El conjunto de datos PASCAL VOC (clases de objetos visuales) es un benchmark clásico de detección de objetos con 20 clases de objetos cotidianos. La configuración VOC.yaml de Ultralytics combina las particiones trainval de VOC2007 y VOC2012 en un conjunto de entrenamiento de 16.551 imágenes, valida con las 4.952 imágenes de prueba de VOC2007 con anotaciones públicas y descarga todo automáticamente (2,8 GB) en el primer uso.
Ver: Cómo entrenar Ultralytics YOLO con el conjunto de datos Pascal VOC | Detección de objetos | Visión artificial 🚀
Los retos PASCAL VOC se celebraron entre 2005 y 2012 y marcaron la forma de evaluar los modelos de detección de objetos: el benchmark abarca tareas de clasificación de imágenes, detección y segmentación, y popularizó la precisión media promedio (mAP) como métrica estándar de detección. La configuración VOC.yaml de Ultralytics utiliza las anotaciones de detección y convierte las cajas delimitadoras XML originales al formato YOLO durante la descarga.
20 clases de objetos cotidianos: persona; seis animales (pájaro, gato, vaca, perro, caballo, oveja); siete vehículos (avión, bicicleta, barco, autobús, coche, moto, tren); y seis objetos de interior (botella, silla, mesa de comedor, planta en maceta, sofá, televisor).
Combinación de dos generaciones del reto: el entrenamiento combina trainval de VOC2007 (5.011 imágenes) con trainval de VOC2012 (11.540 imágenes).
Evaluación estandarizada: las décadas de resultados publicados con VOC lo convierten en una referencia práctica para comparar modelos de detección.
Listo para YOLO: el script de descarga obtiene los archivos comprimidos y convierte las anotaciones automáticamente; no hace falta prepararlo manualmente.
La configuración VOC.yaml de Ultralytics define las siguientes particiones:
División
Imágenes
Fuente
Entrenar
16,551
trainval de VOC2007 (5.011) + trainval de VOC2012 (11.540)
Validación
4,952
Pruebas de VOC2007, utilizadas para la evaluación durante el entrenamiento
Prueba
4,952
Las mismas imágenes de prueba de VOC2007; la configuración no define ninguna partición independiente reservada para pruebas
Las anotaciones de prueba de VOC2007 se publicaron después del reto de ese año, lo que permite utilizar esta partición como conjunto de validación etiquetado. Las anotaciones de prueba de VOC2012 siguen reservadas: los resultados solo se pueden puntuar a través del servidor oficial de evaluación PASCAL, por lo que no forman parte de esta configuración.
Objetos difíciles excluidos
El conversor automático omite los objetos marcados como difficult en las anotaciones XML originales de VOC, por lo que el número de instancias por clase difiere ligeramente de las estadísticas oficiales de VOC.
Explora VOC en Ultralytics Platform para ver las imágenes con sus superposiciones de anotaciones, consultar la distribución de clases y los mapas de calor de las cajas delimitadoras en la pestaña Gráficos, y clonarlo para entrenar tu propio modelo en la nube.
PASCAL VOC fue el benchmark principal para la investigación sobre detección de objetos antes de la aparición del conjunto de datos COCO, de mayor tamaño: detectores como Faster R-CNN y SSD publicaron sus resultados originales con él, y los modelos Ultralytics YOLO se entrenan con él directamente. Hoy sigue siendo popular para:
Comparar nuevas arquitecturas de detección con un amplio historial de resultados publicados
Realizar experimentos rápidos y trabajos de curso: con 16.551 imágenes de entrenamiento, el entrenamiento es mucho más rápido que con COCO
VOC se descarga automáticamente la primera vez que entrenas — tres archivos comprimidos que suman 2,8 GB — y necesita aproximadamente 6 GB de espacio libre en disco durante la extracción y la conversión.
Para entrenar un modelo YOLO26n con el conjunto de datos VOC durante 100 épocas y con un tamaño de imagen de 640, puedes utilizar los siguientes fragmentos de código.
Ejemplo de entrenamiento
from ultralytics import YOLO

# Cargar un modelo
model = YOLO("yolo26n.pt")  # Carga un modelo preentrenado (recomendado para el entrenamiento)

# Entrena el modelo: el conjunto de datos se descargará automáticamente en la primera ejecución
results = model.train(data="VOC.yaml", epochs=100, imgsz=640)
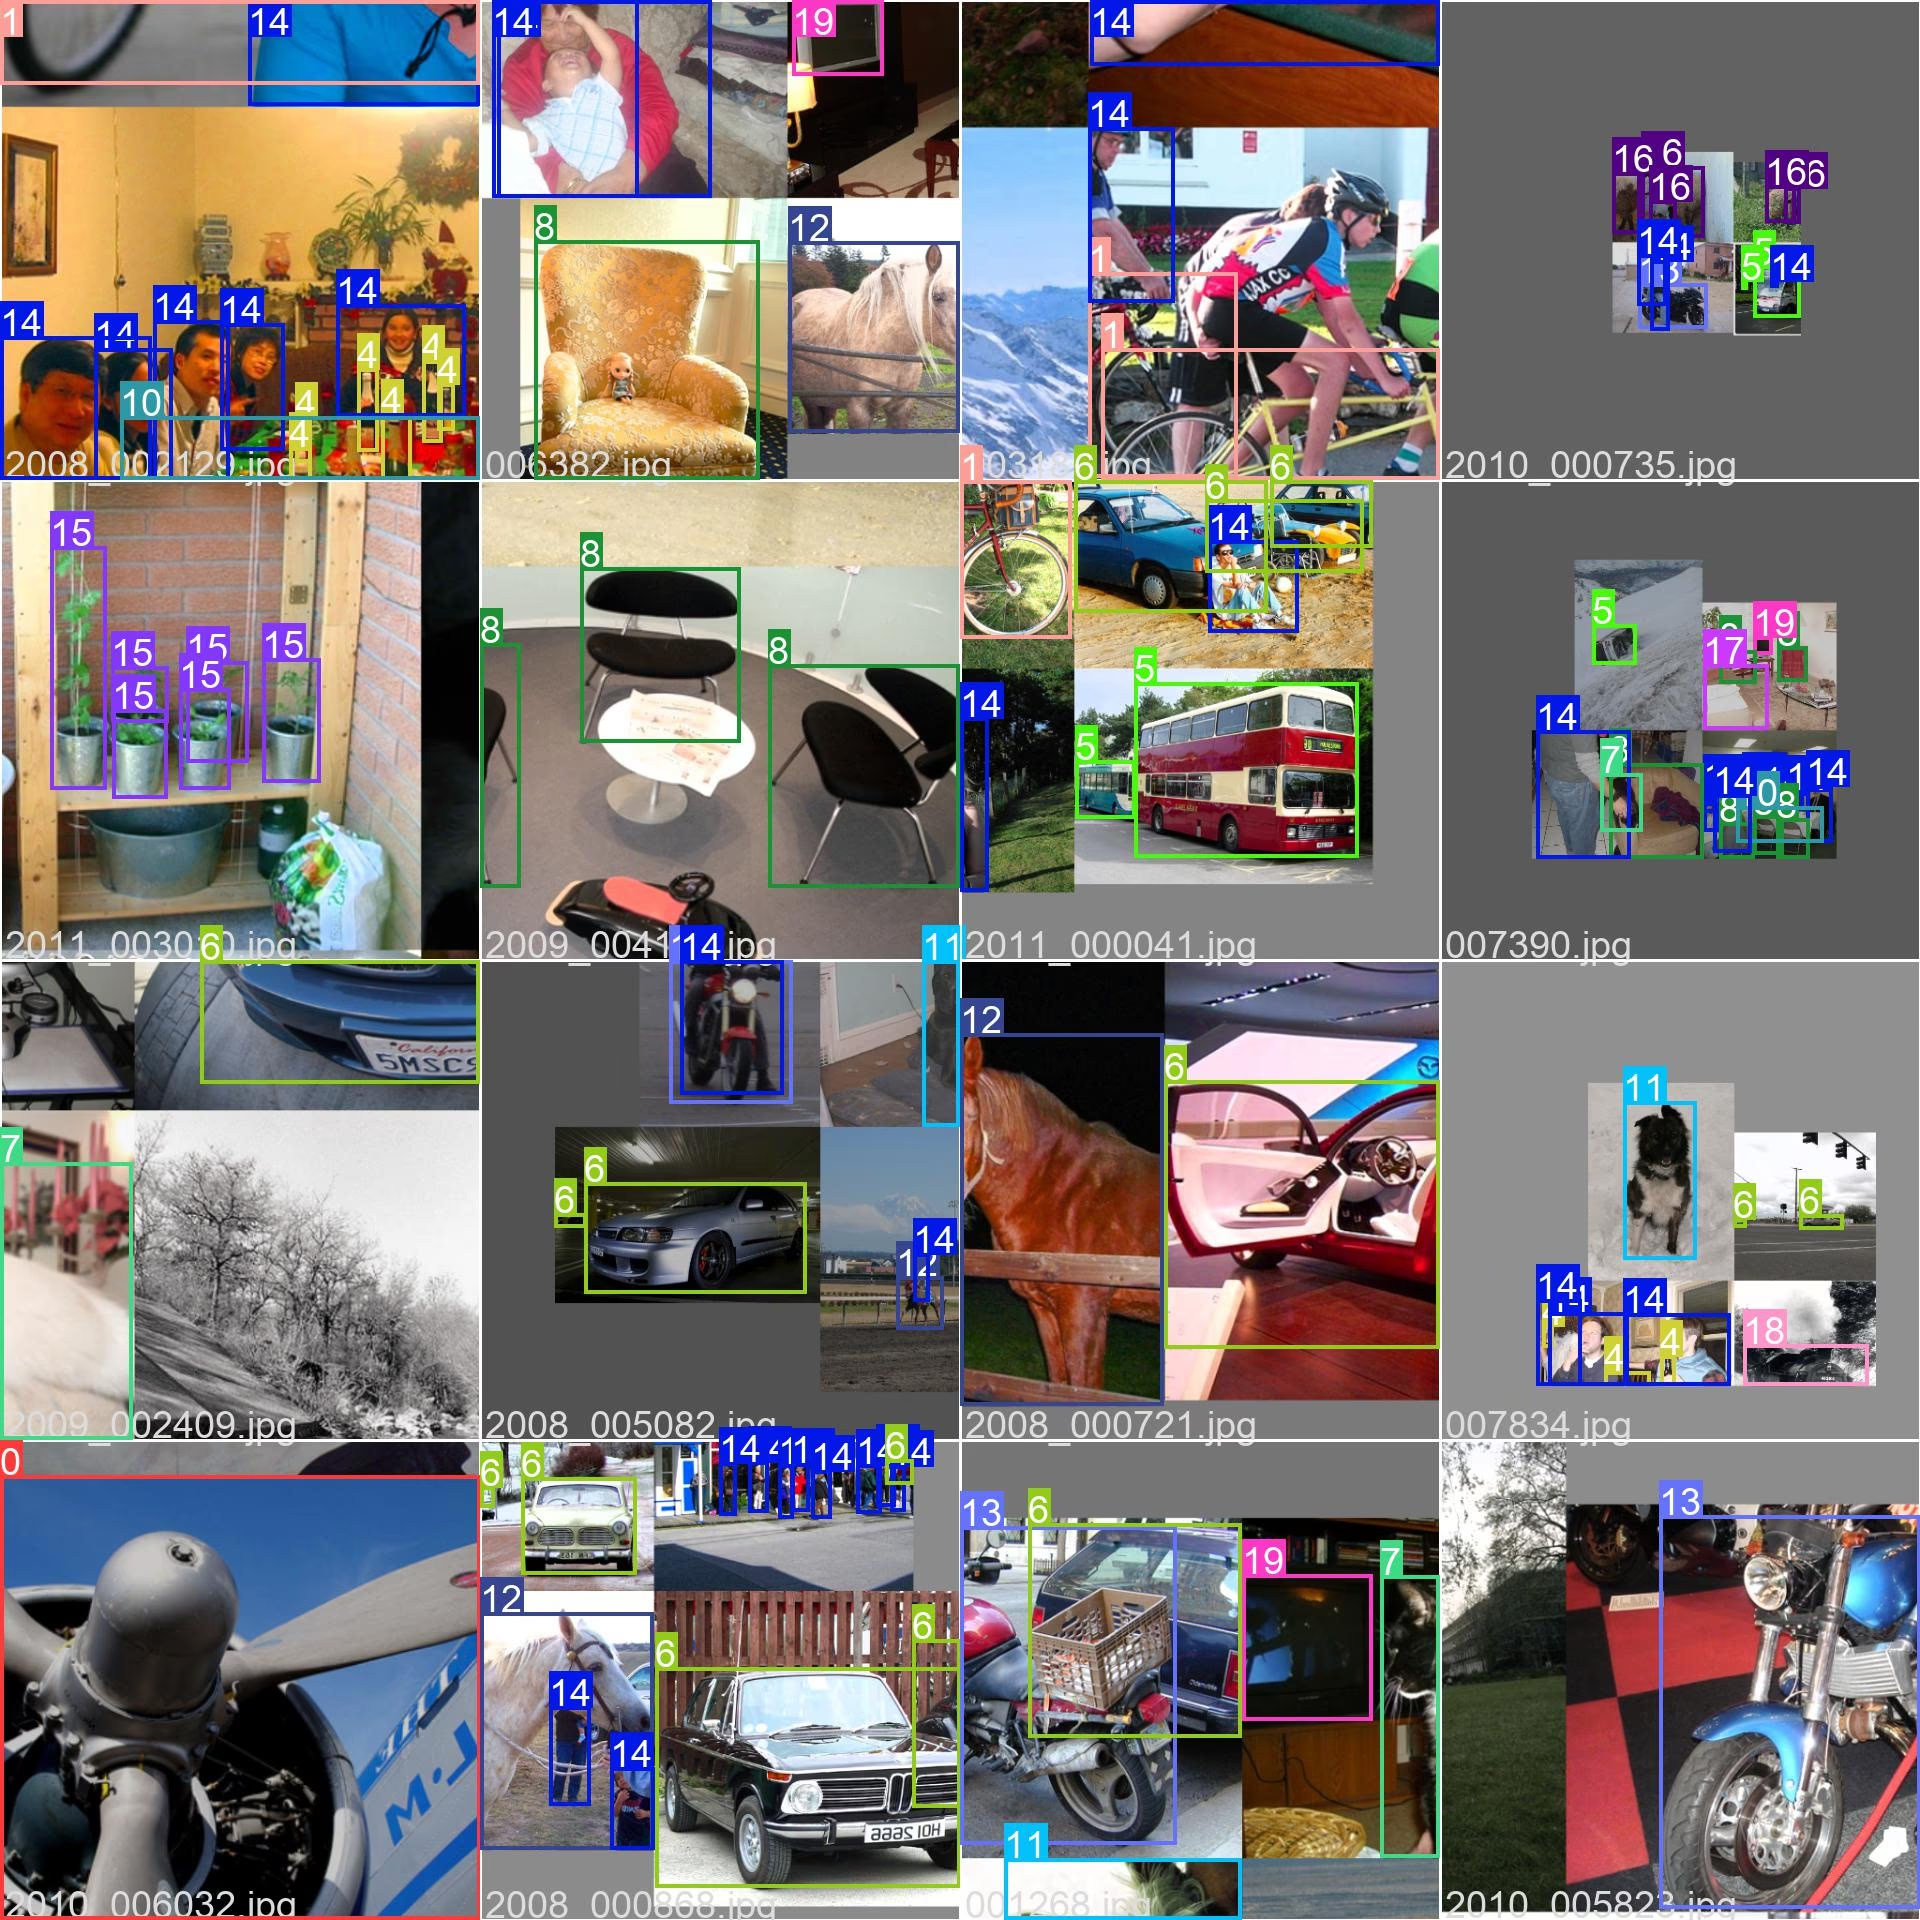
La imagen siguiente muestra un lote de entrenamiento con mosaicos del conjunto de datos VOC. La creación de mosaicos combina varias imágenes en una única muestra de entrenamiento, lo que aumenta la variedad de objetos, escalas y contextos de escena que ve el modelo en cada lote. Consulta la guía de aumento de datos de YOLO para obtener más información.
Si utilizas el conjunto de datos VOC en tu trabajo de investigación o desarrollo, cita el siguiente artículo:
Cita
@article{everingham2010pascal,
  author={Everingham, Mark and Van Gool, Luc and Williams, Christopher K. I. and Winn, John and Zisserman, Andrew},
  journal={International Journal of Computer Vision},
  title={The Pascal Visual Object Classes (VOC) Challenge},
  year={2010},
  volume={88},
  number={2},
  pages={303-338},
  doi={10.1007/s11263-009-0275-4}}
Queremos agradecer al Consorcio PASCAL VOC la creación y el mantenimiento de este valioso recurso para la comunidad de visión artificial. Para obtener más información sobre el conjunto de datos VOC y sus creadores, visita el sitio web del conjunto de datos PASCAL VOC.
PASCAL VOC se utiliza para entrenar y evaluar modelos de detección de objetos con 20 clases de objetos cotidianos, como personas, coches, perros y sillas. Al ser compacto y estar completamente etiquetado, y contar con años de resultados de referencia publicados, es una opción habitual para validar nuevas arquitecturas, realizar prácticas experimentales y llevar a cabo estudios rápidos de aprendizaje por transferencia.
La configuración VOC de Ultralytics contiene 21.503 imágenes: 16.551 para entrenamiento (trainval de VOC2007 + trainval de VOC2012) y 4.952 para validación (el conjunto de prueba de VOC2007). Todas las particiones comparten las mismas 20 clases. Consulta Estructura del conjunto de datos para ver el desglose completo.
VOC se descarga automáticamente la primera vez que entrenas con data="VOC.yaml"; no hace falta seguir ningún paso manual. El script descarga tres archivos comprimidos (2,8 GB) desde los recursos de las versiones de Ultralytics GitHub y convierte las anotaciones XML al formato YOLO.
Entrena un modelo YOLO26n con VOC durante 100 épocas y con un tamaño de imagen de 640:
Ejemplo de entrenamiento
from ultralytics import YOLO

# Cargar un modelo
model = YOLO("yolo26n.pt")  # Carga un modelo preentrenado (recomendado para el entrenamiento)

# Entrenar el modelo
results = model.train(data="VOC.yaml", epochs=100, imgsz=640)
Ambas competiciones comparten las mismas 20 clases, pero aportan imágenes distintas. VOC2007 incluye 5.011 imágenes de trainval y un conjunto de prueba de 4.952 imágenes cuyas anotaciones son públicas; VOC2012 incluye 11.540 imágenes de trainval, pero sus anotaciones de prueba no son públicas y solo se evalúan en el servidor oficial. La configuración VOC.yaml de Ultralytics combina ambos conjuntos de trainval para el entrenamiento y valida con el conjunto de prueba de VOC2007.
VOC es más pequeño y sencillo: 20 clases y 21 503 imágenes frente a las 80 clases y 330 000 imágenes de COCO. Tradicionalmente, los resultados de VOC se expresan como mAP con un IoU de 0,5, mientras que COCO calcula el promedio de mAP con umbrales de IoU entre 0,5 y 0,95. El entrenamiento con VOC es mucho más rápido y resulta adecuado para experimentos rápidos; el conjunto de datos COCO es el estándar para evaluaciones comparativas a escala de producción.
No: VOC.yaml es una configuración exclusiva para detección; su conversor extrae los cuadros delimitadores de las anotaciones XML de VOC, pero no convierte las máscaras de segmentación incluidas en la referencia original. Para entrenar un modelo de segmentación de instancias, utiliza un conjunto de datos con etiquetas de polígonos, como COCO-Seg, junto con un modelo YOLO26n-seg.
raise RuntimeError(emojis(f"Dataset '{clean_url(self.args.data)}' error ❌ {e}")) from e
RuntimeError: Dataset 'VOC.yaml' error ❌ [Errno 2] No such file or directory: '/home/diana/Code/test/datasets/VOC/images/VOCdevkit/VOC2007/ImageSets/Main/train.txt'
Nice find on the root cause. To clean things up, delete the incomplete datasets/VOC folder and run your yolo ... data=VOC.yaml command again so the download/conversion script can fully re-download and unpack everything; if you still hit a path error after that, please share the full command and complete traceback so we can take a closer look.
Respectively, "xmin/ymin" and "xmax/ymax" are the coordinates of the upper-left and lower-right corners of the object.
How can I use this dataset to train the YoloV11 neural network?
@YustasDev to train YOLO26 on your Pascal VOC dataset, you need to convert the XML annotations to YOLO format (class, x_center, y_center, width, height in normalized coordinates). Use the conversion script provided in the VOC.yaml file under the "Download script/URL" section. Once converted, define a custom YAML file for your dataset paths and run the training using:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.train(data="your_dataset.yaml", epochs=100, imgsz=640)
Respectively, "xmin/ymin" and "xmax/ymax" are the coordinates of the upper-left and lower-right corners of the object.
How can I use this dataset to train the YoloV11 neural network?
@YustasDev to use your Pascal VOC dataset for YOLO26 training, you need to convert the XML annotations to YOLO format (class, x_center, y_center, width, height with normalized coordinates). You can adapt the XML-to-YOLO conversion script from the VOC dataset documentation here: https://docs.ultralytics.com/datasets/detect/voc/. Once converted, create a dataset YAML file similar to VOC.yaml, specifying your paths and classes, and then start training using yolo detect train data=your_dataset.yaml model=yolo26n.pt. Let me know if you encounter any issues!
Las cookies nos ayudan a saber qué documentación, modelos y funciones te resultan útiles para poder seguir mejorándolos. Elige qué compartes en o consulta nuestra Política de privacidad.


mengdxiran
 Glenn JocherUltralytics
YustasDev