Conjunto de datos xView#
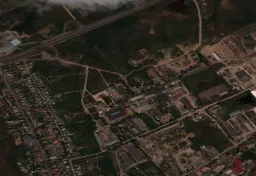
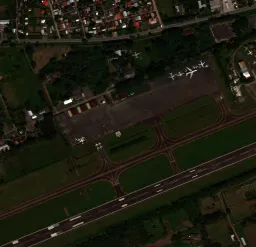
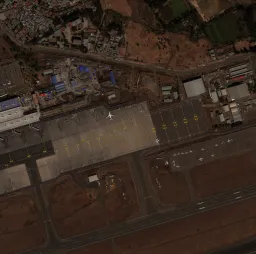
El conjunto de datos xView es uno de los mayores benchmarks de imágenes satelitales disponibles públicamente para la detección de objetos. Ofrece más de 1 millón de instancias de objetos en 60 clases, anotadas con cuadros delimitadores en más de 1.400 km² de imágenes WorldView-3 de 0,3 m. La Agencia Nacional de Inteligencia Geoespacial de EE. UU. (NGA) lo publicó para el desafío DIUx xView 2018; es necesario descargarlo manualmente y ocupa unos 20,7 GB.
El conjunto de datos se creó para ampliar cuatro fronteras de la visión artificial:
- Reducir la resolución mínima para la detección.
- Mejorar la eficiencia del aprendizaje.
- Permitir descubrir más clases de objetos.
- Mejorar la detección de clases detalladas.
A partir de benchmarks como COCO, xView se centra en imágenes aéreas, donde los objetos son mucho más pequeños y están más agrupados que en las fotos tomadas a nivel del suelo.
El conjunto de datos xView no se descarga automáticamente. Regístrate en el sitio web del desafío DIUx xView 2018 para descargar train_images.zip (~15 GB), train_labels.zip y val_images.zip (~5 GB); después, extráelos en datasets/xView/ para que contenga:
datasets/xView/
├── train_images/          # 847 TIF satellite images
├── val_images/            # 282 TIF images (no public labels)
└── xView_train.geojson    # bounding-box annotations
En la primera ejecución del entrenamiento, Ultralytics convierte automáticamente las anotaciones GeoJSON al formato YOLO y divide las imágenes etiquetadas aproximadamente en una proporción 90/10 entre los conjuntos de entrenamiento y validación; no hace falta ninguna conversión manual.
Características principales#
- Clases detalladas: 60 clases de objetos que abarcan aeronaves, vehículos, material ferroviario, embarcaciones, maquinaria de construcción y edificios; muchos son pequeños, poco frecuentes y visualmente similares.
- Alta resolución: distancia de muestreo del terreno de 0,3 m, capturada por satélites WorldView-3.
- Anotación densa: más de 1 millón de instancias de objetos en más de 1.400 km² de imágenes, todas etiquetadas con cuadros delimitadores horizontales.
- Conversión automática: el script de descarga de Ultralytics convierte las etiquetas GeoJSON originales al formato YOLO y genera la partición train/val en el primer uso.
Estructura del conjunto de datos#
Las imágenes xView son grandes escenas satelitales en formato TIF y solo las 847 imágenes de entrenamiento incluyen etiquetas públicas; el conjunto de validación del desafío, de 282 imágenes, no tiene ninguna. Por tanto, la configuración xView.yaml de Ultralytics divide automáticamente las imágenes etiquetadas en el primer uso:
| División | Imágenes | Descripción |
|---|---|---|
| Entrenar | ~90 % de 847 | Imágenes etiquetadas incluidas en autosplit_train.txt, generadas en la primera ejecución |
| Validación | ~10 % de 847 | Imágenes etiquetadas incluidas en autosplit_val.txt, utilizadas para la evaluación |
Las 60 clases incluyen categorías detalladas, como aeronave de ala fija, avión de carga, coche pequeño, autobús, locomotora, embarcación, excavadora, edificio, hangar de aeronaves y tanque de almacenamiento; la lista completa está en el YAML del conjunto de datos que aparece a continuación. Durante la conversión, los ID de clase originales del desafío (11–94) se reasignan a índices consecutivos del 0 al 59.
Aplicaciones#
Las clases detalladas de xView y la perspectiva aérea de alta resolución lo convierten en un benchmark estándar para entrenar y evaluar modelos de aprendizaje profundo en teledetección. Entre sus aplicaciones habituales se incluyen:
- Reconocimiento militar y de defensa
- Planificación y desarrollo urbanos
- Seguimiento medioambiental
- Respuesta y evaluación de catástrofes
- Cartografía y gestión de infraestructuras
Para consultar otros benchmarks de imágenes aéreas, visita el conjunto de datos VisDrone, centrado en drones, o el conjunto de datos DOTA-v2, con cuadros orientados.
YAML del conjunto de datos#
El archivo xView.yaml define la configuración del conjunto de datos: las rutas, los nombres de las 60 clases y el script de descarga que convierte las anotaciones GeoJSON y genera la división automática. Se mantiene en el repositorio de Ultralytics en https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/xView.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# DIUx xView 2018 Challenge dataset https://challenge.xviewdataset.org by U.S. National Geospatial-Intelligence Agency (NGA)
# --------  Download and extract data manually to `datasets/xView` before running the train command.  --------
# Documentation: https://docs.ultralytics.com/datasets/detect/xview
# Example usage: yolo train data=xView.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── xView ← downloads here (20.7 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: xView # dataset root dir
train: images/autosplit_train.txt # train images (relative to 'path') 90% of 847 train images
val: images/autosplit_val.txt # val images (relative to 'path') 10% of 847 train images

# Classes
names:
  0: Fixed-wing Aircraft
  1: Small Aircraft
  2: Cargo Plane
  3: Helicopter
  4: Passenger Vehicle
  5: Small Car
  6: Bus
  7: Pickup Truck
  8: Utility Truck
  9: Truck
  10: Cargo Truck
  11: Truck w/Box
  12: Truck Tractor
  13: Trailer
  14: Truck w/Flatbed
  15: Truck w/Liquid
  16: Crane Truck
  17: Railway Vehicle
  18: Passenger Car
  19: Cargo Car
  20: Flat Car
  21: Tank car
  22: Locomotive
  23: Maritime Vessel
  24: Motorboat
  25: Sailboat
  26: Tugboat
  27: Barge
  28: Fishing Vessel
  29: Ferry
  30: Yacht
  31: Container Ship
  32: Oil Tanker
  33: Engineering Vehicle
  34: Tower crane
  35: Container Crane
  36: Reach Stacker
  37: Straddle Carrier
  38: Mobile Crane
  39: Dump Truck
  40: Haul Truck
  41: Scraper/Tractor
  42: Front loader/Bulldozer
  43: Excavator
  44: Cement Mixer
  45: Ground Grader
  46: Hut/Tent
  47: Shed
  48: Building
  49: Aircraft Hangar
  50: Damaged Building
  51: Facility
  52: Construction Site
  53: Vehicle Lot
  54: Helipad
  55: Storage Tank
  56: Shipping container lot
  57: Shipping Container
  58: Pylon
  59: Tower

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import json
  from pathlib import Path
  import shutil

  import numpy as np
  from PIL import Image

  from ultralytics.utils import TQDM
  from ultralytics.data.split import autosplit
  from ultralytics.utils.ops import xyxy2xywhn

  def convert_labels(fname=Path("xView/xView_train.geojson")):
      """Convert xView GeoJSON labels to YOLO format (classes 0-59) and save them as text files."""
      path = fname.parent
      with open(fname, encoding="utf-8") as f:
          print(f"Loading {fname}...")
          data = json.load(f)

      # Make dirs
      labels = path / "labels" / "train"
      shutil.rmtree(labels, ignore_errors=True)
      labels.mkdir(parents=True, exist_ok=True)

      # xView classes 11-94 to 0-59
      xview_class2index = [-1, -1, -1, -1, -1, -1, -1, -1, -1, -1, -1, 0, 1, 2, -1, 3, -1, 4, 5, 6, 7, 8, -1, 9, 10, 11,
                           12, 13, 14, 15, -1, -1, 16, 17, 18, 19, 20, 21, 22, -1, 23, 24, 25, -1, 26, 27, -1, 28, -1,
                           29, 30, 31, 32, 33, 34, 35, 36, 37, -1, 38, 39, 40, 41, 42, 43, 44, 45, -1, -1, -1, -1, 46,
                           47, 48, 49, -1, 50, 51, -1, 52, -1, -1, -1, 53, 54, -1, 55, -1, -1, 56, -1, 57, -1, 58, 59]

      shapes = {}
      for feature in TQDM(data["features"], desc=f"Converting {fname}"):
          p = feature["properties"]
          if p["bounds_imcoords"]:
              image_id = p["image_id"]
              image_file = path / "train_images" / image_id
              if image_file.exists():  # 1395.tif missing
                  try:
                      box = np.array([int(num) for num in p["bounds_imcoords"].split(",")])
                      assert box.shape[0] == 4, f"incorrect box shape {box.shape[0]}"
                      cls = p["type_id"]
                      cls = xview_class2index[int(cls)]  # xView class to 0-59
                      assert 59 >= cls >= 0, f"incorrect class index {cls}"

                      # Write YOLO label
                      if image_id not in shapes:
                          shapes[image_id] = Image.open(image_file).size
                      box = xyxy2xywhn(box[None].astype(float), w=shapes[image_id][0], h=shapes[image_id][1], clip=True)
                      with open((labels / image_id).with_suffix(".txt"), "a", encoding="utf-8") as f:
                          f.write(f"{cls} {' '.join(f'{x:.6f}' for x in box[0])}\n")  # write label.txt
                  except Exception as e:
                      print(f"WARNING: skipping one label for {image_file}: {e}")

  # Download manually from https://challenge.xviewdataset.org
  dir = Path(yaml["path"])  # dataset root dir
  # urls = [
  #     "https://d307kc0mrhucc3.cloudfront.net/train_labels.zip",  # train labels
  #     "https://d307kc0mrhucc3.cloudfront.net/train_images.zip",  # 15G, 847 train images
  #     "https://d307kc0mrhucc3.cloudfront.net/val_images.zip",  # 5G, 282 val images (no labels)
  # ]
  # download(urls, dir=dir)

  # Convert labels
  convert_labels(dir / "xView_train.geojson")

  # Move images
  images = Path(dir / "images")
  images.mkdir(parents=True, exist_ok=True)
  Path(dir / "train_images").rename(dir / "images" / "train")
  Path(dir / "val_images").rename(dir / "images" / "val")

  # Split
autosplit(dir / "images" / "train")Uso#
El entrenamiento requiere que la descarga manual descrita anteriormente se extraiga en datasets/xView/; después, la conversión de anotaciones y la división train/val se ejecutan automáticamente.
Para entrenar un modelo con el conjunto de datos xView durante 100 épocas y con un tamaño de imagen de 640, puedes usar los siguientes fragmentos de código. Para consultar una lista completa de los argumentos disponibles, visita la página de entrenamiento del modelo.
from ultralytics import YOLO

# Cargar un modelo
model = YOLO("yolo26n.pt")  # Carga un modelo preentrenado (recomendado para el entrenamiento)

# Entrenar el modelo
results = model.train(data="xView.yaml", epochs=100, imgsz=640)
Para etiquetar imágenes satelitales adicionales y gestionar las ejecuciones de entrenamiento de xView desde el navegador, utiliza Ultralytics Platform.
Datos de ejemplo y anotaciones#
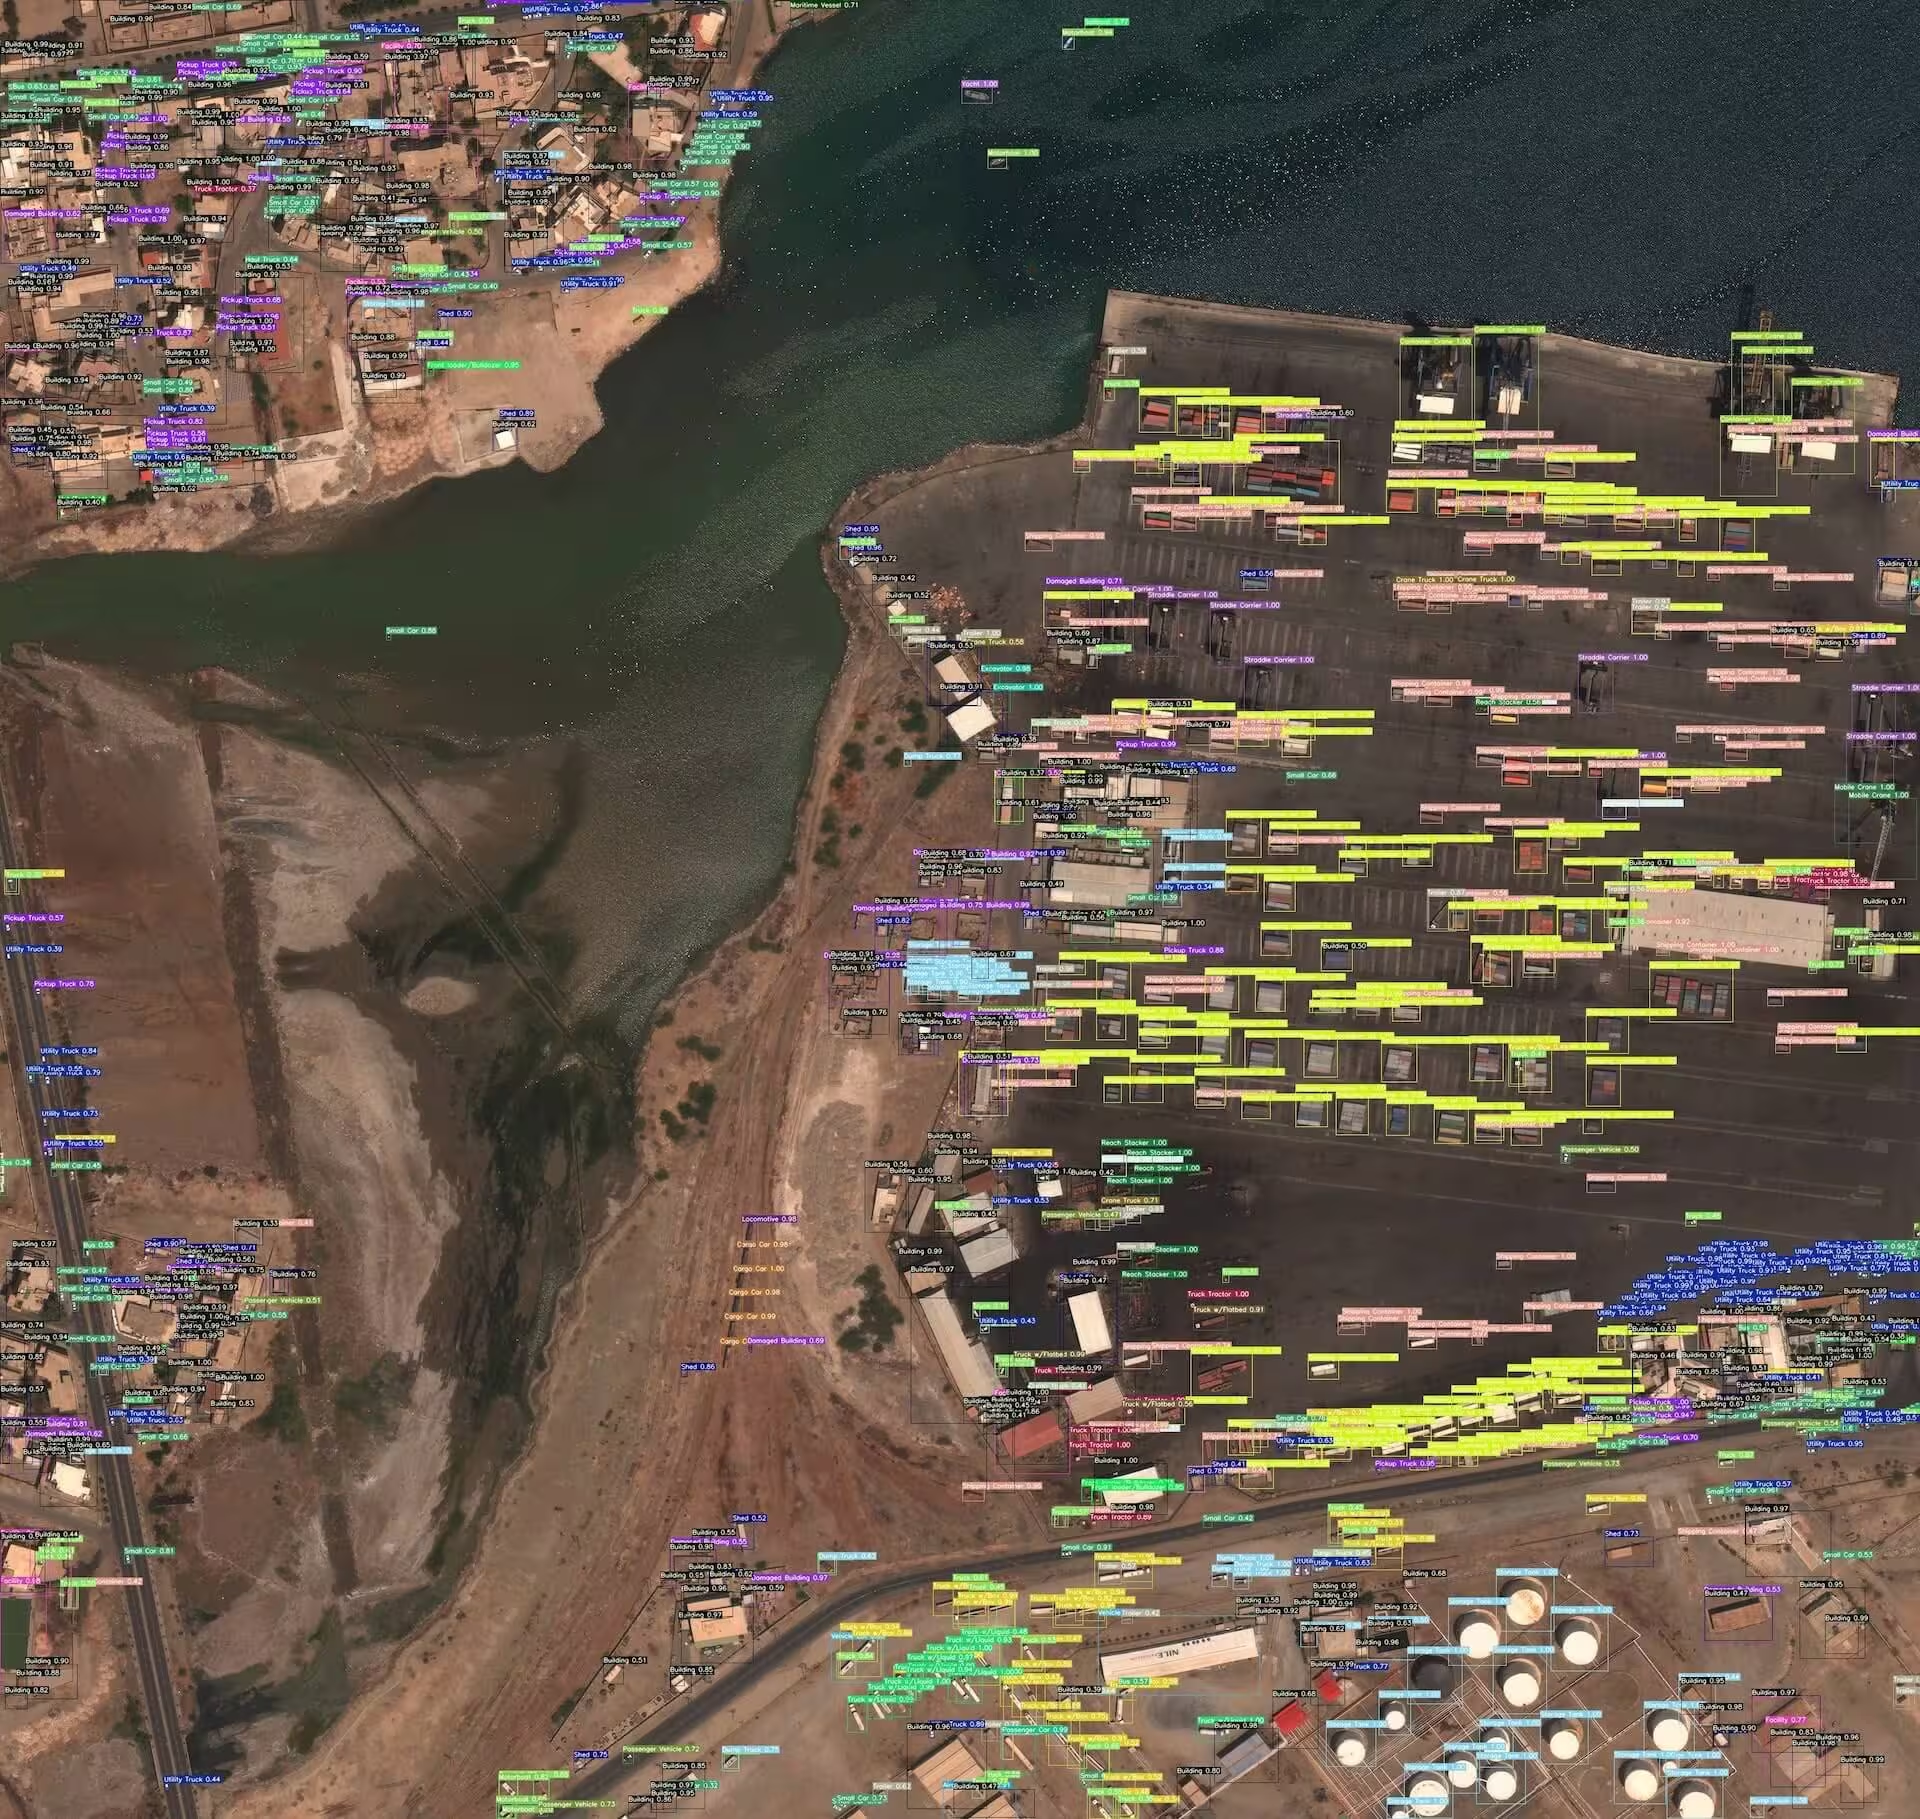
El ejemplo siguiente muestra una escena típica de xView: imágenes aéreas de alta resolución en las que los objetos pequeños, como vehículos y edificios, están anotados con cuadros delimitadores. Esto ilustra por qué la detección de objetos en imágenes satelitales requiere una localización detallada.
Citas y agradecimientos#
Si utilizas el conjunto de datos xView en tu trabajo de investigación o desarrollo, cita el siguiente artículo:
@misc{lam2018xview,
      title={xView: Objects in Context in Overhead Imagery},
      author={Darius Lam and Richard Kuzma and Kevin McGee and Samuel Dooley and Michael Laielli and Matthew Klaric and Yaroslav Bulatov and Brendan McCord},
      year={2018},
      eprint={1802.07856},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Queremos agradecer a la Unidad de Innovación de Defensa (DIU) y a los creadores del conjunto de datos xView su valiosa contribución a la comunidad de investigación en visión artificial. Para obtener más información, visita el sitio web del conjunto de datos xView.
Preguntas frecuentes#
El conjunto de datos xView es un benchmark de imágenes satelitales publicado para el desafío DIUx xView 2018 por la Agencia Nacional de Inteligencia Geoespacial de EE. UU. Ofrece más de 1 millón de instancias de objetos en 60 clases detalladas en imágenes WorldView-3 de 0,3 m. Permite investigar la detección de objetos pequeños, poco frecuentes y detallados en vistas aéreas, mucho más difíciles de analizar que las fotos tomadas a nivel del suelo.
xView requiere una descarga manual: regístrate en el sitio web del desafío DIUx xView 2018, descarga
train_images.zip(~15 GB),train_labels.zipyval_images.zip(~5 GB) — unos 20,7 GB en total — y extráelos endatasets/xView/siguiendo la estructura que se muestra en el aviso al principio de esta página. En la primera ejecución del entrenamiento, Ultralytics convierte automáticamente las anotaciones GeoJSON al formato YOLO y crea la división entre entrenamiento y validación.xView contiene 847 imágenes de entrenamiento etiquetadas y 282 imágenes de validación sin etiquetas públicas, todas capturadas por satélites WorldView-3 con una resolución de 0,3 m. Las anotaciones abarcan más de 1 millón de instancias de objetos en 60 clases. Como solo son públicas las etiquetas de entrenamiento, la configuración
xView.yamlde Ultralytics divide las 847 imágenes etiquetadas aproximadamente en una proporción 90/10 entre los conjuntos de entrenamiento y validación; consulta Estructura del conjunto de datos para obtener más información.Entrena un modelo YOLO26n con xView durante 100 épocas y con un tamaño de imagen de 640:
Ejemplo de entrenamientofrom ultralytics import YOLO # Cargar un modelo model = YOLO("yolo26n.pt") # Carga un modelo preentrenado (recomendado para el entrenamiento) # Entrenar el modelo results = model.train(data="xView.yaml", epochs=100, imgsz=640)Para consultar argumentos y ajustes detallados, visita la página de entrenamiento del modelo.
Cita el artículo «xView: Objects in Context in Overhead Imagery» (Lam et al., arXiv:1802.07856, 2018); la entrada BibTeX completa está en la sección Citas y agradecimientos anterior.