Despliega YOLO26 en dispositivos móviles y de borde con ExecuTorch#
Desplegar modelos de visión artificial en dispositivos de borde, como smartphones, tabletas y sistemas integrados, requiere un entorno de ejecución optimizado que equilibre el rendimiento con las limitaciones de recursos. ExecuTorch, la solución de PyTorch para la computación en el borde, permite realizar inferencias eficientes en el dispositivo con modelos de Ultralytics YOLO.
Esta guía explica cómo exportar modelos de Ultralytics YOLO al formato ExecuTorch para que puedas desplegarlos en dispositivos móviles y de borde con un rendimiento optimizado.
¿Por qué exportar a ExecuTorch?#
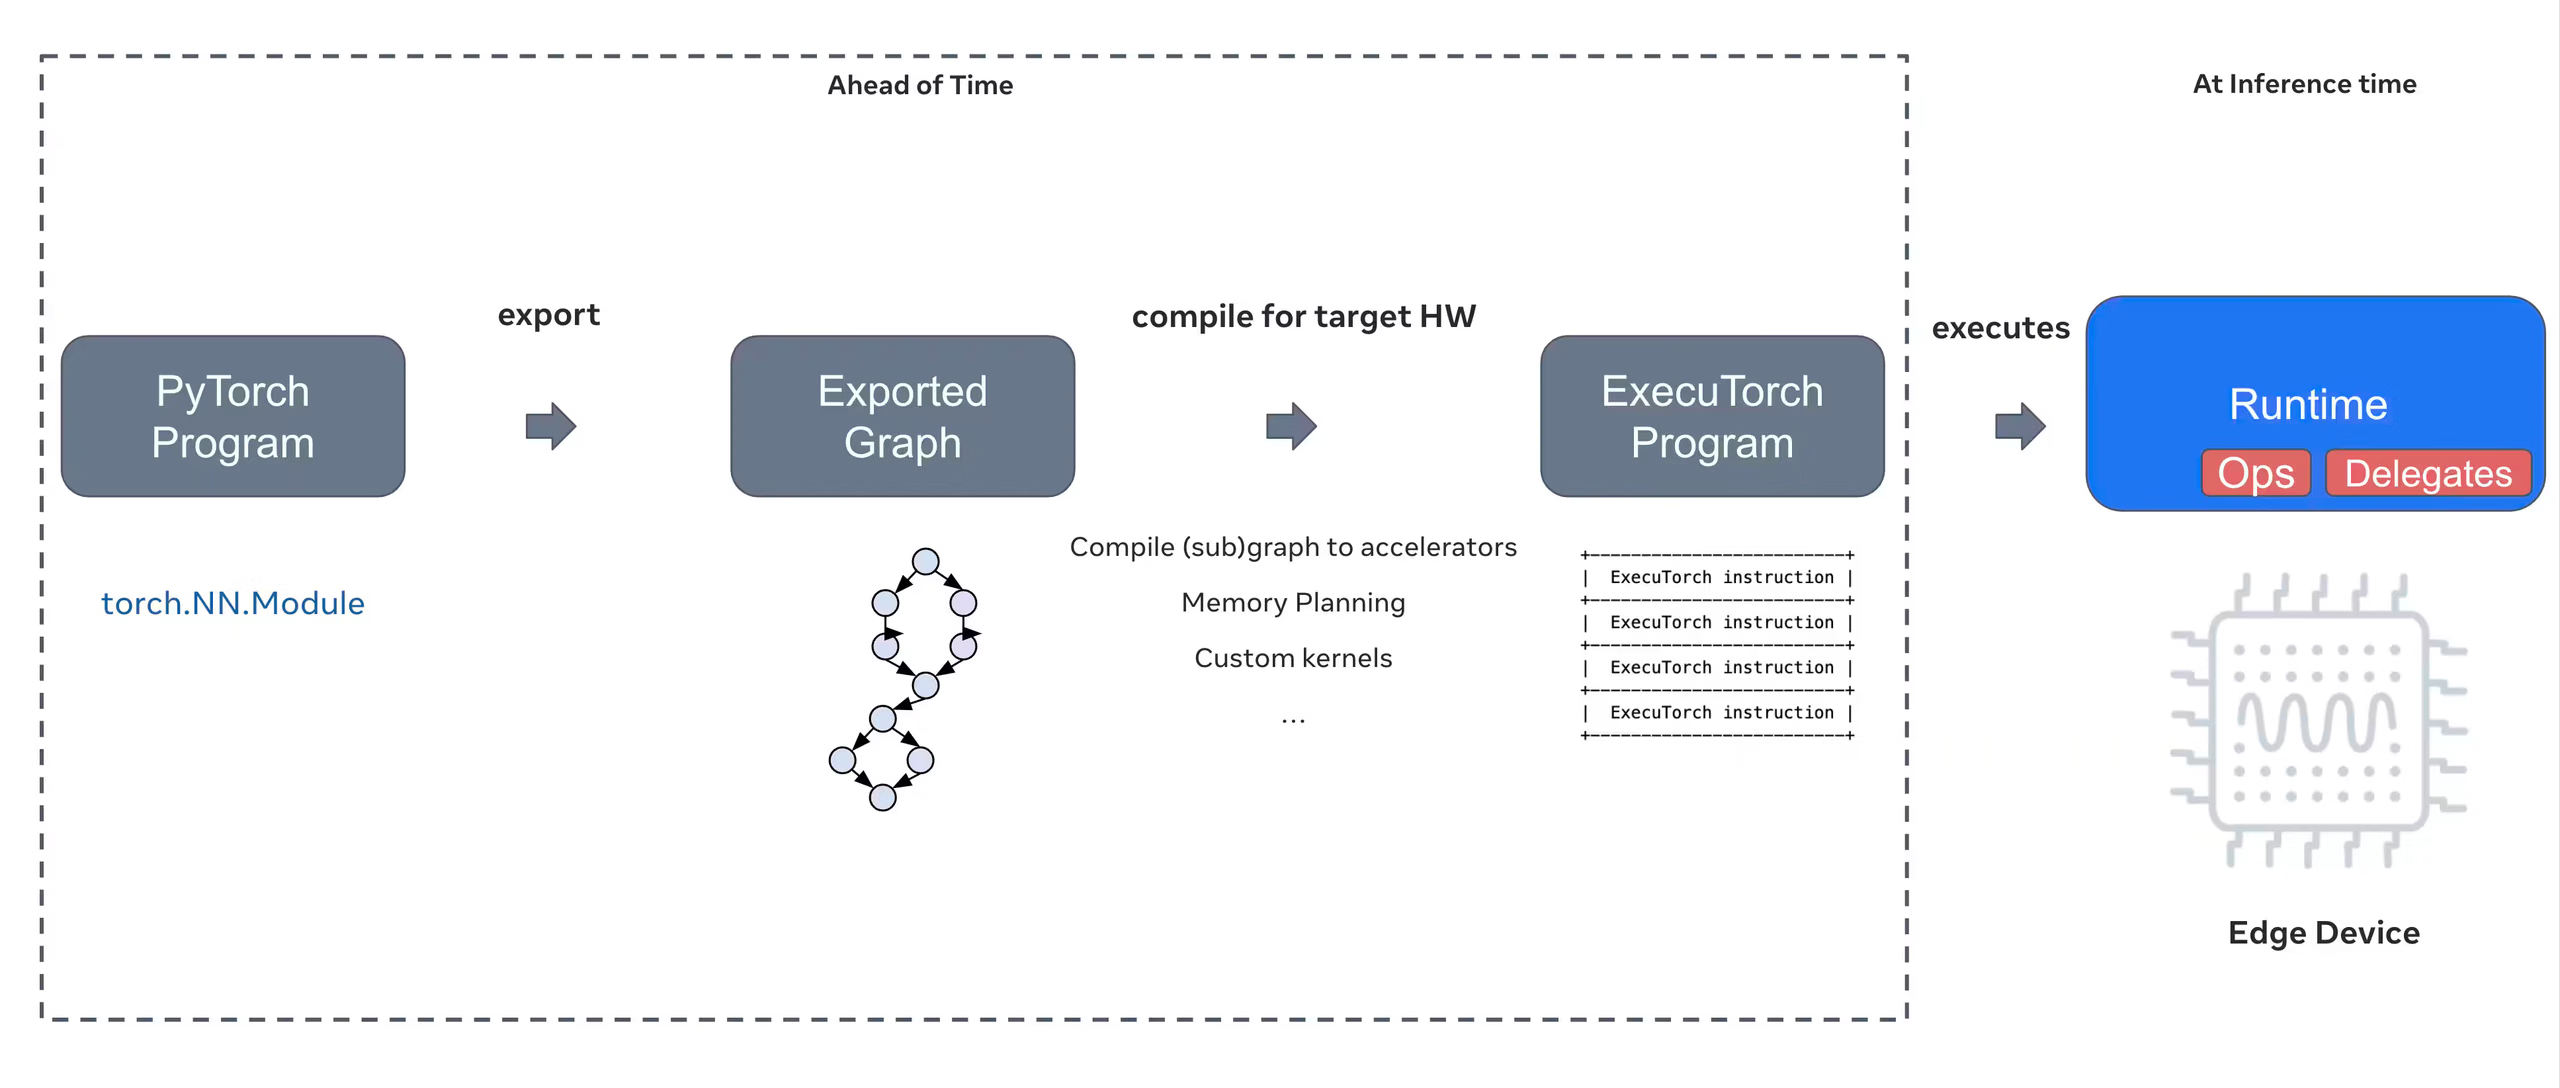
ExecuTorch es la solución integral de PyTorch para habilitar capacidades de inferencia en el dispositivo en plataformas móviles y de borde. ExecuTorch está diseñado para ser portátil y eficiente, y permite ejecutar programas de PyTorch en una amplia variedad de plataformas informáticas.
Funciones clave de ExecuTorch#
ExecuTorch ofrece varias funciones potentes para desplegar modelos de Ultralytics YOLO en dispositivos de borde:
-
Formato de modelo portátil: ExecuTorch utiliza el formato
.pte(PyTorch ExecuTorch), optimizado para reducir el tamaño y agilizar la carga en dispositivos con recursos limitados. -
Backend XNNPACK: La integración predeterminada con XNNPACK ofrece inferencias muy optimizadas en CPU móviles y un rendimiento excelente sin necesidad de hardware especializado.
-
Preparado para la cuantización: El ecosistema ExecuTorch admite técnicas de cuantización para reducir el tamaño del modelo y aumentar la velocidad de inferencia; actualmente, Ultralytics exporta modelos FP32 mediante el backend XNNPACK.
-
Eficiencia de memoria: La gestión de memoria optimizada reduce el consumo de memoria en tiempo de ejecución, por lo que es adecuada para dispositivos con RAM limitada.
-
Metadatos del modelo: Los modelos exportados incluyen los metadatos (tamaño de imagen, nombres de clase, etc.) en un archivo YAML independiente para facilitar la integración.
Opciones de despliegue con ExecuTorch#
Los modelos ExecuTorch se pueden desplegar en diversas plataformas móviles y de borde:
-
Aplicaciones móviles: Despliega los modelos en aplicaciones para iOS y Android con rendimiento nativo, lo que permite detectar objetos en tiempo real en aplicaciones móviles.
-
Sistemas integrados: Ejecuta los modelos en dispositivos con Linux integrado, como Raspberry Pi y NVIDIA Jetson, y en otros sistemas basados en ARM con un rendimiento optimizado.
-
Dispositivos de IA de borde: Despliega los modelos en hardware especializado de IA de borde con delegados personalizados para acelerar la inferencia.
-
Dispositivos IoT: Intégralos en dispositivos IoT para realizar inferencias en el dispositivo sin necesidad de conectividad a la nube.
Tareas compatibles#
La exportación a ExecuTorch es compatible con las siete tareas de Ultralytics. La segmentación semántica y la estimación de profundidad solo están disponibles con YOLO26, la única familia que incluye esas cabezas.
| Tarea | YOLOv8 | YOLO11 | YOLO26 |
|---|---|---|---|
| Detectar | ✅ | ✅ | ✅ |
| Segmentar | ✅ | ✅ | ✅ |
| Semántica | ❌ | ❌ | ✅ |
| Profundidad | ❌ | ❌ | ✅ |
| Clasificar | ✅ | ✅ | ✅ |
| Pose | ✅ | ✅ | ✅ |
| OBB | ✅ | ✅ | ✅ |
Exportar modelos de Ultralytics YOLO26 a ExecuTorch#
Convertir modelos de Ultralytics YOLO26 al formato ExecuTorch permite desplegarlos eficazmente en dispositivos móviles y de borde.
Instalación#
La exportación de ExecuTorch requiere Python 3.10-3.14 y PyTorch >= 2.9.0. Ultralytics instala un paquete executorch compatible cuando exportas o cargas un modelo ExecuTorch, fijado a executorch<1.5 en versiones de PyTorch anteriores a la 2.13, así que no lo actualices manualmente.
# Install Ultralytics package
pip install ultralytics
Para obtener instrucciones detalladas y buenas prácticas sobre el proceso de instalación, consulta nuestra guía de instalación de YOLO26. Si tienes dificultades al instalar los paquetes necesarios para YOLO26, consulta nuestra guía de problemas habituales, donde encontrarás soluciones y consejos.
Uso#
Exportar modelos YOLO26 a ExecuTorch es sencillo:
El formato ExecuTorch admite los modos Exportar, Predecir y Validar. Exporta tu modelo y, después, carga el modelo exportado para ejecutar inferencias o validar su precisión.
from ultralytics import YOLO

# Carga un modelo YOLO26
model = YOLO("yolo26n.pt")

# Exporta el modelo al formato ExecuTorch
model.export(format="executorch") # creates 'yolo26n_executorch_model'from ultralytics import YOLO
# Carga el modelo ExecuTorch exportado
model = YOLO("yolo26n_executorch_model")
# Ejecutar inferencia
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Carga el modelo ExecuTorch exportado
model = YOLO("yolo26n_executorch_model")
# Valida la precisión con el conjunto de datos COCO8
metrics = model.val(data="coco8.yaml")Las exportaciones a ExecuTorch generan un directorio que incluye un archivo .pte y metadatos. Utiliza el entorno de ejecución ExecuTorch en tu aplicación móvil o integrada para cargar el modelo .pte y realizar inferencias.
Argumentos de exportación#
Al exportar al formato ExecuTorch, puedes especificar los siguientes argumentos:
| Argumento | Tipo | Predeterminado | Descripción |
|---|---|---|---|
format | str | 'executorch' | Formato de destino del modelo exportado, que define su compatibilidad con distintos entornos de implementación. |
imgsz | int o tuple | 640 | Tamaño de imagen deseado para la entrada del modelo. Puede ser un número entero para imágenes cuadradas o una tupla (height, width) para dimensiones específicas. |
quantize | int o str | None | Exportación FP32 fija. La exportación a ExecuTorch no admite la conversión de precisión a FP16, INT8 o W8A16 durante la exportación. |
batch | int | 1 | Especifica el tamaño del lote de inferencia del modelo exportado o el número máximo de imágenes que el modelo exportado procesará simultáneamente en el modo predict. |
device | str | None | Especifica el dispositivo para la exportación: GPU (device=0), CPU (device=cpu), MPS para Apple silicon (device=mps). |
Estructura de salida#
La exportación a ExecuTorch crea un directorio que contiene el modelo y sus metadatos:
yolo26n_executorch_model/
├── model.pte               # ExecuTorch model file
└── metadata.yaml           # Model metadata (classes, image size, etc.)
Usar modelos ExecuTorch exportados#
Después de exportar tu modelo, tendrás que integrarlo en la aplicación de destino mediante el entorno de ejecución ExecuTorch.
Integración en dispositivos móviles#
Para aplicaciones móviles (iOS/Android), tendrás que:
- Añadir el entorno de ejecución ExecuTorch: Incluye la biblioteca del entorno de ejecución ExecuTorch en tu proyecto móvil.
- Cargar el modelo: Carga el archivo
.pteen tu aplicación. - Ejecutar inferencias: Procesa imágenes y obtén predicciones.
iOS#
Ejemplo de integración con iOS (Objective-C/C++):
// iOS uses C++ APIs for model loading and inference
// See https://pytorch.org/executorch/stable/using-executorch-ios.html for complete examples

#include <executorch/extension/module/module.h>

using namespace ::executorch::extension;

// Load the model
Module module("/path/to/model.pte");

// Create input tensor
float input[1 * 3 * 640 * 640];
auto tensor = from_blob(input, {1, 3, 640, 640});

// Run inference
const auto result = module.forward(tensor);Android#
Añade el AAR de ExecuTorch para Android desde Maven Central:
dependencies {
    implementation("org.pytorch:executorch-android:<version>")
}
Ejemplo de integración con Android (Kotlin):
import org.pytorch.executorch.EValue
import org.pytorch.executorch.Module
import org.pytorch.executorch.Tensor

// Load the model
val module = Module.load("/path/to/model.pte")

// Prepare input tensor
val inputTensor = Tensor.fromBlob(floatData, longArrayOf(1, 3, 640, 640))
val inputEValue = EValue.from(inputTensor)

// Run inference
val outputs = module.forward(inputEValue)
val scores = outputs[0].toTensor().dataAsFloatArray
Linux integrado#
Para sistemas Linux integrados, usa la API de C++ de ExecuTorch:
#include <executorch/extension/module/module.h>
#include <executorch/extension/tensor/tensor.h>

using namespace ::executorch::extension;

// Load model
Module module("model.pte");

// Prepare input
std::vector<float> input_data = preprocessImage(image);
auto input_tensor = from_blob(input_data.data(), {1, 3, 640, 640});

// Run inference
const auto outputs = module.forward(input_tensor);
Para obtener más información sobre cómo integrar ExecuTorch en tus aplicaciones, visita la documentación de ExecuTorch.
Optimización del rendimiento#
Optimización del tamaño del modelo#
Para reducir el tamaño del modelo para su implementación:
- Usa modelos más pequeños: empieza con YOLO26n (nano) para ocupar el mínimo espacio
- Reduce la resolución de entrada: usa imágenes más pequeñas (p. ej.,
imgsz=320oimgsz=416) - Cuantización: aplica técnicas de cuantización de ExecuTorch fuera de Ultralytics (la exportación de Ultralytics a ExecuTorch solo admite FP32)
Optimización de la velocidad de inferencia#
Para acelerar la inferencia:
- Backend XNNPACK: el backend XNNPACK predeterminado ofrece inferencia optimizada en CPU
- Aceleración por hardware: usa delegados específicos de cada plataforma (p. ej., CoreML para iOS)
- Procesamiento por lotes: procesa varias imágenes cuando sea posible
Pruebas de rendimiento#
El equipo de Ultralytics evaluó modelos YOLO26 y comparó la velocidad y la precisión de PyTorch y ExecuTorch.
| Modelo | Formato | Estado | Tamaño (MB) | metrics/mAP50-95(B) | Tiempo de inferencia (ms/im) |
|---|---|---|---|---|---|
| YOLO26n | PyTorch | ✅ | 5.3 | 0.4790 | 314.80 |
| YOLO26n | ExecuTorch | ✅ | 9.4 | 0.4800 | 142 |
| YOLO26s | PyTorch | ✅ | 19.5 | 0.5730 | 930.90 |
| YOLO26s | ExecuTorch | ✅ | 36.5 | 0.5780 | 376.1 |
El tiempo de inferencia no incluye el preprocesamiento ni el posprocesamiento.
Solución de problemas#
Problemas habituales#
Problema: Python version error
Solución: ExecuTorch requiere Python 3.10 a 3.14. Crea un entorno con una versión compatible:
# Using conda
conda create -n executorch python=3.14
conda activate executorch
Para obtener más ayuda con la resolución de problemas, visita los problemas de Ultralytics en GitHub o la documentación de ExecuTorch.
Resumen#
Exportar modelos YOLO26 al formato ExecuTorch permite implementarlos de forma eficiente en dispositivos móviles y periféricos. Gracias a la integración nativa con PyTorch, la compatibilidad multiplataforma y el rendimiento optimizado, ExecuTorch es una excelente opción para aplicaciones de IA en el edge.
Puntos clave:
- ExecuTorch permite implementar modelos en el edge de forma nativa con PyTorch y ofrece un excelente rendimiento
- La exportación es sencilla con el parámetro
format='executorch' - Los modelos se optimizan para las CPU de dispositivos móviles mediante el backend XNNPACK
- Admite las plataformas iOS, Android y Linux integrado
- Requiere Python 3.10-3.14 y PyTorch >= 2.9.0
Preguntas frecuentes#
Exporta un modelo YOLO26 a ExecuTorch con Python o CLI:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(format="executorch")
o
yolo export model=yolo26n.pt format=executorchLa exportación a ExecuTorch requiere:
- Python 3.10 a 3.14
- El paquete
executorch, que se instala automáticamente (executorch<1.5con versiones de PyTorch anteriores a la 2.13, que no son compatibles con las versiones más recientes del entorno de ejecución de ExecuTorch) - PyTorch (se instala automáticamente con ultralytics)
Nota: el paquete
executorchincluye ruedas precompiladas (con el backend XNNPACK), por lo que no hace falta ningún paso de compilación adicional durante la exportación.Los modelos ExecuTorch se pueden cargar directamente con
YOLO()para realizar inferencias y validaciones en Python (consulta los ejemplos de predicción y validación anteriores); también se pueden implementar en dispositivos móviles y periféricos con las bibliotecas del entorno de ejecución de ExecuTorch.ExecuTorch admite:
- Móviles: iOS y Android
- Linux integrado: Raspberry Pi, NVIDIA Jetson y otros dispositivos ARM
- Escritorio: Linux, macOS y Windows (para desarrollo)
Tanto ExecuTorch como LiteRT son excelentes opciones para la implementación en dispositivos móviles:
- ExecuTorch: mejor integración con PyTorch, flujo de trabajo nativo de PyTorch y un ecosistema en expansión
- LiteRT: más maduro, mayor compatibilidad con hardware, más ejemplos de implementación y ejecución del mismo modelo en Android, iOS y el navegador
Elige ExecuTorch si ya usas PyTorch y quieres una vía de implementación nativa. Elige LiteRT si buscas la máxima compatibilidad y herramientas más maduras.
¡Sí! ExecuTorch admite la aceleración por hardware mediante varios backends:
- GPU móvil: mediante delegados de Vulkan, Metal u OpenCL
- NPU/DSP: mediante delegados específicos de cada plataforma
- Predeterminado: XNNPACK para optimizar la inferencia en CPU
Consulta la documentación de ExecuTorch para configurar cada backend.