Despliegue#
Ultralytics Platform ofrece opciones completas de despliegue de modelos para poner tus modelos YOLO en producción. Prueba modelos con inferencia en el navegador, despliégalos en endpoints dedicados de 42 regiones de todo el mundo y supervisa su rendimiento en tiempo real.
Ver: Empieza a usar Ultralytics Platform: implementación
Descripción general#
La sección Despliegue te ayuda a:
- Probar modelos directamente en el navegador con la pestaña
Predict - Desplegar en endpoints dedicados de 42 regiones de todo el mundo
- Supervisar las métricas de solicitudes, los registros, las comprobaciones de estado y las predicciones temporales de cada endpoint dedicado
- Elegir recursos: los endpoints predeterminados se escalan a cero; los tamaños personalizados mantienen una instancia activa y facturan el tiempo de actividad
Opciones de despliegue#
Ultralytics Platform ofrece varias opciones de despliegue:
| Opción | Descripción | Ideal para |
|---|---|---|
| Pestaña Predict | Imagen, cámara web y ejemplos; cámara IP en tus propios endpoints | Desarrollo, validación |
| Inferencia compartida | Servicio multiinquilino en 3 regiones de datos | Uso ligero, pruebas |
| Endpoints dedicados | Servicios de inquilino único en 42 regiones | Producción, baja latencia |
| Exportar | Descarga pesos en 22 formatos para entornos de ejecución locales o de borde | Sin conexión, en el dispositivo |
Flujo de trabajo#
| Etapa | Descripción |
|---|---|
| Prueba | Valida el modelo con la pestaña Predict |
| Configurar | Selecciona un modelo, una región, una CPU y memoria; revisa los precios y el nombre del despliegue |
| Desplegar | Crea un endpoint dedicado desde la pestaña Deploy |
| Supervisar | Consulta las métricas del endpoint y las predicciones temporales en Supervisión |
Arquitectura#
Inferencia compartida#
El servicio de inferencia compartida se ejecuta en 3 regiones clave. Las solicitudes a un modelo se dirigen al servicio de la región de datos de ese modelo, por lo que los resultados permanecen en la región donde está almacenado:
| Región | Etiqueta | Ubicación | Ideal para |
|---|---|---|---|
| EE. UU. | América | Iowa, EE. UU. | Usuarios de América; la opción más rápida para América |
| UE | Europa, Oriente Medio y África | Bélgica, Europa | Usuarios europeos; cumplimiento del RGPD |
| AP | Asia-Pacífico | Taiwán, Asia-Pacífico | Usuarios de Asia-Pacífico; la menor latencia de APAC |
Endpoints dedicados#
Despliega en Ultralytics Cloud en 42 regiones de todo el mundo:
- América: 14 regiones
- Europa: 13 regiones
- Asia-Pacífico: 12 regiones
- Oriente Medio y África: 3 regiones
Cada endpoint es un servicio de inquilino único con:
- CPU y memoria configurables, con los precios indicados antes del despliegue
- Escalado a cero con los recursos predeterminados; una instancia activa con recursos personalizados, facturada por tiempo de actividad
- URL de endpoint única con su propia referencia interactiva de API en
/docs - Vinculación a su propia clave de API, de modo que solo esa clave pueda llamar al endpoint
- Supervisión, registros y comprobaciones de estado independientes
Pestaña Deployments#
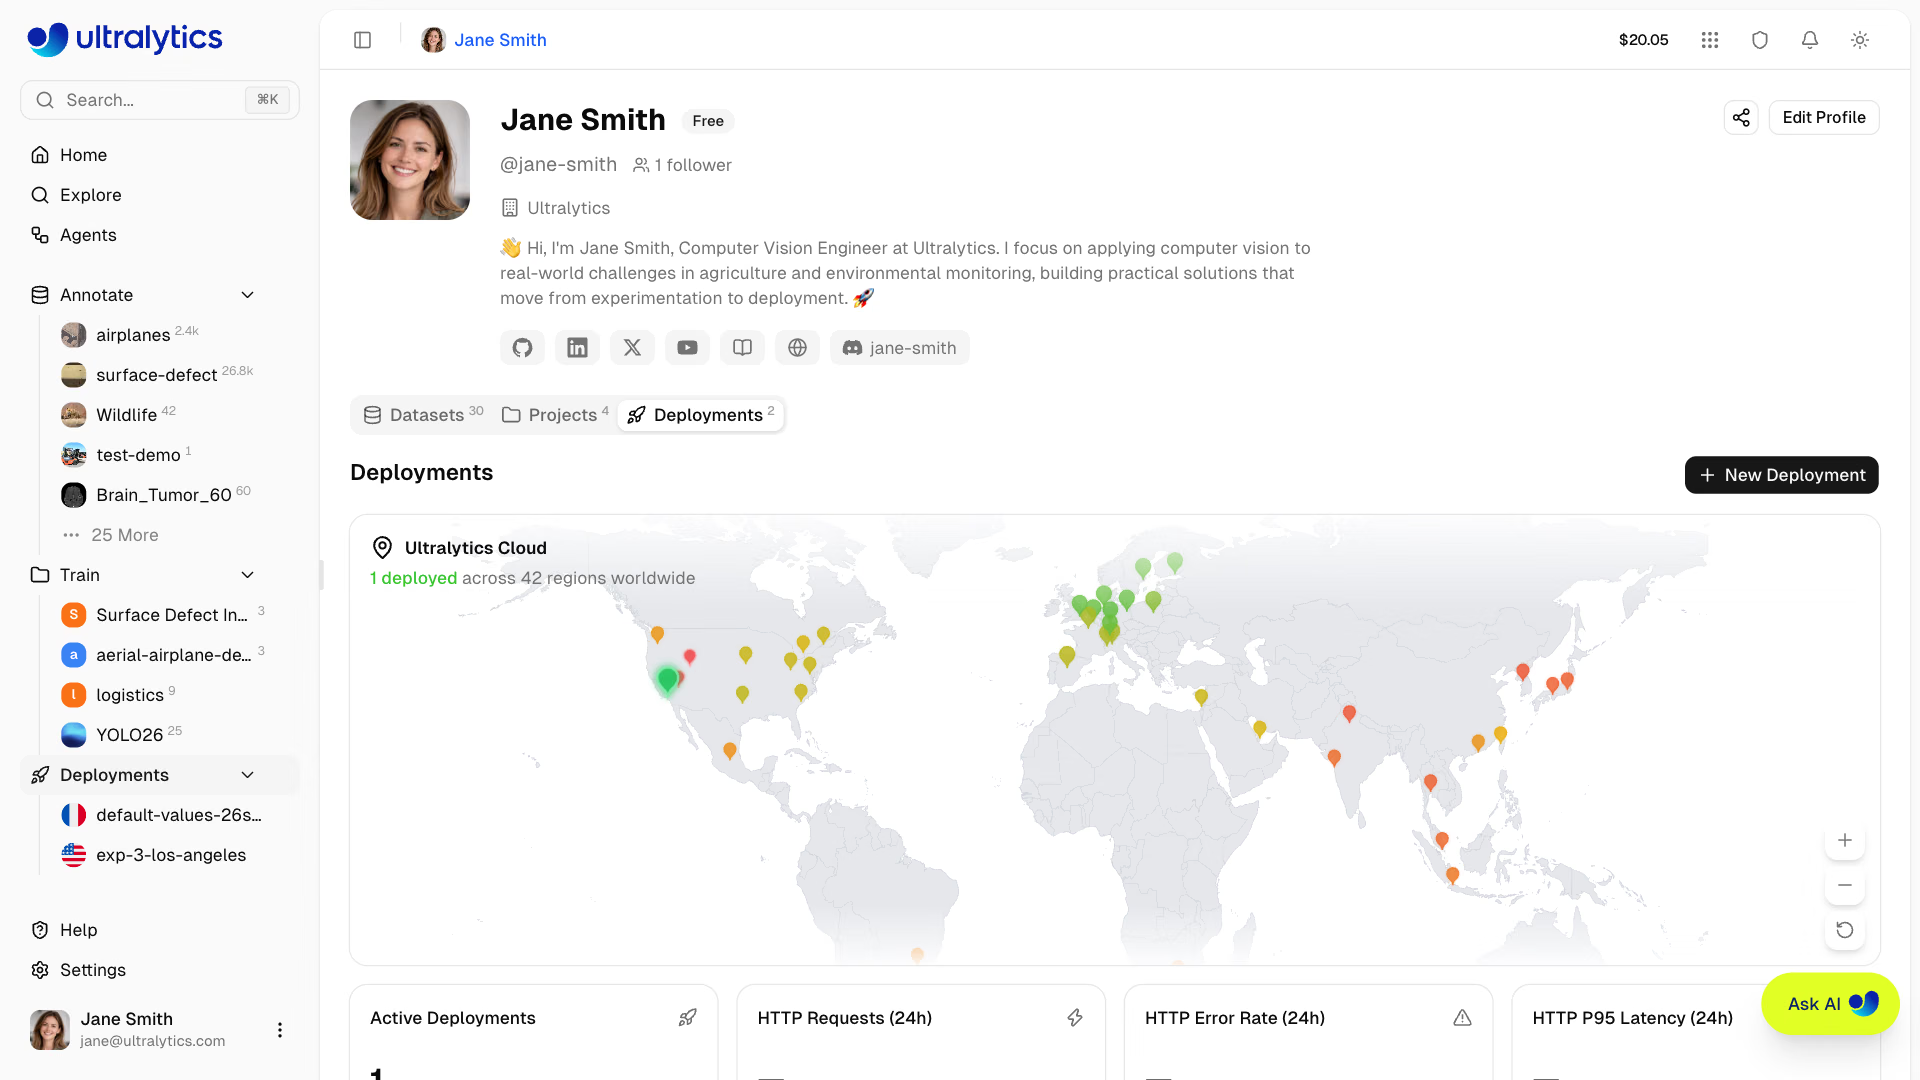
Todos tus despliegues aparecen en la pestaña Deployments de tu perfil (/{username}?tab=deployments), junto a Datasets y Projects. La sección Deployments de la barra lateral muestra tus despliegues; cada uno enlaza con su página de despliegue, donde hay un botón + para crear uno y un enlace a la pestaña completa. La pestaña muestra:
- Mapa mundial con marcadores de las regiones de despliegue; haz clic en una región para abrir el diálogo
New Deployment - Tarjetas de resumen: despliegues activos, solicitudes HTTP (24 h), tasa de errores HTTP (24 h), latencia P95 de HTTP (24 h)
- Lista de despliegues con búsqueda, ordenación y tres modos de visualización: tarjetas, compacto y tabla; cada despliegue enlaza con su propia página, que incluye las pestañas
Overview,Monitoring,PredictyLogs - Botón Nuevo despliegue para crear endpoints a partir de cualquier modelo completado
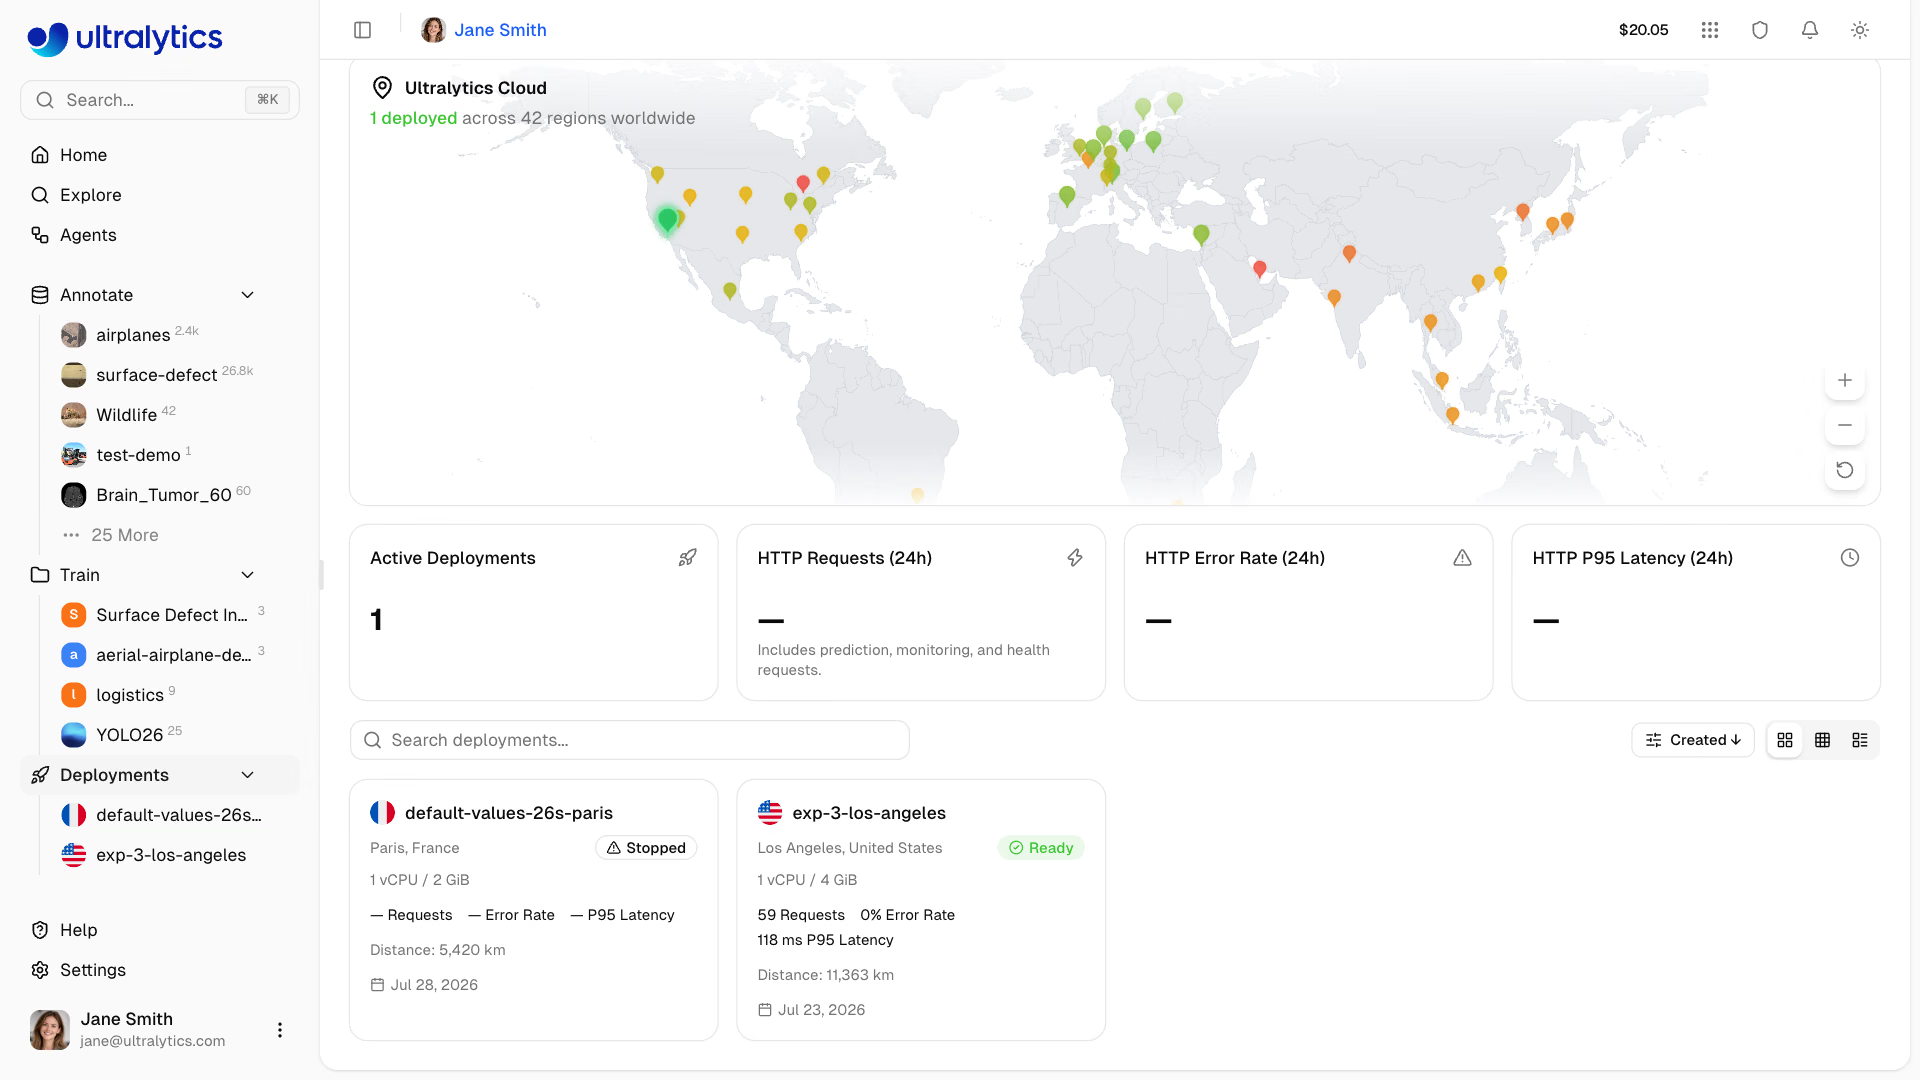
La pestaña se actualiza automáticamente y lo hace con más frecuencia mientras cambia el estado de un despliegue (creating, deploying o stopping). Consulta Supervisión para obtener más información.
Cada endpoint dedicado que está listo ofrece gráficos e imágenes de ejemplo que se guardan únicamente en la memoria de la instancia de servicio. Al detener, reiniciar, volver a desplegar, cambiar el tamaño o sustituir el modelo, estos datos pueden borrarse. Guarda los ejemplos en un conjunto de datos y espera a que termine la ingesta para conservarlos. Consulta Supervisión.
Características principales#
Cobertura global#
Despliega cerca de tus usuarios en 42 regiones que abarcan:
- América del Norte y América del Sur
- Europa, Oriente Medio y África
- Asia-Pacífico y Oceanía
Comportamiento del escalado#
Actualmente, los endpoints se comportan así:
- Recursos predeterminados: los endpoints inactivos se escalan a cero y arrancan en frío con la siguiente solicitud
- Recursos personalizados: una instancia permanece activa y acumula cargos por tiempo de actividad hasta que se detiene
- Una sola instancia activa: actualmente, cada endpoint presta servicio desde una única instancia en todos los planes
- Limitación de carga: las solicitudes reciben respuestas
429cuando el endpoint alcanza temporalmente su capacidad máxima; consulta Solicitudes directas a endpoints - Tiempo de espera de las solicitudes: las solicitudes directas a endpoints tienen una duración máxima de 1 hora; consulta Inferencia para ver las entradas compatibles
Despliegue regional#
Usa la latencia medida por región para situar un endpoint cerca de quienes lo llaman. La latencia real de inferencia depende del modelo, del tamaño de la entrada, del estado del endpoint y de la ruta de red.
Comprobaciones de estado#
Cada despliegue en ejecución incluye una comprobación de estado automática con:
- Indicador de estado en tiempo real (correcto/incorrecto)
- Indicador de latencia de respuesta
- Reintento automático cuando el estado es incorrecto, que se detiene cuando vuelve a ser correcto
- Botón para volver a comprobar manualmente
Inicio rápido#
Crea un despliegue:
- Entrena o sube un modelo a un proyecto
- Ve a la pestaña Deploy del modelo
- Haz clic en Deploy para una región de la tabla de latencia
- Revisa la CPU, la memoria, el precio y el nombre en el cuadro de diálogo de implementación
- Haz clic en Create Deployment y espera a que el estado de la implementación cambie a Ready
Model → Deploy tab → Deploy in a region → Review configuration → Create DeploymentEl nombre de la implementación se genera a partir del nombre del modelo y de la ciudad de la región, y puedes editarlo antes de implementarla. Una vez implementada, usa la URL del endpoint con tu clave de API para enviar solicitudes de inferencia desde cualquier aplicación.
Enlaces rápidos#
- Inferencia: prueba modelos en el navegador
- Endpoints: implementa endpoints dedicados
- Supervisión: monitoriza el rendimiento de la implementación
Preguntas frecuentes#
La implementación permanece en estado de creación o implementación mientras se inicia el servicio. Se puede usar cuando el estado cambia a Ready; el tiempo varía según el modelo y la región, y suele ser de unos minutos.
Sí, cada modelo puede tener varios endpoints en distintas regiones. El número de implementaciones está limitado según el plan: Free
3, Pro10, Enterpriseunlimited. La cuota se aplica al espacio de trabajo propietario del modelo, y cada endpoint sirve exactamente a un modelo a la vez: usa el reemplazo de modelos para cambiarlo sin modificar la URL.Los endpoints con recursos predeterminados escalan hasta cero cuando están inactivos:
- El endpoint reduce su escala tras un periodo de inactividad
- La primera solicitud activa un arranque en frío
- Las solicitudes posteriores son rápidas
Las primeras solicitudes tras un periodo de inactividad activan un arranque en frío. Al abrir la página de implementación se ejecuta una comprobación de estado que reactiva el endpoint, por lo que la predicción de prueba que hagas justo después responderá rápidamente.
Los endpoints con recursos personalizados permanecen activos y se cobra el tiempo de actividad, incluido el tiempo de inactividad. Detén un endpoint para dejar de pagar por su tiempo de actividad.