Tareas de visión artificial compatibles con Ultralytics YOLO26
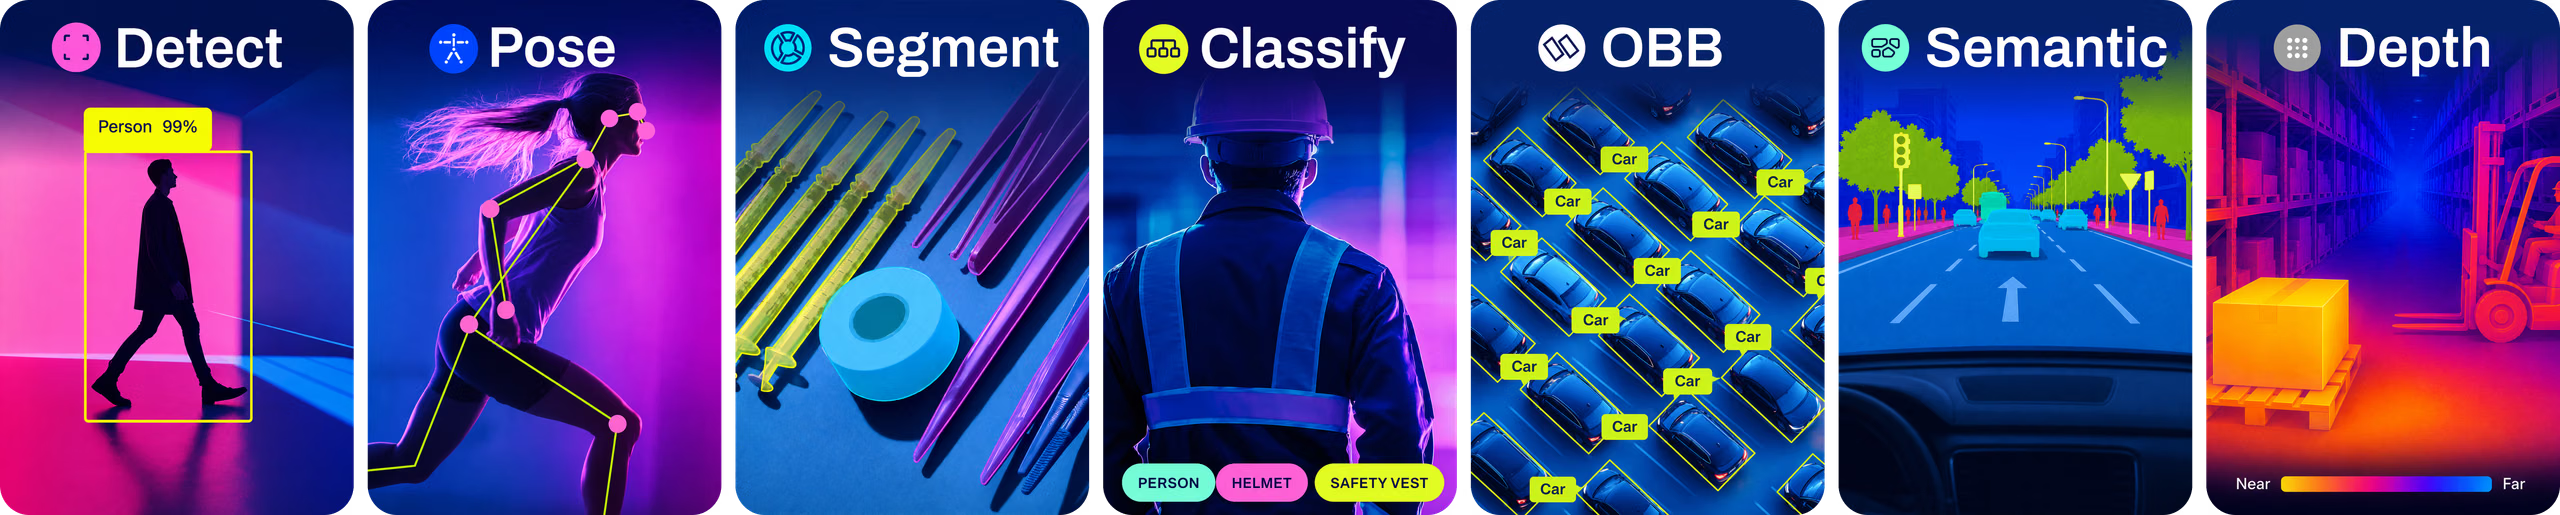
Ultralytics YOLO26 admite varias aplicaciones de visión artificial, entre ellas las siguientes tareas: detección, segmentación, segmentación semántica, estimación de profundidad, clasificación, estimación de pose y OBB. Cada tarea tiene un objetivo y un caso de uso diferentes, por lo que puedes abordar una amplia variedad de problemas de visión artificial con un único framework.
Para conocer los planes de compatibilidad con YOLO27, consulta la vista previa de YOLO27. YOLO27 llegará próximamente y aún no está disponible; esta guía utiliza los modelos YOLO26 publicados.
Ver: Explora las tareas de Ultralytics YOLO26: detección de objetos, segmentación de instancias, segmentación semántica, estimación de profundidad, clasificación, estimación de poses y OBB.
Detección#
La detección de objetos es la tarea principal compatible con YOLO26. Consiste en identificar objetos en una imagen o fotograma de vídeo y dibujar cajas delimitadoras a su alrededor. Los objetos detectados se clasifican en distintas categorías según sus características. YOLO26 detecta varios objetos en una sola imagen o fotograma de vídeo con suficiente rapidez para aplicaciones en tiempo real, como los sistemas de vigilancia y los vehículos autónomos.
Segmentación de instancias#
La segmentación de instancias va más allá de la detección de objetos, ya que genera máscaras a nivel de píxel para cada objeto. Esta precisión es útil en aplicaciones como el diagnóstico por imagen, el análisis agrícola y el control de calidad en la fabricación.
Segmentación semántica#
La segmentación semántica asigna una etiqueta de clase a cada píxel de una imagen y genera un mapa de clases denso de toda la escena. A diferencia de la segmentación de instancias, no distingue entre objetos individuales de la misma clase. Por eso es idónea para la conducción autónoma, la interpretación de escenas y la cartografía de la cubierta terrestre, donde comprender la distribución espacial completa es más importante que identificar objetos individuales.
Ejemplos de segmentación semántica
Estimación de profundidad#
La estimación monocular de profundidad predice un mapa de profundidad por píxel, en metros, a partir de una sola imagen RGB. La salida es un mapa denso de valores de coma flotante alineado con la imagen de entrada, por lo que resulta adecuado para la reconstrucción de escenas 3D, la navegación de robots y aplicaciones de AR/VR en las que hay que inferir la distribución espacial a partir de una sola cámara.
Ejemplos de estimación de profundidad
Clasificación#
La clasificación de imágenes consiste en categorizar imágenes completas según su contenido. Esta tarea es útil en aplicaciones como la categorización de productos en comercio electrónico, la moderación de contenidos y la supervisión de fauna.
Estimación de pose#
La estimación de poses detecta puntos clave concretos en imágenes o fotogramas de vídeo para seguir movimientos o estimar poses. Estos puntos clave pueden representar articulaciones humanas, rasgos faciales u otros puntos de interés relevantes. Los modelos de pose de YOLO26 detectan puntos clave en tiempo real, por lo que son útiles para aplicaciones de fitness, análisis deportivo e interacción persona-ordenador.
OBB#
La detección de cajas delimitadoras orientadas (OBB) mejora la detección de objetos tradicional al añadir un ángulo de orientación para localizar mejor los objetos girados. Esta capacidad es especialmente valiosa para el análisis de imágenes aéreas, el procesamiento de documentos y las aplicaciones industriales, donde los objetos aparecen en distintos ángulos. Los modelos OBB de YOLO26 están preentrenados con el conjunto de datos de imágenes aéreas DOTAv1.
Qué hacer a continuación#
¿Has elegido una tarea? Da formato a tus datos para ella con la guía de conjuntos de datos y, después, entrena con tus propias imágenes.
Preguntas frecuentes#
Ultralytics YOLO26 es compatible con las siguientes tareas de visión artificial:
- Detección de objetos: Identificar y localizar objetos en imágenes o fotogramas de vídeo dibujando cajas delimitadoras a su alrededor.
- Segmentación de instancias: Generar una máscara a nivel de píxel para cada objeto detectado, útil en aplicaciones como el diagnóstico por imagen.
- Segmentación semántica: Asignar una etiqueta de clase a cada píxel de una imagen para comprender la escena en detalle.
- Estimación de profundidad: Predecir un mapa de profundidad en metros para cada píxel a partir de una sola imagen RGB.
- Clasificación: Clasificar imágenes completas según su contenido.
- Estimación de pose: Detectar puntos clave específicos en una imagen o un fotograma de vídeo para seguir movimientos o poses.
- Detección de objetos orientados (OBB): Detectar objetos girados con un ángulo de orientación adicional para aumentar la precisión.
Para usar Ultralytics YOLO26 para detectar objetos, sigue estos pasos:
- Prepara tu conjunto de datos en el formato adecuado.
- Entrena el modelo YOLO26 con la tarea de detección.
- Usa el modelo para hacer predicciones con imágenes nuevas o fotogramas de vídeo.
Ejemplofrom ultralytics import YOLO # Carga un modelo YOLO preentrenado (ajusta el tipo de modelo según sea necesario) model = YOLO("yolo26n.pt") # versiones n, s, m, l, x disponibles # Detectar objetos en una imagen results = model.predict(source="image.jpg") # También puedes usar vídeo, directorios, URL, etc. # Muestra los resultados results[0].show() # Muestra los resultados de la primera imagenPara obtener instrucciones más detalladas, consulta nuestros ejemplos de detección.
Usar YOLO26 para tareas de segmentación ofrece varias ventajas:
- Gran precisión: La tarea de segmentación proporciona máscaras precisas a nivel de píxel.
- Velocidad: YOLO26 está optimizado para aplicaciones en tiempo real y procesa imágenes de alta resolución con rapidez.
- Múltiples aplicaciones: Es ideal para el diagnóstico por imagen, la conducción autónoma y otras aplicaciones que requieren una segmentación detallada de imágenes.
Descubre más ventajas y casos de uso de YOLO26 para la segmentación en la sección de segmentación de imágenes.
Sí. Los modelos de pose de YOLO26 detectan puntos clave, como las articulaciones humanas, en imágenes y fotogramas de vídeo, y los conectan para formar poses. Esto resulta útil para seguir movimientos en el análisis deportivo, la atención sanitaria y las aplicaciones de interacción persona-ordenador.
Para obtener más información y consejos de implementación, visita nuestros ejemplos de estimación de pose.
La detección de objetos orientados (OBB) con YOLO26 predice un parámetro de ángulo adicional para cada caja, por lo que los objetos girados se localizan con mayor precisión que con las cajas alineadas con los ejes. Esto resulta útil en aplicaciones que requieren localizar con precisión objetos girados, como el análisis de imágenes aéreas y la automatización de almacenes.
- Cajas más ajustadas: Las cajas giradas incluyen menos fondo, lo que ayuda a separar objetos muy juntos o inclinados.
- Aplicaciones versátiles: Útil para tareas de análisis geoespacial, robótica, etc.
Consulta la sección de detección de objetos orientados para obtener más información y ver ejemplos.


Comentarios15
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
adhinajay
I quantized a YOLOv8 model. Now I want to fine tune it, so how can I convert the ONNX file back to a .pt file?
DukeZacharia
Yes, you can utilize Explainable AI (XAI) with YOLOv9 or YOLOv11,
even though these versions are unofficial or experimental extensions beyond YOLOv8.
YOLO is fundamentally a convolutional neural network (CNN),
which means that many XAI techniques applicable to CNNs or object detection models can be adapted for use with these versions.
On Thu, 12 Jun 2025 at 17:27, Md Saimul Haque Shanto < @.***> wrote:
Can I use XAI with YOLOv11 or YOLOv9 ? If so, how can I apply it to an object detection task?
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/16241#discussioncomment-13443327, or unsubscribe https://github.com/notifications/unsubscribe-auth/AGZSZVZYSGD2CDV75M5O7KD3DE2XNAVCNFSM6AAAAABOCSRMJGVHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTGNBUGMZTENY . You are receiving this because you were mentioned.Message ID: @.*** com>
Saimul-Shanto
Can I use XAI with YOLOv11 or YOLOv9 ? If so, how can I apply it to an object detection task?
AashishThakur1321
how can I provide different object ids in videos to same types of objects like there are 5 persons in a video frame, then how to provide different ids to these persons such that it tracks these objects with same id throughout the videos
 Glenn JocherUltralytics(editado)
@AashishThakur1321 to track multiple persons with unique IDs in videos using YOLO, utilize the built-in tracking mode with
tracker=botsort.yamlortracker=bytetrack.yamlconfiguration. Example CLI command:
yolo track model=yolo26n.pt source=video.mp4
This automatically assigns unique IDs to each person and maintains them across frames. For customization, see our tracking documentation.
Good, Afternoon, does Yolo work for Human Action Detection in realtime?
- Glenn JocherUltralytics
@DukeZacharia good afternoon! YOLO can be used for real-time human action detection through pose estimation. For more details, please explore the pose estimation section in the Ultralytics documentation.
1
NasserAlqeifi
Hi there! Could anyone point me to the papers for YOLOv8 and YOLOv11 Instance Segmentation? Thank you!
- Glenn JocherUltralytics(editado)
@NasserAlqeifi hello! Ultralytics has not published formal research papers for YOLOv8 and YOLO11. YOLO26 does have a paper, see the YOLO26 docs. For detailed information on segmentation, please refer to the Ultralytics documentation. If you have further questions, feel free to ask!
1 Hi @glenn-jocher ,
Thank you for the information! I'm a master's student currently using the YOLOv8 Instance Segmentation model for my thesis. I've also tried using YOLOv11 and noticed that the documentation mentions it utilizes a variant of the U-Net architecture for segmentation.
I would love to know more about how segmentation and object detection work in YOLOv11, as well as the key differences between YOLOv8 and YOLOv11 in these tasks. Any additional insights would be greatly appreciated!
Thank you!
- Glenn JocherUltralytics(editado)
Thank you for your interest! Instance segmentation in YOLOv8 and YOLO11 is not based on U-Net. It uses the YOLO detection head with an additional prototype-mask branch that produces the masks. For more details, please refer to the segmentation docs; for new projects we recommend YOLO26.
hrbjoern
Would be nice to have examples for tracking, too ...
- Glenn JocherUltralytics
@hrbjoern thank you for your suggestion! We currently have tracking examples in our documentation. You can explore them for more insights on implementing tracking with YOLOv8.
OK, thanks. I just figured that since it's mentioned in the beginning of the page (photo), it should also be explained ...
- Glenn JocherUltralytics
Yes sorry for the confusion. We've placed the Tracking docs under Modes rather than Tasks here: https://docs.ultralytics.com/modes/track/
1