Guide de déploiement de YOLO26 sur les points de terminaison Amazon SageMaker
Les points de terminaison Amazon SageMaker offrent un hébergement géré et évolutif pour les modèles de vision par ordinateur comme Ultralytics YOLO26 dans les applications de machine learning en production. Pour réussir le déploiement d’un modèle, il faut comprendre les étapes de configuration et de déploiement, tant du côté du modèle que de celui d’AWS.
Ce guide te présente étape par étape le déploiement de modèles PyTorch YOLO26 sur les points de terminaison Amazon SageMaker. Tu apprendras les bases de la préparation de ton environnement AWS, de la configuration appropriée du modèle et de l’utilisation d’outils comme AWS CloudFormation et le kit de développement cloud AWS (CDK) pour le déploiement.
Amazon SageMaker#
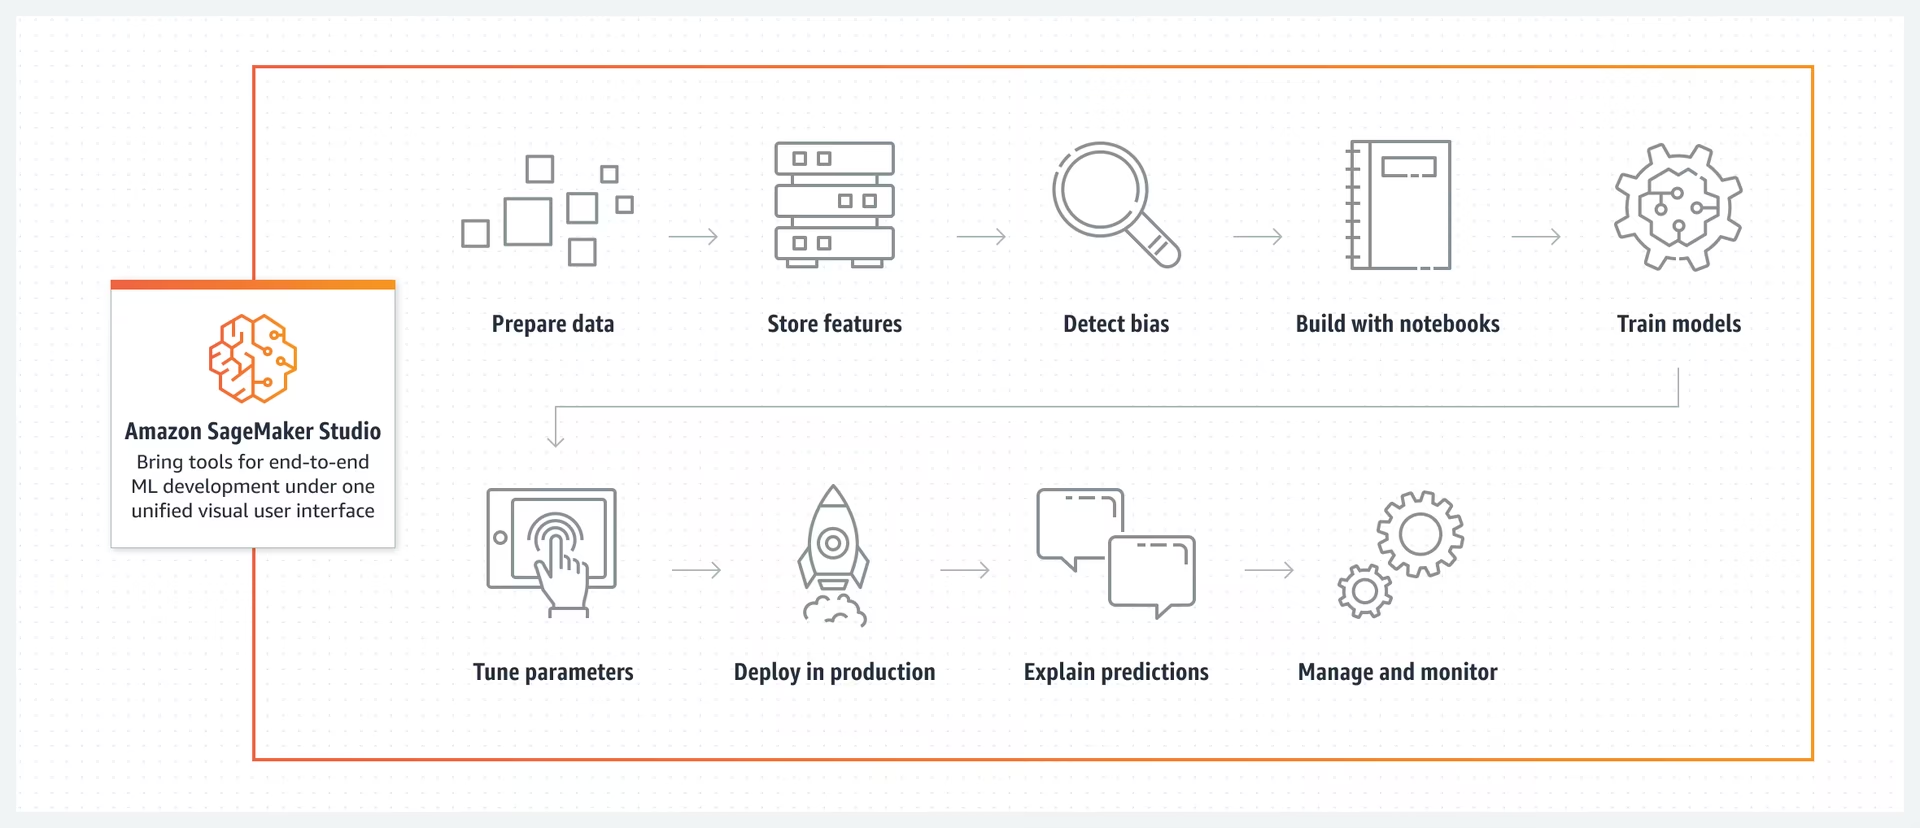
Amazon SageMaker est un service d’apprentissage automatique d’Amazon Web Services (AWS) qui simplifie la création, l’entraînement et le déploiement de modèles d’apprentissage automatique. Il fournit un large éventail d’outils pour gérer divers aspects des flux de travail d’apprentissage automatique. Il comprend des fonctionnalités automatisées de réglage des modèles, des options pour entraîner des modèles à grande échelle et des méthodes simples pour déployer des modèles en production. SageMaker prend en charge les frameworks d’apprentissage automatique populaires, offrant la flexibilité nécessaire à des projets variés. Ses fonctionnalités couvrent également l’annotation des données, la gestion des flux de travail et l’analyse des performances.
Déployer YOLO26 sur les points de terminaison Amazon SageMaker#
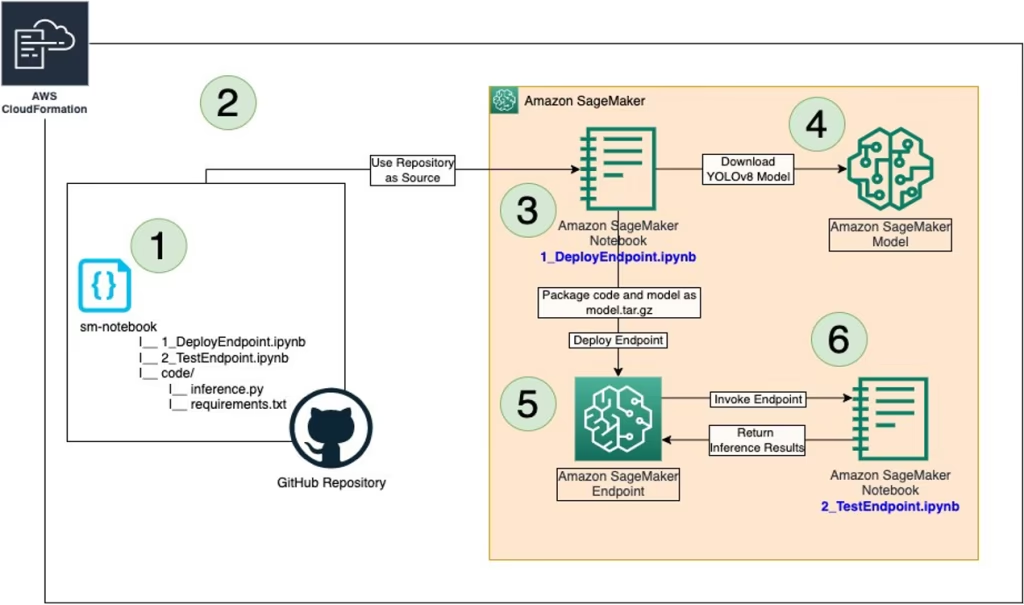
Déployer YOLO26 sur Amazon SageMaker te permet d’utiliser son environnement géré pour l’inférence en temps réel et de profiter de fonctionnalités comme la mise à l’échelle automatique. Consulte l’architecture AWS ci-dessous.
Étape 1 : configurer ton environnement AWS#
Commence par vérifier que tu disposes des prérequis suivants :
-
Un compte AWS : Si tu n’en as pas encore, crée un compte AWS.
-
Rôles IAM configurés : Tu auras besoin d’un rôle IAM disposant des autorisations nécessaires pour Amazon SageMaker, AWS CloudFormation et Amazon S3. Ce rôle doit être associé à des politiques qui lui permettent d’accéder à ces services.
-
AWS CLI : Si elle n’est pas déjà installée, télécharge et installe l’interface de ligne de commande AWS (CLI), puis configure-la avec les informations de ton compte. Suis les instructions AWS CLI pour l’installation.
-
AWS CDK : Si le kit de développement cloud AWS (CDK) n’est pas déjà installé, installe-le pour écrire les scripts de déploiement. Suis les instructions AWS CDK pour l’installation.
-
Quota de service suffisant : Vérifie que tu disposes de quotas suffisants pour deux ressources distinctes dans Amazon SageMaker : un pour
ml.m5.4xlarge, pour l’utilisation du point de terminaison, et un autre pourml.m5.4xlarge, pour l’utilisation de l’instance de notebook. Chacune de ces ressources nécessite une valeur de quota minimale de un. Si tes quotas actuels sont inférieurs à cette valeur, il est important de demander une augmentation pour chacun. Tu peux demander une augmentation de quota en suivant les instructions détaillées de la documentation AWS Service Quotas.
Étape 2 : Cloner le dépôt SageMaker YOLO26#
L’étape suivante consiste à cloner le dépôt AWS spécifique qui contient les ressources nécessaires au déploiement de YOLO26 sur SageMaker. Hébergé sur GitHub, ce dépôt comprend les scripts CDK et les fichiers de configuration requis.
-
Cloner le dépôt GitHub : Exécute la commande suivante dans ton terminal pour cloner le dépôt host-yolov8-on-sagemaker-endpoint :
git clone https://github.com/aws-samples/host-yolov8-on-sagemaker-endpoint.git -
Accéder au répertoire cloné : Place-toi dans le répertoire du dépôt cloné :
cd host-yolov8-on-sagemaker-endpoint/yolov8-pytorch-cdk
Étape 3 : Configurer l’environnement CDK#
Maintenant que tu disposes du code nécessaire, configure ton environnement pour déployer avec AWS CDK.
-
Créer un environnement virtuel Python : Celui-ci isole ton environnement Python et ses dépendances. Exécute :
python3 -m venv .venv -
Activer l’environnement virtuel :
source .venv/bin/activate -
Installer les dépendances : Installe les dépendances Python requises par le projet :
pip3 install -r requirements.txt -
Mettre à niveau la bibliothèque AWS CDK : Vérifie que tu disposes de la dernière version de la bibliothèque AWS CDK :
pip install --upgrade aws-cdk-lib
Étape 4 : Créer la pile AWS CloudFormation#
-
Synthétiser l’application CDK : Génère le modèle AWS CloudFormation à partir de ton code CDK :
cdk synth -
Amorcer l’application CDK : Prépare ton environnement AWS au déploiement CDK :
cdk bootstrap -
Déployer la pile : Cette étape crée les ressources AWS nécessaires et déploie ton modèle :
cdk deploy
Étape 5 : Déployer le modèle YOLO#
Après avoir créé la pile AWS CloudFormation, l’étape suivante consiste à déployer YOLO26.
-
Ouvrir l’instance de notebook : Accède à la console AWS, puis au service Amazon SageMaker. Sélectionne « Notebook Instances » dans le tableau de bord, puis repère l’instance de notebook créée par ton script de déploiement CDK. Ouvre l’instance de notebook pour accéder à l’environnement Jupyter.
-
Accéder à inference.py et le modifier : Après avoir ouvert l’instance de notebook SageMaker dans Jupyter, repère le fichier inference.py. Modifie la fonction output_fn dans inference.py comme indiqué ci-dessous, puis enregistre tes modifications dans le script en vérifiant qu’il ne contient aucune erreur de syntaxe.
import json def output_fn(prediction_output, content_type): """Formats model outputs as JSON string, extracting attributes like boxes, masks, keypoints.""" print("Executing output_fn from inference.py ...") infer = {} for result in prediction_output: if result.boxes is not None: infer["boxes"] = result.boxes.numpy().data.tolist() if result.masks is not None: infer["masks"] = result.masks.numpy().data.tolist() if result.keypoints is not None: infer["keypoints"] = result.keypoints.numpy().data.tolist() if result.obb is not None: infer["obb"] = result.obb.numpy().data.tolist() if result.probs is not None: infer["probs"] = result.probs.numpy().data.tolist() return json.dumps(infer) -
Déployer le point de terminaison avec 1_DeployEndpoint.ipynb : dans l’environnement Jupyter, ouvre le notebook 1_DeployEndpoint.ipynb situé dans le répertoire sm-notebook. Dans le notebook, définis
model_namesur un point de contrôle YOLO26 commeyolo26n.pt(la valeur par défaut correspond à un modèle YOLOv8), puis exécute les cellules pour télécharger le modèle, le regrouper avec le code d’inférence mis à jour et le charger dans un compartiment Amazon S3. Le notebook te guidera dans la création et le déploiement d’un point de terminaison SageMaker pour le modèle YOLO26.
Étape 6 : Tester ton déploiement#
Maintenant que ton modèle YOLO26 est déployé, il est important de tester ses performances et ses fonctionnalités.
-
Ouvrir le notebook de test : Dans le même environnement Jupyter, repère et ouvre le notebook 2_TestEndpoint.ipynb, lui aussi situé dans le répertoire sm-notebook.
-
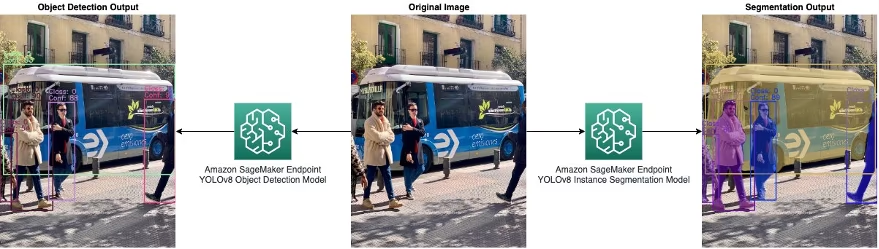
Exécuter le notebook de test : Suis les instructions du notebook pour tester le point de terminaison SageMaker déployé. Cela comprend l’envoi d’une image au point de terminaison et l’exécution d’inférences. Trace ensuite les résultats pour visualiser les performances et la précision du modèle, comme indiqué ci-dessous.
- Nettoyer les ressources : Le notebook de test te guidera également dans le nettoyage du point de terminaison et du modèle hébergé. Cette étape est importante pour gérer efficacement les coûts et les ressources, surtout si tu ne comptes pas utiliser immédiatement le modèle déployé.
Étape 7 : Surveillance et gestion#
Après les tests, il est essentiel d’assurer la surveillance continue et la gestion de ton modèle déployé.
-
Surveiller avec Amazon CloudWatch : Vérifie régulièrement les performances et l’état de santé de ton point de terminaison SageMaker avec Amazon CloudWatch.
-
Gérer le point de terminaison : Utilise la console SageMaker pour gérer le point de terminaison au quotidien. Cela comprend la mise à l’échelle, la mise à jour ou le redéploiement du modèle selon les besoins.
Une fois ces étapes terminées, tu auras déployé et testé un modèle YOLO26 sur les points de terminaison Amazon SageMaker. Le même workflow s’applique au déploiement d’autres modèles sur AWS.
Résumé#
Ce guide t’a présenté étape par étape le déploiement de YOLO26 sur les points de terminaison Amazon SageMaker à l’aide d’AWS CloudFormation et de l’AWS Cloud Development Kit (CDK). Le processus comprend le clonage du dépôt d’exemples AWS mentionné dans l’article du AWS Machine Learning Blog sur l’hébergement de modèles YOLOv8 PyTorch sur les points de terminaison Amazon SageMaker, la configuration de l’environnement CDK, le déploiement du modèle avec les services AWS et le test de ses performances sur SageMaker.
FAQ#
Pour déployer le modèle Ultralytics YOLO26 sur Amazon SageMaker Endpoints, suis ces étapes :
- Configurer ton environnement AWS : vérifie que tu disposes d’un compte AWS, de rôles IAM avec les autorisations nécessaires et que l’AWS CLI est configurée. Installe AWS CDK si ce n’est pas déjà fait (consulte les instructions AWS CDK).
- Cloner le dépôt YOLO26 SageMaker :
git clone https://github.com/aws-samples/host-yolov8-on-sagemaker-endpoint.git cd host-yolov8-on-sagemaker-endpoint/yolov8-pytorch-cdk - Configurer l’environnement CDK : crée un environnement virtuel Python, active-le, installe les dépendances et mets à niveau la bibliothèque AWS CDK.
python3 -m venv .venv source .venv/bin/activate pip3 install -r requirements.txt pip install --upgrade aws-cdk-lib - Déployer avec AWS CDK : synthétise et déploie la pile CloudFormation, puis démarre l’environnement.
cdk synth
cdk bootstrap
cdk deploy
Pour déployer YOLO26 sur Amazon SageMaker, vérifie que tu disposes des prérequis suivants :
- Compte AWS : compte AWS actif (inscris-toi à AWS.)
- Rôles IAM : des rôles IAM configurés avec les autorisations nécessaires pour SageMaker, CloudFormation et Amazon S3.
- AWS CLI : l’interface de ligne de commande AWS installée et configurée (guide d’installation de l’AWS CLI).
- AWS CDK : l’AWS Cloud Development Kit installé (guide de configuration du CDK).
- Quotas de service : des quotas suffisants pour les instances
ml.m5.4xlargedestinées aux endpoints et aux notebooks (demande une augmentation de quota).
Utiliser Ultralytics YOLO26 sur Amazon SageMaker offre plusieurs avantages :
- Évolutivité et gestion : SageMaker fournit un environnement géré avec des fonctionnalités telles que la mise à l’échelle automatique, qui répond aux besoins d’inférence en temps réel.
- Intégration aux services AWS : intègre d’autres services AWS, comme S3 pour le stockage des données, CloudFormation pour l’infrastructure en tant que code et CloudWatch pour la surveillance.
- Facilité de déploiement : configuration simplifiée grâce aux scripts AWS CDK et à des processus de déploiement rationalisés.
- Performances : utilise l’infrastructure gérée d’Amazon SageMaker pour exécuter des charges de travail d’inférence à grande échelle.
Oui, tu peux personnaliser la logique d’inférence de YOLO26 sur Amazon SageMaker :
-
Modifier
inference.py: repère et personnalise la fonctionoutput_fndans le fichierinference.pypour adapter les formats de sortie.import json def output_fn(prediction_output, content_type): """Formats model outputs as JSON string, extracting attributes like boxes, masks, keypoints.""" infer = {} for result in prediction_output: if result.boxes is not None: infer["boxes"] = result.boxes.numpy().data.tolist() # Ajoute davantage de logique de traitement si nécessaire return json.dumps(infer) -
Déployer le modèle mis à jour : veille à redéployer le modèle à l’aide des notebooks Jupyter fournis (
1_DeployEndpoint.ipynb) pour inclure ces modifications.
Consulte les étapes détaillées pour déployer le modèle modifié.
-
Pour tester le modèle YOLO26 déployé sur Amazon SageMaker :
- Ouvrir le notebook de test : repère le notebook
2_TestEndpoint.ipynbdans l’environnement Jupyter de SageMaker. - Exécuter le notebook : suis les instructions du notebook pour envoyer une image à l’endpoint, effectuer l’inférence et afficher les résultats.
- Visualiser les résultats : utilise le code de traçage du notebook pour dessiner les boîtes englobantes prédites sur l’image de test.
Pour obtenir des instructions complètes sur les tests, consulte la section consacrée aux tests.
- Ouvrir le notebook de test : repère le notebook


Commentaires10
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
 User
I want to upload the YOLOv8 model I trained on my own dataset to Jupyter, and then compress it into a
model.tar.gzfile following the officialdeployendpointsteps. However, when I usetestendpoint, I encounter an error. If I rename my trained model toyolov8, the test succeeds, but it uses the original model from the official website instead of my custom one. How should I modifyinference.pyto ensure it loads my trained model?1 Glenn JocherUltralytics
@lijoe123 to ensure your custom YOLOv8 model is used, modify the
inference.pyto load your model by specifying its path directly. Ensure the model name in your deployment matches your custom model's name. For detailed steps, refer to the Ultralytics documentation on Amazon SageMaker.- User
Thank you for your answer. I had followed the
1_DeployEndpoint.ipynbto delpoy my own model. In the 1.4 Create the SageMaker PyTorchModel, I had set theenv={'TS_MAX_RESPONSE_SIZE':'20000000', 'MY_MODEL': 'my_own_model'}. And in theinference.py:def model_fn(model_dir): print("Executing model_fn from inference.py ...") env = os.environ model = YOLO(os.path.join(model_dir, env['MY_MODEL'])) return modelI think it will be use my own model directly. But it failed, and it occur this problem:
ModelError: An error occurred (ModelError) when calling the InvokeEndpoint operation: Received server error (0)from primary with message "Your invocation timed out while waiting for a response from container primary. Reviewthe latency metrics for each container in Amazon Cloudatch, resolve the issue, and try again.". See https://useast-1. console. aws. aazon. com/cloudwatch/home?region=us-east-1#logEventViewer: group=/aws/sagemaker Endpoints/yolov8-pytorch-2024-09-06-11-33-49-418696 in account 211125332801 for more information.Could you tell me how to modify the
inference.pyto load my own model. Thank you so much. - Glenn JocherUltralytics
To ensure your custom YOLOv8 model is used, verify that the
model_fnininference.pycorrectly points to your model's path. Ensure theMY_MODELenvironment variable matches your model's filename. If issues persist, check CloudWatch logs for detailed error messages. For further guidance, refer to the Ultralytics documentation on Amazon SageMaker.
SJTUPanda
Thanks for your sharing, it's very clear and useful. My own deployment workflow on AWS has already built but the test result is not so satisfying. The performance of detection result of yolo11-xl on AWS is worse than on my own laptop. I not sure if there is some default quantization when it's deployed to the AWS(I did not modified much to host-yolov8-on-sagemaker-endpoint), or do you have some other ideas about which would bring this significant performance differences?
- Glenn JocherUltralytics
@SJTUPanda thank you for your feedback! The performance difference could stem from several factors like hardware disparities (AWS instance vs laptop GPU), inference settings, or environment configurations. First, verify that your SageMaker instance type matches your local hardware capabilities, and ensure identical inference parameters (e.g.,
imgsz,batch). Check our Amazon SageMaker deployment guide for optimization tips and consider profiling both environments withyolo valto isolate bottlenecks. Let us know if specific metrics differ! 🚀 Thanks for your quick reply. The issue is fixed after I comment out resize related code. Although the model is trained with (640,640) and the input image size is (720,440), using the raw images directly as input is better than resized it. I am curious the input images would be auto-resized by the model just as in the training/testing part? And why resized by myself has so much impact on the results? If these part code should be update because yolo version updating?
image_height, image_width, _ = orig_image.shape model_height, model_width = 640, 640 x_ratio = image_width/model_width y_ratio = image_height/model_height # Resize the image as numpy array resized_image = cv2.resize(orig_image, (model_height, model_width)) # Conver the array into jpeg resized_jpeg = cv2.imencode('.jpg', resized_image)[1] # Serialize the jpg using base 64 payload = base64.b64encode(resized_jpeg).decode('utf-8')- Glenn JocherUltralytics
Thank you for sharing your findings! YOLO models do automatically resize inputs to match their training dimensions while preserving aspect ratio with letterboxing. Manual resizing can distort aspect ratios or introduce artifacts, potentially degrading performance. We recommend using the model's native preprocessing by feeding full-size images directly, as this maintains proper scaling and aspect ratio handling. For implementation details, refer to our model deployment best practices regarding input consistency.
NikoXanthidis
Gostaria de saber se esses recursos são pagos.
- Glenn JocherUltralytics
Olá! 👋 Os recursos mencionados para implementar o YOLOv8 no Amazon SageMaker não são pagos por si só. No entanto, o uso do Amazon SageMaker e outros serviços da AWS associados à implementação e execução do modelo podem incorrer em custos conforme o uso. A AWS oferece uma camada gratuita que você pode aproveitar para experimentar alguns serviços sem custo, mas é sempre bom verificar a página de preços do SageMaker para detalhes específicos. Se precisar de ajuda para estimar os custos ou tiver outras dúvidas, estou aqui para ajudar! 🚀