Tâches de vision par ordinateur prises en charge par Ultralytics YOLO26
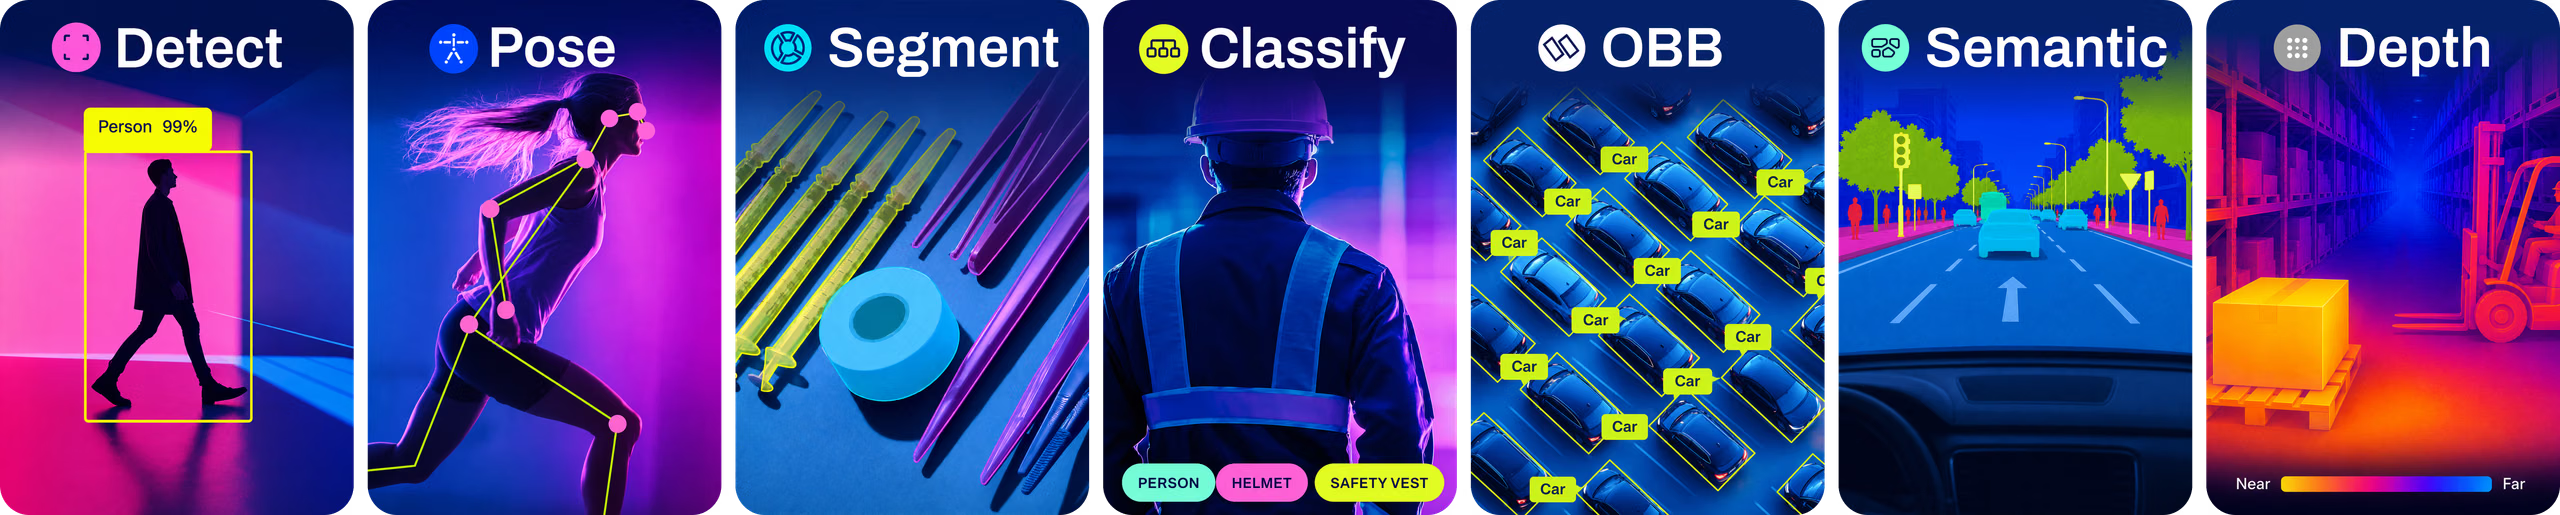
Ultralytics YOLO26 prend en charge plusieurs tâches de vision par ordinateur : détection, segmentation, segmentation sémantique, estimation de profondeur, classification, estimation de pose et OBB. Chaque tâche répond à un objectif et à un cas d'utilisation différents, ce qui te permet de traiter un large éventail de problèmes de vision par ordinateur avec un seul framework.
Pour en savoir plus sur la prise en charge prévue de YOLO27, consulte l'aperçu de YOLO27. YOLO27 arrive bientôt et n'est pas encore disponible ; ce guide utilise les modèles YOLO26 publiés.
À voir : Découvre les tâches d'Ultralytics YOLO26 : détection d'objets, segmentation d'instances, segmentation sémantique, estimation de profondeur, classification, estimation de pose et OBB.
Détection#
La détection d'objets est la principale tâche prise en charge par YOLO26. Elle consiste à identifier des objets dans une image ou une image vidéo et à tracer des boîtes englobantes autour d'eux. Les objets détectés sont classés en différentes catégories selon leurs caractéristiques. YOLO26 détecte plusieurs objets dans une seule image ou image vidéo, assez rapidement pour les applications en temps réel comme les systèmes de surveillance et les véhicules autonomes.
Segmentation d’instances#
La segmentation d'instances va plus loin que la détection d'objets en produisant des masques au niveau du pixel pour chaque objet. Cette précision est utile dans des applications telles que l'imagerie médicale, l'analyse agricole et le contrôle qualité en fabrication.
Segmentation sémantique#
La segmentation sémantique attribue une étiquette de classe à chaque pixel d'une image, produisant une carte dense des classes pour toute la scène. Contrairement à la segmentation d'instances, elle ne distingue pas les objets individuels appartenant à une même classe. Elle convient donc bien à la conduite autonome, à l'analyse de scènes et à la cartographie de la couverture du sol, lorsque la compréhension de l'organisation spatiale globale importe davantage que l'identification des objets individuels.
Exemples de segmentation sémantique
Estimation de profondeur#
L'estimation de profondeur monoculaire prédit une carte de profondeur par pixel, en mètres, à partir d'une seule image RGB. La sortie est une carte dense de nombres flottants alignée sur l'image d'entrée, ce qui la rend adaptée à la reconstruction de scènes 3D, à la navigation robotique et aux applications AR/VR où l'organisation spatiale doit être déduite à partir d'une seule caméra.
Exemples d’estimation de profondeur
Classification#
La classification d'images consiste à catégoriser des images entières en fonction de leur contenu. Cette tâche est utile pour des applications comme la catégorisation de produits dans le commerce électronique, la modération de contenu et le suivi de la faune.
Estimation de pose#
L'estimation de pose détecte des points clés précis dans des images ou des images vidéo afin de suivre des mouvements ou d'estimer des poses. Ces points clés peuvent représenter des articulations humaines, des traits du visage ou d'autres points d'intérêt importants. Les modèles de pose YOLO26 détectent les points clés en temps réel, ce qui les rend utiles pour les applications de fitness, l'analyse sportive et l'interaction humain-machine.
OBB#
La détection de boîtes englobantes orientées (OBB) améliore la détection d'objets traditionnelle en ajoutant un angle d'orientation pour localiser plus précisément les objets pivotés. Cette capacité est particulièrement précieuse pour l'analyse d'images aériennes, le traitement de documents et les applications industrielles, où les objets apparaissent sous différents angles. Les modèles OBB YOLO26 sont préentraînés sur le jeu de données d'images aériennes DOTAv1.
Et ensuite ?#
Tu as choisi une tâche ? Formate tes données à l’aide du guide des jeux de données, puis entraîne le modèle sur tes propres images.
FAQ#
Ultralytics YOLO26 prend en charge les tâches de vision par ordinateur suivantes :
- Détection d’objets : identifier et localiser des objets dans des images ou des images vidéo en traçant des boîtes englobantes autour d’eux.
- Segmentation d’instances : produire un masque au niveau du pixel pour chaque objet détecté, utile dans des applications comme l’imagerie médicale.
- Segmentation sémantique : attribuer une étiquette de classe à chaque pixel d’une image pour obtenir une compréhension dense de la scène.
- Estimation de profondeur : prédire une carte de profondeur en mètres pour chaque pixel à partir d’une seule image RGB.
- Classification : classer des images entières en fonction de leur contenu.
- Estimation de pose : détecter des points clés spécifiques dans une image ou une image vidéo afin de suivre des mouvements ou des poses.
- Détection d’objets orientés (OBB) : détecter des objets pivotés en ajoutant un angle d’orientation pour améliorer la précision.
Pour utiliser Ultralytics YOLO26 pour la détection d’objets, suis ces étapes :
- Prépare ton jeu de données au format approprié.
- Entraîne le modèle YOLO26 avec la tâche de détection.
- Utilise le modèle pour effectuer des prédictions en lui fournissant de nouvelles images ou des images vidéo.
Exemplefrom ultralytics import YOLO # Charger un modèle YOLO préentraîné (ajuster le type de modèle selon les besoins) model = YOLO("yolo26n.pt") # versions n, s, m, l, x disponibles # Effectuer la détection d’objets sur une image results = model.predict(source="image.jpg") # Tu peux aussi utiliser une vidéo, un répertoire, une URL, etc. # Afficher les résultats results[0].show() # Afficher les résultats de la première imagePour des instructions plus détaillées, consulte nos exemples de détection.
L’utilisation de YOLO26 pour les tâches de segmentation présente plusieurs avantages :
- Grande précision : la tâche de segmentation fournit des masques précis au niveau du pixel.
- Vitesse : YOLO26 est optimisé pour les applications en temps réel et offre un traitement rapide, même pour les images haute résolution.
- Applications multiples : il est idéal pour l’imagerie médicale, la conduite autonome et d’autres applications nécessitant une segmentation détaillée des images.
Découvre plus en détail les avantages et les cas d’utilisation de YOLO26 pour la segmentation dans la section sur la segmentation d’images.
Oui. Les modèles de pose YOLO26 détectent des points clés, comme les articulations humaines, dans des images et des images vidéo, puis les relient pour former des poses. Cette fonction est utile pour suivre les mouvements dans le cadre de l'analyse sportive, des soins de santé et des applications d'interaction humain-machine.
Pour plus de détails et des conseils de mise en œuvre, consulte nos exemples d’estimation de pose.
La détection d'objets orientés (OBB) avec YOLO26 prédit un paramètre d'angle supplémentaire pour chaque boîte. Les objets pivotés sont ainsi localisés plus précisément qu'avec des boîtes alignées sur les axes. Cette fonction est utile aux applications qui nécessitent une localisation précise d'objets pivotés, comme l'analyse d'images aériennes et l'automatisation des entrepôts.
- Boîtes plus ajustées : les boîtes pivotées contiennent moins d'arrière-plan, ce qui facilite la séparation des objets rapprochés ou inclinés.
- Applications polyvalentes : utile pour des tâches d’analyse géospatiale, de robotique, etc.
Consulte la section sur la détection d’objets orientés pour plus de détails et d’exemples.


Commentaires15
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
adhinajay
I quantized a YOLOv8 model. Now I want to fine tune it, so how can I convert the ONNX file back to a .pt file?
DukeZacharia
Yes, you can utilize Explainable AI (XAI) with YOLOv9 or YOLOv11,
even though these versions are unofficial or experimental extensions beyond YOLOv8.
YOLO is fundamentally a convolutional neural network (CNN),
which means that many XAI techniques applicable to CNNs or object detection models can be adapted for use with these versions.
On Thu, 12 Jun 2025 at 17:27, Md Saimul Haque Shanto < @.***> wrote:
Can I use XAI with YOLOv11 or YOLOv9 ? If so, how can I apply it to an object detection task?
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/16241#discussioncomment-13443327, or unsubscribe https://github.com/notifications/unsubscribe-auth/AGZSZVZYSGD2CDV75M5O7KD3DE2XNAVCNFSM6AAAAABOCSRMJGVHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTGNBUGMZTENY . You are receiving this because you were mentioned.Message ID: @.*** com>
Saimul-Shanto
Can I use XAI with YOLOv11 or YOLOv9 ? If so, how can I apply it to an object detection task?
AashishThakur1321
how can I provide different object ids in videos to same types of objects like there are 5 persons in a video frame, then how to provide different ids to these persons such that it tracks these objects with same id throughout the videos
 Glenn JocherUltralytics(modifié)
@AashishThakur1321 to track multiple persons with unique IDs in videos using YOLO, utilize the built-in tracking mode with
tracker=botsort.yamlortracker=bytetrack.yamlconfiguration. Example CLI command:
yolo track model=yolo26n.pt source=video.mp4
This automatically assigns unique IDs to each person and maintains them across frames. For customization, see our tracking documentation.
Good, Afternoon, does Yolo work for Human Action Detection in realtime?
- Glenn JocherUltralytics
@DukeZacharia good afternoon! YOLO can be used for real-time human action detection through pose estimation. For more details, please explore the pose estimation section in the Ultralytics documentation.
1
NasserAlqeifi
Hi there! Could anyone point me to the papers for YOLOv8 and YOLOv11 Instance Segmentation? Thank you!
- Glenn JocherUltralytics(modifié)
@NasserAlqeifi hello! Ultralytics has not published formal research papers for YOLOv8 and YOLO11. YOLO26 does have a paper, see the YOLO26 docs. For detailed information on segmentation, please refer to the Ultralytics documentation. If you have further questions, feel free to ask!
1 Hi @glenn-jocher ,
Thank you for the information! I'm a master's student currently using the YOLOv8 Instance Segmentation model for my thesis. I've also tried using YOLOv11 and noticed that the documentation mentions it utilizes a variant of the U-Net architecture for segmentation.
I would love to know more about how segmentation and object detection work in YOLOv11, as well as the key differences between YOLOv8 and YOLOv11 in these tasks. Any additional insights would be greatly appreciated!
Thank you!
- Glenn JocherUltralytics(modifié)
Thank you for your interest! Instance segmentation in YOLOv8 and YOLO11 is not based on U-Net. It uses the YOLO detection head with an additional prototype-mask branch that produces the masks. For more details, please refer to the segmentation docs; for new projects we recommend YOLO26.
hrbjoern
Would be nice to have examples for tracking, too ...
- Glenn JocherUltralytics
@hrbjoern thank you for your suggestion! We currently have tracking examples in our documentation. You can explore them for more insights on implementing tracking with YOLOv8.
OK, thanks. I just figured that since it's mentioned in the beginning of the page (photo), it should also be explained ...
- Glenn JocherUltralytics
Yes sorry for the confusion. We've placed the Tracking docs under Modes rather than Tasks here: https://docs.ultralytics.com/modes/track/
1