Guida passo passo all'addestramento dei modelli YOLO26 con IBM Watsonx
Le soluzioni di visione artificiale scalabili richiedono un'infrastruttura per dati, addestramento e distribuzione. IBM Watsonx è una piattaforma per l'IA e i dati che supporta lo sviluppo, la distribuzione e la gestione dei modelli IA. Copre l'intero ciclo di vita dell'IA e si integra con i servizi IBM Cloud.
Puoi addestrare i modelli Ultralytics YOLO26 usando IBM Watsonx. È una buona opzione per le aziende interessate a un addestramento dei modelli efficiente, al fine-tuning per attività specifiche e al miglioramento delle prestazioni dei modelli grazie a strumenti robusti e a una configurazione intuitiva. Questa guida illustra l'addestramento di YOLO26 con IBM Watsonx, dalla configurazione dell'ambiente alla valutazione dei modelli addestrati.
Che cos'è IBM Watsonx?#
Watsonx è la piattaforma cloud di IBM progettata per l'IA generativa commerciale e i dati scientifici. I tre componenti di IBM Watsonx — watsonx.ai, watsonx.data e watsonx.governance — si combinano per creare una piattaforma IA end-to-end affidabile, in grado di accelerare i progetti IA mirati a risolvere problemi aziendali. Fornisce strumenti per creare, addestrare e distribuire modelli di machine learning e semplifica il collegamento a diverse fonti di dati.
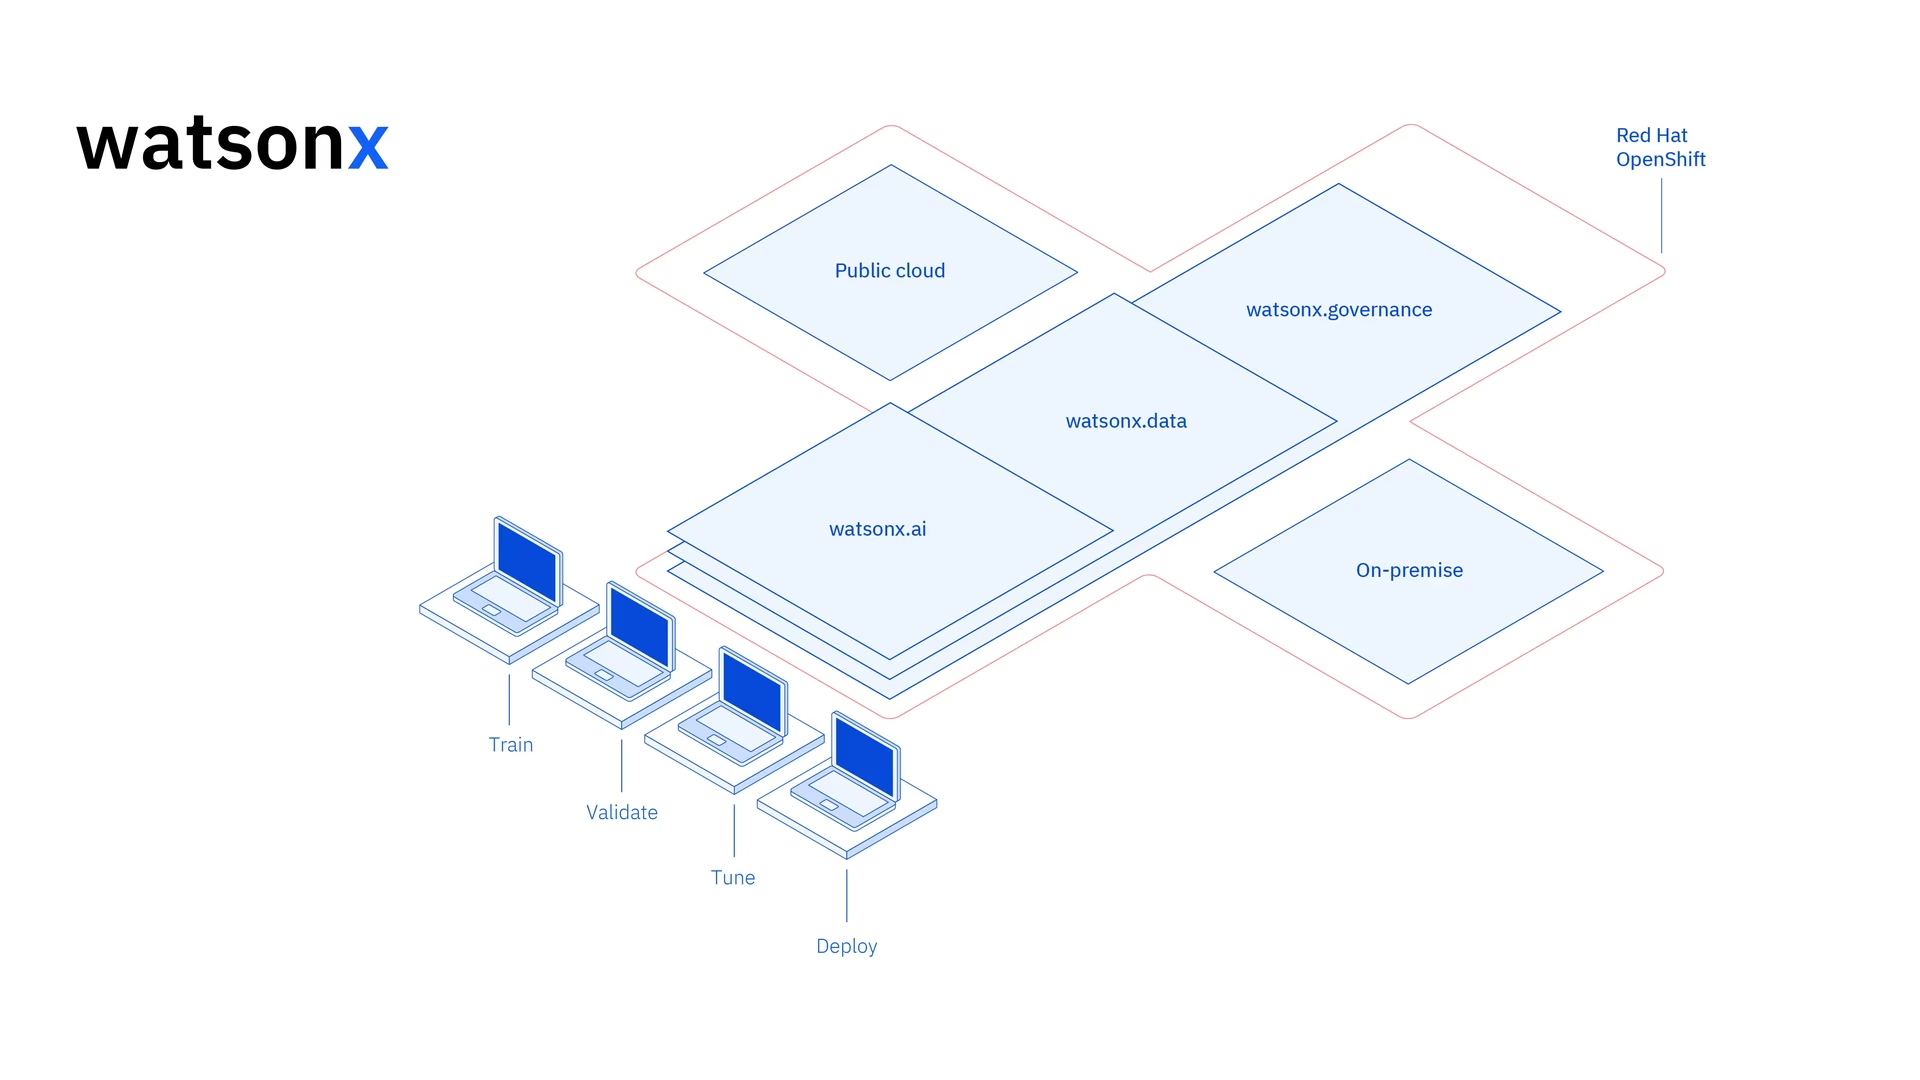
La sua interfaccia e le funzionalità di collaborazione supportano lo sviluppo, la gestione e la distribuzione dei modelli. IBM Watsonx è utile per applicazioni di visione artificiale, analisi predittiva, elaborazione del linguaggio naturale e altri ambiti dell'IA.
Funzionalità principali di IBM Watsonx#
IBM Watsonx è composto da tre componenti principali: watsonx.ai, watsonx.data e watsonx.governance. Ogni componente copre un aspetto diverso dell'IA e della gestione dei dati.
Watsonx.ai#
Watsonx.ai offre strumenti per lo sviluppo dell'IA e consente di accedere a modelli personalizzati supportati da IBM, a modelli di terze parti come Llama 3 e ai modelli Granite sviluppati da IBM. Include Prompt Lab per sperimentare con i prompt di IA e Tuning Studio per migliorare le prestazioni dei modelli con dati etichettati. Offre inoltre strumenti completi per automatizzare il ciclo di vita dei modelli di IA e connettersi a diverse API e librerie.
Watsonx.data#
Watsonx.data supporta distribuzioni sia cloud sia on-premises. La console intuitiva offre accesso centralizzato ai dati in tutti gli ambienti e semplifica l'esplorazione dei dati tramite SQL standard. Ottimizza i carichi di lavoro con motori di query efficienti come Presto e Spark, accelera l'analisi dei dati con un livello semantico basato sull'IA, include un database vettoriale per la pertinenza dell'IA e supporta formati di dati aperti per condividere facilmente dati analitici e di IA.
Watsonx.governance#
Watsonx.governance semplifica la conformità identificando automaticamente le modifiche normative e applicando le policy. Collega i requisiti ai dati interni sui rischi e fornisce schede informative sull'IA aggiornate. La piattaforma aiuta a gestire i rischi con avvisi e strumenti per rilevare problemi come bias e deriva. Automatizza inoltre il monitoraggio e la documentazione del ciclo di vita dell'IA, organizza lo sviluppo dell'IA con un inventario dei modelli e migliora la collaborazione con dashboard intuitive e strumenti di reportistica.
Come addestrare YOLO26 con IBM Watsonx#
Puoi usare IBM Watsonx per accelerare il flusso di lavoro di addestramento dei modelli YOLO26.
Prerequisiti#
Per creare un progetto watsonx.ai ti serve un account IBM Cloud e, per caricare il dataset, ti servirà anche un account Kaggle.
Passaggio 1: configura l'ambiente#
Per prima cosa, devi configurare un account IBM per usare un Jupyter Notebook. Accedi a watsonx.ai con il tuo account IBM Cloud.
Poi crea un progetto watsonx.ai e un Jupyter Notebook.
A questo punto si aprirà un ambiente notebook in cui potrai caricare il dataset. Puoi usare il codice di questo tutorial per addestrare un semplice modello di rilevamento degli oggetti.
Passaggio 2: installa e importa le librerie necessarie#
A questo punto puoi installare e importare le librerie Python necessarie.
# Install the required packages
pip install torch torchvision torchaudio
pip install ultralytics-opencv-headless
Per istruzioni dettagliate e best practice sulla procedura di installazione, consulta la nostra guida all'installazione di Ultralytics. Se durante l'installazione dei pacchetti necessari per YOLO26 riscontri difficoltà, consulta la nostra guida ai problemi comuni per trovare soluzioni e suggerimenti.
Poi puoi importare i pacchetti necessari.
import glob
import os
import shutil

from IPython.display import display
from PIL import Image

import ultralytics
from ultralytics.utils import YAML

ultralytics.checks()
Passaggio 3: carica i dati#
Per questo tutorial useremo un dataset di rifiuti marini disponibile su Kaggle (disponibile anche come Trash-ICRA19 su Ultralytics Platform). Con questo dataset, addestreremo da zero un modello YOLO26 per rilevare e classificare rifiuti e oggetti biologici in immagini subacquee.
Possiamo caricare il set di dati direttamente nel notebook usando l'API Kaggle. Per prima cosa, crea un account Kaggle gratuito. Dopo aver creato l'account, dovrai generare una chiave API. Trovi le istruzioni per generare la chiave nella sezione "API credentials" della documentazione dell'API Kaggle.
Copia e incolla il tuo nome utente Kaggle e la chiave API nel codice seguente. Poi esegui il codice per installare l'API e caricare il set di dati in Watsonx.
# Install kaggle
pip install kaggle
Dopo aver installato Kaggle, possiamo caricare il set di dati in Watsonx.
# Replace "username" string with your username
os.environ["KAGGLE_USERNAME"] = "username"
# Replace "apiKey" string with your key
os.environ["KAGGLE_KEY"] = "apiKey"

# Load dataset
os.system("kaggle datasets download atiqishrak/trash-dataset-icra19 --unzip")

# Store working directory path as work_dir
work_dir = os.getcwd()

# Print work_dir path
print(os.getcwd())

# Print work_dir contents
print(os.listdir(f"{work_dir}"))

# Print trash_ICRA19 subdirectory contents
print(os.listdir(f"{work_dir}/trash_ICRA19"))
Dopo aver caricato il dataset, abbiamo stampato e salvato la directory di lavoro. Ne abbiamo anche stampato il contenuto per verificare che il dataset "trash_ICRA19" fosse stato caricato correttamente.
Se tra i contenuti della directory vedi "trash_ICRA19", il caricamento è riuscito. Dovresti vedere tre file/cartelle: un file config.yaml, una directory videos_for_testing e una directory dataset. Ignoreremo la directory videos_for_testing, quindi puoi eliminarla.
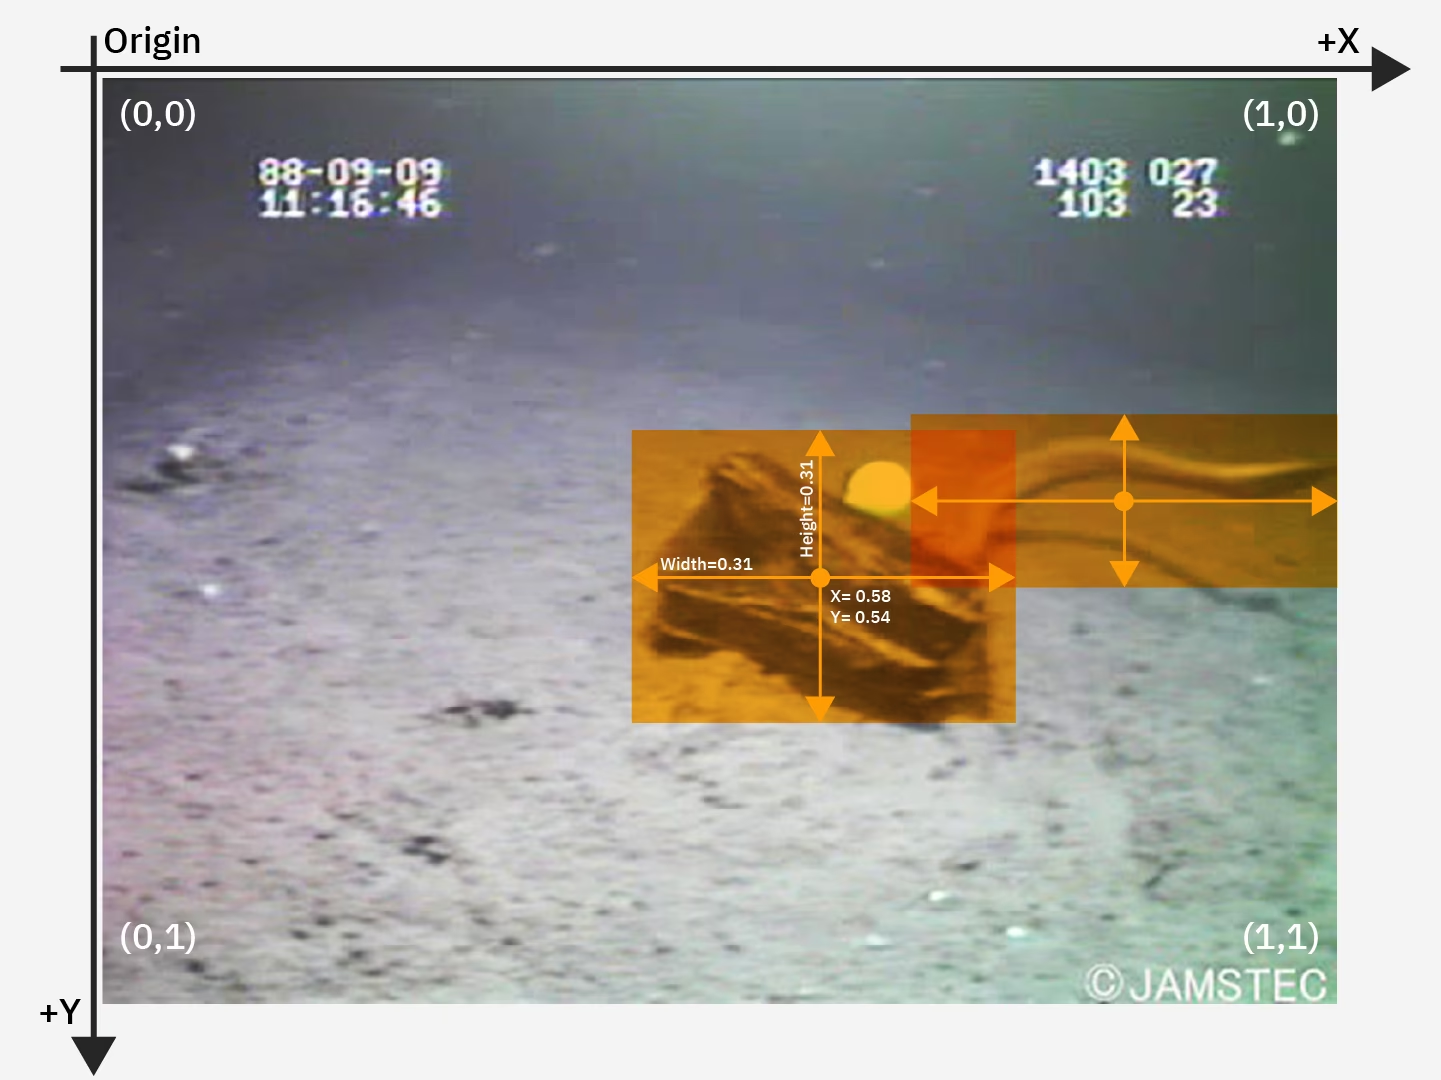
Useremo il file config.yaml e il contenuto della directory del dataset per addestrare il nostro modello di rilevamento degli oggetti. Ecco un'immagine di esempio del nostro dataset di rifiuti marini.
Passaggio 4: preelabora i dati#
Tutte le etichette del dataset di rifiuti marini sono già formattate come file YOLO .txt. Tuttavia, dobbiamo riorganizzare le directory delle immagini e delle etichette affinché il modello possa trovarle. Al momento, la directory del dataset caricato ha questa struttura:
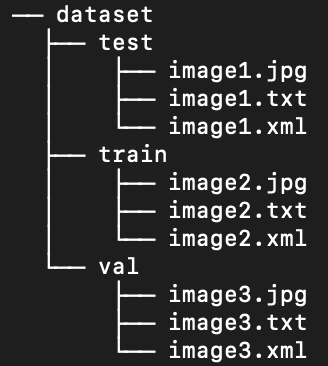
Per impostazione predefinita, i modelli YOLO richiedono sottodirectory images e labels separate all'interno di ogni suddivisione train/val/test. Dobbiamo riorganizzare la directory secondo la seguente struttura:
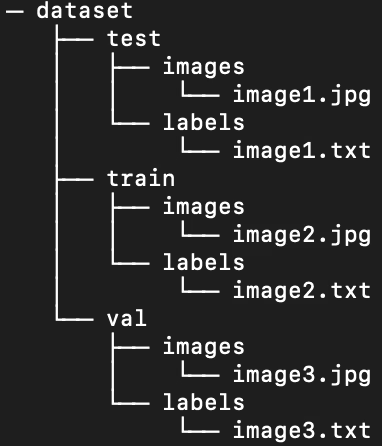
Per riorganizzare la directory del dataset, possiamo eseguire il seguente script:
# Function to reorganize dir
def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        # Create image and label subdirs if non-existent
        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        # Move images and labels to respective subdirs
        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))
            # Delete .xml files
            elif filename.endswith(".xml"):
                os.remove(os.path.join(subdir_path, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
    organize_files(directory)
Successivamente, dobbiamo modificare il file YAML del dataset. Questa è la configurazione che useremo nel nostro file .yaml. Gli ID delle classi partono da 0:
path: /path/to/dataset/directory # root directory for dataset
train: train/images # train images subdirectory
val: val/images # validation images subdirectory
test: test/images # test images subdirectory

# Classes
names:
    0: plastic
    1: bio
    2: rov
Esegui il seguente script per eliminare il contenuto attuale di config.yaml e sostituirlo con la configurazione corrispondente alla nuova struttura della directory del dataset. Lo script usa automaticamente la variabile work_dir definita in precedenza, quindi assicurati che punti al tuo dataset prima dell'esecuzione e lascia invariate le definizioni delle sottodirectory train, val e test.
# Contents of new config.yaml file
def update_yaml_file(file_path):
    data = {
        "path": f"{work_dir}/trash_ICRA19/dataset",
        "train": "train/images",
        "val": "val/images",
        "test": "test/images",
        "names": {0: "plastic", 1: "bio", 2: "rov"},
    }
    YAML.save(file_path, data)  # keeps key order, so "names" follows the directories

if __name__ == "__main__":
    file_path = f"{work_dir}/trash_ICRA19/config.yaml"  # .yaml file path
    update_yaml_file(file_path)
    print(f"{file_path} updated successfully.")
Passaggio 5: addestra il modello YOLO26#
Esegui il seguente comando per ottimizzare tramite fine-tuning un modello YOLO26n preaddestrato.
!yolo detect train data={work_dir}/trash_ICRA19/config.yaml model=yolo26n.pt epochs=2 batch=32 plots=TrueEcco una panoramica più dettagliata dei parametri nel comando di addestramento del modello:
- detect: l'attività di visione artificiale per cui usi il modello YOLO e il dataset specificati.
- train: modalità che indica lo scopo per cui carichi il modello e i dati specificati. In seguito, quando testeremo le prestazioni del modello, useremo
predict. - epochs: il numero di volte in cui YOLO26 eseguirà un passaggio sull'intero dataset.
- batch: la dimensione del batch di addestramento, ovvero il numero di immagini che il modello elabora prima di aggiornare i parametri.
- plots: Indica a YOLO di generare e salvare i grafici delle metriche di training e valutazione del nostro modello.
Per comprendere nel dettaglio il processo di training del modello e le best practice, consulta la guida al training del modello YOLO26. Questa guida ti aiuterà a ottenere il massimo dai tuoi esperimenti e ad assicurarti di usare YOLO26 in modo efficace.
Passaggio 6: testare il modello#
Ora possiamo eseguire l'inferenza per testare le prestazioni del nostro modello ottimizzato:
!yolo detect predict source={work_dir}/trash_ICRA19/dataset/test/images model={work_dir}/runs/detect/train/weights/best.pt conf=0.5 iou=.5 save=True save_txt=TrueQuesto comando genera le etichette previste per ogni immagine del set di test e crea nuovi file immagine di output con i riquadri di delimitazione previsti sovrapposti all'immagine originale.
Le etichette .txt previste per ogni immagine vengono salvate tramite l'argomento save_txt=True, mentre le immagini di output con i riquadri di delimitazione sovrapposti vengono generate tramite l'argomento save=True. Il parametro conf=0.5 indica al modello di ignorare tutte le previsioni con un livello di confidenza inferiore al 50%.
Infine, iou=.5 imposta la soglia di soppressione non massima (NMS): vengono scartati i riquadri della stessa classe che si sovrappongono per oltre il 50% a un riquadro con un punteggio più alto. In questo modo si riducono i riquadri duplicati generati per lo stesso oggetto. Possiamo caricare le immagini con i riquadri di delimitazione previsti sovrapposti per vedere le prestazioni del modello su alcune immagini.
# Show the first ten images from the preceding prediction task
for pred_dir in glob.glob(f"{work_dir}/runs/detect/predict/*.jpg")[:10]:
    img = Image.open(pred_dir)
    display(img)
Il codice precedente mostra dieci immagini del set di test con i relativi riquadri di delimitazione previsti, accompagnati dalle etichette con i nomi delle classi e dai livelli di confidenza.
Passaggio 7: valutare il modello#
Possiamo creare visualizzazioni della precisione e del richiamo del modello per ogni classe. Queste visualizzazioni vengono salvate nella directory di esecuzione dell'addestramento ({work_dir}/runs/detect/train/). Il punteggio di precisione è visualizzato in BoxP_curve.png:
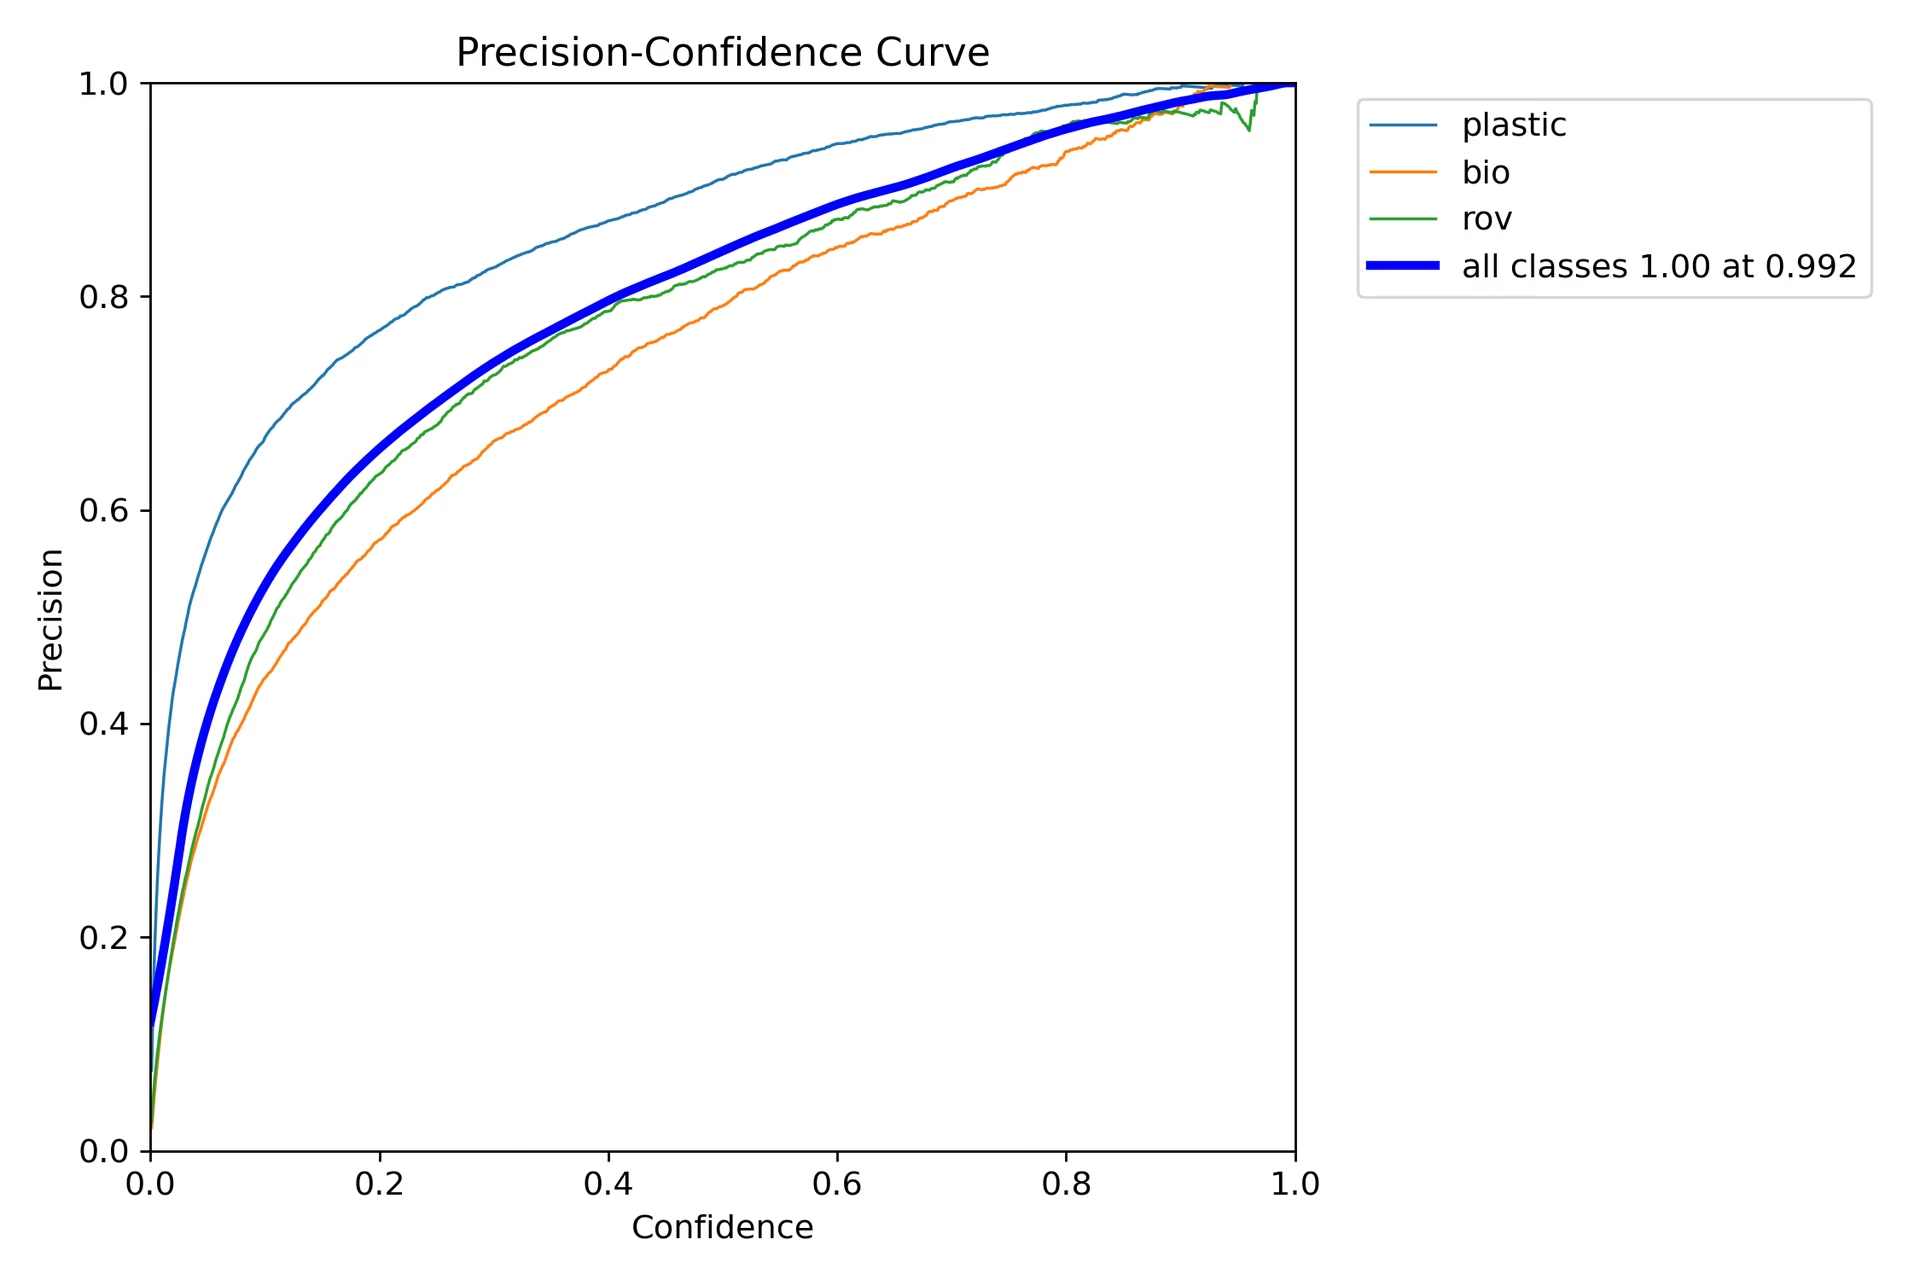
Il grafico mostra che la precisione aumenta al crescere della soglia di confidenza delle previsioni. Tuttavia, dopo due epoche, la precisione del modello non si è ancora stabilizzata a un determinato livello di confidenza.
Il grafico del richiamo (BoxR_curve.png) mostra un andamento inverso:
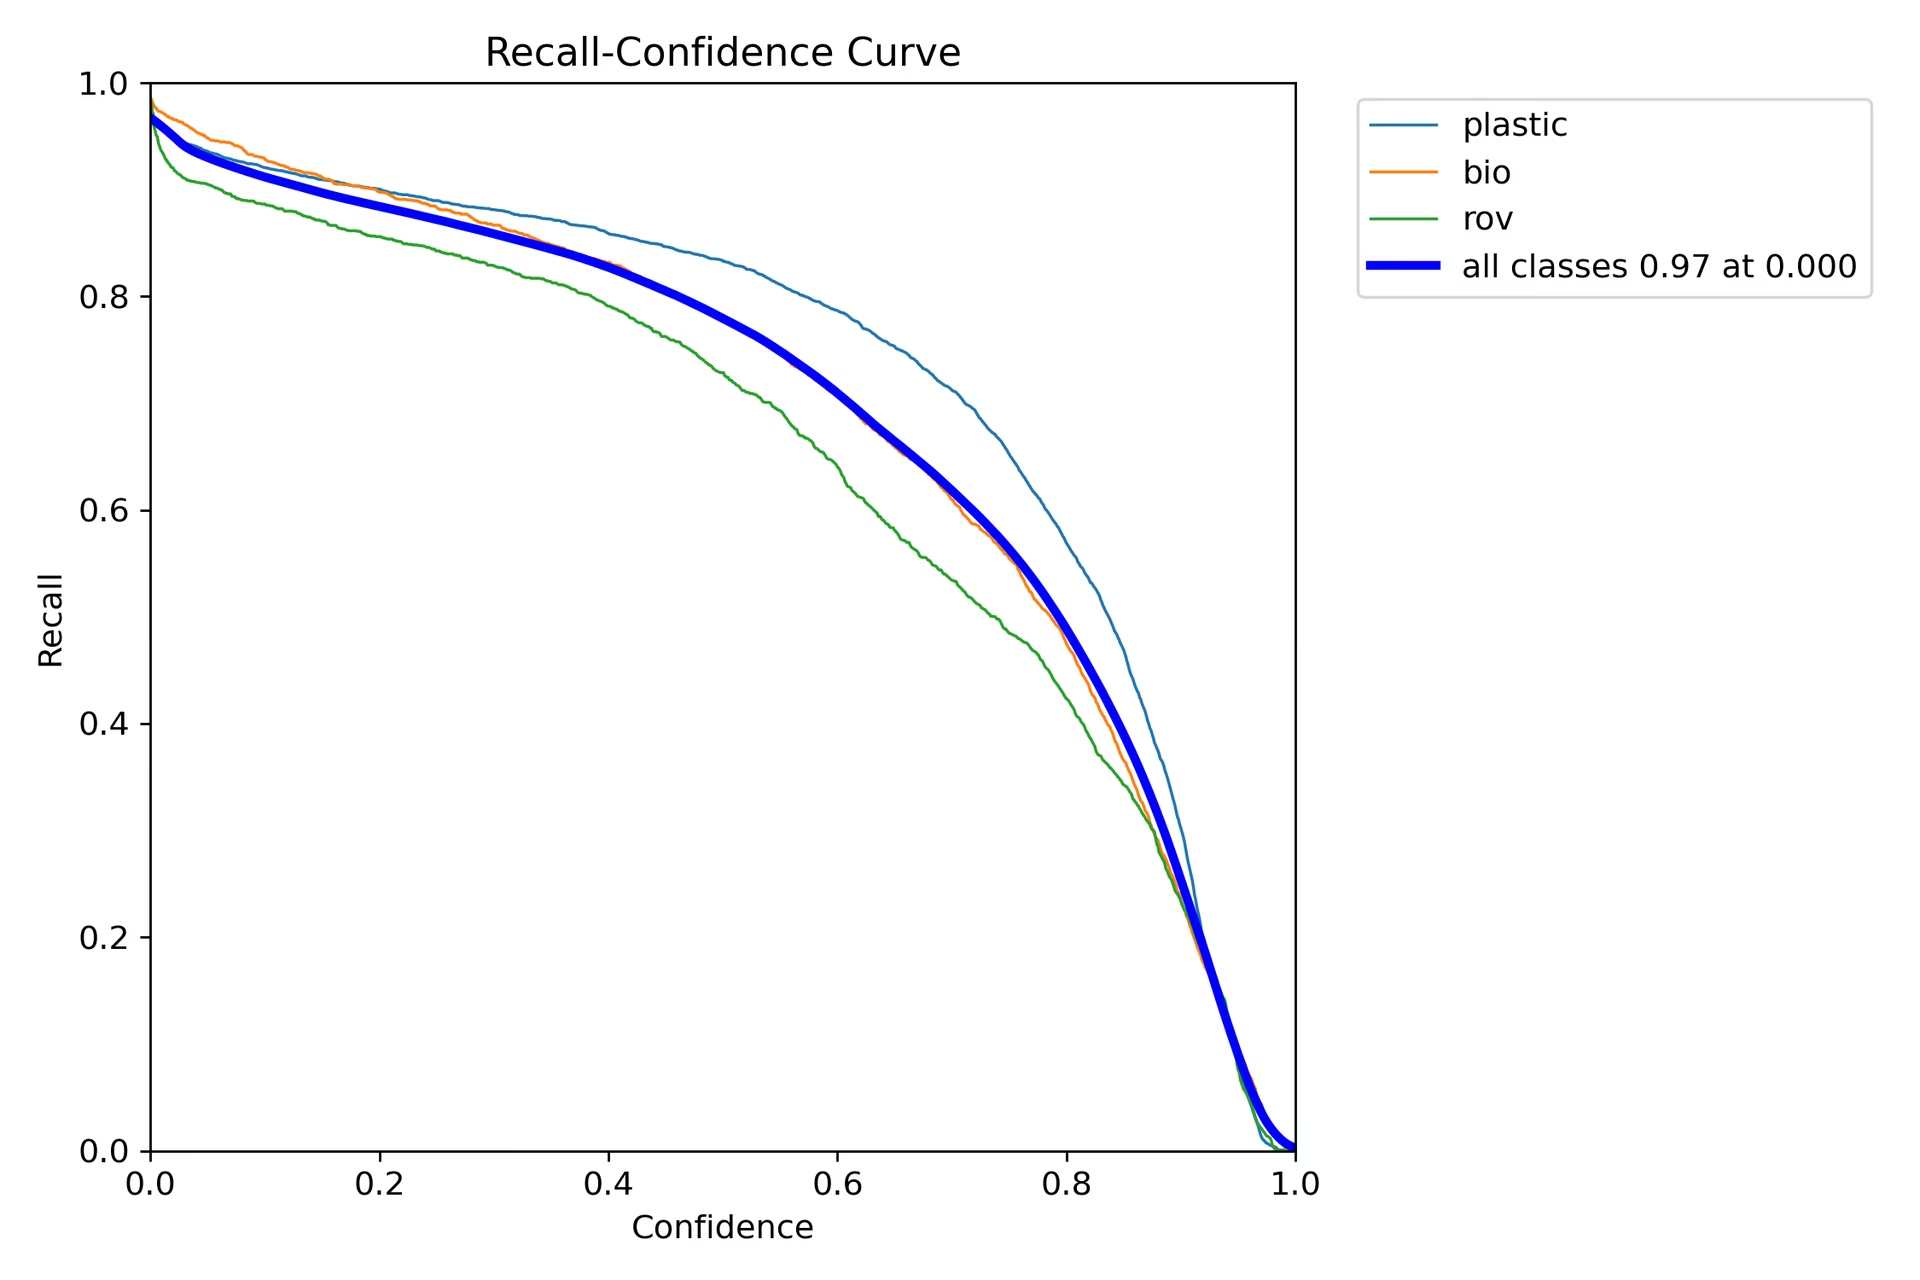
A differenza della precisione, il richiamo è massimo con soglie di confidenza basse e diminuisce all'aumentare della soglia. Questo illustra il compromesso tra precisione e richiamo.
Passaggio 8: calcolo dell'intersezione sull'unione#
Puoi misurare la precisione della localizzazione calcolando l'intersezione sull'unione (IoU) tra un riquadro di delimitazione previsto e un riquadro di delimitazione di riferimento che racchiudono lo stesso oggetto.
Riepilogo#
Abbiamo esaminato le funzionalità principali di IBM Watsonx e come addestrare un modello YOLO26 con questo strumento. IBM Watsonx offre anche strumenti per la creazione di modelli, la gestione dei dati e la conformità.
Per maggiori dettagli sull'utilizzo, consulta la documentazione ufficiale di IBM Watsonx.
Domande frequenti#
Per addestrare un modello YOLO26 utilizzando IBM Watsonx, segui questi passaggi:
- Configura l'ambiente: crea un account IBM Cloud e configura un progetto Watsonx.ai. Usa un Jupyter Notebook come ambiente di programmazione.
- Installa le librerie: installa le librerie necessarie, come
torch,opencveultralytics. - Carica i dati: usa l'API Kaggle per caricare il tuo set di dati in Watsonx.
- Preelabora i dati: organizza il set di dati nella struttura di directory richiesta e aggiorna il file di configurazione
.yaml. - Addestramento del modello: usa l'interfaccia a riga di comando di YOLO per addestrare il modello con parametri come
epochsebatch. - Testa e valuta: esegui l'inferenza per testare il modello e valutarne le prestazioni con metriche come precisione e recall.
Per istruzioni dettagliate, consulta la nostra guida al training del modello YOLO26.
IBM Watsonx offre diverse funzionalità chiave per l'addestramento dei modelli di AI:
- Watsonx.ai: offre strumenti per lo sviluppo dell'IA, compreso l'accesso a modelli personalizzati supportati da IBM e a modelli di terze parti come Llama 3. Include Prompt Lab e Tuning Studio per una gestione completa del ciclo di vita dell'IA.
- Watsonx.data: supporta le distribuzioni cloud e on-premises e offre accesso centralizzato ai dati, motori di query efficienti come Presto e Spark e un livello semantico basato sull'AI.
- Watsonx.governance: automatizza la conformità, gestisce i rischi con avvisi e offre strumenti per rilevare problemi come bias e drift. Include anche dashboard e strumenti di reportistica per la collaborazione.
Per maggiori informazioni, consulta la documentazione ufficiale di IBM Watsonx.
IBM Watsonx è adatto all'addestramento di Ultralytics YOLO26 perché i suoi strumenti coprono l'intero ciclo di vita dell'IA. Tra i principali vantaggi:
- Scalabilità: scala facilmente il training dei tuoi modelli con i servizi IBM Cloud.
- Integrazione: connettiti a varie fonti di dati e API.
- Interfaccia intuitiva: semplifica il processo di sviluppo con un'interfaccia collaborativa e intuitiva.
- Strumenti avanzati: accedi a strumenti come Prompt Lab e Tuning Studio per migliorare le prestazioni dei modelli.
Per preelaborare il set di dati per il training di YOLO26 su IBM Watsonx:
- Organizza le directory: assicurati che il set di dati rispetti la struttura di directory YOLO, con sottodirectory separate per immagini ed etichette all'interno delle suddivisioni train/val/test.
- Aggiorna il file .yaml: modifica il file di configurazione
.yamlin modo che rispecchi la nuova struttura di directory e i nomi delle classi. - Esegui lo script di preelaborazione: usa uno script Python per riorganizzare il set di dati e aggiornare di conseguenza il file
.yaml.
Ecco uno script di esempio per organizzare il set di dati:
import os
import shutil

def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
    organize_files(directory)
Per maggiori dettagli, consulta la nostra guida alla preelaborazione dei dati.
Prima di iniziare ad addestrare un modello YOLO26 su IBM Watsonx, assicurati di soddisfare i seguenti prerequisiti:
- Account IBM Cloud: crea un account IBM Cloud per accedere a Watsonx.ai.
- Account Kaggle: per caricare i set di dati, ti serviranno un account Kaggle e una chiave API.
- Jupyter Notebook: configura un ambiente Jupyter Notebook all'interno di Watsonx.ai per programmare e addestrare i modelli.
Per ulteriori informazioni sulla configurazione dell'ambiente, consulta la nostra guida all'installazione di Ultralytics.


Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.