YOLO12: rilevamento di oggetti basato sull'attenzione
Panoramica#
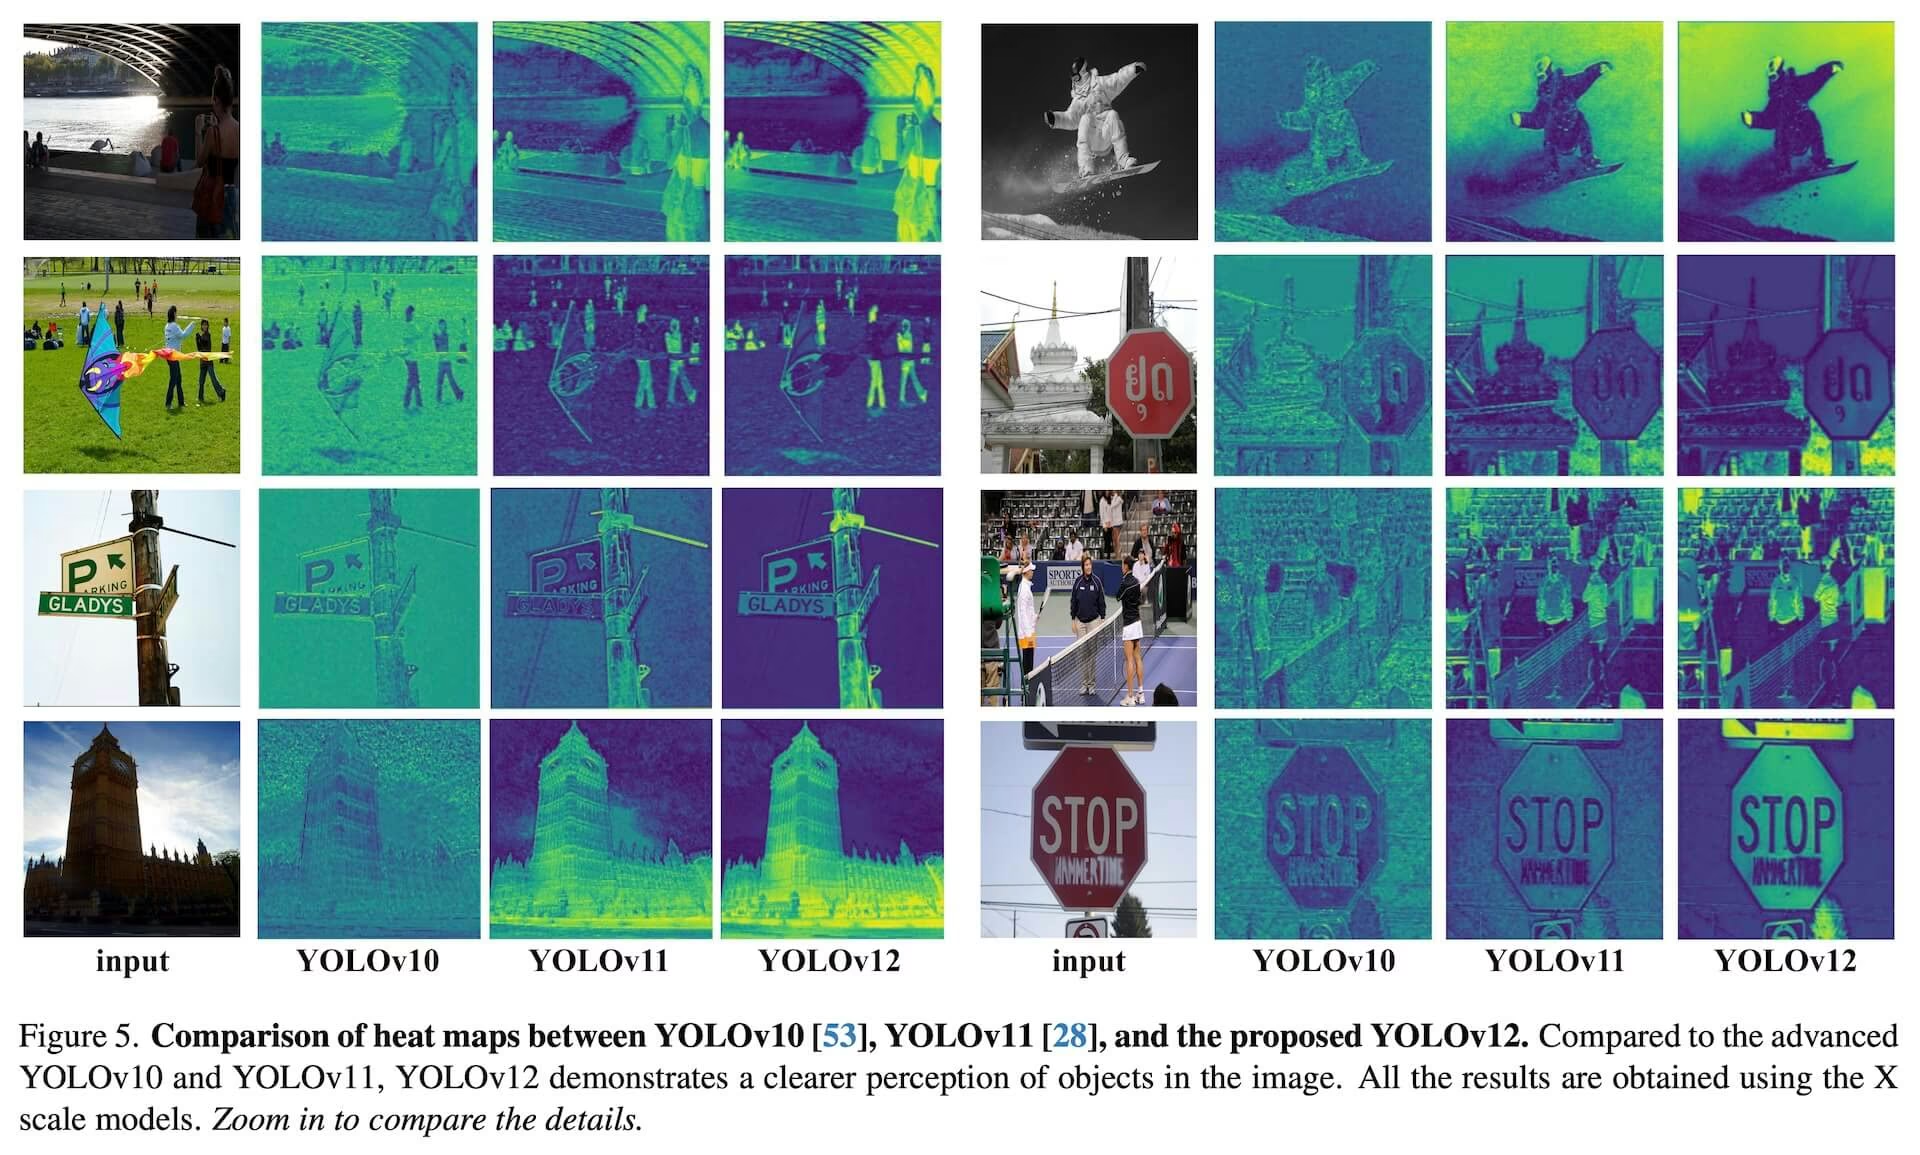
YOLO12, rilasciato all’inizio del 2025, introduce un’architettura incentrata sull’attenzione, che si discosta dagli approcci tradizionali basati su CNN usati nei precedenti modelli YOLO, mantenendo però la velocità di inferenza in tempo reale essenziale per molte applicazioni. Raggiunge un’elevata precisione nel rilevamento di oggetti grazie alle modifiche ai meccanismi di attenzione e all’architettura complessiva della rete. Nonostante questi vantaggi, YOLO12 resta una versione sviluppata dalla community e può presentare instabilità durante l’addestramento, un consumo di memoria elevato e una velocità di elaborazione su CPU inferiore, a causa dei suoi blocchi di attenzione pesanti; per la maggior parte dei carichi di lavoro in produzione, Ultralytics consiglia quindi YOLO11 o YOLO26.
YOLO12 è mantenuto principalmente per il benchmarking e la ricerca. Se ti servono un addestramento stabile, un uso prevedibile della memoria e un’inferenza su CPU ottimizzata, scegli YOLO11 o YOLO26 per la distribuzione.
Guarda: Come usare YOLO12 per il rilevamento di oggetti con il pacchetto Ultralytics | YOLO12 è veloce o lento?
Funzionalità principali#
- Meccanismo di attenzione per aree: un nuovo approccio di autoattenzione che elabora in modo efficiente ampi campi recettivi. Suddivide le mappe delle caratteristiche in l regioni di uguali dimensioni (4 per impostazione predefinita), in orizzontale o in verticale, evitando operazioni complesse e mantenendo un ampio campo recettivo effettivo. Ciò riduce notevolmente il costo computazionale rispetto all’autoattenzione standard.
- Reti di aggregazione dei livelli residuali efficienti (R-ELAN): un modulo di aggregazione delle caratteristiche migliorato, basato su ELAN e progettato per affrontare le difficoltà di ottimizzazione, soprattutto nei modelli di grandi dimensioni incentrati sull'attenzione. R-ELAN introduce:
- Connessioni residuali a livello di blocco con scalatura (simile alla scalatura dei livelli).
- Un metodo di aggregazione delle caratteristiche riprogettato, che crea una struttura simile a un collo di bottiglia.
- Architettura di attenzione ottimizzata: YOLO12 semplifica il meccanismo di attenzione standard per renderlo più efficiente e compatibile con il framework YOLO. Ciò include:
- Uso di FlashAttention per ridurre al minimo l’overhead degli accessi alla memoria.
- La rimozione della codifica posizionale per ottenere un modello più semplice e veloce.
- La regolazione del rapporto MLP (da 4, il valore tipico, a 1,2 o 2) per bilanciare meglio i calcoli tra i livelli di attenzione e quelli feed-forward.
- La riduzione della profondità dei blocchi impilati per migliorare l'ottimizzazione.
- Uso di operazioni di convoluzione (quando opportuno) per la loro efficienza computazionale.
- L'aggiunta di una convoluzione separabile 7x7 (il «percettore di posizione») al meccanismo di attenzione per codificare implicitamente le informazioni posizionali.
- Supporto completo per le attività: YOLO12 supporta diverse attività fondamentali di computer vision: rilevamento di oggetti, segmentazione di istanze, classificazione delle immagini, stima della posa e rilevamento di oggetti orientati (OBB).
- Efficienza migliorata: raggiunge una precisione superiore con un numero inferiore di parametri rispetto a molti modelli precedenti, mostrando un equilibrio migliore tra velocità e precisione.
- Distribuzione flessibile: progettato per la distribuzione su piattaforme diverse, dai dispositivi edge alle infrastrutture cloud.
Attività e modalità supportate#
YOLO12 supporta diverse attività di visione artificiale. La tabella seguente mostra le attività supportate e le modalità operative (Addestramento, Convalida, Inferenza ed Esportazione) abilitate per ciascuna:
Sono stati rilasciati su ultralytics/assets solo i pesi per il rilevamento (yolo12n.pt, yolo12s.pt, yolo12m.pt, yolo12l.pt, yolo12x.pt). Le architetture per la segmentazione, la classificazione, la stima della posa e OBB sono definite in ultralytics/cfg/models/12/, quindi queste varianti supportano l'addestramento da zero usando la configurazione .yaml, ma al momento non sono disponibili file .pt preaddestrati. Per checkpoint preaddestrati di segmentazione, stima della posa, classificazione o OBB, Ultralytics consiglia YOLO11 o YOLO26.
| Tipo di modello | Attività | Pesi preaddestrati | Addestramento | Validazione | Inferenza | Esporta |
|---|---|---|---|---|---|---|
| YOLO12 | Rilevamento | ✅ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-seg | Segmentazione | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-cls | Classificazione | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-pose | Stima della posa | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-obb | OBB | ❌ | ✅ | ✅ | ✅ | ✅ |
Tutte le architetture YOLO12 supportano ogni modalità quando è disponibile un checkpoint addestrato. La colonna Pretrained Weights indica soltanto se Ultralytics pubblica un .pt preaddestrato ufficiale su ultralytics/assets: per la segmentazione, la stima della posa, la classificazione e OBB, devi addestrare il tuo checkpoint a partire dalla configurazione .yaml corrispondente prima di eseguire l'inferenza, la convalida o l'esportazione.
Metriche di prestazione#
YOLO12 migliora la precisione a tutte le scale del modello, con alcuni compromessi in termini di velocità rispetto ai modelli YOLO precedenti più veloci. Di seguito sono riportati i risultati quantitativi del rilevamento di oggetti sul dataset di convalida COCO:
Prestazioni di rilevamento (COCO val2017)#
| Modello | dimensione (pixel) | mAPval50-95 | Velocità CPU ONNX (ms) | Velocità T4 TensorRT (ms) | parametri (M) | FLOPs (B) | Confronto (mAP/velocità) |
|---|---|---|---|---|---|---|---|
| YOLO12n | 640 | 40.6 | - | 1.64 | 2.6 | 7.5 | +2.1%/-9% (rispetto a YOLOv10n) |
| YOLO12s | 640 | 48.0 | - | 2.61 | 9.3 | 23.3 | +0.1%/+42% (rispetto a RT-DETRv2) |
| YOLO12m | 640 | 52.5 | - | 4.86 | 20.2 | 70.7 | +1.0%/-3% (rispetto a YOLO11m) |
| YOLO12l | 640 | 53.7 | - | 6.77 | 26.4 | 95.4 | +0.4%/-8% (rispetto a YOLO11l) |
| YOLO12x | 640 | 55.2 | - | 11.79 | 59.1 | 208.9 | +0.6%/-4% (rispetto a YOLO11x) |
- Velocità di inferenza misurata su una GPU NVIDIA T4 con precisione TensorRT FP16.
- I confronti mostrano il miglioramento relativo in mAP e la variazione percentuale della velocità (un valore positivo indica una maggiore velocità; un valore negativo, una velocità inferiore). I confronti sono effettuati rispetto ai risultati pubblicati per YOLOv10, YOLO11 e RT-DETR, ove disponibili.
Esempi d'uso#
Questa sezione fornisce esempi di addestramento e inferenza con YOLO12.
Gli esempi seguenti riguardano i modelli YOLO12 Detect (per il rilevamento di oggetti). Per le altre attività supportate (segmentazione, classificazione, stima della posa e rilevamento di oggetti orientati), consulta la documentazione specifica: Segment, Classify, Pose e OBB.
Puoi passare i modelli *.pt preaddestrati (che usano PyTorch) e i file di configurazione *.yaml alla classe YOLO() per creare un'istanza del modello in Python:
from ultralytics import YOLO

# Carica un modello YOLO12n preaddestrato su COCO
model = YOLO("yolo12n.pt")

# Addestra il modello sul dataset di esempio COCO8 per 100 epoche
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)

# Esegui l'inferenza con il modello YOLO12n sull'immagine 'bus.jpg'
results = model("path/to/bus.jpg")
Miglioramenti principali#
-
Estrazione delle caratteristiche migliorata:
- Attenzione per aree: gestisce in modo efficiente ampi campi recettivi, riducendo il costo computazionale.
- Equilibrio ottimizzato: migliore bilanciamento tra i calcoli di attenzione e quelli della rete feed-forward.
- R-ELAN: migliora l'aggregazione delle caratteristiche usando l'architettura R-ELAN.
-
Innovazioni nell'ottimizzazione:
- Connessioni residuali: introduce connessioni residuali con scalatura per stabilizzare l'addestramento, soprattutto nei modelli più grandi.
- Integrazione delle caratteristiche perfezionata: implementa un metodo migliorato per integrare le caratteristiche all'interno di R-ELAN.
- FlashAttention: integra FlashAttention per ridurre il sovraccarico degli accessi alla memoria.
-
Efficienza architetturale:
- Numero di parametri ridotto: raggiunge un numero di parametri inferiore mantenendo o migliorando la precisione rispetto a molti modelli precedenti.
- Attenzione semplificata: usa un'implementazione dell'attenzione semplificata, che evita la codifica posizionale.
- Rapporti MLP ottimizzati: regola i rapporti MLP per allocare le risorse computazionali in modo più efficace.
Requisiti#
Per impostazione predefinita, l'implementazione Ultralytics di YOLO12 non richiede FlashAttention. Tuttavia, puoi compilare FlashAttention e usarlo con YOLO12 facoltativamente. Per compilare FlashAttention, è necessaria una delle seguenti GPU NVIDIA:
- GPU Turing (ad esempio, T4, serie Quadro RTX)
- GPU Ampere (ad esempio, serie RTX30, A30/40/100)
- GPU Ada Lovelace (ad esempio, serie RTX40)
- GPU Hopper (ad es. H100/H200)
Citazioni e ringraziamenti#
Se usi YOLO12 nella tua ricerca, cita il lavoro originale della University at Buffalo e della University of Chinese Academy of Sciences:
@inproceedings{tian2025yolov12,
  title={YOLOv12: Attention-Centric Real-Time Object Detectors},
  author={Tian, Yunjie and Ye, Qixiang and Doermann, David},
  booktitle={Advances in Neural Information Processing Systems},
  volume={38},
  pages={78433--78457},
  year={2025},
  url={https://proceedings.neurips.cc/paper_files/paper/2025/file/7103444259031cc58051f8c9a4868533-Paper-Conference.pdf}
}

@software{yolo12,
  author = {Tian, Yunjie and Ye, Qixiang and Doermann, David},
  title = {YOLO12: Attention-Centric Real-Time Object Detectors},
  year = {2025},
  url = {https://github.com/sunsmarterjie/yolov12},
  license = {AGPL-3.0}
}
L'articolo su YOLO12 è stato pubblicato negli atti di NeurIPS 2025, con una versione preliminare su arXiv.
Domande frequenti#
YOLO12 integra diverse innovazioni chiave per bilanciare velocità e precisione. Il meccanismo di attenzione per aree elabora in modo efficiente ampi campi recettivi, riducendo il costo computazionale rispetto all’autoattenzione standard. Le reti di aggregazione dei livelli efficienti residuali (R-ELAN) migliorano l’aggregazione delle caratteristiche, affrontando le difficoltà di ottimizzazione nei modelli più grandi incentrati sull’attenzione. L’architettura di attenzione ottimizzata, che include l’uso di FlashAttention e la rimozione della codifica posizionale, migliora ulteriormente l’efficienza. Queste caratteristiche consentono a YOLO12 di raggiungere un’elevata precisione mantenendo la velocità di inferenza in tempo reale necessaria a molte applicazioni.
YOLO12 supporta un’ampia gamma di attività fondamentali di visione artificiale: rilevamento di oggetti, segmentazione di istanze, classificazione di immagini, stima della posa e rilevamento di oggetti orientati (OBB). Questo rende YOLO12 adatto a campi diversi, dalla robotica alla guida autonoma, fino all’imaging medico e all’ispezione industriale. Tieni presente che al momento i pesi
.ptpreaddestrati sono pubblicati solo per il rilevamento; le architetture per la segmentazione, la stima della posa, la classificazione e OBB sono disponibili come configurazioni.yamlper l’addestramento da zero.YOLO12 migliora la precisione a tutte le scale del modello rispetto ai precedenti modelli YOLO, come YOLOv10 e YOLO11, con alcuni compromessi sulla velocità rispetto ai modelli precedenti più veloci. Ad esempio, YOLO12n ottiene un miglioramento del mAP del +2,1% rispetto a YOLOv10n e del +1,2% rispetto a YOLO11n sul dataset COCO val2017. Rispetto a modelli come RT-DETR, YOLO12s offre un miglioramento del mAP del +1,5% e un aumento della velocità del +42%. Queste metriche evidenziano l'equilibrio ottimale di YOLO12 tra precisione ed efficienza.
Per impostazione predefinita, l’implementazione Ultralytics di YOLO12 non richiede FlashAttention. Tuttavia, FlashAttention può essere compilato facoltativamente e usato con YOLO12 per ridurre al minimo l’overhead degli accessi alla memoria. Per compilare FlashAttention serve una delle seguenti GPU NVIDIA: GPU Turing (ad es. serie T4 e Quadro RTX), GPU Ampere (ad es. serie RTX30, A30/40/100), GPU Ada Lovelace (ad es. serie RTX40) o GPU Hopper (ad es. H100/H200). In questo modo, gli utenti possono sfruttare FlashAttention quando l’hardware lo supporta.
Questa pagina fornisce esempi di utilizzo di base per l’addestramento e l’inferenza. YOLO12 usa le stesse modalità Train, Val, Predict ed Export e le stesse interfacce per le attività Segment, Classify, Pose e OBB degli altri modelli Ultralytics.


Commenti69
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
Zixuan-He
I try use the YOLO12-seg, but with update to lastest version (> pip install -U ultralytics) it is still showing (No such file or directory: 'YOLO12n-seg.pt) with code (yolo segment train data=data.yaml model=YOLO12n-seg.pt epochs=200 batch=16 imgsz=640 patience=25 ). theYOLO12n.pt for obj is good. Is the code changed or need other input?
1 Glenn JocherUltralytics
@Zixuan-He Answer:
The YOLO12-seg model requires using its specific configuration file. Trymodel=yolo12-seg.yamlinstead of the.ptfile to initialize training. The segmentation weights are not yet released as pretrained.ptfiles, but you can train from scratch using the YAML configuration. For details, see the YOLO12-seg documentation.2LucasGenoud
Hello, thank you for your answer ! Do you have any date estimation of when the pretrained segmentation models for YOLO12 will be available ? Thanks
- Glenn JocherUltralytics
We don't have an official release date for YOLO12-seg pretrained weights yet, but you can train segmentation models from scratch using the YOLO12-seg.yaml configuration. For updates, please monitor the YOLO12 documentation.
Thank you for your response. Great work :)
- Glenn JocherUltralytics
Thank you for your kind words! We don't have a specific release date for YOLO12-seg pretrained weights yet, but you can monitor the YOLO12 documentation for updates. The team typically announces new model releases there first. For now, training from scratch using the YOLO12-seg.yaml configuration remains the recommended approach.
dolokbutarbutar24
Here are some sample images for the healthy class. I also attached some "results" images, hopefully can give more information so you guys can help me with the project.
Pada Sen, 30 Mar 2026 pukul 15.58 Glenn Jocher @.***> menulis:
Thanks for dropping this question here so the Ultralytics team can see it; for leaf-disease datasets, mAP50-95 usually improves more from cleaner labels, balanced class counts, harder negative samples, and reviewing per-class PR/confusion outputs than from pushing loss weights alone, so I’d next tune weight_decay, momentum, warmup_epochs, lrf, translate, shear, perspective, fliplr, and close_mosaic using the hyperparameter tuning guide https://docs.ultralytics.com/guides/hyperparameter-tuning/ and performance metrics guide https://docs.ultralytics.com/guides/yolo-performance-metrics/. If you can share a few sample images, labels, and training curves here, we can suggest a tighter search space, and it’s also worth benchmarking the same split with YOLO26 https://docs.ultralytics.com/models/yolo26/ since YOLO12 is mainly maintained as a community research model.
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/19360?email_source=notifications&email_token=A23CVICPPIXOD6F3LMBB52T4TIZKDA5CNFSNUABIM5UWIORPF5TWS5BNNB2WEL2ENFZWG5LTONUW63SDN5WW2ZLOOQXTCNRTG44DGNRZUZZGKYLTN5XKOY3PNVWWK3TUUVSXMZLOOSWGM33PORSXEX3DNRUWG2Y#discussioncomment-16378369, or unsubscribe https://github.com/notifications/unsubscribe-auth/A23CVIG2PM2BD5335IFZQXT4TIZKDAVCNFSM6AAAAABXS26SR6VHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTMMZXHAZTMOI . You are receiving this because you commented.Message ID: @.*** com>
- Glenn JocherUltralytics
Thanks, that helps; from those samples I’d next verify that the
healthylabels are fully consistent and that the class counts are not skewed, then please attach a few matching image/label.txtpairs plusresults.csvandconfusion_matrix_normalized.pngso we can check whether this is a data issue rather than a YOLO12 training issue, and if you recently fixed labels please delete anylabels/*.cachefiles before retraining.
I am currently working on a project to detect cassava leaf diseases using YOLOv12. The focus of this research is to perform hyperparameter tuning and also determine the most suitable augmentation configuration to improve model performance. So far, the trained model is still hovering around the 0.5 range for the mAP@50-95 evaluation metric. Here are the hyperparameters I have used for tuning so far: epochs=100, patience=20, imgsz=1024, batch=8, optimizer='auto', lr0=0.00511, box=6.32971, cls=2.87957, dfl=2.12658, mosaic=0.25, scale=0.15, mixup=0.0, copy_paste=0.0, degrees=10.0, hsv_h=0.015, hsv_s=0.7, hsv_v=0.4.
What other strategies can I do to improve my model's performance, especially on the mAP@50-95 evaluation metric? Do you have any suggestions for other hyperparameters that need to be added to this project for tuning? I'm sure your experience and skills can answer that and help me hahaha.
- Glenn JocherUltralytics
Thanks for dropping this question here so the Ultralytics team can see it; for leaf-disease datasets, mAP50-95 usually improves more from cleaner labels, balanced class counts, harder negative samples, and reviewing per-class PR/confusion outputs than from pushing loss weights alone, so I’d next tune
weight_decay,momentum,warmup_epochs,lrf,translate,shear,perspective,fliplr, andclose_mosaicusing the hyperparameter tuning guide and performance metrics guide. If you can share a few sample images, labels, and training curves here, we can suggest a tighter search space, and it’s also worth benchmarking the same split with YOLO26 since YOLO12 is mainly maintained as a community research model.
 Clousy
在5090 32G上使用yolo12l训练模型的时候,数据量大概7万左右,batch_size=24 内存占用在24G左右,为啥速度只有2-3it/s 是哪里设置有问题?下面是训练参数: rain_args = dict( data="data.yaml", epochs=500, imgsz=640, batch=24, device=device, workers=16,
cache=False, amp=True, # --- 减少 CPU 负担 --- mosaic=0.0, # 暂时关掉 Mosaic 看看速度是否飙升 mixup=0.0, # 同上 )- Glenn JocherUltralytics
yolo12l本身是重注意力结构,吞吐会比同尺度的 CNN 系列低不少,所以你看到的2–3 it/s在batch=24下未必异常(折算大约是48–72 img/s);如果你目标是更高训练/CPU 端速度,建议直接换到更稳更快的 Ultralytics YOLO26(YOLO12 更偏研究/基准用途,见 YOLO12 文档)。想确认是不是环境/数据读取瓶颈的话,请把yolo checks输出和完整文本训练日志(含第一轮的进度条行、CUDA:/显卡名、DataLoader相关信息)贴在这里;另外你现在cache=False可能会被磁盘 IO 卡住、workers=16在部分系统上也会造成额外调度开销,建议先用下面这组参数做一次对照测试(同一数据/同一imgsz),看it/s是否明显变化:yolo checks yolo train model=yolo12l.pt data=data.yaml epochs=2 imgsz=640 batch=24 device=0 workers=8 cache=True mosaic=0.0 mixup=0.0
is there any video (tutorial) about how to classify plant disease? i'm confused about how to do it because i need guidance to do classify task
- Glenn JocherUltralytics(modificato)
Yes—plant disease is just a standard image classification workflow; please follow the Ultralytics YOLO classification guide (and drop any follow-up questions here in this discussion so the Ultralytics team can see them), then try:
from ultralytics import YOLO

# ImageNet-pretrained classifier backbone (recommended starting point)
model = YOLO("yolo26n-cls.pt")

# Your dataset folder should contain train/ and val/ with one subfolder per class
model.train(data="path/to/plant_disease_dataset", epochs=50, imgsz=224)
If you share your dataset folder layout (just the directory tree) and what’s confusing you, I can point you to the exact next step.
asad121101
Hello , this new yolo12 is using what architecture in neck ? pan or fpn ? or some thing else ?
Sourabh0052
while working on classification model using YOLO12-cls and i do not make any .yaml file, just simply provide the data source path then will it work same or not
radadiavasu
I faced a problem that recently I put my model on training with yolo12x but at 98/100 epoch it stopped due to units are over on colab pro but when I start again and expect to start from 98 but it start from 1/100 instead of 98 even in results.csv I couldn't get anything. Why this problem occurs?
deldanr
When resuming a training session started with Yolov12, after the AMP check, the training session downloads a Yolov11 model to continue, which I assume is an error.
Attached is part of the log: YOLOv12l summary: 488 layers, 26,389,875 parameters, 26,389,859 gradients, 89.4 GFLOPs
Transferred 1245/1245 items from pretrained weights Freezing layer 'model.21.dfl.conv.weight' AMP: Running Automatic Mixed Precision (AMP) checks... Downloading https://github.com/ultralytics/assets/releases/download/v8.3.0/yolo11n.pt to 'yolo11n.pt'... <-- Here's the error
pvurda
Has anyone found a low-cost, low-latency way to generate a short semantic scene caption (e.g., “two people loading a van”) on top of YOLO12 detections in real time?