OpenAI CLIPでセマンティック画像検索を構築する方法#
このガイドでは、OpenAI CLIPとFlaskを使用して、セマンティック画像検索エンジンを構築する方法を説明します。NumPyを利用した高速なコサイン類似度検索と、CLIPの視覚と言語の埋め込みを組み合わせることで、ラベルやカテゴリを必要とせず、自然言語のクエリから関連画像を取得するWebインターフェースを構築できます。
Watch: How Similarity Search Works | Visual Search Using OpenAI CLIP and the Ultralytics Package 🎉
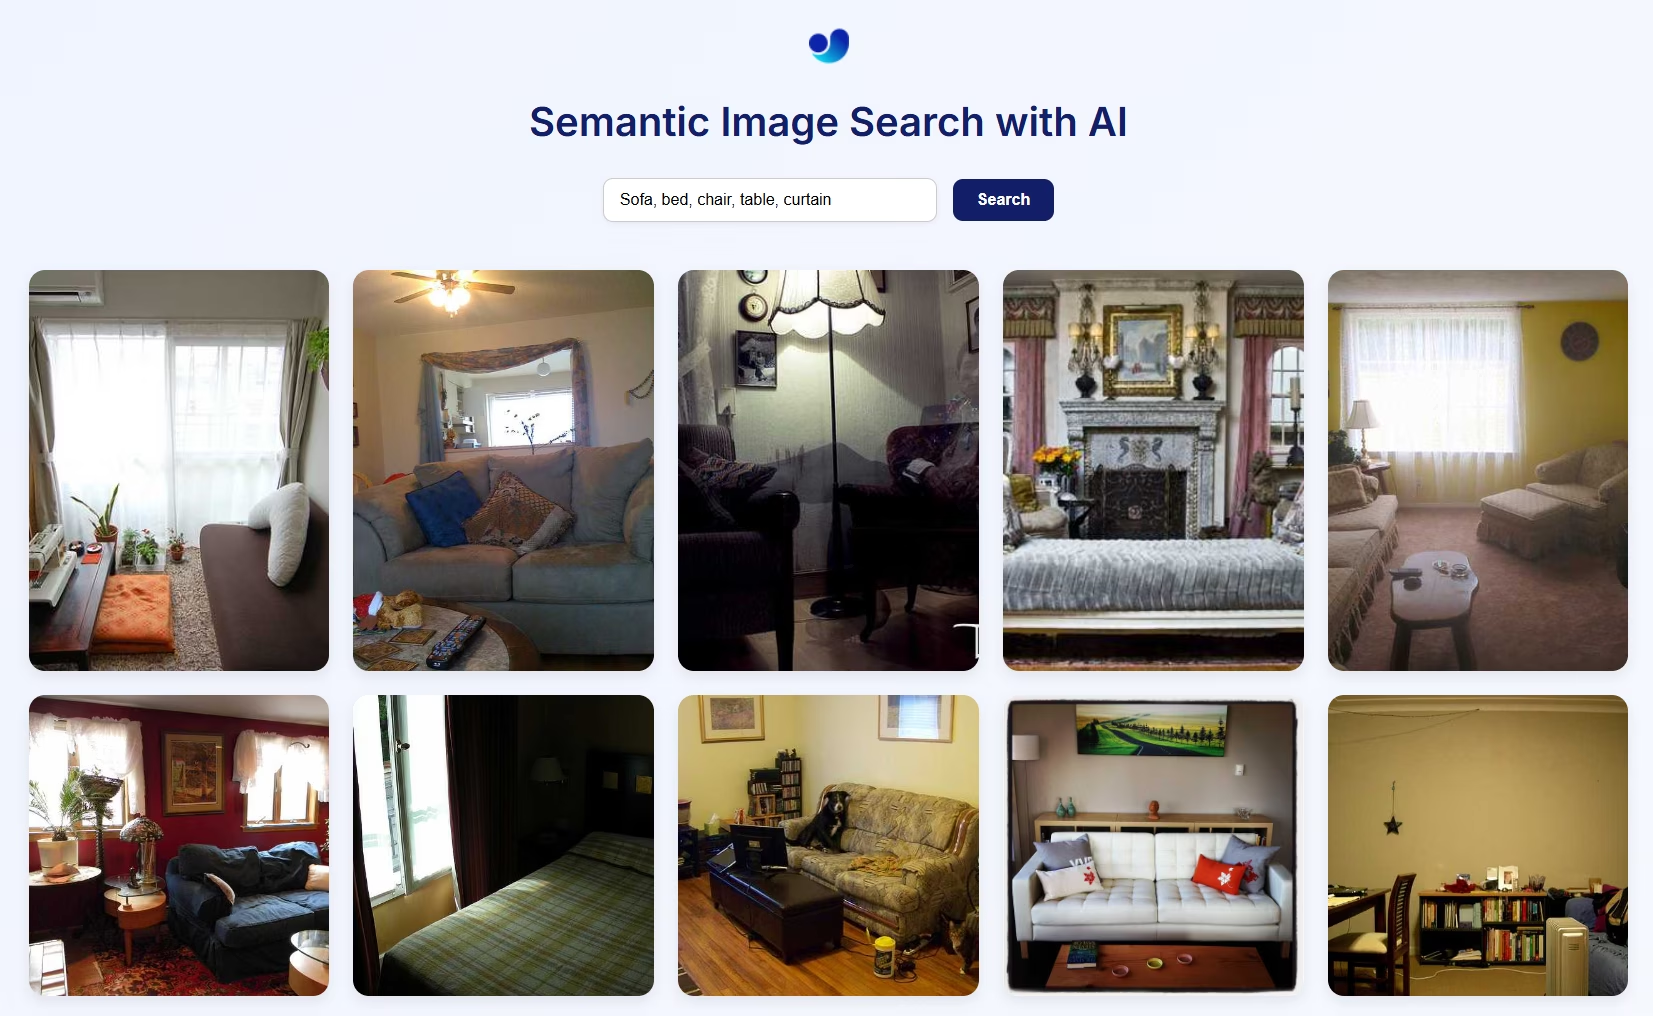
Ultralytics Pythonパッケージは、このパイプライン全体を2つのクラスにラップしているため、数行で実用的な検索アプリを起動したり、プログラムからクエリを実行したりできます。このガイドでは、セマンティック検索が有用な理由、その仕組み、Webアプリの実行、プログラムからの検索、パラメータの設定について説明します。
セマンティック画像検索を使用する理由#
独自のセマンティック画像検索システムを構築すると、次のような大きな利点があります。
- ゼロショット機能: データセットで学習する必要はありません。CLIPのゼロショット学習により、自由形式の自然言語で任意の画像コレクションにクエリを実行できるため、時間とリソースを節約できます。
- 人間に近い理解: キーワード検索とは異なり、CLIPはセマンティックな文脈を理解し、「自然の中にいる幸せな子ども」や「夜の未来的な都市のスカイライン」のような抽象的、感情的、関係的なクエリから画像を取得できます。
- ラベルやメタデータが不要: このアプローチに必要なのは未加工の画像だけです。CLIPは手動アノテーションなしで埋め込みを生成します。
- 軽量で正確な検索: NumPyで1回の正規化行列積を実行してすべての画像をコサイン類似度で順位付けするため、追加の検索依存関係をインストールまたは管理することなく、数千件の埋め込みに対してリアルタイムに正確な結果を得られます。
- ドメイン横断型のアプリケーション: 個人用の写真アーカイブ、クリエイティブなインスピレーションツール、商品検索エンジン、アート推薦システムのいずれを構築する場合でも、同じスタックを最小限の調整で適用できます。
セマンティック画像検索の仕組み#
このパイプラインは3つのコンポーネントで構成され、それぞれが画像とテキストを順位付けされた結果に変換する各段階を担います。
- CLIPは、画像にはビジョンエンコーダー(例: ResNetまたはViT)を、言語にはテキストエンコーダー(Transformerベース)を使用し、両方を同じマルチモーダル埋め込み空間に写像します。これにより、コサイン類似度を使用してテキストと画像を直接比較できます。
- NumPyは画像の埋め込みを単一の配列として格納し、1回の行列積でクエリの埋め込みと照合して順位付けします。追加のインデックス依存関係なしで、コサイン類似度が最も高いベクトルを返します。
- Flaskは、自然言語のクエリを送信し、インデックスからセマンティックに一致する画像を表示するためのシンプルなWebインターフェースを提供します。
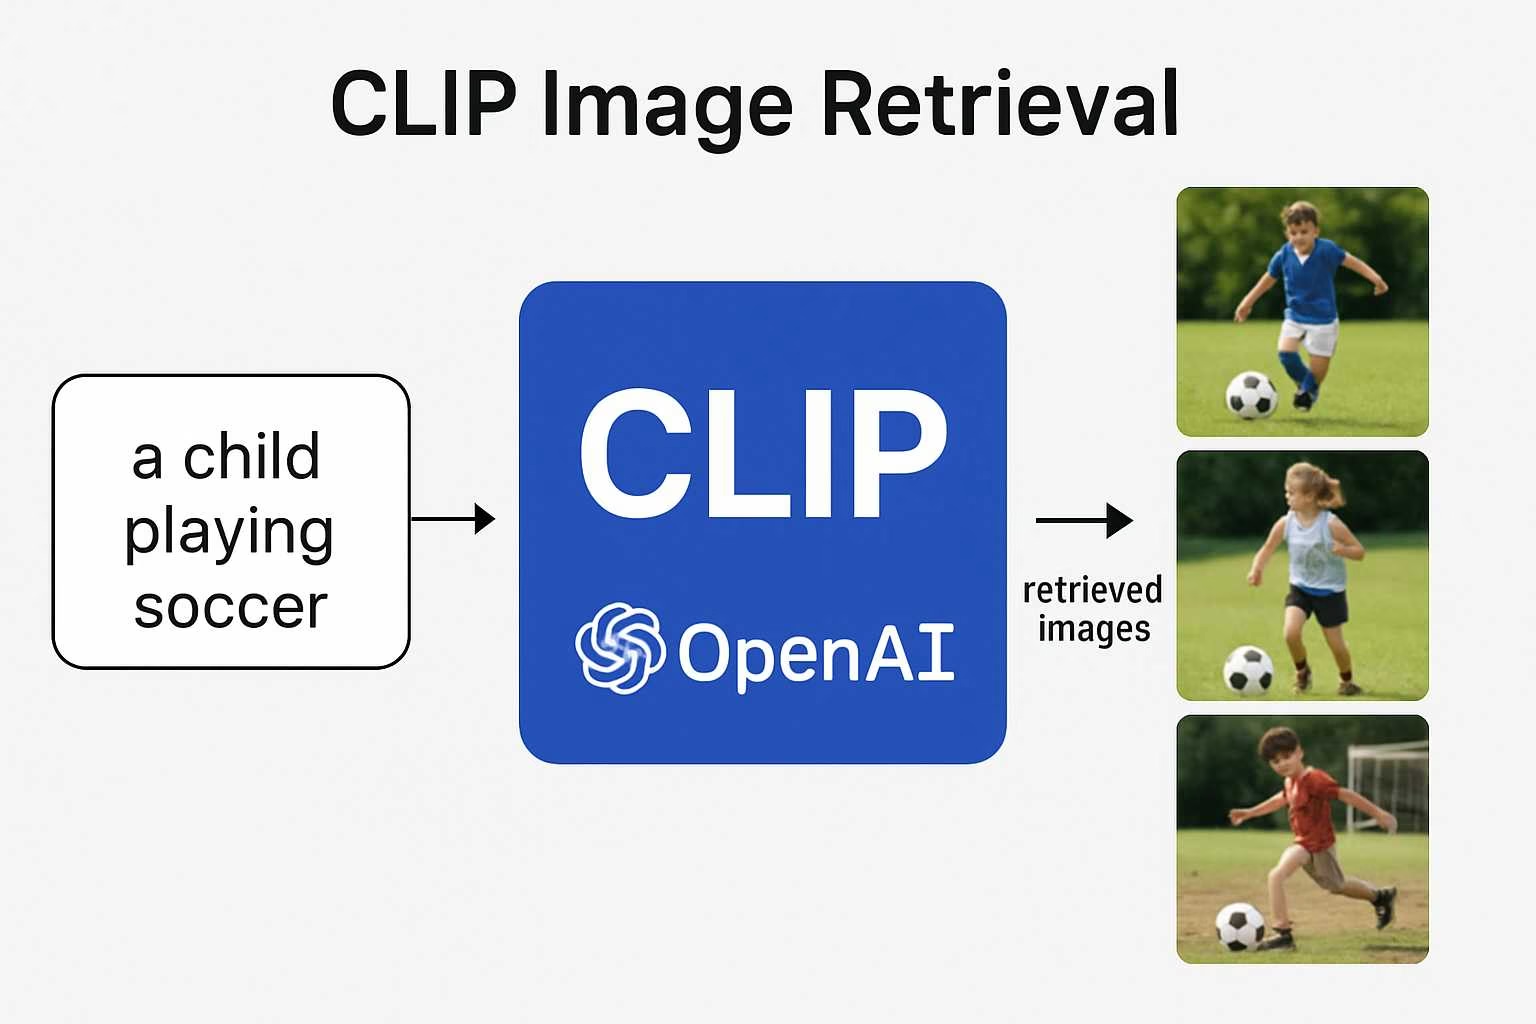
画像とテキストの両方が同じベクトル空間に配置されるため、検索はゼロショットで実行できます。ラベルやカテゴリは不要で、画像データと適切なプロンプトだけが必要です。
セマンティック検索Webアプリを実行する#
SearchAppクラスは、Flaskインターフェース全体を起動します。初回の実行時にはサンプル画像セットをダウンロードし、埋め込みインデックスを構築して、クエリを入力して順位付けされた結果を表示できるページを配信します。
画像パスに関する警告
独自の画像を使用する場合は、画像ディレクトリの絶対パスを指定してください。指定しないと、Flaskのファイル配信上の制限により、画像がWebページに表示されないことがあります。
from ultralytics import solutions

app = solutions.SearchApp(
    data="images",  # replace with a path to build the search engine with your own images
    device="cpu",  # configure the device for processing, e.g., "cpu" or "cuda"
)

app.run(debug=False) # You can also use `debug=True` argument for testingプログラムから画像を検索する#
VisualAISearchクラスは、Webレイヤーなしですべてのバックエンド処理を実行します。
- ローカル画像から埋め込みインデックスを読み込むか、構築します。
- CLIPを使用して画像とテキストの埋め込みを抽出します。
- コサイン類似度を使用して類似度検索を実行します。
自然言語のクエリで検索処理を呼び出すと、類似度順に並べられた一致画像のファイル名一覧が返されます。
from ultralytics import solutions

searcher = solutions.VisualAISearch(
    data="images",  # replace with a path to build the search engine with your own images
    device="cpu",  # configure the device for processing, e.g., "cpu" or "cuda"
)

results = searcher("a dog sitting on a bench")

# Ranked Results:
#     - 000000546829.jpg | Similarity: 0.3269
#     - 000000549220.jpg | Similarity: 0.2899
#     - 000000517069.jpg | Similarity: 0.2761
#     - 000000029393.jpg | Similarity: 0.2742
# - 000000534270.jpg | Similarity: 0.2680VisualAISearchのパラメータを設定する#
次の表に、VisualAISearchで使用できるパラメータを示します。
| 引数 | 型 | デフォルト | 説明 |
|---|---|---|---|
data | str | 'images' | インデックス作成と検索の対象となる画像ディレクトリへのパスです。 |
device | str | 'cpu' | CLIPの推論に使用するデバイスです(例: cpu、cuda、0)。 |
ローカルファイルを管理せずに本番規模の画像コレクションを検索するには、CLIPでインデックスを作成する前に、Ultralytics Platformで画像を整理してバージョン管理できます。
まとめ#
CLIPとUltralytics Pythonパッケージを使用すると、数行でゼロショットのセマンティック画像検索エンジンを構築できます。FlaskのWebアプリとしても、プログラムから利用する検索バックエンドとしても実装できます。ここから、dataに独自の画像ディレクトリを指定してインデックスを作成し、その他のUltralytics Solutionsを活用してコンピュータービジョンワークフローを拡張できます。
FAQ#
CLIPの際立った特徴は、汎化能力です。特定のラベルやタスクだけを対象に学習するのではなく、自然言語そのものから学習します。これにより、「ジェットスキーに乗る男性」や「シュールな夢の風景」のような柔軟なクエリにも対応でき、再学習なしで分類からクリエイティブなセマンティック検索まで、幅広く活用できます。
CLIPはOpenAIが開発していますが、Ultralytics Pythonパッケージは、埋め込みの生成、インデックス作成、コサイン類似度検索を数行のコードで動作する完全なセマンティック画像検索パイプラインにラップしています。
from ultralytics import solutions

searcher = solutions.VisualAISearch(
    data="images",  # replace with a path to build the search engine with your own images
    device="cpu",  # configure the device for processing, e.g., "cpu" or "cuda"
)

results = searcher("a dog sitting on a bench")
この高レベル実装は、次の処理を行います。
- CLIPベースの画像およびテキスト埋め込みの生成。
- 埋め込みインデックスの作成と管理。
- コサイン類似度による効率的なセマンティック検索。
- ディレクトリベースの画像読み込みと可視化。
はい。現在の構成では基本的なHTMLフロントエンドを備えたFlaskを使用していますが、独自のHTMLに置き換えたり、React、Vue、その他のフロントエンドフレームワークでより動的なUIを構築したりできます。Flaskは、カスタムインターフェース用のバックエンドAPIとして利用できます。
直接はできません。簡単な回避策として、動画から個々のフレーム(例: 1秒ごとに1フレーム)を抽出し、それらを独立した画像として扱ってシステムに入力します。これにより、検索エンジンは動画内の視覚的な瞬間をセマンティックにインデックス化できます。