モデルのトレーニング
Ultralytics Platformは、実験の整理から、リアルタイムのメトリクス配信を伴うクラウドトレーニングジョブの実行まで、YOLOモデルのトレーニングに役立つツールを提供します。
視聴: Ultralytics Platformを始める - トレーニング
概要#
トレーニングセクションでは、次のことができます。
- モデルをプロジェクトに整理して、管理を簡単にします
- ワンクリックでクラウドGPU上でトレーニングします
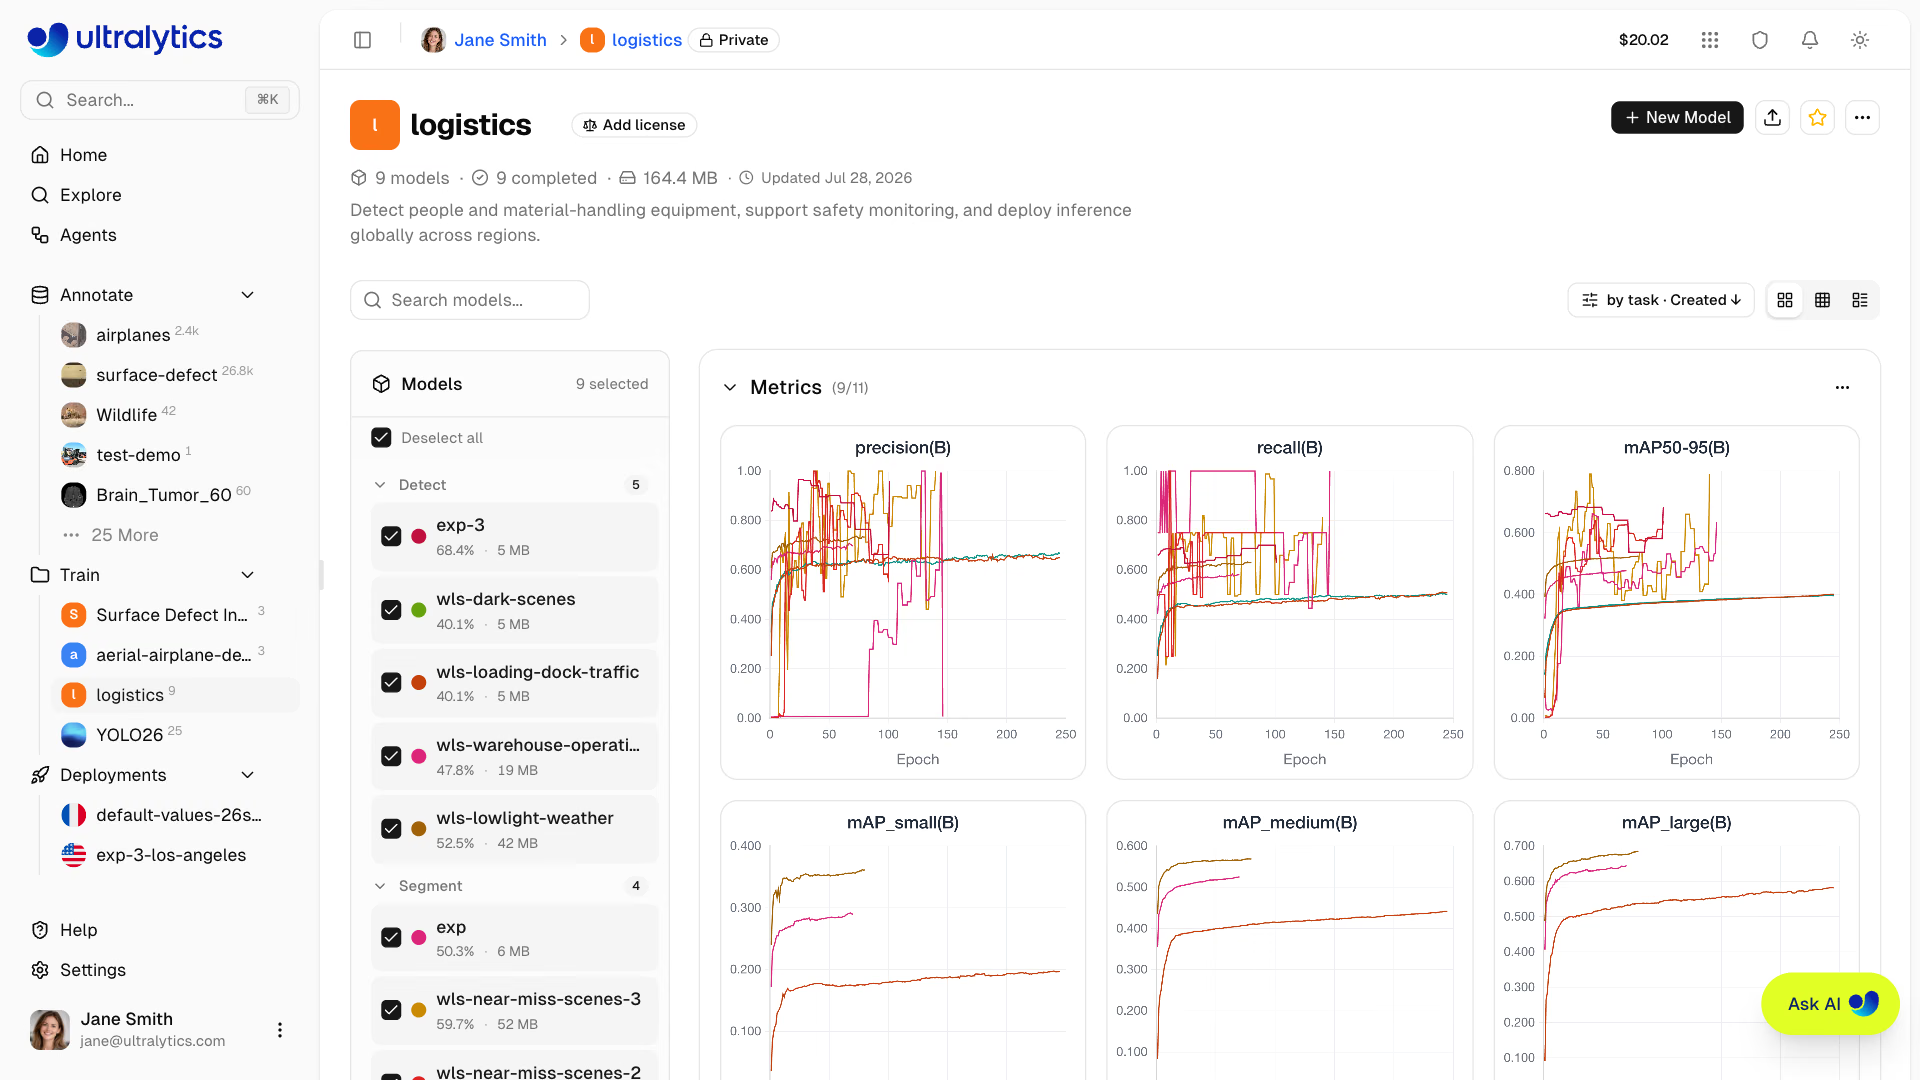
- トレーニング中のリアルタイムメトリクスを監視します
- 実験間でモデルのパフォーマンスを比較します
- 23 種類のデプロイフォーマットにエクスポートします(対応フォーマットを参照)。
ワークフロー#
| ステージ | 説明 |
|---|---|
| プロジェクト | 関連するモデルを整理するためのワークスペースを作成します |
| 設定 | データセット、ベースモデル、トレーニングパラメーターを選択します |
| トレーニング | クラウドGPUまたはローカルハードウェアで実行します |
| 監視 | 損失曲線とメトリクスをリアルタイムで表示します |
| エクスポート | 23 種類のデプロイフォーマットに変換します(詳細)。 |
トレーニングオプション#
Ultralytics Platformは、複数のトレーニング方法に対応しています。
| メソッド | 説明 | 最適な用途 |
|---|---|---|
| クラウドトレーニング | Ultralytics CloudのGPUでトレーニングします | ローカルGPUが不要で、スケーラブルです |
| ローカルトレーニング | ローカルでトレーニングし、メトリクスをPlatformに配信します | 既存のハードウェアを活用でき、プライバシーを確保できます |
| Colabトレーニング | Platformと連携したGoogle Colabを使用します | 無料でGPUを利用できます |
RTX PRO 6000より安価なGPUを選択し、Ultralyticsが管理する計算リソースに空きがある場合、Platformは選択したGPUの時間単価のまま、ジョブをRTX PRO 6000で実行します。選択したGPUで実行する場合より早く完了し、コストも抑えられることがあります。このアップグレードによって、時間やコストが増えることはありません。
GPUオプション#
Ultralytics Cloudでのクラウドトレーニングに利用できるGPU:
| GPU | 世代 | VRAM | 最適な用途 |
|---|---|---|---|
| RTX 2000 Ada | Ada | 16 GB | 小規模データセット、テスト |
| RTX A4500 | Ampere | 20 GB | 小~中規模のデータセット |
| RTX A5000 | Ampere | 24 GB | 中規模のデータセット |
| RTX 4000 Ada | Ada | 20 GB | 中規模のデータセット |
| RTX 3090 | Ampere | 24 GB | 一般的なトレーニング |
| RTX PRO 4000 | Blackwell | 24 GB | 低予算向けBlackwell |
| L4 | Ada | 24 GB | 推論に最適化 |
| A40 | Ampere | 48 GB | 大きなバッチサイズ |
| RTX A6000 | Ampere | 48 GB | 大規模モデル |
| RTX PRO 4500 | Blackwell | 32 GB | 価格性能比に優れる |
| L40 | Ada | 48 GB | 大規模モデル |
| RTX 4090 | Ada | 24 GB | 一般的なトレーニング |
| RTX PRO 5000 | Blackwell | 48 GB | 大きなバッチでのトレーニング |
| RTX 6000 Ada | Ada | 48 GB | 大きなバッチでのトレーニング |
| L40S | Ada | 48 GB | 大きなバッチでのトレーニング |
| RTX 5090 | Blackwell | 32 GB | 最新のコンシューマー向け世代 |
| A100 PCIe | Ampere | 80 GB | 本番環境向けトレーニング |
| A100 SXM | Ampere | 80 GB | 本番環境向けトレーニング |
| RTX PRO 6000 | Blackwell | 96 GB | 推奨デフォルト |
| H100 PCIe | Hopper | 80 GB | 高性能トレーニング |
| H100 NVL | Hopper | 94 GB | 最大限のパフォーマンス |
| H200 NVL | Hopper | 143 GB | 最大メモリ |
| H100 SXM | Hopper | 80 GB | 最速のトレーニング |
| H200 SXM | Hopper | 141 GB | 最大限のパフォーマンス |
| B200 | Blackwell | 180 GB | 大規模モデル(Pro+) |
| B300 | Blackwell | 288 GB | 最大規模のモデル(Pro+) |
現在の時間単位の料金は、トレーニングダイアログのGPU選択メニューと料金ページに表示されます。
B200およびB300 GPUを利用するには、ProまたはEnterpriseプランが必要です。それ以外のGPUは、Freeを含むすべてのプランで利用できます。
新規アカウントには、トレーニング用の登録クレジットが付与されます。詳細は請求をご確認ください。
リアルタイムメトリクス#
モデルのTrainタブで、リアルタイムのメトリクスと利用可能な検証結果を確認できます。
| サブタブ | メトリクス |
|---|---|
| メトリクス | タスク指標(検出ではmAP50、mAP50-95、適合率、再現率)、学習/検証損失、学習率 |
| 検証 | 利用可能な場合は、記録された検証プロットと画像ごとの分析が表示されます |
| コンソール | ANSIカラー表示と自動エラー検出に対応したライブトレーニングログ |
| システム | GPU使用率、GPUメモリと温度、CPU、RAM、ネットワークおよびディスクI/O |
最良のチェックポイント(best.pt、最も高いfitnessを記録したエポック)は、トレーニングの実行中に定期的にPlatformへアップロードされ、実行終了時にも再度アップロードされます。そのため、ダウンロード、エクスポート、デプロイには常に、それまでに生成された中で最良のエポックが使用されます。キャンセルされた実行では、アップロードが完了した最後のチェックポイントが保持されます。
クイックスタート#
1分以内にクラウドトレーニングを開始できます。
- サイドバーでプロジェクトを作成します
- New Modelをクリックします
- モデル、データセット、GPUを選択します
- Start Trainingをクリックします
クイックリンク#
- プロジェクト: モデルや実験を整理できます
- モデル:トレーニング済みチェックポイントを管理します
- クラウドトレーニング: クラウドGPUでトレーニングできます
- AutoTrain:Ask AIを使用して実験を実行し、モデルを比較します
よくある質問#
トレーニング時間は、次の要素によって異なります。
- データセットのサイズ(画像数)
- モデルのサイズ(n、s、m、l、x)
- エポック数
- 選択したGPUの種類
現在の見積もりでは、RTX PRO 6000で1000枚の画像を使用してYOLO26nを100エポック学習する場合、約6分かかります。また、RTX 4090で500枚の画像を使用してYOLO26nを50エポック学習する場合、約2 分かかります。実際の所要時間は変動します。選択したデータセットと設定に基づくライブ見積もりを、トレーニングダイアログでご確認ください。
はい。同時に実行できるクラウドトレーニングの数はプランによって異なります。Freeでは3件、Proでは10件まで、Enterpriseでは無制限です。さらに並列でトレーニングするには、複数のマシンからリモートトレーニングを実行してください。
トレーニングに失敗した場合:
- モデルは失敗としてマークされ、計算インスタンスは終了します
- モデルページには、取得されたエラーを示すエラーバナー、コンソール出力へのリンク、AIで診断、および同じ設定でトレーニングダイアログを再度開くトレーニングを再試行アクション(Editorロール以上)が表示されます
- 実行状況の報告が4時間途絶えた場合、自動的に失敗としてマークされ、計算リソースが解放されます
- クラウドコンピューティングが開始していた場合は、経過したGPU時間分が請求されます。コンピューティング開始前の失敗では、GPU使用料は発生しません
シナリオ 推奨GPU ほとんどのトレーニングジョブ RTX PRO 6000 大規模なデータセットまたはバッチサイズ H100 SXMまたはH200 コスト重視 RTX 4090


コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。