Neural Magic의 DeepSparse Engine으로 YOLO26 추론 최적화#
다양한 하드웨어에 객체 탐지 모델인 Ultralytics YOLO26을 배포할 때 최적화와 같은 고유한 문제에 직면할 수 있습니다. YOLO26과 Neural Magic의 DeepSparse Engine을 통합하면 이러한 문제를 해결할 수 있습니다. 이 통합은 YOLO26 모델의 실행 방식을 바꾸고 CPU에서 GPU 수준의 성능을 구현합니다.
이 가이드에서는 Neural Magic의 DeepSparse를 사용하여 YOLO26을 배포하고 추론을 실행하는 방법과 최적화 여부를 확인하기 위해 성능을 벤치마크하는 방법을 설명합니다.
Neural Magic은 2025년 1월 Red Hat에 인수되었으며, deepsparse, sparseml, sparsezoo, sparsify 라이브러리의 커뮤니티 버전에 대한 지원을 중단합니다. 자세한 내용은 sparsify GitHub 저장소의 Readme에 게시된 공지를 참조하세요.
Neural Magic의 DeepSparse#
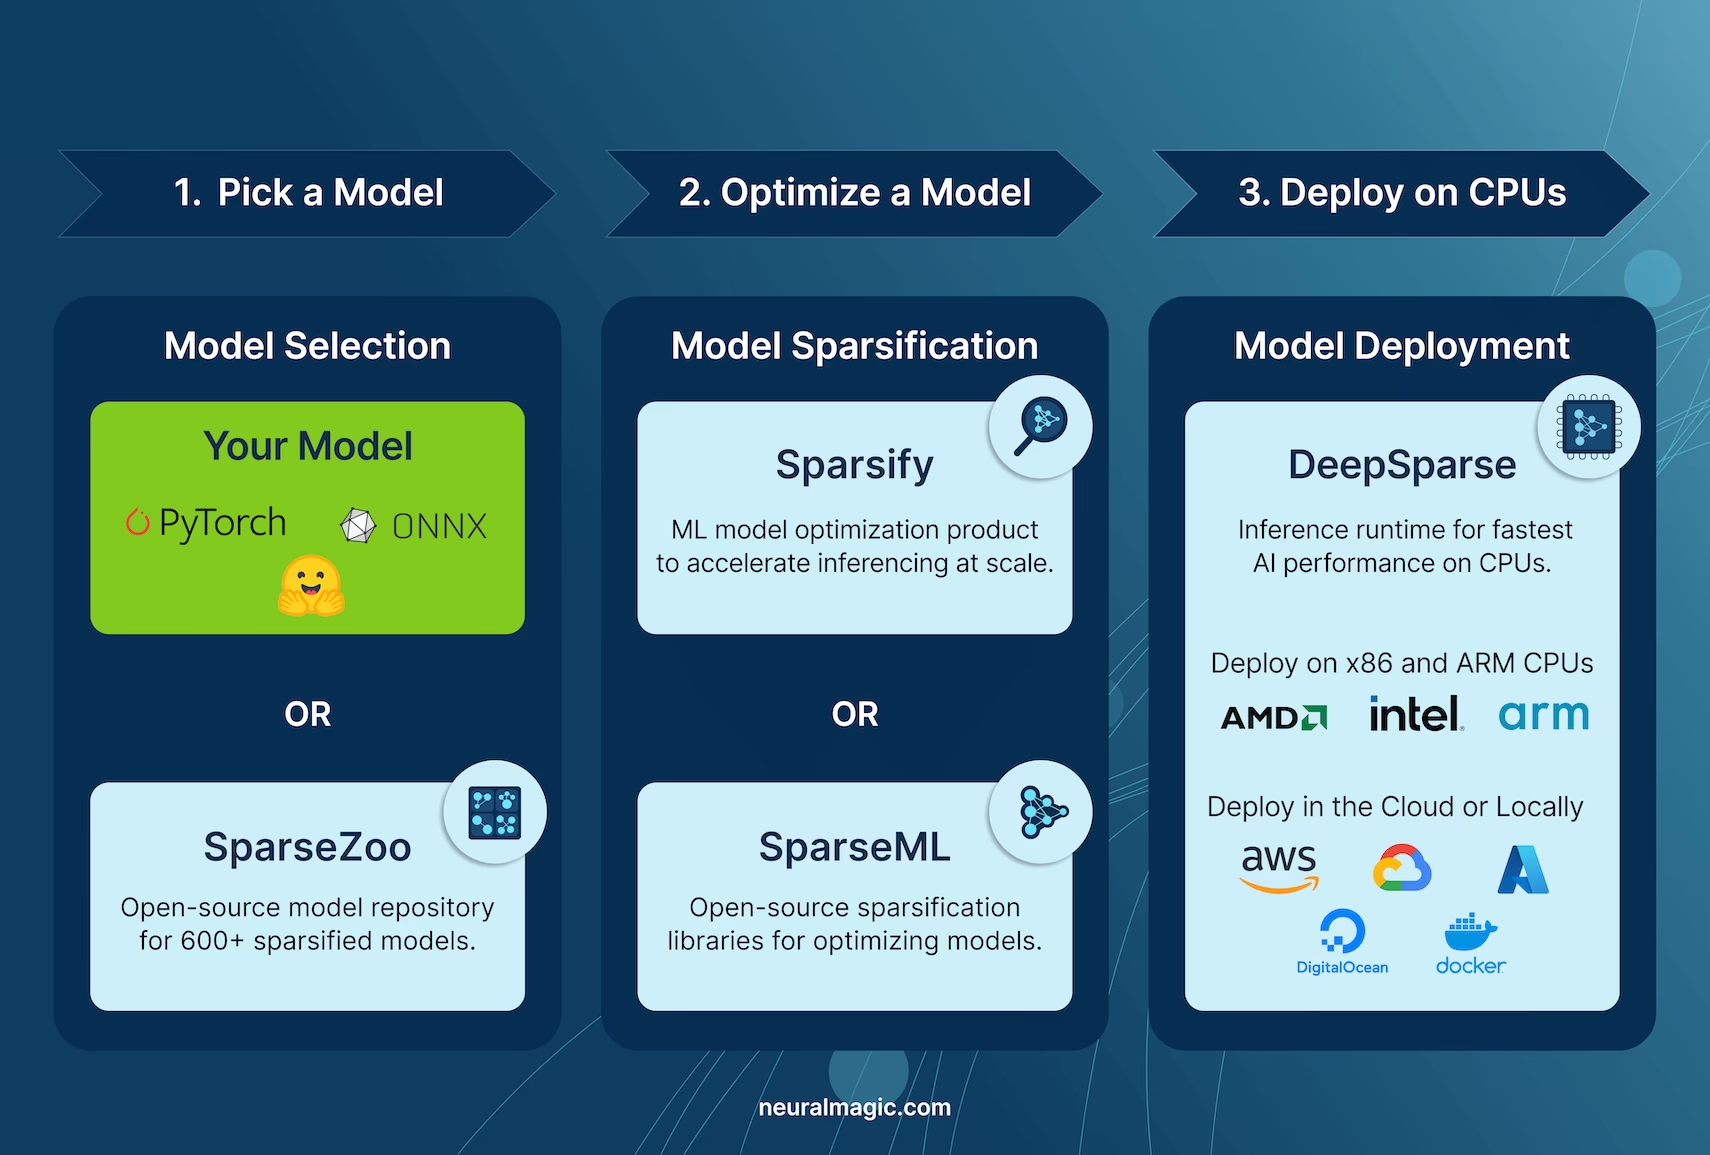
Neural Magic의 DeepSparse는 CPU에서 신경망 실행을 최적화하도록 설계된 추론 런타임입니다. 희소성, 가지치기, 양자화와 같은 고급 기법을 적용하여 정확도를 유지하면서 컴퓨팅 요구량을 크게 줄입니다. DeepSparse는 다양한 디바이스에서 신경망을 효율적이고 확장성 있게 실행할 수 있는 유연한 솔루션을 제공합니다.
Neural Magic의 DeepSparse와 YOLO26 통합의 이점#
DeepSparse를 사용하여 YOLO26을 배포하는 방법을 살펴보기 전에 DeepSparse의 이점을 알아보겠습니다. 주요 장점은 다음과 같습니다.
- 추론 속도 향상: 최대 525 FPS(YOLOv8n 기준)를 달성하여 기존 방식에 비해 YOLO 추론 성능을 크게 높입니다.
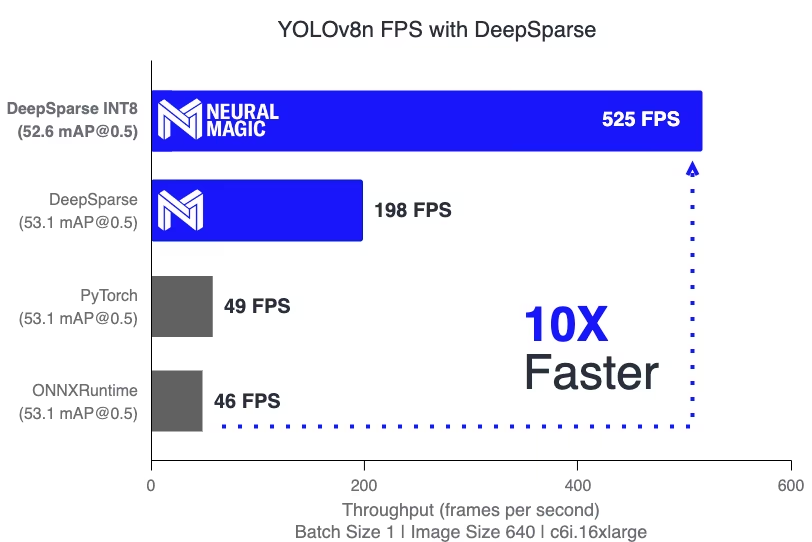
- 모델 효율성 최적화: 가지치기와 양자화를 사용하여 YOLO26의 효율성을 높이고 모델 크기와 컴퓨팅 요구량을 줄이면서 정확도를 유지합니다.
-
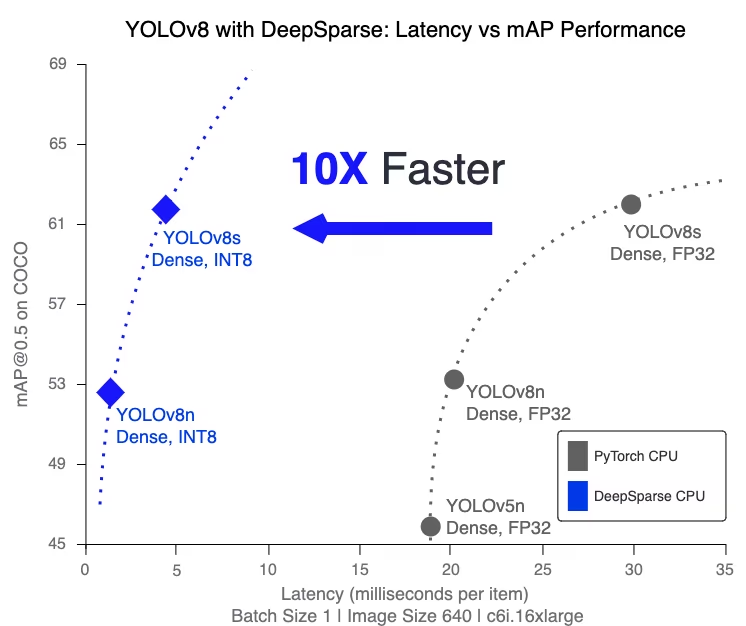
일반 CPU에서 높은 성능: CPU에서 GPU와 유사한 성능을 제공하므로 다양한 애플리케이션에 더 쉽게 도입할 수 있고 비용 효율적입니다.
-
간소화된 통합 및 배포: 이미지 및 동영상 어노테이션 기능을 비롯해 YOLO26을 애플리케이션에 쉽게 통합할 수 있는 사용자 친화적인 도구를 제공합니다.
-
다양한 모델 유형 지원: 일반 YOLO 모델과 희소성 최적화 YOLO 모델을 모두 지원하여 배포 유연성을 높입니다.
-
비용 효율적이고 확장 가능한 솔루션: 운영 비용을 줄이고 고급 객체 탐지 모델을 확장성 있게 배포할 수 있습니다.
Neural Magic의 DeepSparse 기술은 어떻게 작동하나요?#
Neural Magic의 DeepSparse 기술은 신경망 연산에서 나타나는 인간 두뇌의 효율성에서 영감을 얻었습니다. 다음과 같이 두뇌의 두 가지 핵심 원리를 적용합니다.
-
희소성: 희소화는 딥러닝 네트워크에서 중복 정보를 가지치기하여 정확도를 유지하면서 더 작고 빠른 모델을 만드는 과정입니다. 이 기법은 네트워크 크기와 컴퓨팅 요구량을 크게 줄입니다.
-
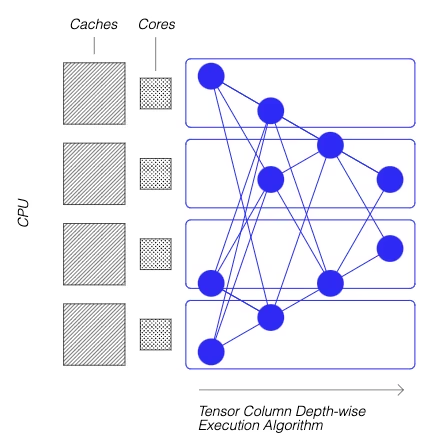
참조 지역성: DeepSparse는 네트워크를 Tensor Column으로 나누는 고유한 실행 방식을 사용합니다. 이 열은 깊이 방향으로 실행되어 CPU 캐시에 완전히 들어갑니다. 이러한 접근 방식은 두뇌의 효율성을 모방하여 데이터 이동을 최소화하고 CPU 캐시 활용도를 극대화합니다.
사용자 지정 데이터셋으로 학습한 YOLO26의 희소 버전 만들기#
Neural Magic의 오픈 소스 모델 저장소인 SparseZoo는 희소화가 사전에 적용된 YOLOv8 모델 체크포인트 모음을 제공합니다. Ultralytics와 원활하게 통합되는 SparseML을 사용하면 간단한 명령줄 인터페이스를 통해 특정 데이터셋에 맞춰 이러한 희소 체크포인트를 손쉽게 파인튜닝할 수 있습니다.
자세한 내용은 Neural Magic의 SparseML YOLOv8 문서를 참조하세요.
사용법: DeepSparse를 사용한 YOLO26 배포#
Neural Magic의 DeepSparse로 YOLO26을 배포하는 과정은 몇 가지 간단한 단계로 이루어집니다. 사용 지침을 살펴보기 전에 Ultralytics에서 제공하는 YOLO26 모델을 확인하세요. 프로젝트 요구 사항에 가장 적합한 모델을 선택하는 데 도움이 됩니다. 시작 방법은 다음과 같습니다.
1단계: 설치#
필수 패키지를 설치하려면 다음을 실행하세요:
# Install the required packages
pip install deepsparse[yolov8]
2단계: YOLO26을 ONNX 형식으로 내보내기#
DeepSparse Engine을 사용하려면 YOLO26 모델이 ONNX 형식이어야 합니다. DeepSparse와 호환되려면 모델을 이 형식으로 내보내야 합니다. 다음 명령을 사용하여 YOLO26 모델을 내보냅니다.
# Export YOLO26 model to ONNX format
yolo detect export model=yolo26n.pt format=onnx opset=13
이 명령은 yolo26n.onnx 모델을 디스크에 저장합니다.
3단계: 추론 배포 및 실행#
YOLO26 모델을 ONNX 형식으로 준비하면 DeepSparse를 사용해 추론을 배포하고 실행할 수 있습니다. 직관적인 Python API를 사용하면 간편하게 수행할 수 있습니다.
from deepsparse import Pipeline

# YOLO26 ONNX 모델 경로 지정
model_path = "path/to/yolo26n.onnx"

# DeepSparse Pipeline 설정
yolo_pipeline = Pipeline.create(task="yolov8", model_path=model_path)

# 이미지에서 모델 실행
images = ["path/to/image.jpg"]
pipeline_outputs = yolo_pipeline(images=images)
4단계: 성능 벤치마크#
YOLO26 모델이 DeepSparse에서 최적으로 작동하는지 확인하는 것이 중요합니다. 모델의 성능을 벤치마크하여 처리량과 지연 시간을 분석할 수 있습니다.
# Benchmark performance
deepsparse.benchmark model_path="path/to/yolo26n.onnx" --scenario=sync --input_shapes="[1,3,640,640]"
5단계: 추가 기능#
DeepSparse는 이미지 어노테이션 및 데이터셋 평가와 같이 애플리케이션에서 YOLO26을 실용적으로 통합할 수 있는 추가 기능을 제공합니다.
# For image annotation
deepsparse.yolov8.annotate --source "path/to/image.jpg" --model_filepath "path/to/yolo26n.onnx"

# For evaluating model performance on a dataset
deepsparse.yolov8.eval --model_path "path/to/yolo26n.onnx"
annotate 명령을 실행하면 지정한 이미지가 처리되어 객체를 탐지하고, 바운딩 박스와 분류 결과가 표시된 이미지가 저장됩니다. 어노테이션된 이미지는 annotation-results 폴더에 저장됩니다. 이를 통해 모델의 탐지 성능을 시각적으로 확인할 수 있습니다.
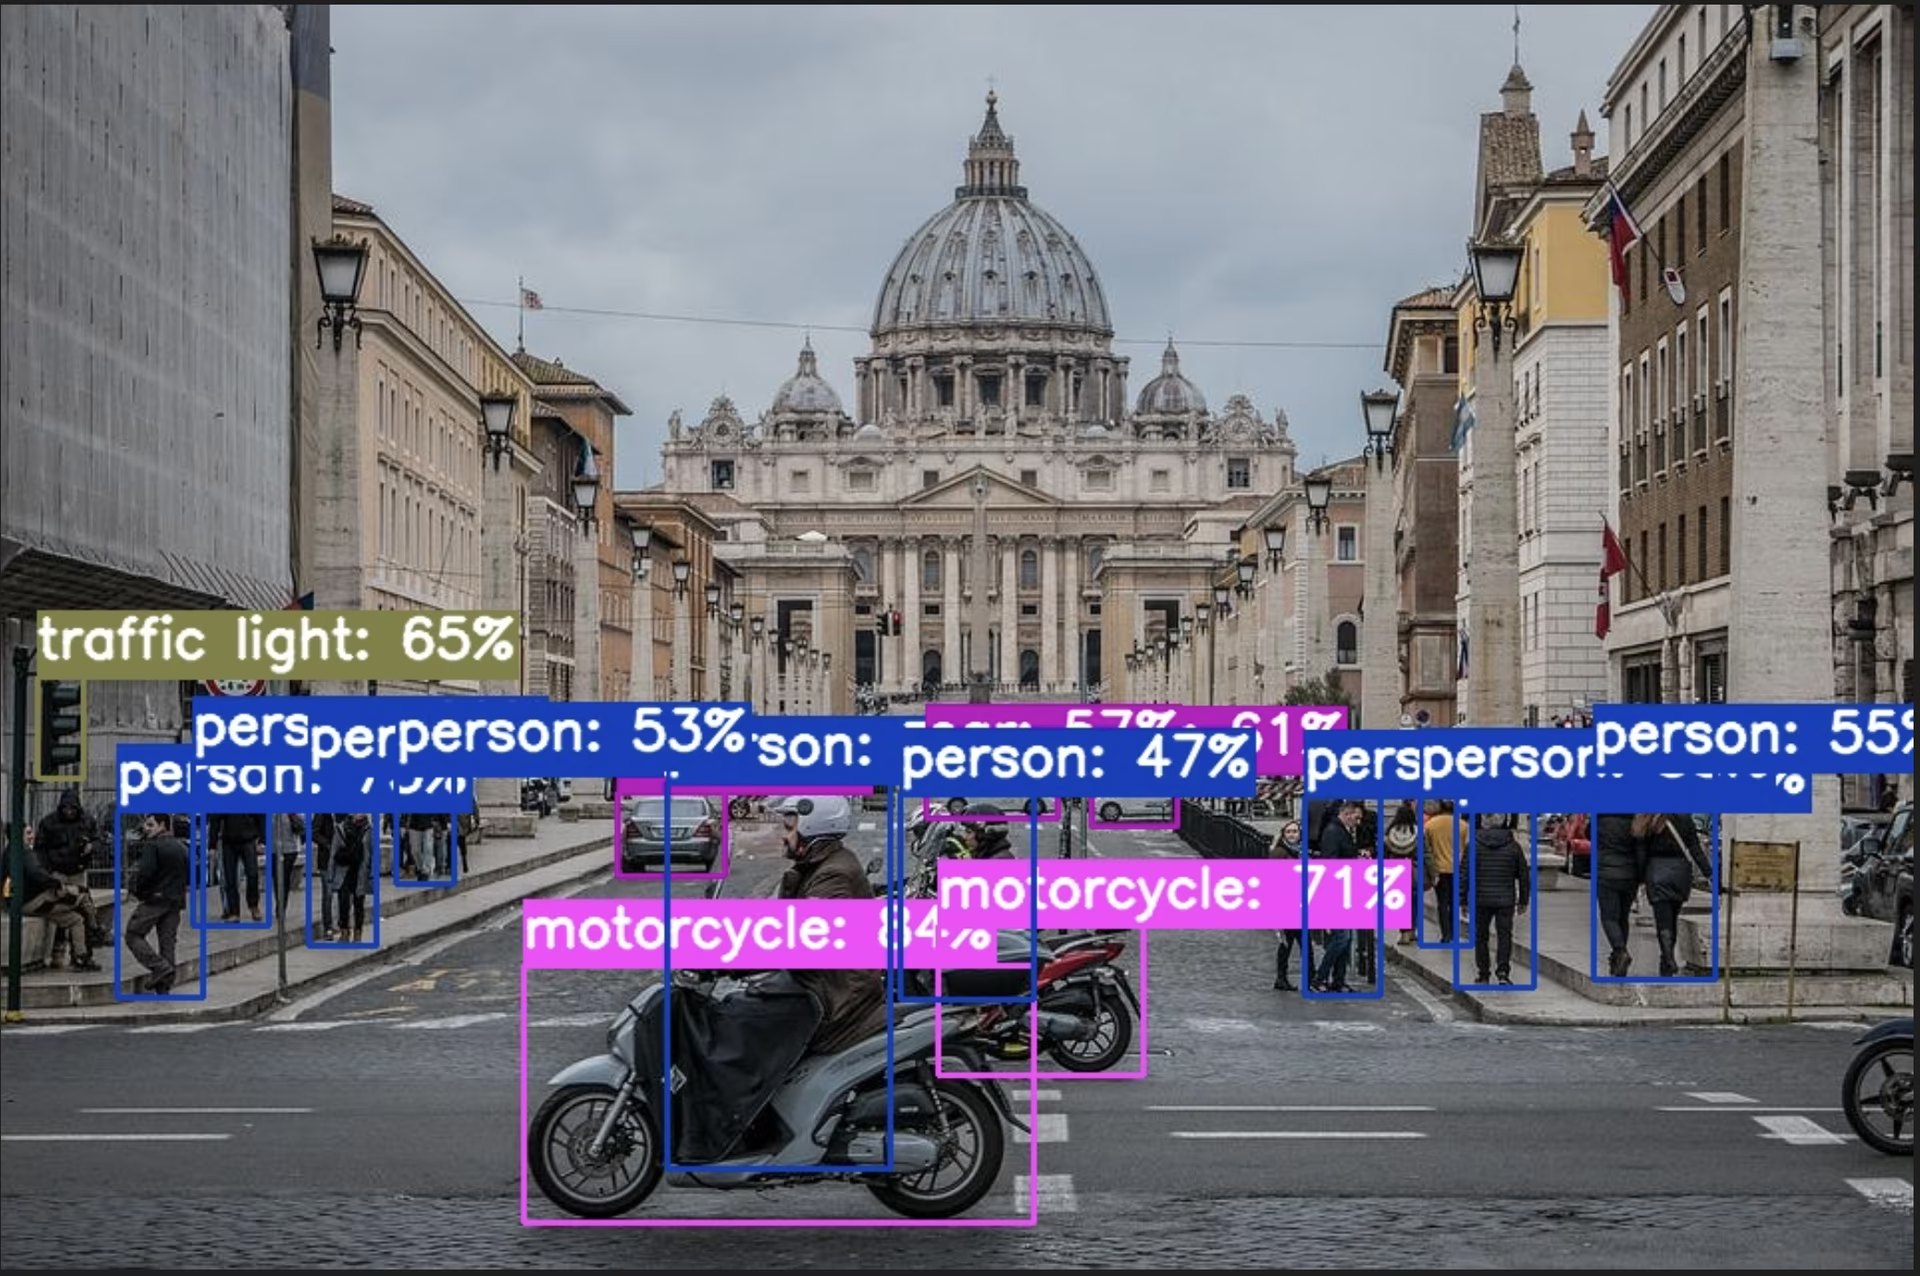
eval 명령을 실행하면 정밀도, 재현율, mAP(평균 정밀도)와 같은 상세한 출력 지표를 확인할 수 있습니다. 이러한 지표는 데이터셋에서 모델 성능을 종합적으로 보여 주며, 특히 특정 사용 사례에 맞게 YOLO26 모델을 미세 조정하고 최적화하여 높은 정확도와 효율성을 확보하는 데 유용합니다.
요약#
이 가이드에서는 Ultralytics의 YOLO26과 Neural Magic의 DeepSparse Engine을 통합하는 방법을 살펴보았습니다. 이 통합으로 CPU 플랫폼에서 YOLO26의 성능이 향상되고, GPU 수준의 효율성과 고급 신경망 희소성 기법을 활용할 수 있음을 소개했습니다.
자세한 내용과 고급 사용법은 Neural Magic의 DeepSparse 저장소를 참조하세요. YOLOv8 통합 가이드를 살펴보고 YouTube의 안내 세션을 시청할 수도 있습니다.
다양한 YOLO26 통합 옵션에 대해 더 폭넓게 알아보려면 Ultralytics 통합 가이드 페이지를 방문하세요. 이 페이지에서 여러 가지 유용한 통합 가능성을 확인할 수 있습니다.
자주 묻는 질문#
Neural Magic의 DeepSparse Engine은 희소성, 가지치기, 양자화 등의 고급 기법을 통해 CPU에서 신경망 실행을 최적화하도록 설계된 추론 런타임입니다. DeepSparse를 YOLO26과 통합하면 일반 CPU에서 GPU와 유사한 성능을 구현하여 정확도를 유지하면서 추론 속도, 모델 효율성 및 전반적인 성능을 크게 향상할 수 있습니다. 자세한 내용은 Neural Magic의 DeepSparse 섹션을 참조하세요.
Neural Magic의 DeepSparse를 사용해 YOLO26을 배포하는 데 필요한 패키지를 간편하게 설치할 수 있습니다. CLI를 사용하면 쉽게 설치할 수 있습니다. 실행해야 하는 명령은 다음과 같습니다.
pip install deepsparse[yolov8]설치가 완료되면 설치 섹션의 단계를 따라 환경을 설정하고 DeepSparse와 YOLO26을 사용하기 시작하세요.
DeepSparse와 호환되는 데 필요한 ONNX 형식으로 YOLO26 모델을 변환하려면 다음 CLI 명령을 사용하세요.
yolo detect export model=yolo26n.pt format=onnx opset=13이 명령은 YOLO26 모델(
yolo26n.pt)을 DeepSparse Engine에서 사용할 수 있는 형식(yolo26n.onnx)으로 내보냅니다. 모델 내보내기에 대한 자세한 내용은 모델 내보내기 섹션을 참조하세요.DeepSparse에서 YOLO26 성능을 벤치마크하면 처리량과 지연 시간을 분석하여 모델이 최적화되었는지 확인할 수 있습니다. 다음 CLI 명령을 사용해 벤치마크를 실행할 수 있습니다.
deepsparse.benchmark model_path="path/to/yolo26n.onnx" --scenario=sync --input_shapes="[1,3,640,640]"이 명령은 중요한 성능 지표를 제공합니다. 자세한 내용은 성능 벤치마크 섹션을 참조하세요.
Neural Magic의 DeepSparse를 YOLO26과 통합하면 다음과 같은 여러 이점을 얻을 수 있습니다.
- 추론 속도 향상: 최대 525 FPS(YOLOv8n 기준)를 달성하여 DeepSparse의 최적화 역량을 보여 줍니다.
- 모델 효율성 최적화: 희소성, 가지치기, 양자화 기법을 사용해 정확도를 유지하면서 모델 크기와 연산 요구량을 줄입니다.
- 일반 CPU에서 높은 성능: 비용 효율적인 CPU 하드웨어에서 GPU와 유사한 성능을 제공합니다.
- 간소화된 통합: 간편한 배포와 통합을 위한 사용자 친화적인 도구를 제공합니다.
- 유연성: 일반 YOLO 모델과 희소성 최적화 YOLO 모델을 모두 지원합니다.
- 비용 효율성: 효율적인 리소스 활용으로 운영 비용을 절감합니다.
이러한 이점을 자세히 알아보려면 YOLO26과 Neural Magic의 DeepSparse 통합 이점 섹션을 참조하세요.