Датасет DOTA с OBB
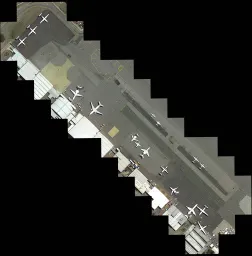
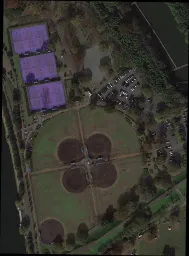
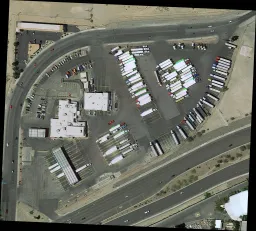
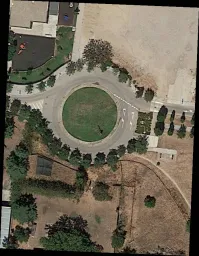
Датасет DOTA — масштабный бенчмарк для обнаружения объектов на аэрофотоснимках. Он выпущен в трёх версиях (v1.0, v1.5, v2.0) и содержит до 1,7 млн аннотаций ориентированных ограничивающих рамок (OBB) для 18 категорий, полученных с помощью различных аэрофотосенсоров и платформ.
Открой официально размещённые датасеты DOTA v1.5 и DOTA v1.0 на платформе Ultralytics, чтобы предварительно просмотреть ориентированные аннотации, изучить статистику и клонировать датасеты для обучения.
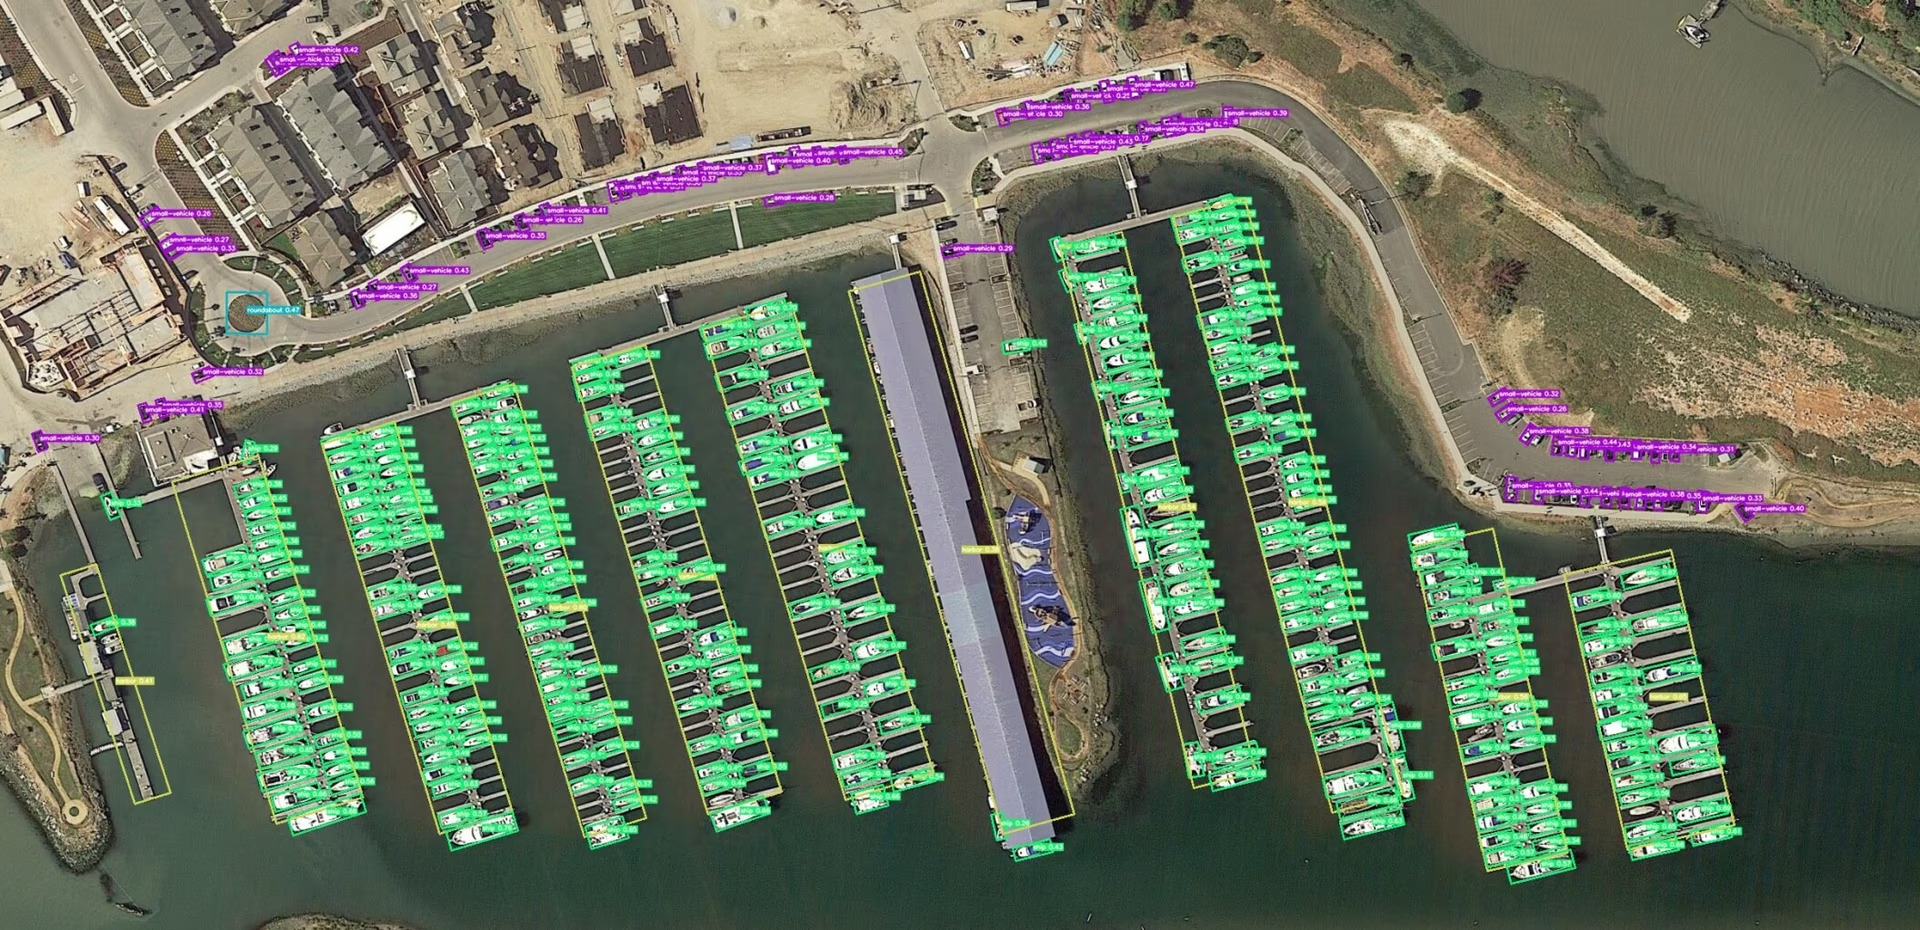
Основные особенности#
Смотри: Как обучить Ultralytics YOLO на датасете DOTA для обнаружения ориентированных ограничивающих рамок в Google Colab
- Данные собраны с различных сенсоров и платформ; размеры изображений варьируются от 800 × 800 до 20 000 × 20 000 пикселей.
- Более 1,7 млн ориентированных ограничивающих рамок для 18 категорий.
- Поддерживается обнаружение объектов разных масштабов благодаря широкому диапазону размеров объектов на изображениях.
- Объекты размечены экспертами произвольными четырёхугольниками (8 степеней свободы), которые охватывают объекты разных масштабов, ориентаций и форм.
Версии датасета#
DOTA-v1.0#
- Содержит 15 распространённых категорий.
- Включает 2 806 изображений и 188 282 объекта.
- Разбиение: 1/2 для обучения (1 411 изображений), 1/6 для валидации (458 изображений) и 1/3 для тестирования (937 изображений).
DOTA-v1.5#
- Включает те же изображения, что и DOTA-v1.0.
- Также размечены очень маленькие объекты размером менее 10 пикселей.
- Добавлена новая категория: «портальный кран».
- Всего 403 318 объектов.
- Выпущен для конкурса DOAI Challenge 2019 по обнаружению объектов на аэрофотоснимках.
DOTA-v2.0#
- Включает снимки из Google Earth, спутника GF-2 и другие аэрофотоснимки.
- Содержит 18 распространённых категорий.
- Содержит 11 268 изображений и 1 793 658 экземпляров.
- Добавлены новые категории: «аэропорт» и «вертолётная площадка».
- Разбиение изображений:
- Обучение: 1 830 изображений с 268 627 экземплярами.
- Валидация: 593 изображения с 81 048 экземплярами.
- Тестовая выборка для разработки: 2 792 изображения с 353 346 экземплярами.
- Тестовая выборка для испытаний: 6 053 изображения с 1 090 637 экземплярами.
Структура набора данных#
DOTA имеет структурированную организацию, предназначенную для задач обнаружения объектов с OBB:
- Изображения: Обширная коллекция аэрофотоснимков высокого разрешения, на которых запечатлены разнообразные ландшафты и объекты.
- Ориентированные ограничивающие рамки: Аннотации в виде повернутых прямоугольников, охватывающих объекты независимо от их ориентации. Они идеально подходят для фиксации таких объектов, как самолёты, корабли и здания.
Применение#
DOTA служит бенчмарком для обучения и оценки моделей, предназначенных для анализа аэрофотоснимков. Аннотации ориентированных ограничивающих рамок делают этот датасет сложным тестом для моделей обнаружения объектов на повёрнутых и плотно расположенных объектах на аэрофотоснимках. Датасет широко применяется в дистанционном зондировании, системах наблюдения и экологическом мониторинге.
Файл YAML набора данных#
Файл YAML набора данных задаёт пути к изображениям и меткам, названия классов и другие важные метаданные. Ultralytics поддерживает официальные файлы YAML для двух наиболее распространённых версий:
Используй YAML-файл, соответствующий загруженной версии, или создай собственный YAML, если работаешь с DOTA-v2 или другой производной версией. Обе версии автоматически загружаются из ресурсов Ultralytics GitHub (2 ГБ) при первом запуске обучения.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# DOTA 1.0 dataset https://captain-whu.github.io/DOTA/index.html for object detection in aerial images by Wuhan University
# Documentation: https://docs.ultralytics.com/datasets/obb/dota-v2
# Example usage: yolo train model=yolov8n-obb.pt data=DOTAv1.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── DOTAv1 ← downloads here (2 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: DOTAv1 # dataset root dir
train: images/train # train images (relative to 'path') 1411 images
val: images/val # val images (relative to 'path') 458 images
test: images/test # test images (optional) 937 images

# Classes for DOTA 1.0
names:
  0: plane
  1: ship
  2: storage tank
  3: baseball diamond
  4: tennis court
  5: basketball court
  6: ground track field
  7: harbor
  8: bridge
  9: large vehicle
  10: small vehicle
  11: helicopter
  12: roundabout
  13: soccer ball field
  14: swimming pool

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/DOTAv1.zip
Разбиение изображений DOTA#
Исходные изображения часто превышают 10 000 пикселей по каждой стороне, поэтому перед передачей данных в YOLO рекомендуется разделить их на фрагменты. Используй приведённый ниже вспомогательный инструмент, чтобы нарезать исходные изображения на перекрывающиеся фрагменты размером 1024 × 1024 в нескольких масштабах, сохранив соответствие аннотаций.
from ultralytics.data.split_dota import split_test, split_trainval

# Разделить обучающую и проверочную выборки вместе с метками.
split_trainval(
    data_root="path/to/DOTAv1.0/",
    save_dir="path/to/DOTAv1.0-split/",
    rates=[0.5, 1.0, 1.5],  # multiscale
    gap=500,
)
# Разделить тестовую выборку без меток.
split_test(
    data_root="path/to/DOTAv1.0/",
    save_dir="path/to/DOTAv1.0-split/",
    rates=[0.5, 1.0, 1.5],  # multiscale
    gap=500,
)Сохраняй стандартную структуру каталогов YOLO в выходной папке (images/train, labels/train и т. д.), чтобы напрямую указывать её в YAML-файле набора данных.
Использование#
Чтобы обучить модель YOLO26n-obb на датасете DOTA v1, используй следующие фрагменты кода. Полный список доступных аргументов смотри в документации к своей модели. Если сначала хочешь поэкспериментировать с меньшим подмножеством, попробуй датасет DOTA8, в котором всего 8 изображений для быстрого тестирования; его можно просматривать на платформе Ultralytics.
Все изображения и связанные с ними аннотации в датасете DOTAv1 предназначены только для академического использования; коммерческое использование запрещено. Ultralytics трактует эти ограничения как относящиеся к исходному датасету, а не к весам предобученной или дообученной модели. Ознакомься с условиями DOTA, чтобы определить, подходят ли они для твоих целей.
from ultralytics import YOLO

# Загрузи предварительно обученную модель YOLO26n-OBB
model = YOLO("yolo26n-obb.pt")

# Обучи модель на датасете DOTAv1
results = model.train(data="DOTAv1.yaml", epochs=100, imgsz=1024)
Примеры данных и аннотаций#
Ниже показаны типичные сцены и аннотации DOTA:
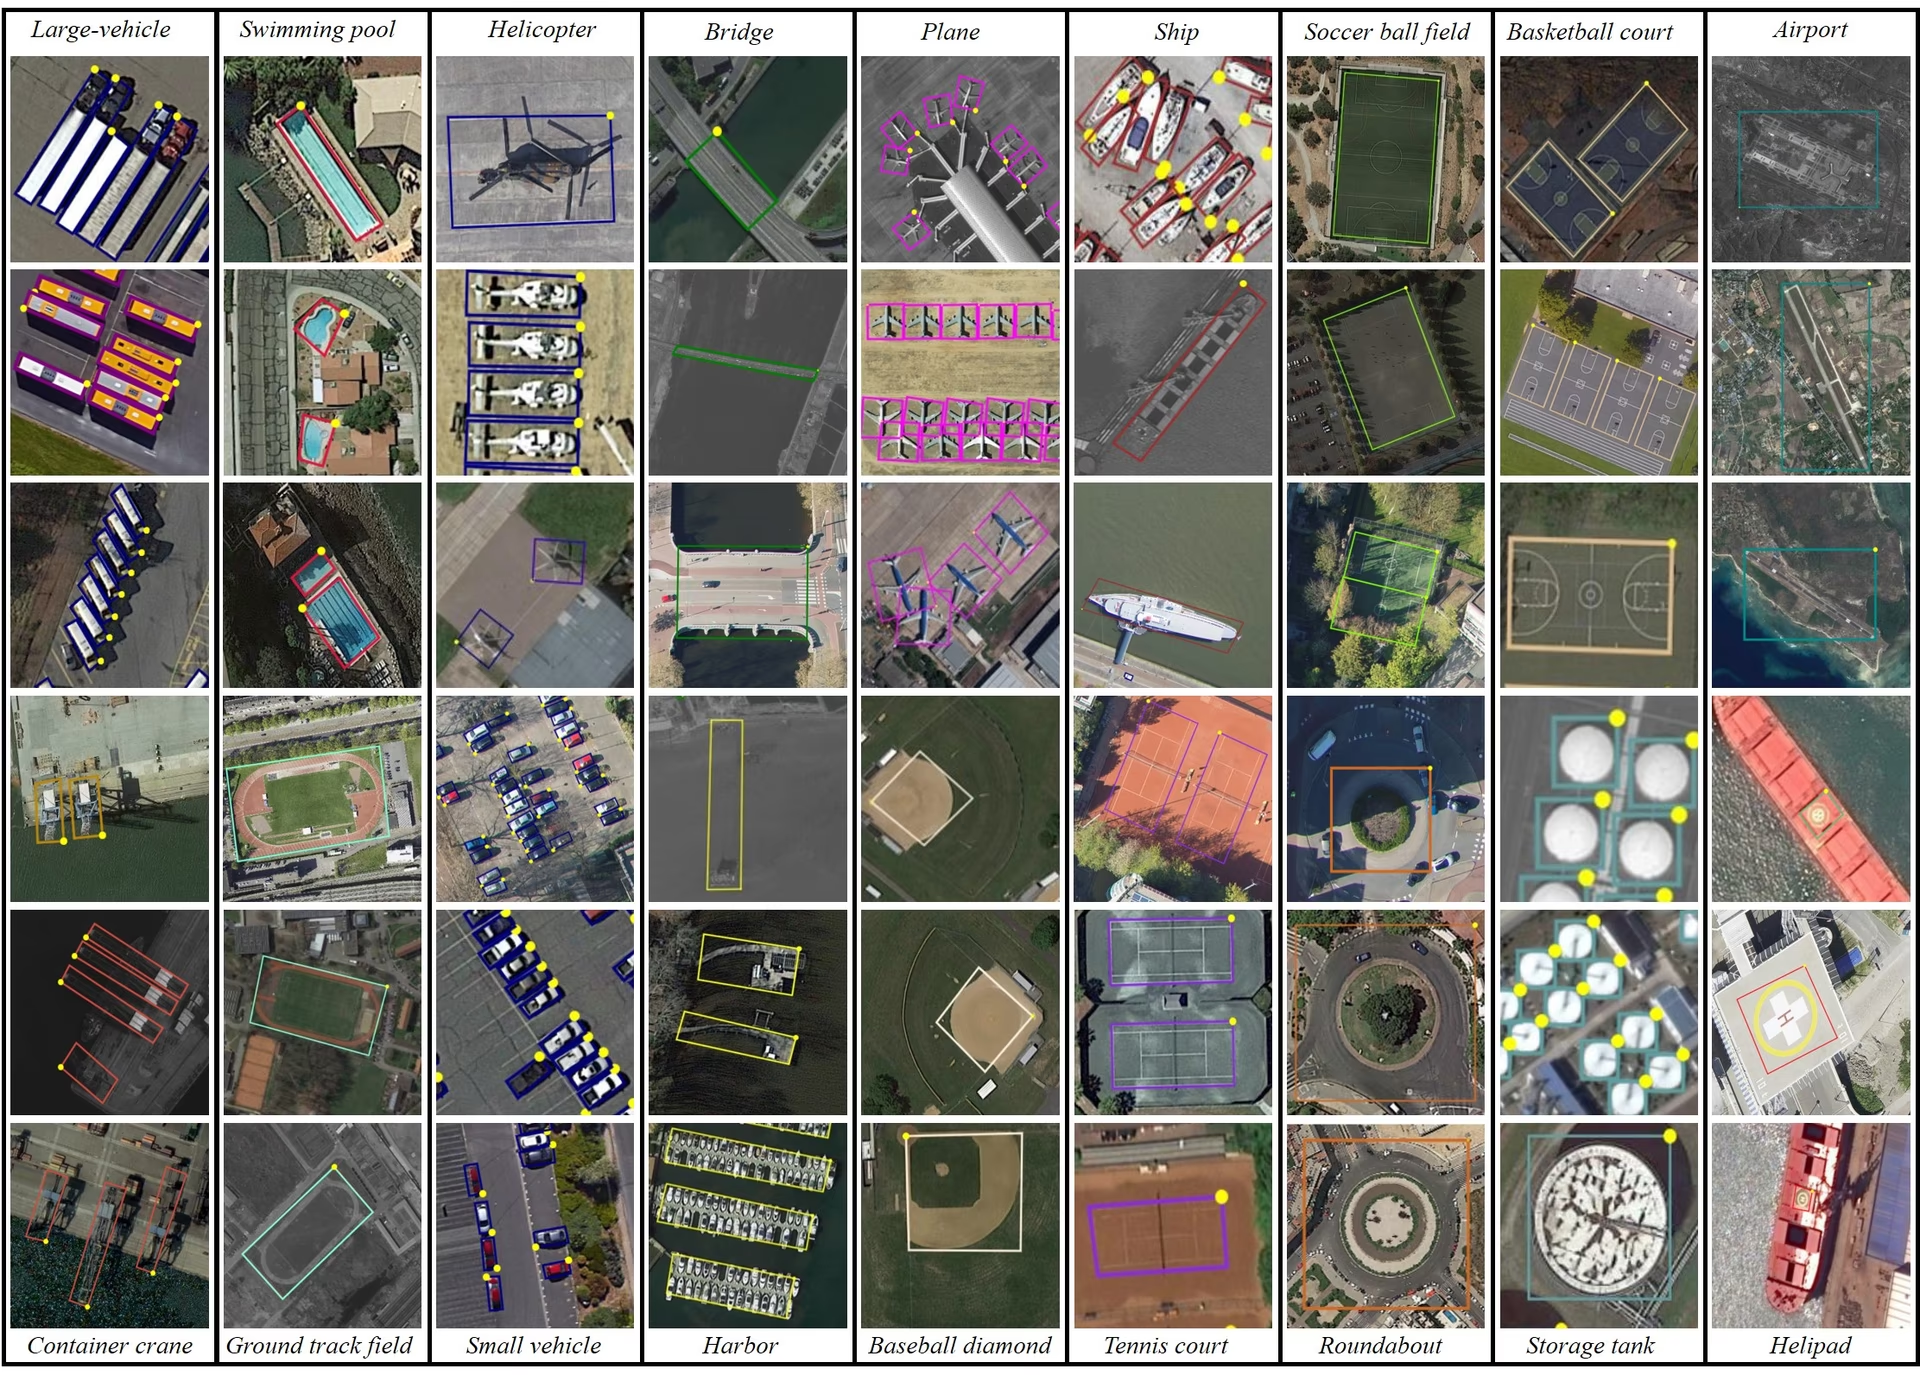
- Примеры DOTA: Этот снимок подчёркивает сложность аэрофотосцен и важность аннотаций ориентированных ограничивающих рамок, которые фиксируют объекты в их естественной ориентации.
Эти сцены демонстрируют сложности обнаружения, характерные для аэрофотоснимков. DOTA-v2.0 широко применяется в проектах по дистанционному зондированию и воздушному наблюдению благодаря подробным аннотациям и разнообразию категорий объектов.
Цитирование и благодарности#
Если ты используешь DOTA в своей работе, укажи в цитировании соответствующие научные статьи:
@article{9560031,
  author={Ding, Jian and Xue, Nan and Xia, Gui-Song and Bai, Xiang and Yang, Wen and Yang, Michael and Belongie, Serge and Luo, Jiebo and Datcu, Mihai and Pelillo, Marcello and Zhang, Liangpei},
  journal={IEEE Transactions on Pattern Analysis and Machine Intelligence},
  title={Object Detection in Aerial Images: A Large-Scale Benchmark and Challenges},
  year={2022},
  volume={44},
  number={11},
  pages={7778-7796},
  doi={10.1109/TPAMI.2021.3117983}
}
Благодарим команду, подготовившую датасеты DOTA. Полную информацию о датасете смотри на официальном сайте DOTA.
Часто задаваемые вопросы#
Набор данных DOTA предназначен для обнаружения объектов на аэрофотоснимках. В нём представлены аннотированные изображения разнообразных воздушных сцен с ориентированными ограничивающими рамками (OBB). Разнообразие ориентации, масштаба и формы объектов в 1,7 млн аннотаций и 18 категориях делает DOTA идеальным набором данных для разработки и оценки моделей анализа аэрофотоснимков, например для наблюдения, экологического мониторинга и ликвидации последствий стихийных бедствий.
В DOTA для аннотирования используются ориентированные ограничивающие рамки (OBB), представленные повёрнутыми прямоугольниками, которые охватывают объекты независимо от их ориентации. Этот метод позволяет точно фиксировать объекты, в том числе мелкие и расположенные под разными углами. Многошкальные изображения датасета размером от 800 × 800 до 20 000 × 20 000 пикселей также позволяют эффективно обнаруживать как мелкие, так и крупные объекты. Этот подход особенно полезен для аэрофотоснимков, где объекты встречаются под разными углами и имеют разный масштаб.
Чтобы обучить модель на наборе данных DOTA, используй следующий пример с Ultralytics YOLO:
Пример обученияfrom ultralytics import YOLO # Загрузи предварительно обученную модель YOLO26n-OBB model = YOLO("yolo26n-obb.pt") # Обучи модель на датасете DOTAv1 results = model.train(data="DOTAv1.yaml", epochs=100, imgsz=1024)Подробнее о разбиении и предварительной обработке изображений DOTA см. в разделе «Разбиение изображений DOTA».
- DOTA-v1.0: Включает 15 распространённых категорий на 2 806 изображениях с 188 282 экземплярами. Набор данных разделён на обучающую, проверочную и тестовую выборки.
- DOTA-v1.5: Развивает DOTA-v1.0: в ней размечены очень маленькие экземпляры (менее 10 пикселей) и добавлена новая категория «контейнерный кран»; всего в наборе 403 318 экземпляров.
- DOTA-v2.0: Ещё больше расширяет набор за счёт аннотаций из Google Earth и спутниковых снимков GF-2: версия включает 11 268 изображений и 1 793 658 экземпляров. Добавлены новые категории, например «аэропорт» и «вертолётная площадка».
Подробное сравнение и дополнительные сведения см. в разделе «Версии набора данных».
Изображения DOTA могут быть очень большими, поэтому для удобства обучения их делят на фрагменты меньшего размера. Вот фрагмент кода на Python для разбиения изображений:
Примерfrom ultralytics.data.split_dota import split_test, split_trainval # разделить обучающую и проверочную выборки вместе с метками. split_trainval( data_root="path/to/DOTAv1.0/", save_dir="path/to/DOTAv1.0-split/", rates=[0.5, 1.0, 1.5], # multiscale gap=500, ) # разделить тестовую выборку без меток. split_test( data_root="path/to/DOTAv1.0/", save_dir="path/to/DOTAv1.0-split/", rates=[0.5, 1.0, 1.5], # multiscale gap=500, )Этот процесс повышает эффективность обучения и качество модели. Подробные инструкции см. в разделе «Разбиение изображений DOTA».


Комментарии17
Задай вопрос, поделись результатами или помоги кому-нибудь.
XWP-PPP
May I ask how you converted the inference results from YOLOV8 OBB into inference results that can be uploaded to DOTA's Task 1 server? I saved the final inference results of the model in the form of xyxyxy and uploaded them via email. However, the mAP results provided on YOLO's official website differ significantly. I would like to know the reason for this. Can you provide me with a conversion code to convert the test image set into a result that can be uploaded to DOTA's Task 1 server? Thank you very much for your help!
1 Paula DerrengerUltralytics(изменено)
@XWP-PPP hi there!
DOTA's Task 1 server expects a zip of one text file per class (
Task1_plane.txt,Task1_storage-tank.txt, ...), where each line isimgname score x1 y1 x2 y2 x3 y3 x4 y4, with the image name given without extension. OBB results are stored inresult.obb, notresult.boxes. Here is a snippet that builds those files:import shutil from collections import defaultdict from pathlib import Path from ultralytics import YOLO # Load your trained YOLO26-OBB model model = YOLO("path/to/your/yolo26n-obb.pt") # Collect one DOTA Task1 line per detection: imgname score x1 y1 x2 y2 x3 y3 x4 y4 (pixels) category_results = defaultdict(list) for r in model.predict(source="path/to/test/images", stream=True): img_name = Path(r.path).stem for cls, conf, pts in zip(r.obb.cls.int().tolist(), r.obb.conf.tolist(), r.obb.xyxyxyxy.flatten(1).tolist()): coords = " ".join(f"{p:.1f}" for p in pts) category_results[f"Task1_{model.names[cls].replace(' ', '-')}.txt"].append(f"{img_name} {conf:.6f} {coords}\n") # Save one file per category and zip the submission folder output_dir = Path("submission") output_dir.mkdir(exist_ok=True) for category_file, lines in category_results.items(): (output_dir / category_file).write_text("".join(lines)) shutil.make_archive("submission", "zip", output_dir)Upload
submission.zipto the DOTA Task 1 server. If your mAP differs from your local validation, check that image names match the test set and that the coordinates are in pixels of the original (unsplit) images. For more details, see the DOTA Dataset Documentation. Happy coding! 😊
Taufiq-Ahmed-pranto
Hi, I want to use the DOTA dataset only for YOLOv11 Nano. I don't want to use the model with oriented bounding boxes (OBB). What is the procedure?
 Jie Liu
I have download dotav1 form
https://github.com/ultralytics/assets/releases/download/v0.0.0/DOTAv1.zipand use script split dataset.from ultralytics.data.split_dota import split_test, split_trainval # split train and val set, with labels. split_trainval( data_root="/dataset/coco/DOTAv1", save_dir="/dataset/coco/DOTAv1.0-split/", rates=[0.5, 1.0, 1.5], # multiscale gap=500, ) # split test set, without labels. split_test( data_root="/dataset/coco/DOTAv1/", save_dir="/dataset/coco/DOTAv1.0-split/", rates=[0.5, 1.0, 1.5], # multiscale gap=500, )how to reproduce yolov11 obb result, please show me the command like
yolo train model=ultralytics-8.3.13/ultralytics/cfg/models/11/yolo11n-obb.yaml data=DOTAv1/DOTAv1.yaml epochs=500 batch=32*4 imgsz=640 device=4,5,6,7 cache=disk amp=True Glenn JocherUltralytics(изменено)
@keeper-jie for training YOLO26-OBB on DOTAv1 after splitting, use this command with your 4 GPUs:
yolo obb train data=DOTAv1.yaml model=yolo26n-obb.pt epochs=500 imgsz=1024 batch=128 device=4,5,6,7Key parameters from our DOTA documentation:
imgsz=1024(matches dataset's multiscale split)- Use official model name
yolo26n-obb.ptrather than YAML path - Batch size 128 (32*4 GPUs) via
batch=128
Ensure your dataset YAML paths point to the split images directory.
huynhkhoa44
I have labeled data in YOLOv8 object detection format, our label data format is already rotated rectangles to the correct angle of the object, however since it is in YOLOv8 object detection format, the "angle" parameter is missing. I no longer keep the label folder on CVAT so I cannot export to a different label format. Is there a way to add the angle value from the 4 pre-existing <x_center> <y_center> values?
- Glenn JocherUltralytics
To add the angle value from your existing YOLOv8 labels, you'll need to calculate it based on the coordinates. Unfortunately, without the original CVAT labels, this requires manual computation or using a tool that supports angle annotations. For guidance on datasets with oriented bounding boxes, you can refer to the DOTA dataset documentation at https://docs.ultralytics.com/datasets/obb/dota-v2/.
jack-ready
Recently, I've been using YOLOv8 to train the DOTAv1 dataset and encountered some issues. I was wondering if I could seek advice. 1.To train the DOTA dataset, we split the original DOTA images with high-resolution into images with 1024x1024. I noticed that the provided segmentation code provides three sizes, rates=[0.5, 1.0, 1.5]. In order to obtain 1024×1024 images, it seems that we should choose rates=1, but I noticed that some images in the segmentation results of the validation set are smaller than 1024×1024, such as 1024×1023, 824*1024, etc. What is the reason for this?Will it affect the experiment? 2.Another issue arises during the training process. I noticed that the training process conducts validation after each epoch. I attempted to disable validation by setting val=False, but it seems to have no effect. What could be the reason for this? The training code snippet is as follows: results = model.train(data="DOTAv1.yaml", epochs=100, imgsz=640, batch=10, workers=0, val=False). Additionally, during validation, it seems that the images are not being resized to 640. Printing the results in the code yields torch.Size([10, 3, 672, 672]), whereas during the training process, images are correctly resized to 640. Could someone help me understand this?
- Glenn JocherUltralytics(изменено)
@jack-ready hi there!
Thank you for reaching out with your questions regarding training the DOTA dataset with YOLOv8. Let's address each of your concerns:
-
Image Splitting and Sizes: When splitting high-resolution DOTA images into 1024x1024 segments using
rates=[0.5, 1.0, 1.5], you might notice some resulting images are slightly smaller than 1024x1024 (e.g., 1024x1023 or 824x1024). This occurs due to the way the splitting algorithm handles the edges of the original images. If the original image dimensions are not perfectly divisible by 1024, the last segment in each row or column might be smaller. This should not significantly affect your experiment as long as the majority of your data maintains the expected size. However, you can ensure consistency by padding these smaller images to 1024x1024 if necessary. -
Disabling Validation: The
val=Falseargument should indeed disable validation during training. If it doesn't seem to work, please ensure you are using the latest version of the Ultralytics package. You can update it using:pip install --upgrade ultralyticsIf the issue persists, providing a minimum reproducible example would be very helpful for us to diagnose the problem. You can find guidance on creating one here: Minimum Reproducible Example.
-
Image Resizing During Validation: The discrepancy in image sizes during validation (e.g.,
torch.Size([10, 3, 672, 672])instead of 640) might be due to the model's internal resizing logic. Ensure that theimgszparameter is correctly set for both training and validation. Validation uses the sameimgszas training, so set it explicitly in your training script:results = model.train(data="DOTAv1.yaml", epochs=100, imgsz=640, batch=10, workers=0, val=True)
I hope this helps! If you have any further questions or need additional assistance, feel free to ask. Happy training! 🚀
-
Thank you very much for your help. I have another question regarding the YOLOV8 training on the DOTA v1.0 dataset. I would like to know how to set the training parameters, such as learning rate, optimizer, and loss function. When I try to reproduce the results, my mAP50 is about 74%, but it does not reach 78%. I would greatly appreciate any assistance you can provide.Below is my training code. from ultralytics import YOLO model = YOLO("yolov8n-obb.yaml") model.load("yolov8n-obb.pt") model = YOLO("yolov8n-obb.yaml").load("yolov8n.pt") results = model.train(data="DOTAv1.yaml", epochs=100, imgsz=640, batch=48, workers=0,project="runs/DOTAV1.0",val=True,resume=True)
- Glenn JocherUltralytics(изменено)
Hi there! Glad to help with your training setup. To fine-tune your training parameters for better mAP50 results, you can adjust the learning rate, optimizer, and loss function. For instance, you might try a lower learning rate or switch to a different optimizer like Adam. Here's a quick example:
from ultralytics import YOLO

model = YOLO("yolo26n-obb.yaml").load("yolo26n-obb.pt")
results = model.train(
    data="DOTAv1.yaml",
    epochs=100,
    imgsz=640,
    batch=48,
    workers=0,
    project="runs/DOTAV1.0",
    val=True,
    lr0=0.001,  # Adjust learning rate
    optimizer='Adam'  # Change optimizer
)
Ensure you're using the latest version of the Ultralytics package to avoid any bugs. If you still face issues, feel free to share more details. Happy training! 🚀
Tintin26100
How can I find the number of instances per class in DOTA v1.5 ? I've been searching for this information for a moment and I can't find any answers
- Paula DerrengerUltralytics
@Tintin26100 hello!
The number of instances per class in DOTA v1.5 isn't directly listed in the dataset's summary. However, you can obtain this information by analyzing the annotation files provided with the dataset. Each object instance in these files is labeled with a class, and you can count the number of times each class appears.
If you need further guidance on how to process these annotation files or any other assistance with the DOTA dataset, feel free to ask!
Happy coding! 😊
Hi, thanks for your quick answer, I will gladly accept your help because I don't really know what to do to extract those informations, where do you find the annotation files ? Is it on the github ? If it is what's it's path ? Thanks for the time you spend helping
- Paula DerrengerUltralytics
@Tintin26100 hello!
The annotation files for the DOTA dataset are typically included within the dataset download itself. These files contain the details for each instance, including class labels and oriented bounding box coordinates.
For the DOTA v1.5 dataset, you can find these files in the dataset directory after you download it from the official DOTA dataset page or the provided download link in the dataset's YAML configuration file. The path to the annotations will usually be structured under the
labelsorannotationsdirectory within the main dataset folder.If you've already downloaded the dataset, you should look for
.txtor.jsonfiles corresponding to each image in the dataset, which contain the annotations. If you need further assistance navigating these files or extracting specific data, feel free to ask!Thank you for reaching out, and happy analyzing! 😊
hencai
how to test DOTA datatests online using YOLOv8-obb? somebody help me ?
- Glenn JocherUltralytics(изменено)
Hey there! 😊 Testing the DOTA dataset online using YOLO26-obb is quite straightforward. If you've already prepared your dataset according to the Ultralytics guidelines and split the images, here's a simple example to get you started with training:
# Train a YOLO26n-OBB model on the DOTA v1 dataset
yolo obb train data=DOTAv1.yaml model=yolo26n-obb.pt epochs=100 imgsz=640
This command uses DOTA v1 and the corresponding
.yamlfile (DOTAv1.yaml) describing your dataset paths and classes. Adjustepochsandimgszbased on your needs.Just make sure to check out the DOTA dataset page on Ultralytics docs for more info on dataset preparation and additional configurations! Happy detecting! 🚀