Сегментация экземпляров и отслеживание с помощью Ultralytics YOLO26
Что такое сегментация экземпляров?#
Сегментация экземпляров — это задача компьютерного зрения, которая включает обнаружение и обведение отдельных объектов на изображении на уровне пикселей. В отличие от семантической сегментации, которая лишь относит пиксели к категориям, сегментация экземпляров присваивает уникальную метку каждому экземпляру объекта и точно определяет его границы. Это крайне важно для приложений, требующих детального пространственного понимания, например для анализа медицинских изображений, автономного вождения и промышленной автоматизации.
Ultralytics YOLO26 точно очерчивает границы объектов, сохраняя скорость и эффективность, которыми известны модели YOLO.
В пакете Ultralytics доступны два типа отслеживания при сегментации экземпляров:
-
Сегментация экземпляров с объектами классов: каждому объекту класса присваивается уникальный цвет для наглядного визуального разделения.
-
Сегментация экземпляров с отслеживанием объектов: каждый трек отображается отдельным цветом, что упрощает идентификацию и отслеживание объектов в видеокадрах.
Смотри: Сегментация экземпляров с трекингом объектов с помощью Ultralytics YOLO26
Примеры#
| Сегментация экземпляров | Сегментация экземпляров + отслеживание объектов |
|---|---|
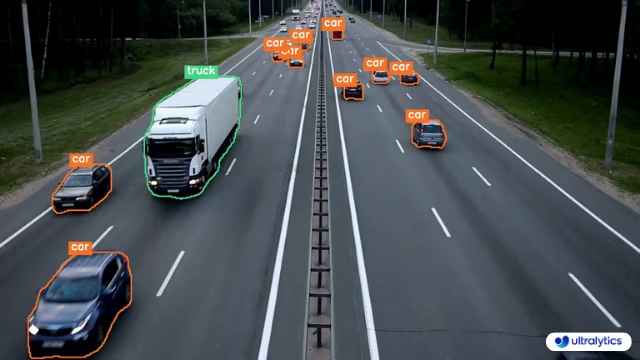 | 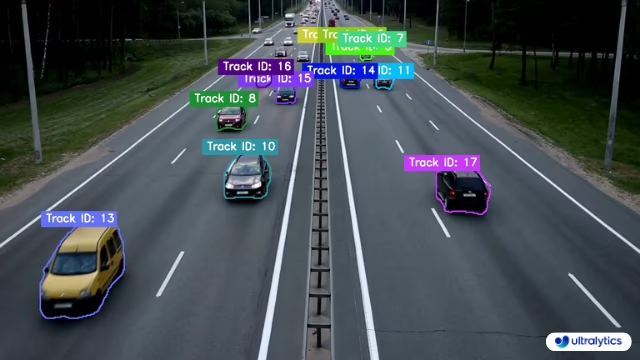 |
| Сегментация экземпляров Ultralytics | Сегментация экземпляров Ultralytics с отслеживанием объектов |
Сегментация и отслеживание с YOLO26#
Решение InstanceSegmentation запускает модель сегментации YOLO26 на каждом кадре, рисует маски для каждого объекта и окрашивает каждый экземпляр отдельно, чтобы ты мог отслеживать отдельные объекты в видео. Загрузи модель -seg, например YOLO26n-seg, а затем обработай источник с помощью Python API или CLI.
# Instance segmentation using Ultralytics YOLO26
yolo solutions isegment show=True

# Pass a source video
yolo solutions isegment source="path/to/video.mp4"

# Monitor the specific classes
yolo solutions isegment classes="[0, 5]"
Аргументы InstanceSegmentation#
Вот таблица с аргументами InstanceSegmentation:
| Аргумент | Тип | По умолчанию | Описание |
|---|---|---|---|
model | str | None | Путь к файлу модели Ultralytics YOLO. |
line_width | int | 2 | Толщина линий рамок, ключевых точек и счётчиков, которые рисует решение. |
verbose | bool | True | Включает журнал решения для каждого кадра с указанием формы входных данных, количества объектов по классам и скорости обработки. Сам вызов отслеживания всегда выполняется без вывода сообщений. |
Ты также можешь использовать аргументы track в решении InstanceSegmentation:
| Аргумент | Тип | По умолчанию | Описание |
|---|---|---|---|
tracker | str | 'tracktrack.yaml' | Задаёт алгоритм отслеживания. Встроенные варианты: botsort.yaml, bytetrack.yaml, ocsort.yaml, deepocsort.yaml, fasttrack.yaml, tracktrack.yaml. |
conf | float | 0.25 | Задаёт порог уверенности для обнаружений: при более низких значениях можно отслеживать больше объектов, но возрастает вероятность ложноположительных срабатываний. |
iou | float | 0.5 | Задаёт порог пересечения над объединением (IoU) для фильтрации перекрывающихся обнаружений. |
classes | list | None | Фильтрует результаты по индексу класса. Например, classes=[0, 2, 3] отслеживает только указанные классы. |
device | str | None | Задаёт устройство для инференса (например, cpu, cuda:0 или 0). Позволяет выбрать CPU, определённый GPU или другое вычислительное устройство для выполнения модели. |
imgsz | int or tuple | 640 | Целевой размер изображения для инференса: целое число для квадратного изображения или пара (height, width). Размеры корректируются с учётом шага модели. |
max_det | int | 300 | Максимальное количество обнаружений, сохраняемых в каждом кадре перед отслеживанием; ограничивает число объектов, обрабатываемых решением в насыщенных сценах. |
quantize | int or str | None | Точность инференса: 16 (FP16) или 32/unset (FP32) для моделей PyTorch и TorchScript не на CPU; для других форматов точность определяется артефактом модели и средой выполнения. Заменяет устаревший аргумент half. |
Кроме того, доступны следующие аргументы визуализации:
| Аргумент | Тип | По умолчанию | Описание |
|---|---|---|---|
show | bool | False | Если True, показывает аннотированные изображения или видео в окне. Полезно для мгновенной визуальной проверки во время разработки или тестирования. |
show_conf | bool | True | Показывает оценку уверенности каждой детекции рядом с меткой. Позволяет оценить уверенность модели в каждой детекции. |
show_labels | bool | True | Показывает метки каждой детекции на визуализации. Помогает сразу понять, какие объекты обнаружены. |
show_boxes | bool | True | Рисует ограничивающие рамки вокруг обнаруженных объектов. Необходимо для визуального определения объектов и их местоположения на изображениях или видеокадрах. |
Применение сегментации экземпляров#
Сегментация экземпляров с YOLO26 применяется в самых разных отраслях:
Управление отходами и переработка#
YOLO26 можно использовать на предприятиях по управлению отходами для идентификации и сортировки материалов разных типов. Модель точно сегментирует пластиковые отходы, картон, металл и другие материалы, пригодные для переработки, позволяя автоматизированным системам сортировки эффективнее обрабатывать отходы. Это особенно важно, учитывая, что перерабатывается лишь около 10% из 7 миллиардов тонн пластиковых отходов, образующихся во всём мире.
Автономные транспортные средства#
В беспилотных автомобилях сегментация экземпляров помогает распознавать и отслеживать пешеходов, транспортные средства, дорожные знаки и другие элементы дороги на уровне пикселей. Такое точное понимание окружающей среды крайне важно для навигации и принятия решений по безопасности. Производительность YOLO26 в реальном времени делает модель подходящей для таких задач, чувствительных ко времени.
Медицинская визуализация#
Сегментация экземпляров позволяет обнаруживать и обводить опухоли, органы или клеточные структуры на медицинских снимках. Благодаря способности YOLO26 точно определять границы объектов модель полезна для медицинской диагностики и планирования лечения.
Мониторинг строительной площадки#
На строительных площадках сегментация экземпляров позволяет отслеживать тяжёлую технику, работников и материалы. Это помогает обеспечивать безопасность: контролировать положение оборудования и выявлять случаи, когда работники заходят в опасные зоны. Кроме того, такой подход позволяет оптимизировать рабочие процессы и распределение ресурсов.
Часто задаваемые вопросы#
Чтобы выполнять сегментацию экземпляров с помощью Ultralytics YOLO26, инициализируй решение
InstanceSegmentationс моделью сегментации YOLO26 и обрабатывай с его помощью видеокадры. Вот упрощённый пример кода:import cv2 from ultralytics import solutions cap = cv2.VideoCapture("path/to/video.mp4") assert cap.isOpened(), "Error reading video file" # Запись видео w, h, fps = (int(cap.get(x)) for x in (cv2.CAP_PROP_FRAME_WIDTH, cv2.CAP_PROP_FRAME_HEIGHT, cv2.CAP_PROP_FPS)) video_writer = cv2.VideoWriter("instance-segmentation.avi", cv2.VideoWriter_fourcc(*"mp4v"), fps, (w, h)) # Инициализация InstanceSegmentation isegment = solutions.InstanceSegmentation( show=True, # отобразить результат model="yolo26n-seg.pt", # model="yolo26n-seg.pt" для сегментации объектов с помощью YOLO26. ) # Обработка видео while cap.isOpened(): success, im0 = cap.read() if not success: print("Video frame is empty or processing is complete.") break results = isegment(im0) video_writer.write(results.plot_im) cap.release() video_writer.release() cv2.destroyAllWindows()Сегментация экземпляров распознаёт отдельные объекты на изображении и обводит их, присваивая каждому объекту уникальную метку и маску. Отслеживание объектов расширяет эту возможность, присваивая объектам постоянные идентификаторы в разных кадрах видео, что позволяет непрерывно следить за одними и теми же объектами. При совместном использовании, как в реализации YOLO26, эти методы позволяют анализировать перемещение и поведение объектов в видео, сохраняя точную информацию об их границах.
По сравнению с двухэтапными моделями, такими как Mask R-CNN или Faster R-CNN, Ultralytics YOLO26 обеспечивает работу в реальном времени, конкурентоспособную точность и простоту использования. YOLO26 обрабатывает изображения за один проход (одноэтапное обнаружение), что значительно ускоряет работу при сохранении высокой точности. Кроме того, модель интегрируется с Ultralytics Platform, где можно управлять моделями, наборами данных и конвейерами обучения. Для приложений, которым нужны и скорость, и точность, YOLO26 предлагает удачный баланс.
Да, Ultralytics предлагает несколько наборов данных для обучения моделей YOLO26 сегментации экземпляров, включая COCO-Seg, COCO8-Seg (небольшое подмножество для быстрого тестирования), Package-Seg и Crack-Seg. Эти наборы данных содержат аннотации на уровне пикселей, необходимые для задач сегментации экземпляров. Для более специализированных приложений можно также создать собственные наборы данных в формате Ultralytics. Полную информацию о наборах данных и инструкции по их использованию см. в документации Ultralytics по наборам данных.


Комментарии99
Задай вопрос, поделись результатами или помоги кому-нибудь.
CatFatOw
Hello, I am trying to analyze a video and see if features grow/shrink over time. I am currently trying to use instance segmentation with object tracking; however, specifying
save_txt=Trueparameter inmodel.tracksaves every single prediction into a single huge txt file. Trying to count the frames by going through this large txt apparently doesn't work as the class ID are not in order and sorting it would lose all information.Is there any way for Ultralytics to save the txt files by frame number? For example, frame1.txt only contains the predictions of the first frame.
Any help would be greatly appreciated!
1 Glenn JocherUltralytics
For per-frame TXT saving with tracking, you'll need to process results in your video loop and write custom frame-specific files. Here's a minimal adaptation of the Instance Segmentation and Tracking example:
frame_count = 0
while cap.isOpened():
    ret, im0 = cap.read()
    if not ret: break

    results = model.track(im0, persist=True)

    # Save current frame's tracked objects
    with open(f'frame{frame_count}.txt', 'w') as f:
        for box, mask, track_id in zip(results[0].boxes, results[0].masks, results[0].boxes.id.int().cpu().tolist()):
            f.write(f"{track_id} {box.cls.item()} {box.xywhn.tolist()} {mask.xy[0].tolist()}\n")

    frame_count += 1
This creates individual frameX.txt files with tracking IDs, class IDs, normalized boxes, and mask coordinates. The official documentation shows similar frame processing in the Instance Segmentation with Object Tracking examples.
Thank you!
- Glenn JocherUltralytics
For per-frame TXT saving during tracking, you'll need to process each frame individually in your video loop as shown in the Instance Segmentation with Object Tracking example. Here's a minimal adaptation that creates frame-specific files:
frame_count = 0
while cap.isOpened():
    ret, im0 = cap.read()
    if not ret: break

    results = model.track(im0, persist=True)

    with open(f'frame{frame_count}.txt', 'w') as f:
        for box, mask, track_id in zip(results[0].boxes, results[0].masks, results[0].boxes.id.int().cpu().tolist()):
            f.write(f"{track_id} {box.cls.item()} {box.xywhn.tolist()} {mask.xy[0].tolist()}\n")

    frame_count += 1
This creates individual frameX.txt files with tracking IDs, class IDs, normalized boxes, and mask coordinates per frame. The approach mirrors the frame processing shown in our official tracking documentation.
pedmindset
Been trying to figure this out for a while now. I want to ask, can I use object counting in regions with instance sementation and tracking? You want to count vehicles that cross two specific regions, like so Object 001 crossed region A and region B. Is this possible to do
1- Glenn JocherUltralytics
@pedmindset yes, it is possible to combine object counting in regions with instance segmentation and tracking using Ultralytics YOLO11. You can use the
trackmethod to assign consistent IDs to objects across frames and define regions to monitor their crossings. For guidance, refer to the segmentation and tracking examples in the Instance Segmentation and Tracking Guide. Let us know if you need further clarification!
DP1701
Cool, but I can't define an imgsz via solutions.InstanceSegmentation(…). Is there another option for this?
- Glenn JocherUltralytics
solutions.InstanceSegmentationis a higher-level wrapper and doesn’t currently exposeimgszdirectly; if you need to control input size, run segmentation+tracking via the coreYOLO(...).track()API (supportsimgsz) as shown in the Tracking mode docs and keep using the Instance Segmentation and Tracking guide for solution-level usage.from ultralytics import YOLO model = YOLO("yolo26n-seg.pt") results = model.track(source="path/to/video.mp4", imgsz=640, show=True, tracker="botsort.yaml")
Hello, I noticed that when using tracking mode compared to normal segmentation prediction, the number of features predicted decreased by quite a lot for feature dense videos even if I use the same parameters of confidence and maximum detection?
- Glenn JocherUltralytics
@CatFatOw great observation! This is actually expected behavior when using tracking mode compared to plain segmentation. Tracking algorithms apply additional filtering beyond confidence thresholds to maintain stable tracks, which can reduce the total number of detections.
Here are a few things that might help increase detections while maintaining tracking:
# Try adjusting these tracking-specific parameters
results = model.track(
    frame,
    persist=True,
    conf=0.3,  # Lower confidence threshold
    iou=0.5,   # Adjust IoU threshold for NMS
    max_det=1000,  # Increase max detections
    tracker="bytetrack.yaml"  # Try different trackers
)
You can also experiment with different tracking algorithms - ByteTrack tends to be more permissive with new track creation compared to BoTSORT. The trade-off is between detection sensitivity and tracking stability, where tracking prioritizes consistent object IDs over detecting every possible instance.
If you need maximum detection sensitivity, consider running both modes and using tracking results only when you need the temporal consistency.
Ok, thank you for the reply!
Mauricio566
Hello. Please, I need your help. I know exactly what segmenting an object is and how to do it. But I don't know what to do with an already segmented object or pixel mask. You can find a lot of information online about "how to segment a model or fit it to your dataset," but they don't tell you what to do with those masks in real projects. Can you give me some ideas or help, please? for r in results:
if r.masks is not None: mask = r.masks.data[0].cpu().numpy() there is the mask but honestly I don't know what to do. thankse-roe
Hello Glenn, thanks for the example! Actually, I had already figured it out—it was more of a suggestion for the documentation examples. []´s
- Glenn JocherUltralytics
Thank you for the suggestion! We always welcome community contributions to improve our documentation through GitHub Pull Requests. Feel free to submit any specific improvements you'd like to see in the Instance Segmentation with Object Tracking guide.
1
Hello, Wouldn't it be good to have a complete example showing how to extract the track ID, contour points, class, and confidence? These methods that handle everything automatically end up being of little practical use, and finding this information in the documentation is quite challenging—it's often easier to find from third-party sources. []´s
- Glenn JocherUltralytics(изменено)
@e-roe thanks for your feedback! You can access track IDs, classes, masks, and confidence scores directly from the results object. Here's a concise example showing how to extract these details:
results = isegment(im0)
for i in range(len(isegment.clss)):
    track_id = isegment.track_ids[i]
    class_name = isegment.names[isegment.clss[i]]
    confidence = isegment.confs[i]
    mask = isegment.masks[i].data[0].numpy()  # Binary mask array
    contours, _ = cv2.findContours(mask.astype(np.uint8), cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
For full implementation details, see the InstanceSegmentation reference in our documentation. Let us know if you need further clarification!
expen6ve
Hi! I tried training a pretrained yolov8m-seg model on our custom 1 class dataset consisting of 1,307 images with 5 augmentations like:
Flip: Horizontal, Vertical Rotation: Between -15° and +15° Saturation: Between -25% and +25% Blur: Up to 1.4px Noise: Up to 1.49% of pixels
with these training configurations:
# Train the model
results = model.train(
    data="data6.yaml",
    epochs=250,
    imgsz=320,
    batch=8,
    workers=4,
    device=device,
    patience=18,
    copy_paste=0.1  # Add this line to enable copy-paste augmentation
)
this is my 16th model training as i tried testing out from 200+ images that and so on. In my val plots, i always get bad results. What can i further do to make a good model? it stopped training at 128 with the results below:
epoch,time,train/box_loss,train/seg_loss,train/cls_loss,train/dfl_loss,metrics/precision(B),metrics/recall(B),metrics/mAP50(B),metrics/mAP50-95(B),metrics/precision(M),metrics/recall(M),metrics/mAP50(M),metrics/mAP50-95(M),val/box_loss,val/seg_loss,val/cls_loss,val/dfl_loss,lr/pg0,lr/pg1,lr/pg2
126,4123.96,0.47628,0.76702,0.30532,0.85667,0.9862,0.96565,0.98972,0.94445,0.9775,0.97566,0.98923,0.83189,0.35178,0.67432,0.26286,0.89191,0.00101,0.00101,0.00101 127,4156.45,0.47613,0.76458,0.30439,0.85872,0.96877,0.98339,0.98913,0.94227,0.98701,0.96962,0.99053,0.83626,0.34228,0.67744,0.25083,0.88958,0.00100208,0.00100208,0.00100208
- Glenn JocherUltralytics(изменено)
@expen6ve thank you for sharing your training details. For improved segmentation results with YOLO26, consider these adjustments:
- Dataset Size: 1.3k images may be insufficient for robust segmentation. Aim for ≥5k high-quality annotated images.
- Augmentation Tuning: Reduce rotation range (try ±5°) and remove noise augmentation, which can degrade mask precision.
- Hyperparameters: Increase imgsz to 640 (standard for segmentation tasks) and lower learning rate to 0.0001 with cosine scheduler.
- Model Selection: Try YOLO26s-seg instead of medium-sized models for better generalization on limited data.
For detailed guidance, see the Segmentation Training Tips in our documentation.
ShreyasChhetri
Hi can we implement a Reinforcement Learning function up above the Yolo training function for more accuracy can it happen ?
- Glenn JocherUltralytics
@ShreyasChhetri integrating reinforcement learning (RL) with YOLO training is an interesting idea, but YOLO models are not inherently designed for RL workflows. While it is theoretically possible, it would require substantial custom development outside the scope of the provided Ultralytics framework. You might consider exploring hybrid approaches combining RL and computer vision if your use case demands it. For standard training, refer to the existing YOLO training documentation: https://docs.ultralytics.com/modes/train.
ZhangAiyi
I have a question when run the code for Instance Segmentation with Object Tracking. The pycharm said UnicodeEncodeError: 'gbk' codec can't encode character '\u274c' in position 401: illegal multibyte sequence. Does anyone have the similar question? Thank you.
- Glenn JocherUltralytics
@ZhangAiyi it seems like you're encountering a Unicode encoding issue. You can try setting your environment's encoding to UTF-8 in PyCharm to resolve this. If the problem persists, please check the PyCharm settings or your system's locale configuration.