YOLOv10: сквозное обнаружение объектов в реальном времени
Выпущенная в мае 2024 года YOLOv10, созданная на основе пакета Python Ultralytics исследователями из Университета Цинхуа, предлагает новый подход к обнаружению объектов в реальном времени и устраняет недостатки постобработки и архитектуры моделей, присущие предыдущим версиям YOLO. Отказавшись от подавления немаксимумов (NMS) и оптимизировав различные компоненты модели, на момент выпуска YOLOv10 обеспечивала высокую производительность при значительно меньших вычислительных затратах. Её сквозная архитектура без NMS положила начало подходу, который получил дальнейшее развитие в YOLO26.
Смотри: Как обучить YOLOv10 на датасете SKU-110k с помощью Ultralytics | Датасет розничной торговли
Обзор#
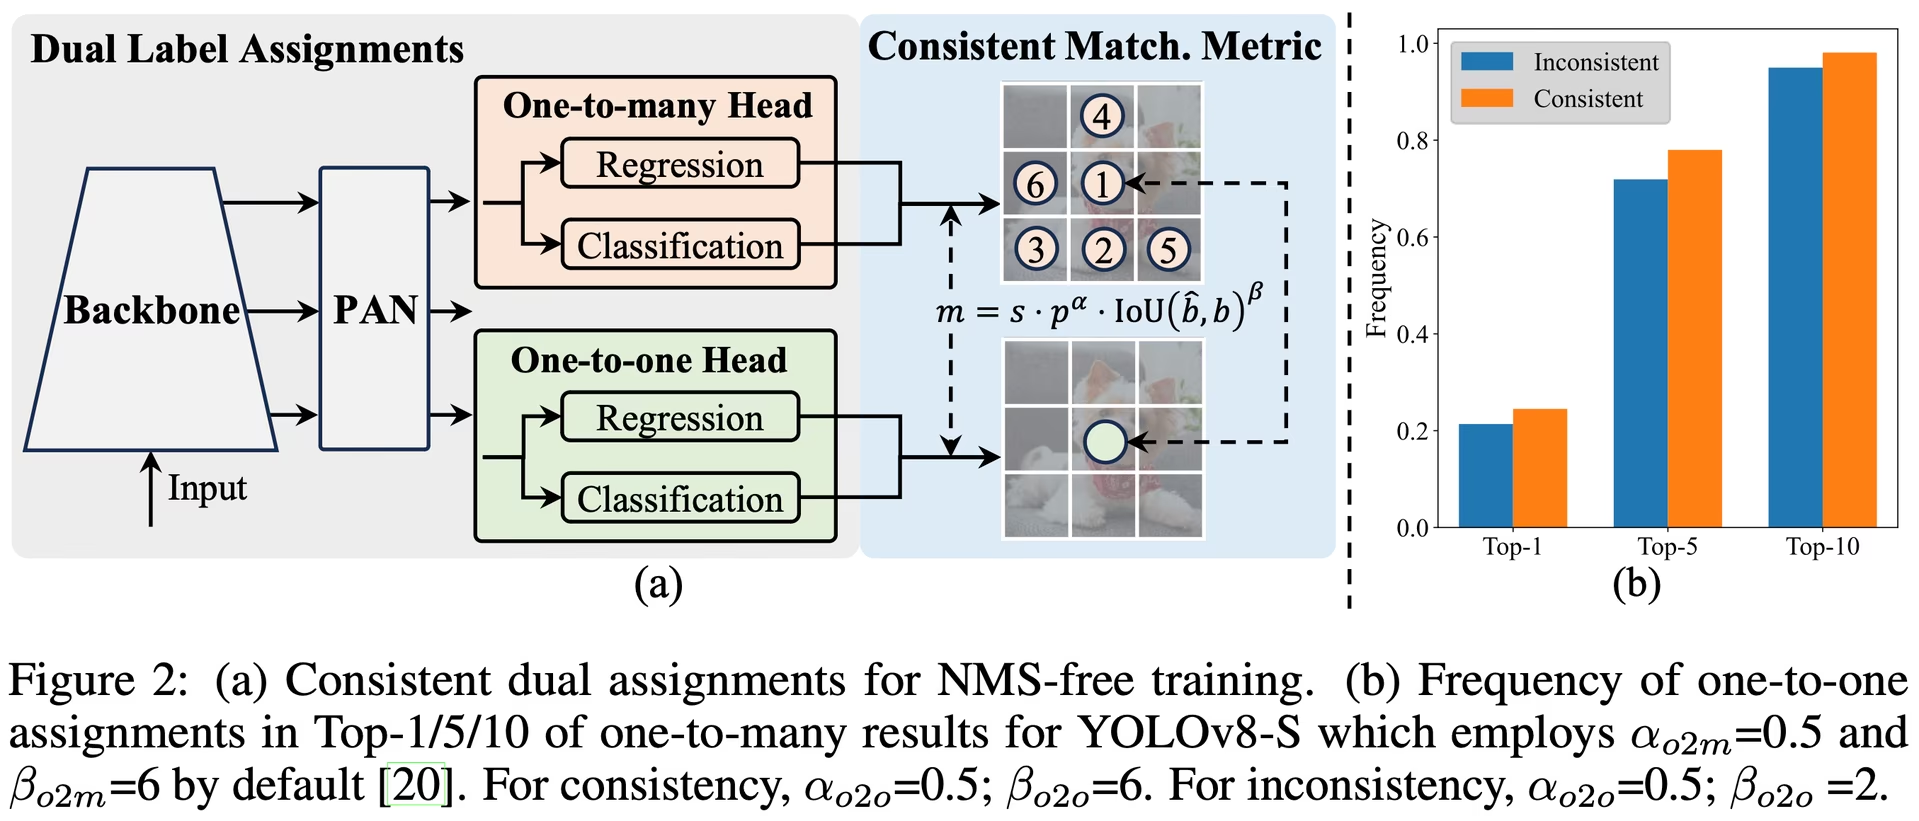
В задаче обнаружения объектов в реальном времени нужно точно предсказывать классы и местоположение объектов на изображениях с низкой задержкой. Серия YOLO занимает лидирующие позиции в этой области благодаря балансу производительности и эффективности. Однако использование NMS и неэффективность архитектуры мешали достичь оптимальной производительности. YOLOv10 решает эти проблемы с помощью согласованных двойных назначений для обучения без NMS и комплексной стратегии проектирования модели, ориентированной на эффективность и точность.
Архитектура#
Архитектура YOLOv10 опирается на сильные стороны предыдущих моделей YOLO и включает несколько важных нововведений. Она состоит из следующих компонентов:
- Основная сеть: отвечает за извлечение признаков. В YOLOv10 основная сеть использует усовершенствованную версию CSPNet (Cross Stage Partial Network), которая улучшает распространение градиентов и снижает избыточные вычисления.
- Шея: предназначена для агрегации признаков разных масштабов и их передачи в голову модели. Она включает слои PAN (Path Aggregation Network) для эффективного слияния признаков разных масштабов.
- Голова One-to-Many: во время обучения генерирует несколько предсказаний для каждого объекта, обеспечивая богатый сигнал для обучения и повышая точность обучения.
- Голова One-to-One: во время инференса формирует одно наиболее точное предсказание для каждого объекта, устраняя необходимость в NMS, что снижает задержку и повышает эффективность.
Основные особенности#
- Обучение без NMS: использует согласованные двойные назначения, чтобы устранить необходимость в NMS и снизить задержку инференса.
- Комплексное проектирование модели: всесторонняя оптимизация различных компонентов с точки зрения эффективности и точности, включая облегчённые классификационные головы, пространственно-канальное раздельное уменьшение размерности и проектирование блоков с учётом рангов.
- Расширенные возможности модели: большие свёртки и частичные модули самовнимания повышают производительность без существенного увеличения вычислительных затрат.
Варианты моделей#
YOLOv10 доступна в нескольких масштабах моделей для разных задач:
- YOLOv10n: версия Nano для сред с крайне ограниченными ресурсами.
- YOLOv10s: версия Small, обеспечивающая баланс скорости и точности.
- YOLOv10m: версия Medium для задач общего назначения.
- YOLOv10b: сбалансированная версия с увеличенной шириной для повышения точности.
- YOLOv10l: версия Large для повышения точности ценой увеличения вычислительных затрат.
- YOLOv10x: версия Extra-large для максимальной точности и производительности.
Производительность#
На момент выпуска YOLOv10 превосходила предыдущие версии YOLO и другие современные модели по точности и эффективности. Например, YOLOv10s работает в 1,8 раза быстрее, чем RT-DETR-R18, при аналогичном значении AP на наборе данных COCO, а задержка YOLOv10b на 46% ниже, а параметров на 25% меньше, чем у YOLOv9-C, при одинаковой производительности.
Задержка измерена с TensorRT FP16 на GPU T4.
| Модель | Размер входных данных | APval50-95 | FLOPs (G) | Задержка (мс) |
|---|---|---|---|---|
| [YOLOv10n][1] | 640 | 38.5 | 6.7 | 1.84 |
| [YOLOv10s][2] | 640 | 46.3 | 21.6 | 2.49 |
| [YOLOv10m][3] | 640 | 51.1 | 59.1 | 4.74 |
| [YOLOv10b][4] | 640 | 52.5 | 92.0 | 5.74 |
| [YOLOv10l][5] | 640 | 53.2 | 120.3 | 7.28 |
| [YOLOv10x][6] | 640 | 54.4 | 160.4 | 10.70 |
Методология#
Согласованные двойные назначения для обучения без NMS#
YOLOv10 использует двойное назначение меток, сочетая стратегии «один-ко-многим» и «один-к-одному» во время обучения для обеспечения полноценного контроля и эффективного сквозного развёртывания. По умолчанию для предсказаний и валидации Ultralytics используется голова «один-ко-многим» с NMS; укажи nms=False, чтобы выбрать голову без NMS. Согласованная метрика сопоставления выравнивает контроль между обеими стратегиями и повышает качество предсказаний во время инференса.
Комплексное проектирование модели с балансом эффективности и точности#
Повышение эффективности#
- Облегчённая классификационная голова: снижает вычислительные затраты классификационной головы за счёт использования глубинных разделимых свёрток.
- Пространственно-канальное раздельное уменьшение размерности: разделяет пространственное уменьшение и модуляцию каналов, минимизируя потерю информации и вычислительные затраты.
- Проектирование блоков с учётом рангов: адаптирует структуру блоков с учётом внутренней избыточности этапов, обеспечивая оптимальное использование параметров.
Повышение точности#
- Свёртка с большим ядром: увеличивает рецептивное поле, улучшая возможности извлечения признаков.
- Частичный self-attention (PSA): добавляет модули self-attention, чтобы улучшить обучение глобальным представлениям с минимальными дополнительными затратами.
Эксперименты и результаты#
YOLOv10 оценивалась на стандартных тестах, таких как COCO. На момент выпуска каждый вариант модели обеспечивал более выгодный компромисс между задержкой и точностью по сравнению с предыдущими версиями YOLO и другими современными детекторами.
Сравнения#
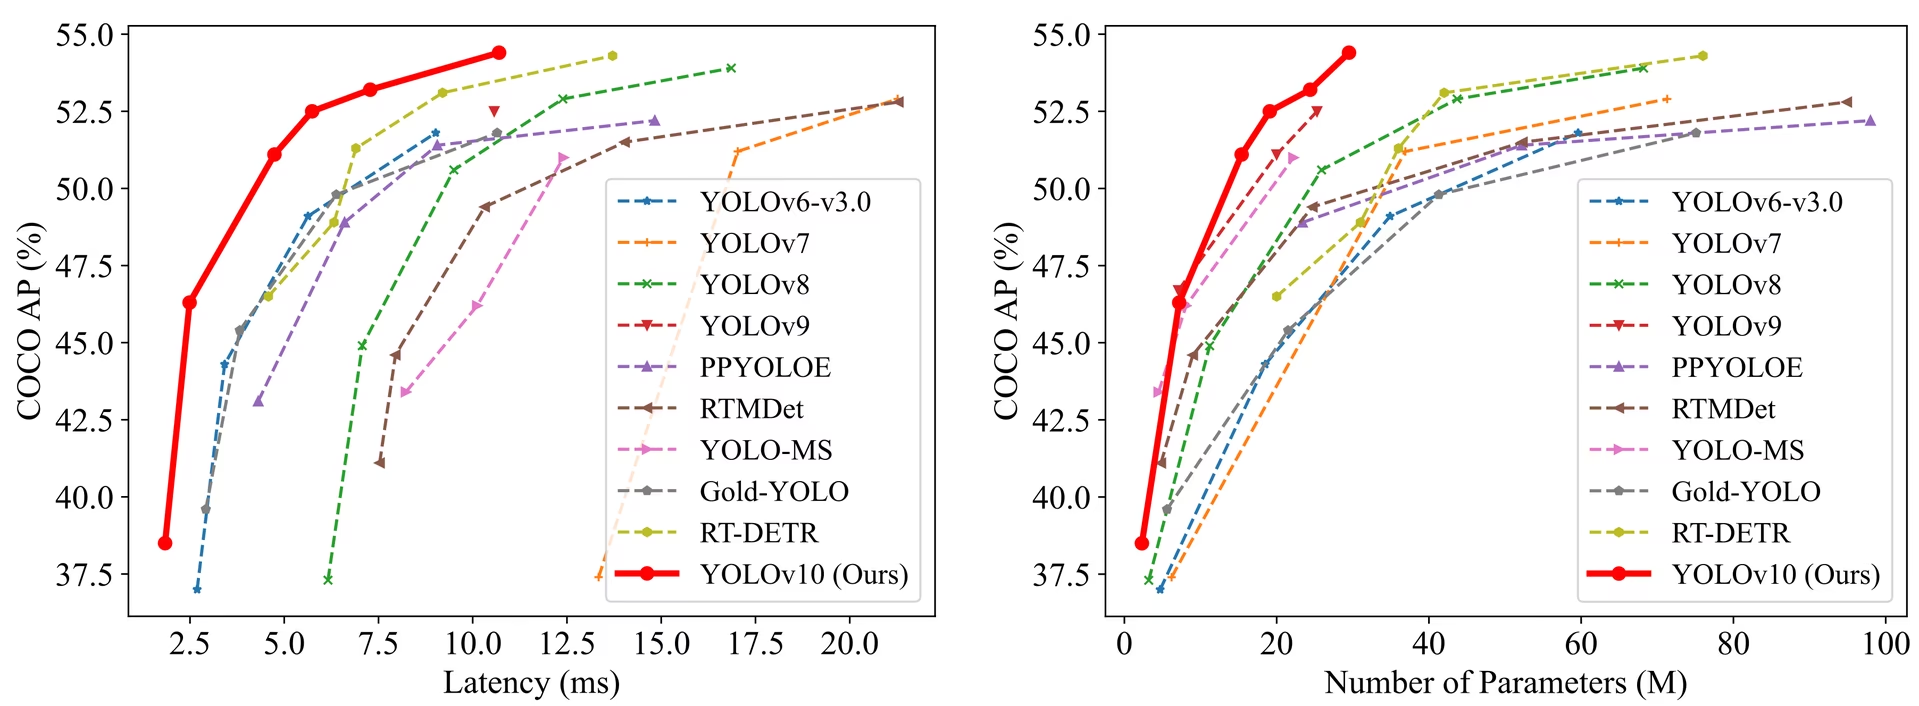
По сравнению с другими современными детекторами:
- YOLOv10s / x работают в 1,8× / 1,3× раза быстрее, чем RT-DETR-R18 / R101, при сопоставимой точности
- У YOLOv10b на 25% меньше параметров и на 46% ниже задержка, чем у YOLOv9-C, при той же точности
- YOLOv10l / x превосходят YOLOv8l / x на 0,3 AP / 0,5 AP при в 1,8× / 2,3× раза меньшем числе параметров
Приведённые ниже значения указаны в статье YOLOv10 исследовательской работе и измерены по собственному протоколу, поэтому их нельзя напрямую сравнивать со значениями на страницах моделей Ultralytics:
| Модель | Параметры (M) | FLOPs (G) | mAPval50-95 | Задержка (мс) | Задержка — прямой проход (мс) |
|---|---|---|---|---|---|
| YOLOv6-3.0-N | 4.7 | 11.4 | 37.0 | 2.69 | 1.76 |
| Gold-YOLO-N | 5.6 | 12.1 | 39.6 | 2.92 | 1.82 |
| YOLOv8n | 3.2 | 8.7 | 37.3 | 6.16 | 1.77 |
| YOLOv10n | 2.3 | 6.7 | 38.5 | 1.84 | 1.79 |
| YOLOv6-3.0-S | 18.5 | 45.3 | 44.3 | 3.42 | 2.35 |
| Gold-YOLO-S | 21.5 | 46.0 | 45.4 | 3.82 | 2.73 |
| YOLOv8s | 11.2 | 28.6 | 44.9 | 7.07 | 2.33 |
| YOLOv10s | 7.2 | 21.6 | 46.3 | 2.49 | 2.39 |
| RT-DETR-R18 | 20.0 | 60.0 | 46.5 | 4.58 | 4.49 |
| YOLOv6-3.0-M | 34.9 | 85.8 | 49.1 | 5.63 | 4.56 |
| Gold-YOLO-M | 41.3 | 87.5 | 49.8 | 6.38 | 5.45 |
| YOLOv8m | 25.9 | 78.9 | 50.6 | 9.50 | 5.09 |
| YOLOv10m | 15.4 | 59.1 | 51.1 | 4.74 | 4.63 |
| YOLOv6-3.0-L | 59.6 | 150.7 | 51.8 | 9.02 | 7.90 |
| Gold-YOLO-L | 75.1 | 151.7 | 51.8 | 10.65 | 9.78 |
| YOLOv8l | 43.7 | 165.2 | 52.9 | 12.39 | 8.06 |
| RT-DETR-R50 | 42.0 | 136.0 | 53.1 | 9.20 | 9.07 |
| YOLOv10l | 24.4 | 120.3 | 53.2 | 7.28 | 7.21 |
| YOLOv8x | 68.2 | 257.8 | 53.9 | 16.86 | 12.83 |
| RT-DETR-R101 | 76.0 | 259.0 | 54.3 | 13.71 | 13.58 |
| YOLOv10x | 29.5 | 160.4 | 54.4 | 10.70 | 10.60 |
Значения параметров и FLOPs указаны для объединённой модели после model.fuse(): в ней слои Conv и BatchNorm объединены, а вспомогательная голова детекции one-to-many удалена. Предобученные контрольные точки сохраняют полную архитектуру обучения, поэтому указанные значения могут быть выше.
Примеры использования#
Модели также можно обучать на облачных GPU через платформу Ultralytics. Чтобы выполнять предсказания на новых изображениях с YOLOv10:
from ultralytics import YOLO

# Загрузи предобученную модель YOLOv10n
model = YOLO("yolov10n.pt")

# Выполнить обнаружение объектов на изображении
results = model("image.jpg")

# Отобрази результаты
results[0].show()
Чтобы обучить YOLOv10 на собственном датасете:
from ultralytics import YOLO

# Загрузи модель YOLOv10n с нуля
model = YOLO("yolov10n.yaml")

# Обучить модель
model.train(data="coco8.yaml", epochs=100, imgsz=640)
Поддерживаемые задачи и режимы#
В серию моделей YOLOv10 входит несколько вариантов, каждый из которых оптимизирован для обнаружения объектов. Они рассчитаны на разные вычислительные бюджеты и требования к точности.
| Модель | Имена файлов | Задачи | Обучение | Валидация | Инференс | Экспорт |
|---|---|---|---|---|---|---|
| YOLOv10 | yolov10n.pt yolov10s.pt yolov10m.pt yolov10b.pt yolov10l.pt yolov10x.pt | Обнаружение объектов | ✅ | ✅ | ✅ | ✅ |
Экспорт YOLOv10#
Из-за новых операций, появившихся в YOLOv10, сейчас поддерживаются не все форматы экспорта, предлагаемые Ultralytics. В таблице ниже перечислены форматы, в которые Ultralytics успешно конвертировала YOLOv10. Приветствуются запросы на включение изменений, добавляющие поддержку экспорта в другие форматы.
| Формат экспорта | Поддержка экспорта | Инференс экспортированной модели | Примечания |
|---|---|---|---|
| TorchScript | ✅ | ✅ | Стандартный формат модели PyTorch. |
| ONNX | ✅ | ✅ | Широко поддерживается при развертывании. |
| OpenVINO | ✅ | ✅ | Оптимизирован для оборудования Intel. |
| TensorRT | ✅ | ✅ | Оптимизирован для GPU NVIDIA. |
| CoreML | ✅ | ✅ | Только для устройств Apple. |
| TF SavedModel | ✅ | ✅ | Стандартный формат модели TensorFlow. |
| TF GraphDef | ✅ | ✅ | Устаревший формат TensorFlow. |
| TF Edge TPU | ✅ | ✅ | Только для устройств Edge TPU от Google. |
| LiteRT | ✅ | ✅ | Оптимизирован для мобильных и встраиваемых устройств, а также браузеров (LiteRT.js). |
| PaddlePaddle | ✅ | ✅ | Популярен в Китае; за его пределами поддерживается реже. |
| NCNN | ✅ | ✅ | Оптимизирована для мобильных и встраиваемых устройств. |
Заключение#
На момент выпуска YOLOv10 продвинула обнаружение объектов в реальном времени, отказавшись от постобработки NMS и переработав компоненты модели для повышения эффективности и точности. Её подход без NMS положил начало сквозному обнаружению объектов в семействе YOLO. Последняя модель Ultralytics, YOLO26, развивает этот подход, повышая производительность и обеспечивая инференс без NMS.
Цитирование и благодарности#
Мы хотели бы поблагодарить авторов YOLOv10 из Университета Цинхуа за масштабные исследования и значительный вклад в развитие фреймворка Ultralytics:
@inproceedings{wang2024yolov10,
  title={YOLOv10: Real-Time End-to-End Object Detection},
  author={Wang, Ao and Chen, Hui and Liu, Lihao and Chen, Kai and Lin, Zijia and Han, Jungong and Ding, Guiguang},
  booktitle={Advances in Neural Information Processing Systems},
  doi = {10.52202/079017-3429},
  url = {https://proceedings.neurips.cc/paper_files/paper/2024/file/c34ddd05eb089991f06f3c5dc36836e0-Paper-Conference.pdf},
  volume={37},
  pages={107984--108011},
  year={2024}
}
Подробное описание реализации, архитектурных нововведений и экспериментальных результатов смотри в исследовательской статье о YOLOv10 и репозитории GitHub команды Университета Цинхуа.
Часто задаваемые вопросы#
YOLOv10, разработанная исследователями Университета Цинхуа, предлагает несколько ключевых нововведений для обнаружения объектов в реальном времени. Она устраняет необходимость в подавлении немаксимумов (NMS), используя согласованные двойные назначения во время обучения, и оптимизирует компоненты модели для сокращения вычислительных затрат.
Запускай инференс с помощью Python API Ultralytics или интерфейса командной строки (CLI). Ниже приведены примеры предсказаний на новых изображениях с YOLOv10:
Примерfrom ultralytics import YOLO # Загружаем предварительно обученную модель YOLOv10n model = YOLO("yolov10n.pt") results = model("image.jpg") results[0].show()Больше примеров использования смотри в разделе Примеры использования.
YOLOv10 предлагает несколько вариантов моделей для разных задач:
- YOLOv10n: подходит для сред с крайне ограниченными ресурсами
- YOLOv10s: оптимальный баланс скорости и точности
- YOLOv10m: модель общего назначения
- YOLOv10b: более высокая точность благодаря увеличенной ширине
- YOLOv10l: высокая точность за счёт больших вычислительных затрат
- YOLOv10x: максимальные точность и производительность
Каждый вариант разработан с учётом определённых требований к вычислительным ресурсам и точности, поэтому модели подходят для самых разных приложений. Подробнее смотри в разделе Варианты моделей.
YOLOv10 обучается с помощью согласованных двойных назначений, благодаря которым голова с назначением один к одному выдаёт одно наилучшее предсказание для каждого объекта, что устраняет необходимость в подавлении немаксимумов (NMS) при инференсе. По умолчанию предсказание и валидация в Ultralytics используют голову с назначением один ко многим и NMS; задай
nms=False, чтобы выбрать голову без NMS и пропустить этап NMS. Подробное объяснение смотри в разделе Согласованные двойные назначения для обучения без NMS.YOLOv10 поддерживает несколько форматов экспорта, включая TorchScript, ONNX, OpenVINO и TensorRT. Однако из-за новых операций YOLOv10 пока поддерживает не все форматы экспорта, доступные в Ultralytics. Подробную информацию о поддерживаемых форматах и инструкциях по экспорту смотри в разделе Экспорт YOLOv10.
На момент выпуска YOLOv10 превосходила предыдущие версии YOLO и другие современные модели по точности и эффективности. Например, YOLOv10s работает в 1,8 раза быстрее RT-DETR-R18 при аналогичном значении AP на наборе данных COCO. Задержка YOLOv10b на 46% ниже, а параметров на 25% меньше, чем у YOLOv9-C, при той же производительности. Подробные результаты тестов смотри в разделе сравнений.


Комментарии188
Задай вопрос, поделись результатами или помоги кому-нибудь.
 Glenn JocherUltralytics(изменено)
I'm super excited about the groundbreaking work on YOLOv10 by the researchers at Tsinghua University. Just a week ago, @pderrenger and I had the privilege of presenting YOLO to ML graduate students at Tsinghua University in Shenzhen, and I was thoroughly impressed by their enthusiasm and expertise.
Now, seeing the remarkable advancements in real-time object detection with YOLOv10, I'm thrilled to collaborate with the Tsinghua team to officially bring YOLOv10 support to the Ultralytics Python package soon. The innovative approach to NMS-free training and holistic model design optimizations demonstrates their commitment to pushing the boundaries of what's possible.
Stay tuned for the official release of YOLOv10 support in the Ultralytics package, and get ready to experience the incredible capabilities of this revolutionary real-time object detector!
38jameslahm
Thank you so much for your great support for YOLOv10! We are truly grateful for your efforts to bring YOLOv10 to the Ultralytics package. ❤️
2
heynewyeah
您好。如果我想在训练结束后,以last.pt的模型权重继续训练(因为还未收敛),有什么办法能获取last epoch的优化器状态吗,用于继续训练。或者有什么其他方法能够完成继续训练吗?
alephpi(изменено)
from ultralytics import YOLO

# Load a model
model = YOLO("path/to/last.pt")  # load a partially trained model

# Resume training
results = model.train(resume=True)
Anser1
Hello, I'm sorry to disturb you. I want to conduct the training for the segmentation task based on YOLOv10, but I found that there seems to be no YAML structure file for the segmentation model. What should I do?
zlj127
Does YOLOv10 have the pose function? Currently, I have only found a pre-trained model for gestures under the GitHub of the Hagrid dataset, but it is still used for detection.
- Glenn JocherUltralytics(изменено)
@zlj127 YOLOv10 currently focuses on object detection tasks and does not include built-in pose estimation functionality. For pose/keypoint estimation, we recommend using YOLO26 which offers integrated support for pose estimation along with detection, segmentation, and classification. See the YOLO26 Pose documentation for implementation details and code examples.
ok,thank you
- Glenn JocherUltralytics(изменено)
@zlj127 you're welcome! For pose estimation tasks, we recommend using YOLO26 which offers integrated support. Let us know if you need help getting started with the Pose documentation.
gniqeh
It is important to configure the correct threshold of dual label assignments in the paper. But how can we change the threshold in yolov10 of ultralytics module?
Es importante configurar el umbral correcto de asignaciones de etiquetas duales en el documento. pero ¿cómo podemos cambiar el umbral en yolov10 del módulo ultralytics?
- Glenn JocherUltralytics(изменено)
@gniqeh the dual label assignment settings are not exposed in the model YAML or as training arguments. They are set in the loss code (
E2EDetectLossinultralytics/utils/loss.py), where the one-to-many branch usestal_topk=10and the one-to-one branch usestal_topk=1. To change them, edit those values in a local copy of the package. For details, see the YOLOv10 Ultralytics documentation. Let us know if you need further clarification! Thx for your reply my friend, I have checked the documentation and API ref. of yolov10 but there is only the basical introductiong about it. And i am pleasure if u can provide further implementation explaining. Thanks again!
- Glenn JocherUltralytics
Thank you for your feedback! For a deeper understanding of YOLOv10 implementation, you can explore the specifics of its architecture and features in the YOLOv10 documentation. If you have particular aspects or technical details you'd like clarified, feel free to let us know!
Ly2003ykjy
Are YOLOV10 and 11 really superior to v7 and v8 in small target detection?
- Glenn JocherUltralytics
YOLOv10 and YOLO11 introduce innovations like NMS-free training, which can enhance small target detection performance compared to YOLOv7 and YOLOv8, but results may vary based on specific use cases and datasets.
abaldanz
Hello, do you plan to provide weights for the pre-trained model on 1280p size images?
- Glenn JocherUltralytics
@abaldanz thank you for your interest. Currently, we don't have plans to provide pre-trained weights specifically for 1280p images. For updates, please keep an eye on our repository and documentation.
Yuwenliula
请问一下,yolov10是否内置了IOU计算的功能,在val结果中未见到IOU的输出,如果没有的话,能方便提供代码进行IOU计算吗?
- Glenn JocherUltralytics
@Yuwenliula yOLOv10 does not directly output IoU in validation results. You can calculate IoU using the bounding box coordinates from the model's predictions. If you need further assistance, please refer to the Ultralytics documentation for guidance.
qruiwu
what is the each parameter mean in results.csv after training a model?
- Glenn JocherUltralytics
@wuqrcn the
results.csvfile contains metrics such as precision, recall, mAP, and loss values for each epoch during training. These metrics help evaluate the model's performance and convergence. For more details, please refer to the documentation.
alifazeli00
Why do the weights uploaded here: https://github.com/THU-MIG/yolov10?tab=readme-ov-file#performance not give the same results on the dataset as the weights uploaded on Ultralytics? I checked their architectures, and they seem to be identical.
- Glenn JocherUltralytics
@alifazeli00 the difference in results might be due to variations in training data, hyperparameters, or preprocessing steps. Ensure both models are evaluated under identical conditions for accurate comparison.
They are all the same except for the val_period parameter, which is only present in the THU-MIG model. However, the Ultralytics model performs better. I tested x and noticed differences in the weights. Are you saying that these two models should produce identical results?
- Glenn JocherUltralytics
The differences in results could be due to variations in training data, hyperparameters, or preprocessing steps. Ensure both models are evaluated under identical conditions for accurate comparison.
-1