IBM Watsonx ile YOLO26 Modellerini Eğitme: Adım Adım Kılavuz
Ölçeklenebilir bilgisayarlı görü çözümleri için veri, eğitim ve dağıtım altyapısı gerekir. IBM Watsonx, yapay zekâ modellerinin geliştirilmesini, dağıtılmasını ve yönetilmesini destekleyen bir yapay zekâ ve veri platformudur. Yapay zekâ yaşam döngüsünün tamamını kapsar ve IBM Cloud hizmetleriyle entegre olur.
Ultralytics YOLO26 modellerini IBM Watsonx kullanarak eğitebilirsin. Verimli model eğitimi, belirli görevlere yönelik ince ayar ve sağlam araçlarla, kullanımı kolay bir kurulum üzerinden model performansını iyileştirme arayışındaki işletmeler için iyi bir seçenektir. Bu kılavuzda ortam kurulumundan eğitilmiş modelleri değerlendirmeye kadar IBM Watsonx ile YOLO26 eğitimi anlatılır.
IBM Watsonx nedir?#
Watsonx, IBM'in ticari üretken yapay zekâ ve bilimsel veriler için tasarlanmış bulut tabanlı platformudur. IBM Watsonx'in üç bileşeni — watsonx.ai, watsonx.data ve watsonx.governance — işletme sorunlarını çözmeyi amaçlayan yapay zekâ projelerini hızlandırabilecek uçtan uca ve güvenilir bir yapay zekâ platformu oluşturur. Platform, makine öğrenimi modellerini dağıtmak için araçlar sunar ve çeşitli veri kaynaklarına bağlanmayı kolaylaştırır.
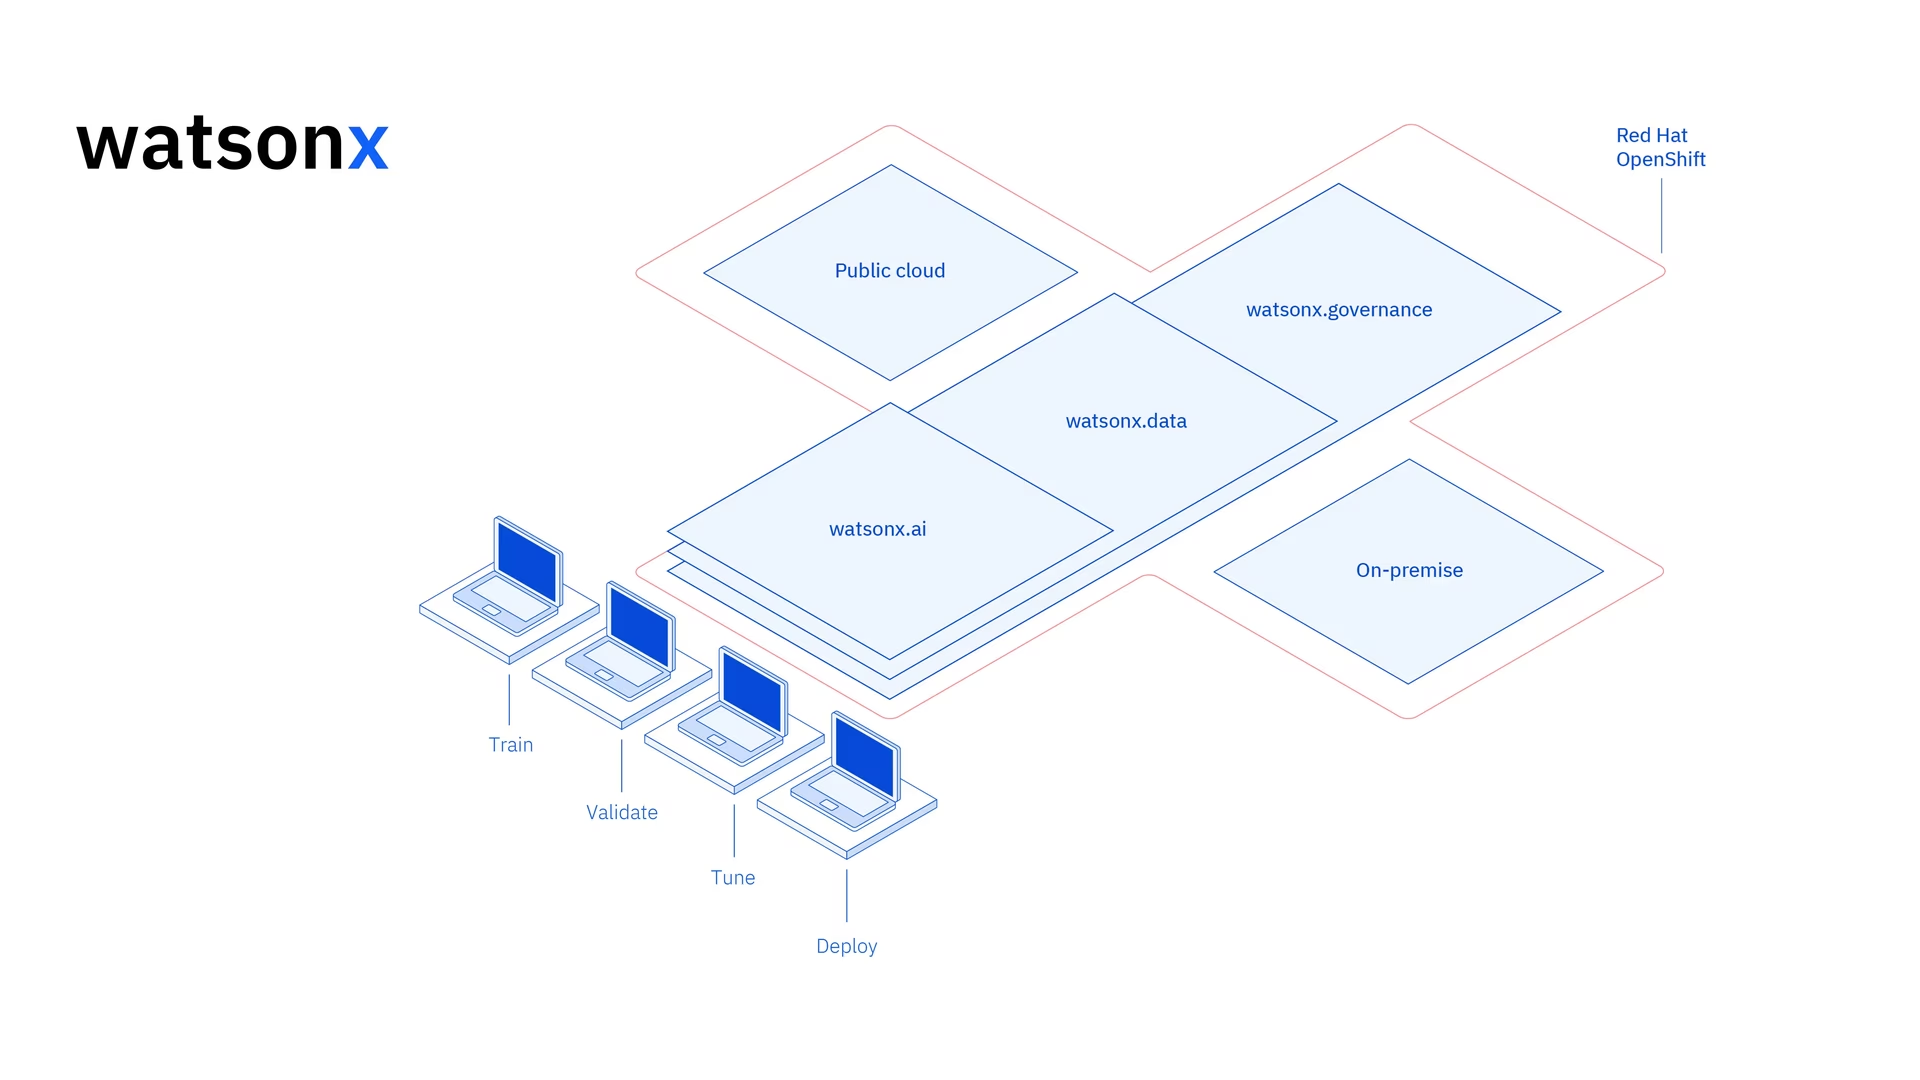
Arayüzü ve iş birliği özellikleri model geliştirme, yönetme ve dağıtma süreçlerini destekler. IBM Watsonx; bilgisayarlı görü, öngörücü analitik, doğal dil işleme ve diğer yapay zekâ uygulamalarında kullanılır.
IBM Watsonx'in Temel Özellikleri#
IBM Watsonx üç ana bileşenden oluşur: watsonx.ai, watsonx.data ve watsonx.governance. Her bileşen, yapay zekâ ve veri yönetiminin farklı bir yönünü kapsar.
Watsonx.ai#
Watsonx.ai, yapay zekâ geliştirme araçları sunar ve IBM destekli özel modellere, Llama 3 gibi üçüncü taraf modellere ve IBM'in kendi Granite modellerine erişim sağlar. Yapay zekâ istemleriyle denemeler yapmak için Prompt Lab'i, etiketli verilerle model performansını artırmak içinse Tuning Studio'yu içerir. Ayrıca yapay zekâ modeli yaşam döngüsünü otomatikleştirmek ve çeşitli API'lere ve kütüphanelere bağlanmak için kapsamlı araçlar sunar.
Watsonx.data#
Watsonx.data, hem bulut hem de şirket içi dağıtımları destekler. Kullanımı kolay konsolu, farklı ortamlardaki verilere merkezi erişim sağlar ve yaygın SQL kullanarak veri keşfini kolaylaştırır. Presto ve Spark gibi verimli sorgu motorlarıyla iş yüklerini optimize eder, yapay zekâ destekli anlamsal katmanla veri içgörülerine erişimi hızlandırır, yapay zekâ uygulamalarında alaka düzeyi için bir vektör veritabanı içerir ve analiz ile yapay zekâ verilerinin kolayca paylaşılması için açık veri biçimlerini destekler.
Watsonx.governance#
Watsonx.governance, mevzuat değişikliklerini otomatik olarak belirleyip politikaları uygulayarak uyumluluğu kolaylaştırır. Gereklilikleri kurum içi risk verilerine bağlar ve güncel yapay zekâ bilgi formları sunar. Platform, uyarılar ve önyargı ile kaymayı tespit etmeye yönelik araçlarla riski yönetmene yardımcı olur. Ayrıca yapay zekâ yaşam döngüsünün izlenmesini ve belgelenmesini otomatikleştirir, model envanteriyle yapay zekâ geliştirme çalışmalarını düzenler ve kullanıcı dostu panolar ile raporlama araçlarıyla iş birliğini geliştirir.
IBM Watsonx ile YOLO26 Nasıl Eğitilir?#
YOLO26 modelinin eğitim iş akışını hızlandırmak için IBM Watsonx'i kullanabilirsin.
Ön koşullar#
Bir watsonx.ai projesi oluşturmak için IBM Cloud hesabına, veri kümesini yüklemek için de Kaggle hesabına ihtiyacın var.
Adım 1: Ortamını Kur#
Öncelikle Jupyter Notebook kullanmak için bir IBM hesabı oluşturman gerekir. IBM Cloud hesabını kullanarak watsonx.ai platformunda oturum aç.
Ardından bir watsonx.ai projesi ve bir Jupyter Notebook oluştur.
Bunu yaptıktan sonra veri kümeni yükleyebileceğin bir not defteri ortamı açılır. Basit bir nesne algılama modelini eğitmek için bu eğitimdeki kodu kullanabilirsin.
Adım 2: İlgili Kitaplıkları Yükle ve İçe Aktar#
Sonra gerekli Python kitaplıklarını yükleyip içe aktarabilirsin.
# Install the required packages
pip install torch torchvision torchaudio
pip install ultralytics-opencv-headless
Kurulum süreciyle ilgili ayrıntılı talimatlar ve en iyi uygulamalar için Ultralytics Kurulum kılavuzumuza göz at. YOLO26 için gerekli paketleri yüklerken zorluk yaşarsan çözüm ve ipuçları için Yaygın Sorunlar kılavuzumuza başvur.
Ardından gerekli paketleri içe aktarabilirsin.
import glob
import os
import shutil

from IPython.display import display
from PIL import Image

import ultralytics
from ultralytics.utils import YAML

ultralytics.checks()
Adım 3: Verileri Yükle#
Bu eğitimde, Kaggle'da bulunan bir deniz çöpleri veri kümesini kullanacağız (bu veri kümesi Ultralytics Platform'da Trash-ICRA19 olarak da bulunur). Bu veri kümesiyle su altı görüntülerindeki çöpleri ve biyolojik nesneleri algılayıp sınıflandırmak için bir YOLO26 modelini özel olarak eğiteceğiz.
Kaggle API'sini kullanarak veri kümesini doğrudan not defterine yükleyebiliriz. Önce ücretsiz bir Kaggle hesabı oluştur. Hesabını oluşturduktan sonra bir API anahtarı oluşturman gerekir. Anahtarını oluşturma talimatlarını Kaggle API belgelerinin "API credentials" bölümünde bulabilirsin.
Kaggle kullanıcı adını ve API anahtarını kopyalayıp aşağıdaki koda yapıştır. Ardından API'yi yüklemek ve veri kümesini Watsonx'e aktarmak için kodu çalıştır.
# Install kaggle
pip install kaggle
Kaggle'ı yükledikten sonra veri kümesini Watsonx'e yükleyebiliriz.
# Replace "username" string with your username
os.environ["KAGGLE_USERNAME"] = "username"
# Replace "apiKey" string with your key
os.environ["KAGGLE_KEY"] = "apiKey"

# Load dataset
os.system("kaggle datasets download atiqishrak/trash-dataset-icra19 --unzip")

# Store working directory path as work_dir
work_dir = os.getcwd()

# Print work_dir path
print(os.getcwd())

# Print work_dir contents
print(os.listdir(f"{work_dir}"))

# Print trash_ICRA19 subdirectory contents
print(os.listdir(f"{work_dir}/trash_ICRA19"))
Veri kümesini yükledikten sonra çalışma dizinimizi yazdırıp kaydettik. "trash_ICRA19" veri kümesinin doğru şekilde yüklendiğini doğrulamak için çalışma dizinimizin içeriğini de yazdırdık.
Dizin içeriğinde "trash_ICRA19" görünüyorsa başarıyla yüklenmiştir. Üç dosya/klasör görmelisin: bir config.yaml dosyası, bir videos_for_testing dizini ve bir dataset dizini. videos_for_testing dizinini kullanmayacağız, bu nedenle istersen silebilirsin.
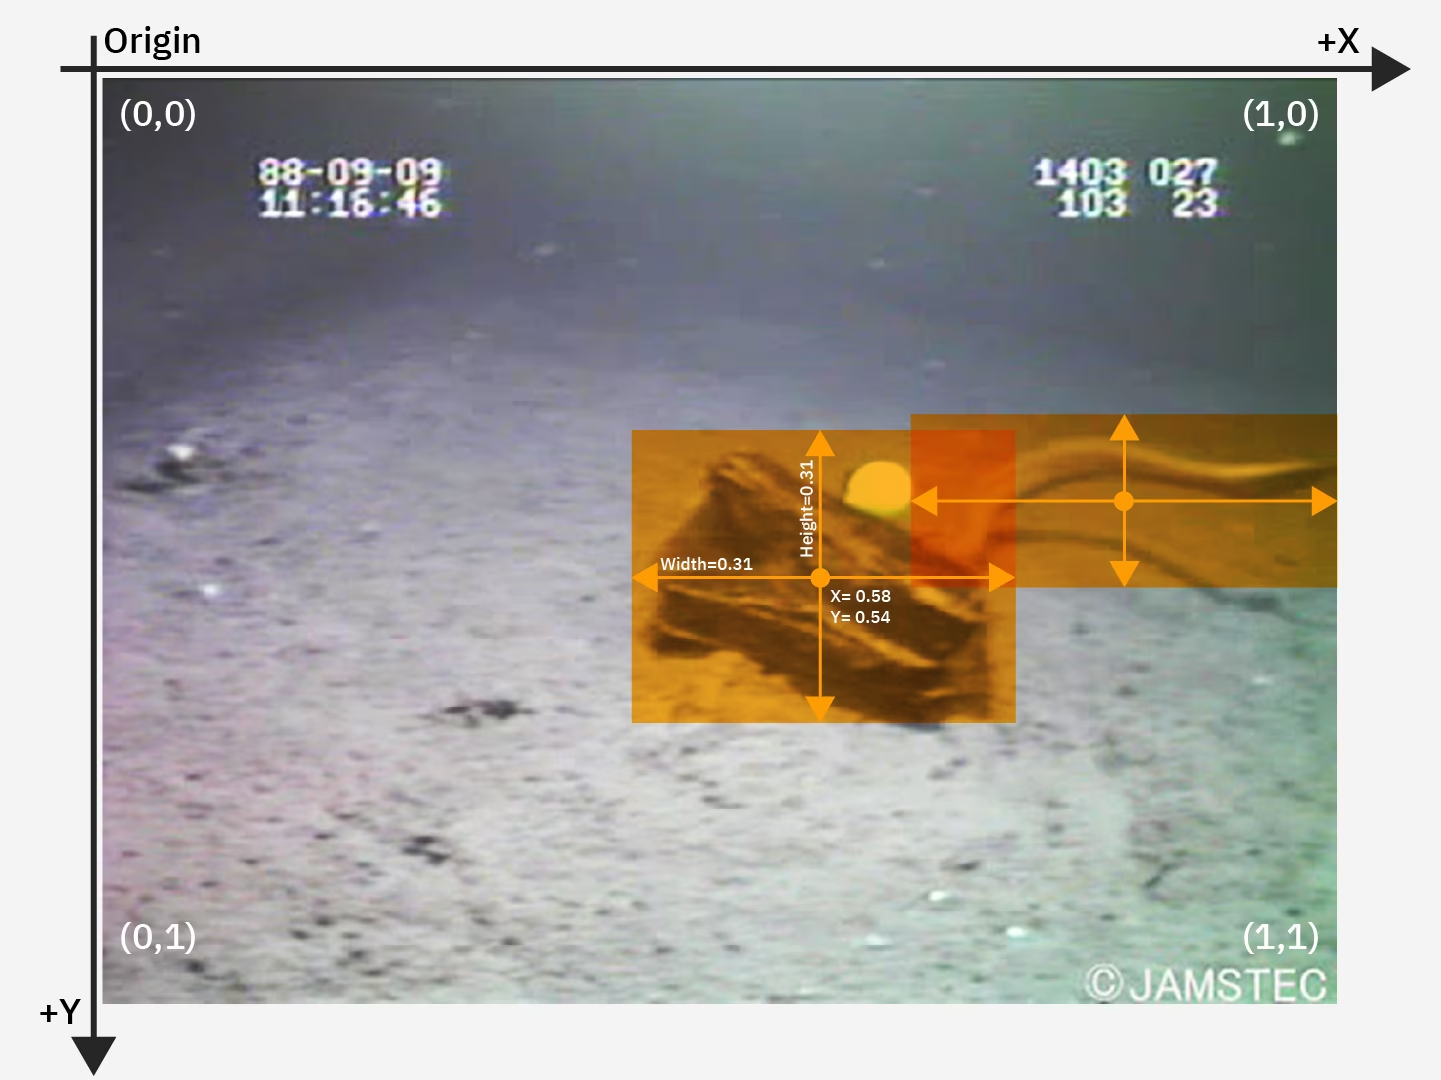
Nesne algılama modelimizi eğitmek için config.yaml dosyasını ve veri kümesi dizininin içeriğini kullanacağız. Aşağıda deniz çöpleri veri kümemizden örnek bir görüntü yer alıyor.
Adım 4: Verileri Ön İşle#
Deniz çöpleri veri kümesindeki tüm etiketler zaten YOLO .txt dosyaları olarak biçimlendirilmiştir. Ancak modelin bulabilmesi için görüntü ve etiket dizinlerini yeniden düzenlememiz gerekiyor. Şu anda yüklenen veri kümesi dizinimiz şu yapıya sahip:
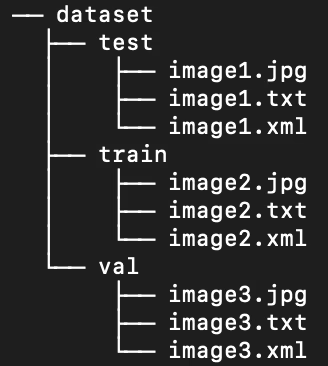
YOLO modelleri varsayılan olarak her train/val/test bölümünde ayrı images ve labels alt dizinleri gerektirir. Dizini aşağıdaki yapıda olacak şekilde yeniden düzenlememiz gerekiyor:
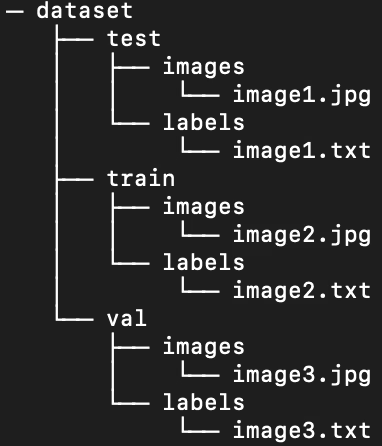
Veri kümesi dizinini yeniden düzenlemek için aşağıdaki betiği çalıştırabiliriz:
# Function to reorganize dir
def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        # Create image and label subdirs if non-existent
        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        # Move images and labels to respective subdirs
        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))
            # Delete .xml files
            elif filename.endswith(".xml"):
                os.remove(os.path.join(subdir_path, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
    organize_files(directory)
Sonraki adımda veri kümesi YAML dosyasını değiştirmemiz gerekiyor. .yaml dosyamızda kullanacağımız yapılandırma bu. Sınıf kimliği numaraları 0'dan başlar:
path: /path/to/dataset/directory # root directory for dataset
train: train/images # train images subdirectory
val: val/images # validation images subdirectory
test: test/images # test images subdirectory

# Classes
names:
    0: plastic
    1: bio
    2: rov
config.yaml içeriğini silip yeni veri kümesi dizin yapımızı yansıtan yapılandırmayla değiştirmek için aşağıdaki betiği çalıştır. Betik, daha önce tanımladığımız work_dir değişkenini otomatik olarak kullanır. Bu nedenle çalıştırmadan önce değişkenin veri kümeni gösterdiğinden emin ol ve train, val ve test alt dizinlerinin tanımlarını değiştirme.
# Contents of new config.yaml file
def update_yaml_file(file_path):
    data = {
        "path": f"{work_dir}/trash_ICRA19/dataset",
        "train": "train/images",
        "val": "val/images",
        "test": "test/images",
        "names": {0: "plastic", 1: "bio", 2: "rov"},
    }
    YAML.save(file_path, data)  # keeps key order, so "names" follows the directories

if __name__ == "__main__":
    file_path = f"{work_dir}/trash_ICRA19/config.yaml"  # .yaml file path
    update_yaml_file(file_path)
    print(f"{file_path} updated successfully.")
Adım 5: YOLO26 modelini eğit#
Önceden eğitilmiş bir YOLO26n modeli üzerinde ince ayar yapmak için aşağıdaki komutu çalıştır.
!yolo detect train data={work_dir}/trash_ICRA19/config.yaml model=yolo26n.pt epochs=2 batch=32 plots=TrueModel eğitim komutundaki parametrelere daha yakından bakalım:
- detect: Belirtilen YOLO modelini ve veri kümesini kullandığın bilgisayarlı görü görevi.
- train: Belirtilen modeli ve verileri hangi amaçla yüklediğini belirten mod. Daha sonra modelimizin performansını test ederken
predictkullanacağız. - epochs: YOLO26'nın tüm veri kümesini baştan sona kaç kez işleyeceği.
- batch: Model parametrelerini güncellemeden önce işlediği görüntü sayısı olan eğitim toplu iş boyutu.
- plots: YOLO'ya modelimizin eğitim ve değerlendirme metriklerinin grafiklerini oluşturup kaydetmesini söyler.
Model eğitim süreci ve en iyi uygulamalar hakkında ayrıntılı bilgi için YOLO26 Model Eğitimi kılavuzuna başvur. Bu kılavuz, deneylerinden en iyi şekilde yararlanmana ve YOLO26'yı etkili biçimde kullandığından emin olmana yardımcı olur.
Adım 6: Modeli Test Etme#
Artık ince ayar yaptığımız modelin performansını test etmek için çıkarım çalıştırabiliriz:
!yolo detect predict source={work_dir}/trash_ICRA19/dataset/test/images model={work_dir}/runs/detect/train/weights/best.pt conf=0.5 iou=.5 save=True save_txt=TrueBu komut, test kümesindeki her görüntü için tahmin edilen etiketleri ve orijinal görüntünün üzerine tahmin edilen sınırlayıcı kutunun eklendiği yeni çıktı görüntü dosyalarını oluşturur.
Her görüntü için tahmin edilen .txt etiketleri save_txt=True argümanı aracılığıyla kaydedilir; sınırlayıcı kutu katmanları eklenmiş çıktı görüntüleri ise save=True argümanı aracılığıyla oluşturulur. conf=0.5 parametresi, modele güven düzeyi %50'nin altındaki tüm tahminleri yok saymasını söyler.
Son olarak iou=.5, maksimum olmayan bastırma (NMS) eşiğini belirler: Aynı sınıftaki kutular daha yüksek puanlı bir kutuyla %50'den fazla örtüşüyorsa bu kutular elenir. Böylece aynı nesne için oluşturulan yinelenen kutular azaltılır. Modelimizin birkaç görüntüdeki performansını görmek için tahmin edilen sınırlayıcı kutuların eklendiği görüntüleri yükleyebiliriz.
# Show the first ten images from the preceding prediction task
for pred_dir in glob.glob(f"{work_dir}/runs/detect/predict/*.jpg")[:10]:
    img = Image.open(pred_dir)
    display(img)
Yukarıdaki kod, test kümesinden tahmin edilen sınırlayıcı kutuların yanı sıra sınıf adı etiketleri ve güven düzeyleriyle birlikte on görüntü görüntüler.
Adım 7: Modeli Değerlendirme#
Modelin her sınıf için kesinlik ve duyarlılık görselleştirmelerini oluşturabiliriz. Bu görselleştirmeler eğitim çalıştırma dizinine ({work_dir}/runs/detect/train/) kaydedilir. Kesinlik puanı BoxP_curve.png içinde gösterilir:
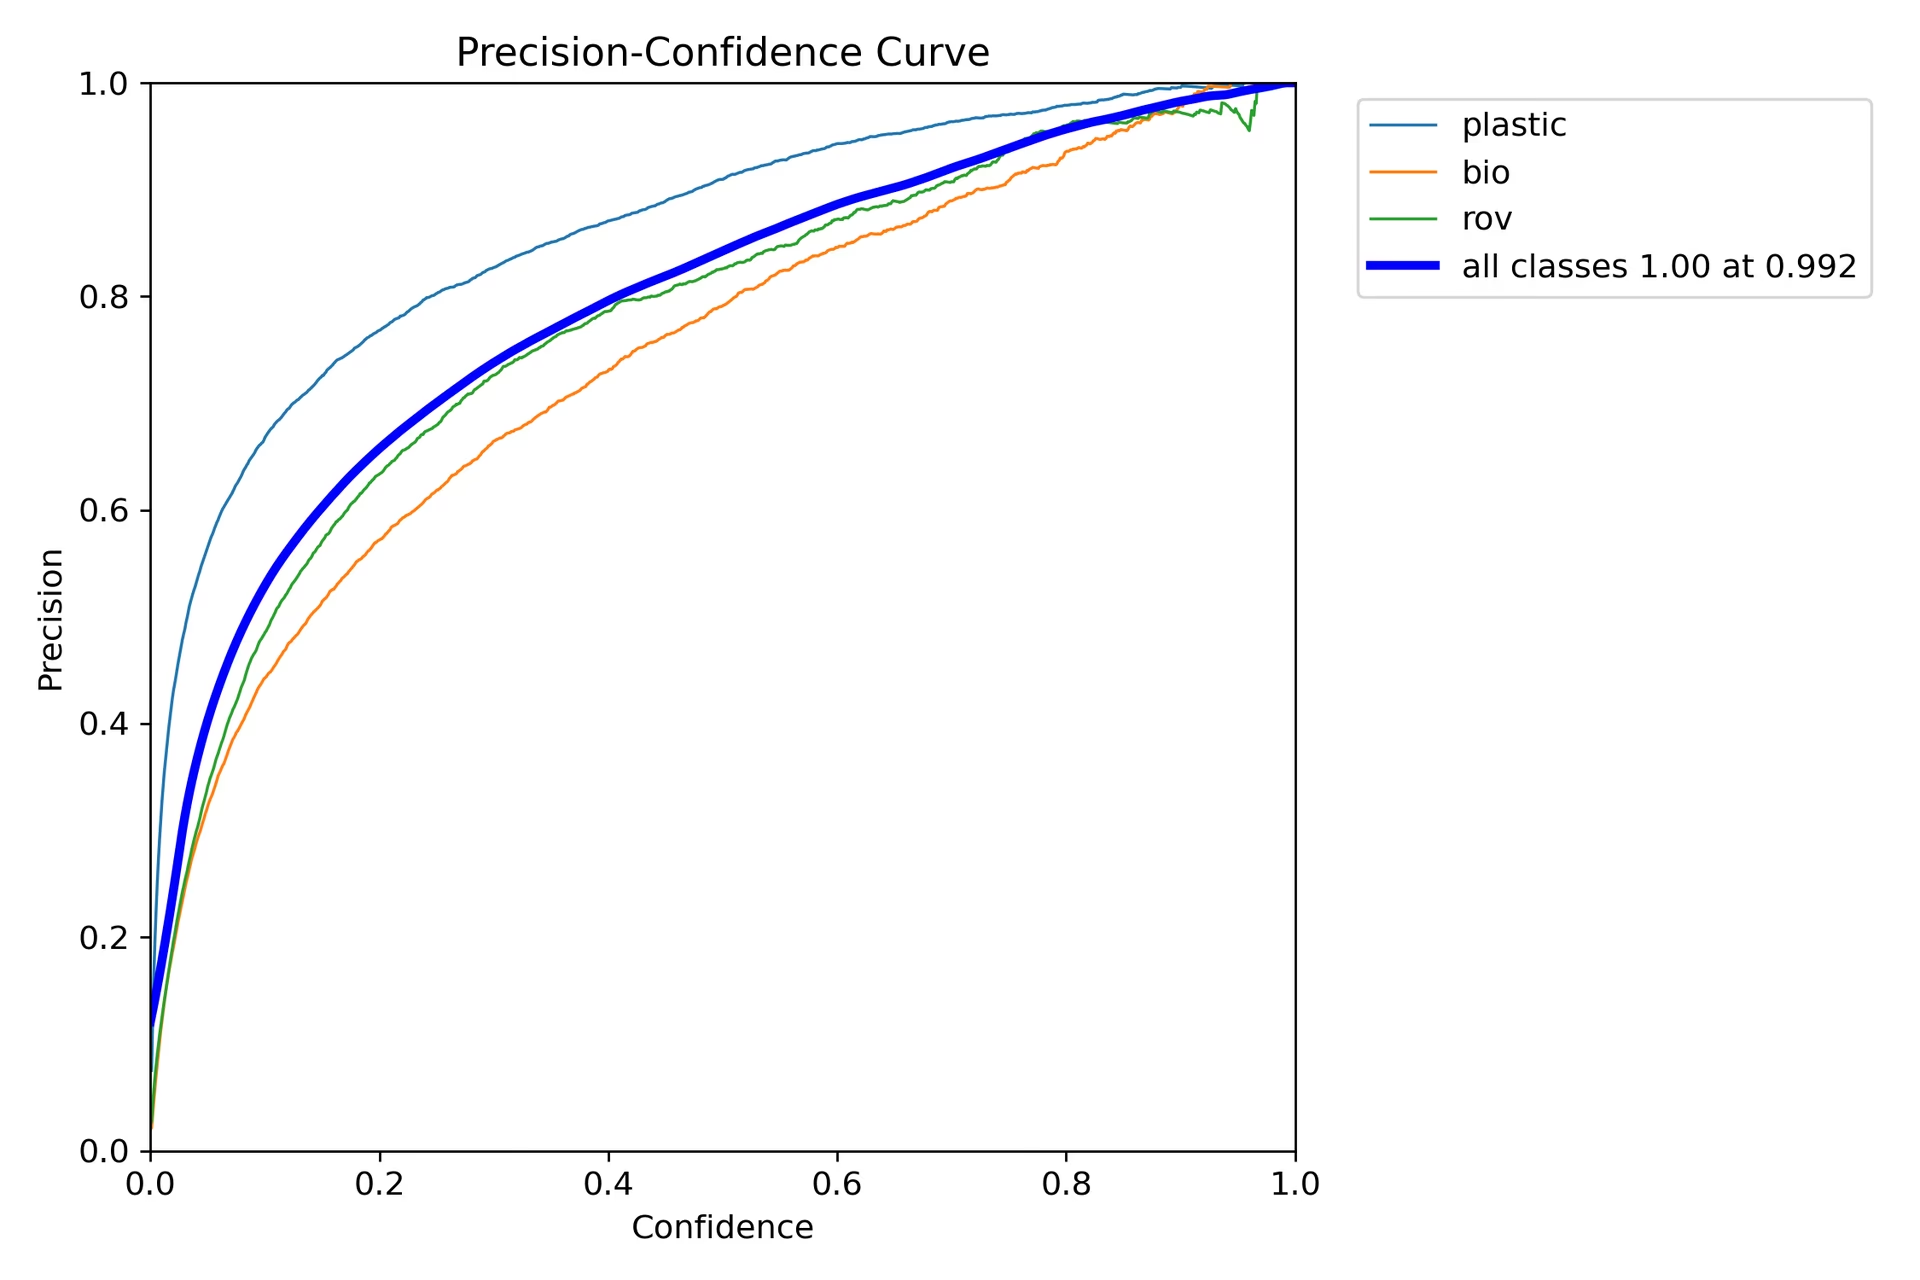
Grafik, tahminler için güven eşiği arttıkça kesinliğin yükseldiğini gösteriyor. Ancak iki epoch sonrasında modelin kesinliği henüz belirli bir güven düzeyinde sabitlenmemiş.
Duyarlılık grafiği (BoxR_curve.png) bunun tersi bir eğilim gösteriyor:
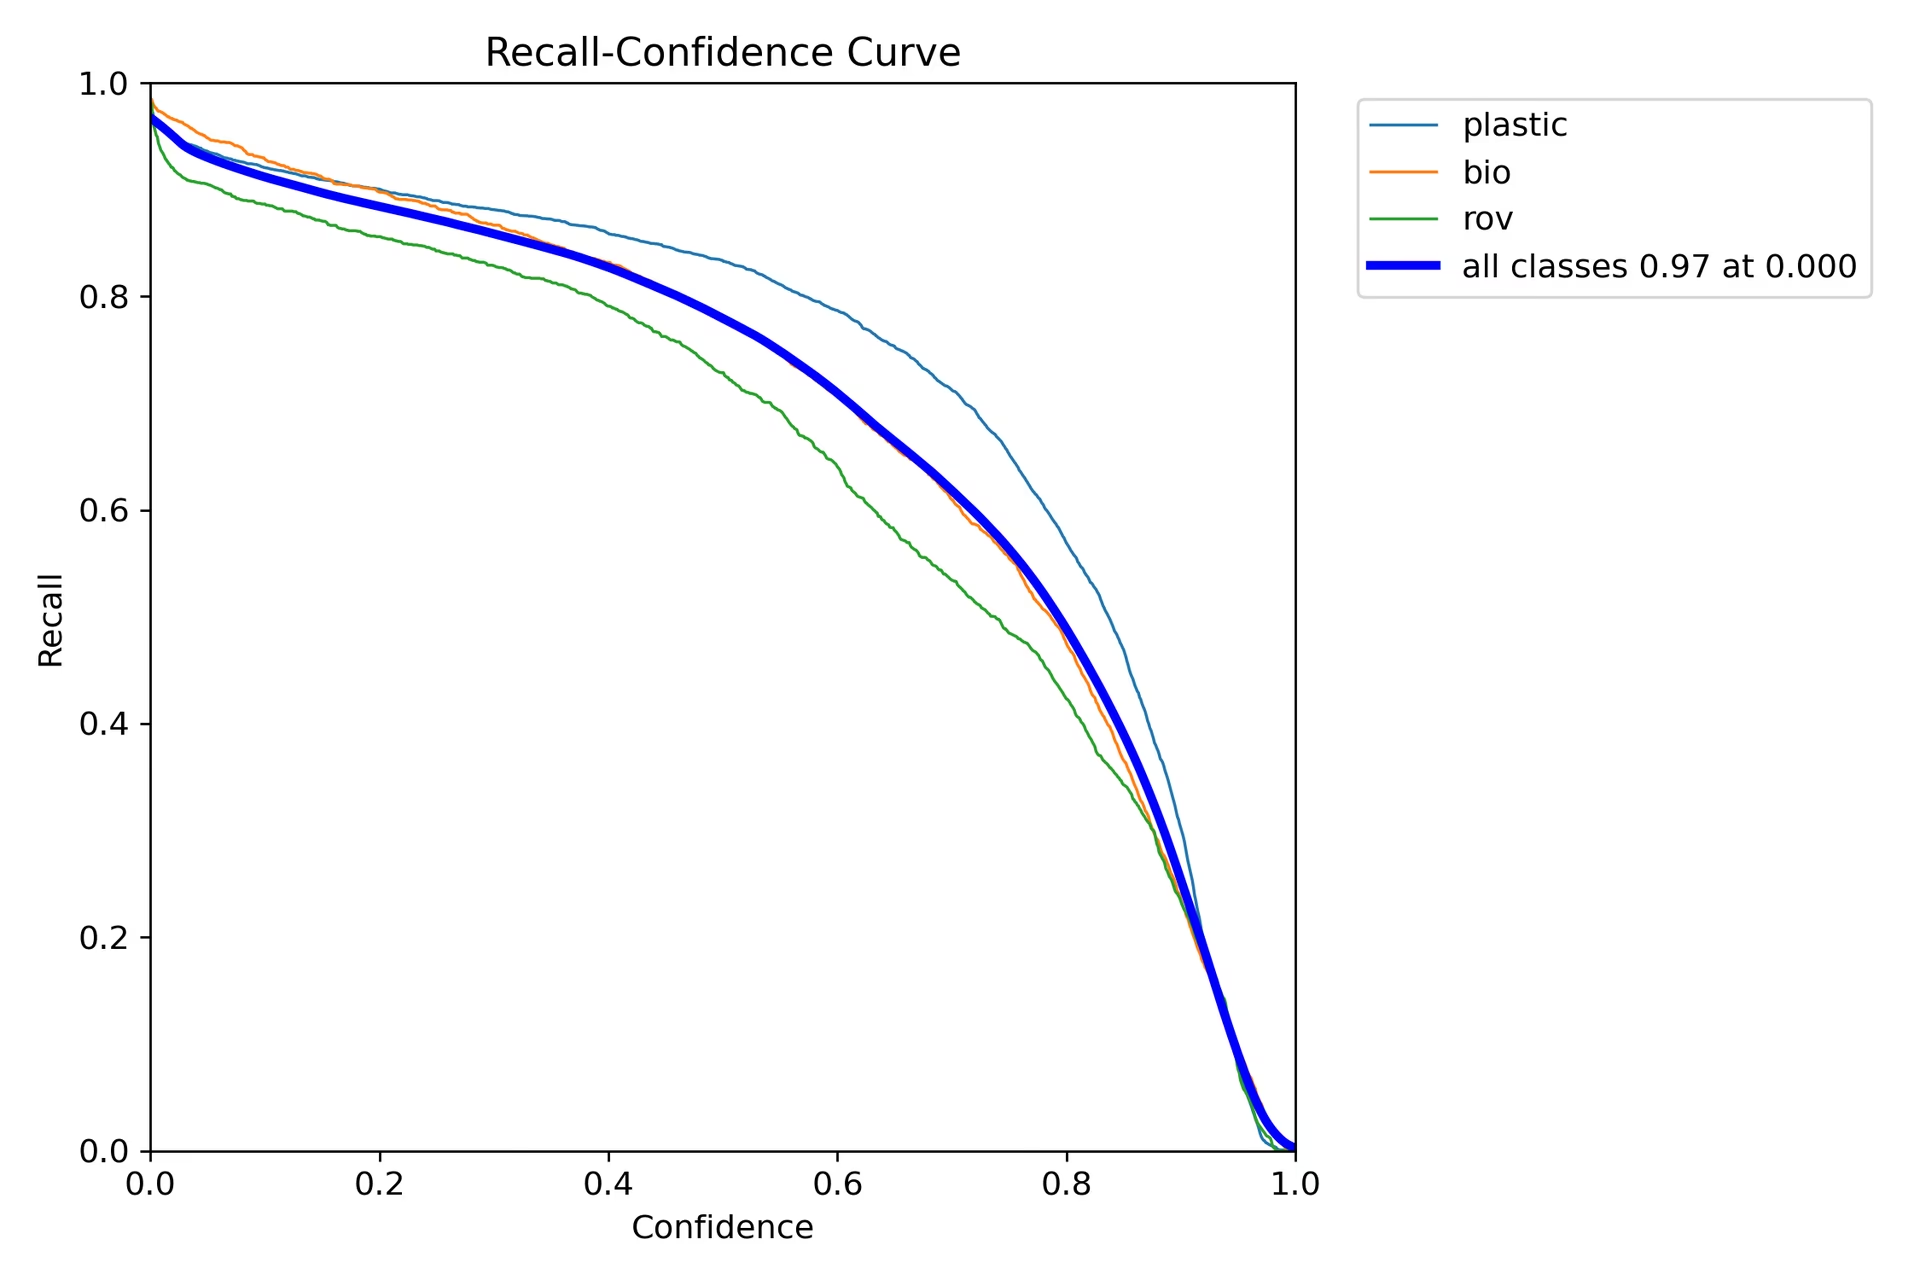
Kesinliğin aksine duyarlılık, düşük güven eşiklerinde en yüksek düzeydedir ve eşik arttıkça düşer. Bu, kesinlik ile duyarlılık arasındaki ödünleşimi gösterir.
8. Adım: Kesişim-Birleşim Oranını Hesaplama#
Bir nesne için tahmin edilen sınırlayıcı kutu ile gerçek sınırlayıcı kutu arasındaki Kesişim-Birleşim Oranını (IoU) hesaplayarak konumlandırma doğruluğunu ölçebilirsin.
Özet#
IBM Watsonx'in temel özelliklerini ve onunla bir YOLO26 modelinin nasıl eğitileceğini inceledik. IBM Watsonx ayrıca model oluşturma, veri yönetimi ve uyumluluk araçları sunar.
Kullanım hakkında daha fazla bilgi için IBM Watsonx resmi belgelerini ziyaret et.
Sık Sorulan Sorular#
IBM Watsonx kullanarak YOLO26 modelini eğitmek için şu adımları izle:
- Ortamını Kur: Bir IBM Cloud hesabı oluştur ve Watsonx.ai projesi kur. Kodlama ortamın olarak Jupyter Notebook kullan.
- Kitaplıkları Yükle:
torch,opencvveultralyticsgibi gerekli kitaplıkları yükle. - Verileri Yükle: Veri kümeni Watsonx'e yüklemek için Kaggle API'sini kullan.
- Verileri Ön İşle: Veri kümeni gerekli dizin yapısına göre düzenle ve
.yamlyapılandırma dosyasını güncelle. - Modeli Eğit: Modelini
epochsvebatchgibi parametrelerle eğitmek için YOLO komut satırı arayüzünü kullan. - Test Et ve Değerlendir: Modeli test etmek için çıkarım çalıştır ve performansını kesinlik ve duyarlık gibi metriklerle değerlendir.
Ayrıntılı talimatlar için YOLO26 Model Eğitimi kılavuzumuza başvur.
IBM Watsonx, yapay zekâ modeli eğitimi için çeşitli temel özellikler sunar:
- Watsonx.ai: IBM destekli özel modellere ve Llama 3 gibi üçüncü taraf modellere erişim dâhil, yapay zekâ geliştirme araçları sunar. Kapsamlı yapay zekâ yaşam döngüsü yönetimi için Prompt Lab ve Tuning Studio'yu içerir.
- Watsonx.data: Bulut ve şirket içi dağıtımları destekler; merkezi veri erişimi, Presto ve Spark gibi verimli sorgu motorları ve yapay zekâ destekli bir anlamsal katman sunar.
- Watsonx.governance: Uyumluluğu otomatikleştirir, uyarılarla riski yönetir ve önyargı ile veri kayması gibi sorunları tespit etmeye yönelik araçlar sunar. Ayrıca iş birliği için gösterge panelleri ve raporlama araçları içerir.
Daha fazla bilgi için IBM Watsonx resmi belgelerini ziyaret et.
IBM Watsonx, araçları yapay zekâ yaşam döngüsünün tamamını kapsadığı için Ultralytics YOLO26 eğitimi için uygundur. Başlıca avantajları:
- Ölçeklenebilirlik: IBM Cloud hizmetleriyle model eğitimini kolayca ölçeklendir.
- Entegrasyon: Çeşitli veri kaynaklarına ve API'lere bağlan.
- Kullanıcı Dostu Arayüz: İş birliğine dayalı ve sezgisel bir arayüzle geliştirme sürecini basitleştirir.
- Gelişmiş Araçlar: Model performansını iyileştirmek için Prompt Lab ve Tuning Studio gibi araçlara eriş.
IBM Watsonx üzerinde YOLO26 eğitimi için veri kümeni ön işlemek üzere:
- Dizinleri Düzenle: Veri kümenin, train/val/test bölümleri içinde görüntüler ve etiketler için ayrı alt dizinler içeren YOLO dizin yapısını izlediğinden emin ol.
- .yaml Dosyasını Güncelle: Yeni dizin yapısını ve sınıf adlarını yansıtması için
.yamlyapılandırma dosyasını değiştir. - Ön İşleme Betiğini Çalıştır: Veri kümeni yeniden düzenlemek ve
.yamldosyasını buna göre güncellemek için bir Python betiği kullan.
Veri kümeni düzenlemek için örnek bir betik:
import os
import shutil

def organize_files(directory):
    for subdir in ["train", "test", "val"]:
        subdir_path = os.path.join(directory, subdir)
        if not os.path.exists(subdir_path):
            continue

        images_dir = os.path.join(subdir_path, "images")
        labels_dir = os.path.join(subdir_path, "labels")

        os.makedirs(images_dir, exist_ok=True)
        os.makedirs(labels_dir, exist_ok=True)

        for filename in os.listdir(subdir_path):
            if filename.endswith(".txt"):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(labels_dir, filename))
            elif filename.endswith((".jpg", ".png", ".jpeg")):
                shutil.move(os.path.join(subdir_path, filename), os.path.join(images_dir, filename))

if __name__ == "__main__":
    directory = f"{work_dir}/trash_ICRA19/dataset"
    organize_files(directory)
Daha fazla ayrıntı için veri ön işleme kılavuzumuza başvur.
IBM Watsonx üzerinde YOLO26 modelini eğitmeye başlamadan önce aşağıdaki ön koşulları sağladığından emin ol:
- IBM Cloud Hesabı: Watsonx.ai'ye erişmek için IBM Cloud'da bir hesap oluştur.
- Kaggle Hesabı: Veri kümelerini yüklemek için bir Kaggle hesabına ve API anahtarına ihtiyacın olacak.
- Jupyter Notebook: Kodlama ve model eğitimi için Watsonx.ai içinde bir Jupyter Notebook ortamı kur.
Ortamını kurma hakkında daha fazla bilgi için Ultralytics Kurulum kılavuzumuzu ziyaret et.


Yorumlar
Bir soru sor, sonuçlarını paylaş veya başka birine yardım et.