Cách xây dựng tính năng tìm kiếm hình ảnh ngữ nghĩa với OpenAI CLIP#
Hướng dẫn này chỉ cho bạn cách xây dựng một công cụ tìm kiếm hình ảnh ngữ nghĩa bằng OpenAI CLIP và Flask. Bằng cách kết hợp embeddings thị giác-ngôn ngữ của CLIP với tính năng tìm kiếm độ tương đồng cosine nhanh được hỗ trợ bởi NumPy, bạn có thể xây dựng một giao diện web truy xuất các hình ảnh liên quan từ truy vấn ngôn ngữ tự nhiên mà không cần nhãn hoặc danh mục.
Watch: How Similarity Search Works | Visual Search Using OpenAI CLIP and the Ultralytics Package 🎉
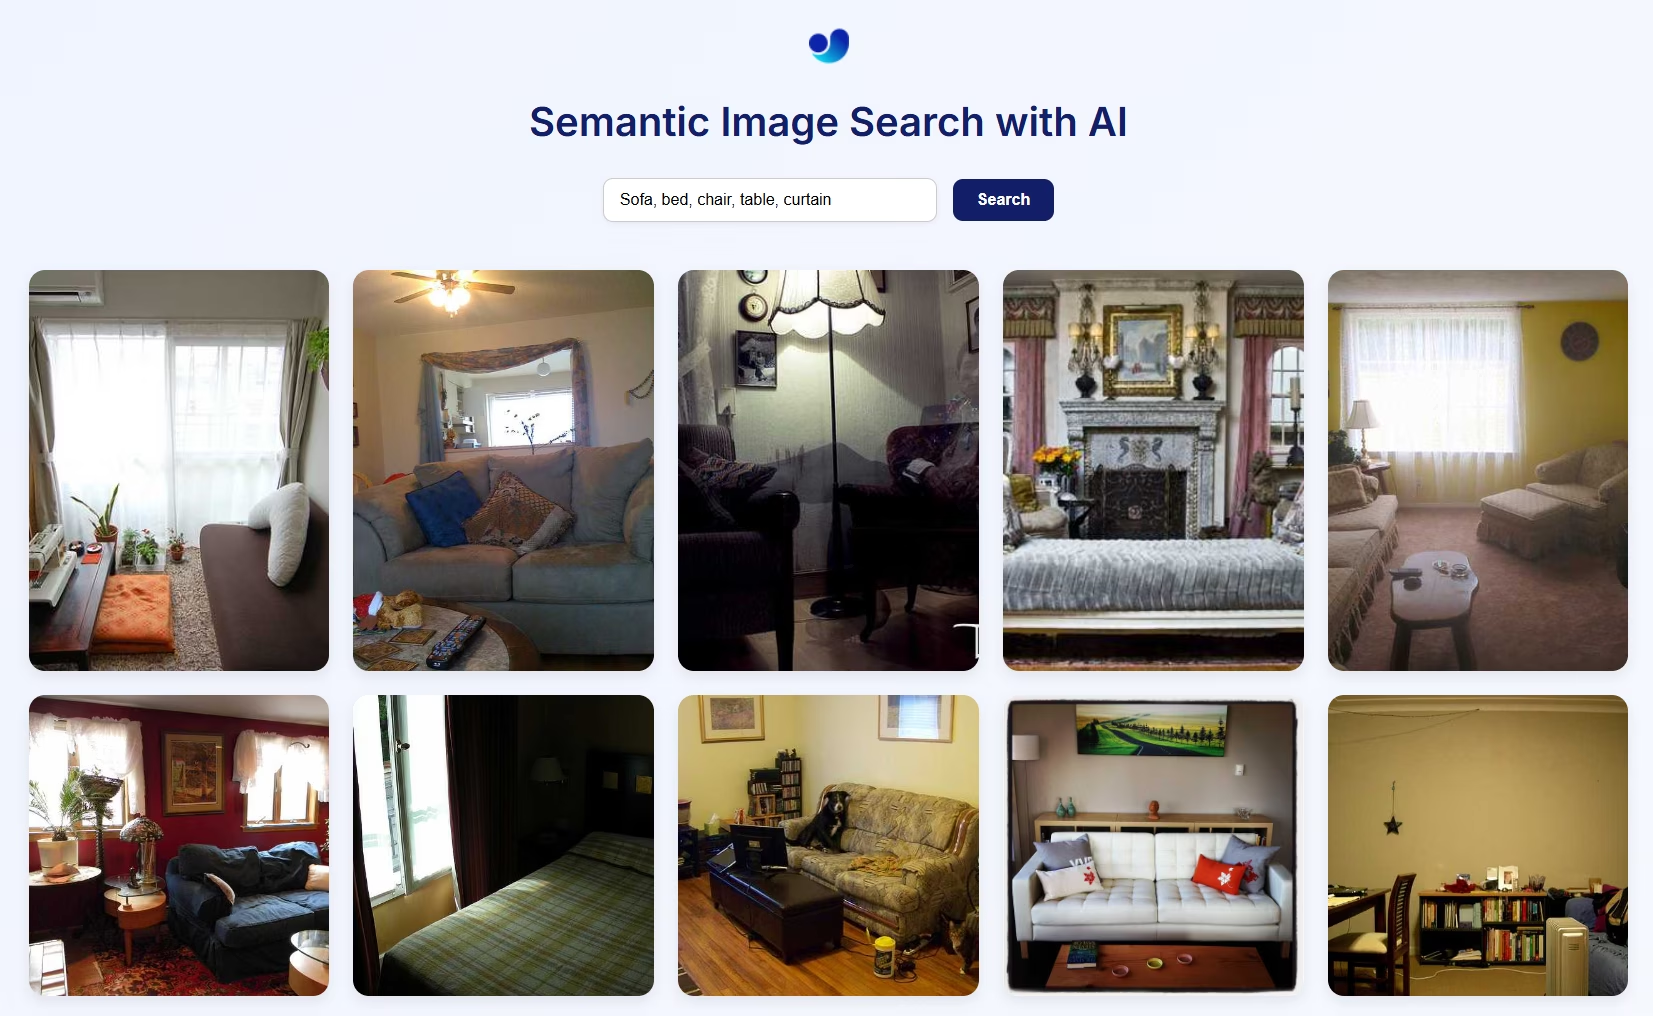
Package Python của Ultralytics đóng gói toàn bộ pipeline này phía sau hai class, vì vậy bạn có thể khởi chạy một ứng dụng tìm kiếm hoạt động được hoặc chạy các truy vấn theo cách lập trình chỉ với vài dòng code. Hướng dẫn này trình bày lý do tìm kiếm ngữ nghĩa hữu ích, cách thức hoạt động, chạy ứng dụng web, tìm kiếm theo cách lập trình và cấu hình các tham số.
Tại sao nên sử dụng tính năng tìm kiếm hình ảnh ngữ nghĩa?#
Việc xây dựng hệ thống tìm kiếm hình ảnh ngữ nghĩa riêng bằng CLIP mang lại một số lợi ích nổi bật:
- Khả năng zero-shot: Bạn không cần huấn luyện trên dataset của mình. Học zero-shot của CLIP cho phép bạn truy vấn bất kỳ bộ sưu tập hình ảnh nào bằng ngôn ngữ tự nhiên dạng tự do, giúp tiết kiệm thời gian và tài nguyên.
- Khả năng hiểu giống con người: Không giống tìm kiếm từ khóa, CLIP hiểu ngữ cảnh ngữ nghĩa và truy xuất hình ảnh từ các truy vấn trừu tượng, giàu cảm xúc hoặc mang tính quan hệ như "một đứa trẻ vui vẻ giữa thiên nhiên" hoặc "đường chân trời của một thành phố tương lai vào ban đêm."
- Không cần nhãn hoặc metadata: Phương pháp này chỉ cần hình ảnh thô. CLIP tạo embeddings mà không cần chú thích thủ công.
- Tìm kiếm nhẹ và chính xác: Một phép nhân ma trận đã chuẩn hóa trong NumPy xếp hạng mọi hình ảnh theo độ tương đồng cosine, cho kết quả chính xác với phản hồi theo thời gian thực trên hàng nghìn embedding mà không cần cài đặt hoặc quản lý dependency tìm kiếm bổ sung.
- Ứng dụng đa miền: Dù bạn đang xây dựng kho lưu trữ ảnh cá nhân, công cụ tìm cảm hứng sáng tạo, công cụ tìm kiếm sản phẩm hay hệ thống đề xuất tác phẩm nghệ thuật, cùng một stack có thể thích ứng với rất ít điều chỉnh.
Cách thức hoạt động của tính năng tìm kiếm hình ảnh ngữ nghĩa#
Pipeline kết hợp ba thành phần, mỗi thành phần đảm nhiệm một giai đoạn trong việc chuyển hình ảnh và văn bản thành các kết quả được xếp hạng:
- CLIP sử dụng bộ mã hóa thị giác (ví dụ: ResNet hoặc ViT) cho hình ảnh và bộ mã hóa văn bản (dựa trên Transformer) cho ngôn ngữ để chiếu cả hai vào cùng một không gian embedding đa phương thức. Điều này cho phép so sánh trực tiếp văn bản và hình ảnh bằng độ tương đồng cosine.
- NumPy lưu các embedding hình ảnh dưới dạng một array duy nhất và xếp hạng chúng so với embedding truy vấn bằng một phép nhân ma trận, trả về các vector gần nhất theo độ tương đồng cosine mà không cần dependency lập chỉ mục bổ sung.
- Flask cung cấp giao diện web đơn giản để gửi các truy vấn ngôn ngữ tự nhiên và hiển thị những hình ảnh khớp về mặt ngữ nghĩa từ index.
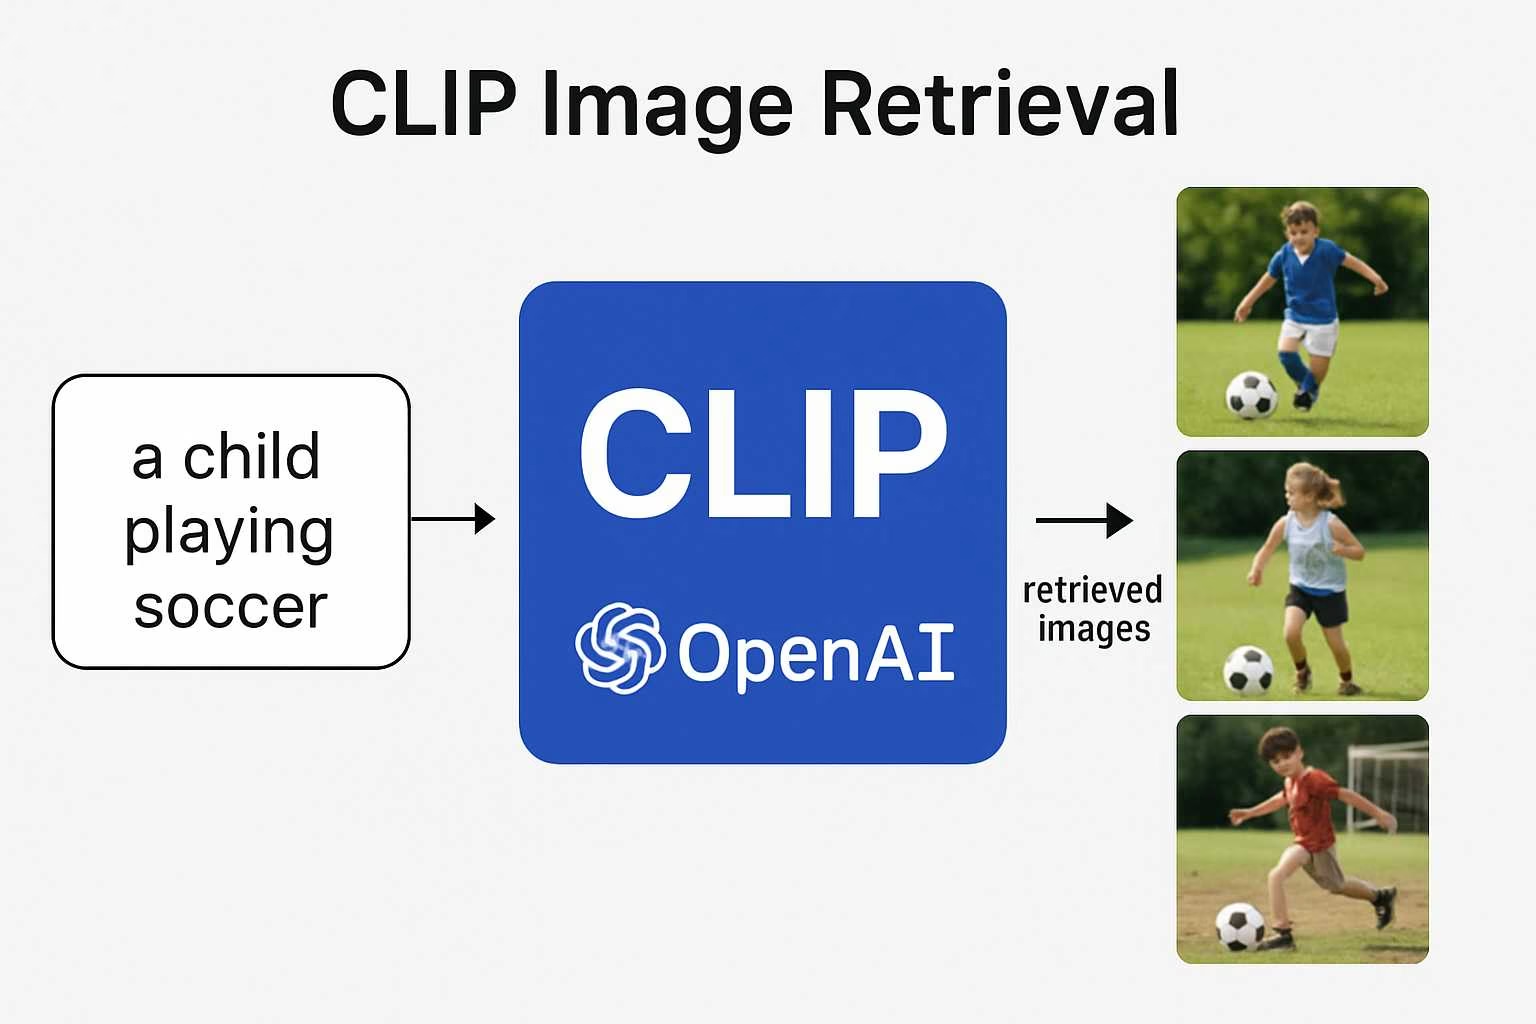
Vì hình ảnh và văn bản đều nằm trong cùng một không gian vector, việc truy xuất có tính zero-shot: bạn không cần nhãn hoặc danh mục, chỉ cần dữ liệu hình ảnh và một prompt tốt.
Chạy ứng dụng web tìm kiếm ngữ nghĩa#
Class SearchApp khởi chạy toàn bộ giao diện Flask. Trong lần chạy đầu tiên, class này tải xuống một tập hợp hình ảnh mẫu, xây dựng index embedding và cung cấp một trang nơi bạn có thể nhập truy vấn rồi xem các kết quả được xếp hạng.
Cảnh báo về đường dẫn hình ảnh
Nếu bạn sử dụng hình ảnh của mình, hãy đảm bảo cung cấp đường dẫn tuyệt đối đến thư mục hình ảnh. Nếu không, hình ảnh có thể không xuất hiện trên trang web do các hạn chế trong việc Flask cung cấp file.
from ultralytics import solutions

app = solutions.SearchApp(
    data="images",  # replace with a path to build the search engine with your own images
    device="cpu",  # configure the device for processing, e.g., "cpu" or "cuda"
)

app.run(debug=False)  # You can also use `debug=True` argument for testing
Tìm kiếm hình ảnh theo cách lập trình#
Class VisualAISearch thực hiện toàn bộ thao tác backend mà không cần lớp web:
- Tải hoặc xây dựng index embedding từ hình ảnh cục bộ.
- Trích xuất embeddings hình ảnh và văn bản bằng CLIP.
- Thực hiện tìm kiếm tương đồng bằng độ tương đồng cosine.
Gọi searcher bằng một truy vấn ngôn ngữ tự nhiên để nhận về danh sách tên file hình ảnh khớp được xếp hạng theo độ tương đồng:
from ultralytics import solutions

searcher = solutions.VisualAISearch(
    data="images",  # replace with a path to build the search engine with your own images
    device="cpu",  # configure the device for processing, e.g., "cpu" or "cuda"
)

results = searcher("a dog sitting on a bench")

# Ranked Results:
#     - 000000546829.jpg | Similarity: 0.3269
#     - 000000549220.jpg | Similarity: 0.2899
#     - 000000517069.jpg | Similarity: 0.2761
#     - 000000029393.jpg | Similarity: 0.2742
#     - 000000534270.jpg | Similarity: 0.2680
Cấu hình các tham số của VisualAISearch#
Bảng dưới đây liệt kê các tham số khả dụng cho VisualAISearch:
| Đối số | Kiểu | Mặc định | Mô tả |
|---|---|---|---|
data | str | 'images' | Đường dẫn đến thư mục hình ảnh cần lập index và tìm kiếm. |
device | str | 'cpu' | Thiết bị được sử dụng cho suy luận CLIP (ví dụ: cpu, cuda, 0). |
Để tìm kiếm các bộ sưu tập hình ảnh ở quy mô production mà không phải quản lý file cục bộ, bạn có thể sắp xếp và version hình ảnh trên Ultralytics Platform trước khi lập index bằng CLIP.
Kết luận#
Với CLIP và package Python của Ultralytics, bạn có thể triển khai một công cụ tìm kiếm hình ảnh ngữ nghĩa zero-shot chỉ với vài dòng code, dưới dạng ứng dụng web Flask hoặc backend tìm kiếm theo cách lập trình. Từ đây, hãy trỏ data đến thư mục hình ảnh của riêng bạn để lập index, sau đó khám phá các Ultralytics Solutions khác để xây dựng thêm trên quy trình computer vision của mình.
FAQ#
CLIP (Huấn luyện trước tương phản ngôn ngữ-hình ảnh) là một model do OpenAI phát triển, có khả năng học cách kết nối thông tin thị giác và ngôn ngữ. Model này được huấn luyện trên một dataset khổng lồ gồm các hình ảnh đi kèm chú thích bằng ngôn ngữ tự nhiên. Quá trình huấn luyện này cho phép model ánh xạ cả hình ảnh và văn bản vào một không gian embedding chung, nhờ đó bạn có thể so sánh trực tiếp chúng bằng độ tương đồng vector.
Điểm khiến CLIP nổi bật là khả năng khái quát hóa. Thay vì chỉ được huấn luyện cho các nhãn hoặc tác vụ cụ thể, model học trực tiếp từ ngôn ngữ tự nhiên. Nhờ đó, model có thể xử lý các truy vấn linh hoạt như "một người đàn ông đang lái mô tô nước" hoặc "cảnh mộng siêu thực", khiến CLIP hữu ích cho mọi thứ từ phân loại đến tìm kiếm ngữ nghĩa sáng tạo mà không cần huấn luyện lại.
Sau khi CLIP chuyển hình ảnh của bạn thành embeddings, package Ultralytics chuẩn hóa L2 cho chúng và lưu trong một array NumPy duy nhất. Một truy vấn được xếp hạng bằng một phép nhân ma trận để tính độ tương đồng cosine giữa embedding truy vấn và mọi embedding hình ảnh, sau đó sắp xếp các điểm số. Tìm kiếm brute-force này chính xác và nhanh đối với các bộ sưu tập hình ảnh thông thường, không cần cài đặt hoặc quản lý dependency vector database bổ sung.
Mặc dù CLIP được OpenAI phát triển, package Python của Ultralytics đóng gói việc tạo embedding, lập index và tìm kiếm theo độ tương đồng cosine thành một pipeline tìm kiếm hình ảnh ngữ nghĩa hoàn chỉnh, chỉ với vài dòng code là có thể hoạt động ngay:
from ultralytics import solutions

searcher = solutions.VisualAISearch(
    data="images",  # replace with a path to build the search engine with your own images
    device="cpu",  # configure the device for processing, e.g., "cpu" or "cuda"
)

results = searcher("a dog sitting on a bench")
Phần triển khai cấp cao này xử lý:
- Tạo embedding hình ảnh và văn bản dựa trên CLIP.
- Tạo và quản lý index embedding.
- Tìm kiếm ngữ nghĩa hiệu quả bằng độ tương đồng cosine.
- Tải hình ảnh dựa trên thư mục và trực quan hóa.
Có. Thiết lập hiện tại sử dụng Flask với frontend HTML cơ bản, nhưng bạn có thể thay thế bằng HTML của riêng mình hoặc xây dựng UI linh hoạt hơn bằng React, Vue hay một frontend framework khác. Flask có thể đóng vai trò backend API cho giao diện tùy chỉnh của bạn.
Không trực tiếp. Một cách giải quyết đơn giản là trích xuất các frame riêng lẻ từ video (ví dụ: một frame mỗi giây), coi chúng như những hình ảnh độc lập và đưa chúng vào hệ thống. Bằng cách này, công cụ tìm kiếm có thể lập index ngữ nghĩa cho các khoảnh khắc hình ảnh trong video của bạn.