Triển khai YOLO26 trên thiết bị di động và edge bằng ExecuTorch#
Việc triển khai model thị giác máy tính trên thiết bị edge như điện thoại thông minh, máy tính bảng và hệ thống nhúng đòi hỏi runtime được tối ưu hóa để cân bằng hiệu suất với giới hạn tài nguyên. ExecuTorch, giải pháp điện toán edge của PyTorch, cho phép suy luận hiệu quả ngay trên thiết bị cho các model Ultralytics YOLO.
Hướng dẫn này trình bày cách export model Ultralytics YOLO sang định dạng ExecuTorch, cho phép bạn triển khai model trên thiết bị di động và edge với hiệu suất được tối ưu hóa.
Tại sao nên export sang ExecuTorch?#
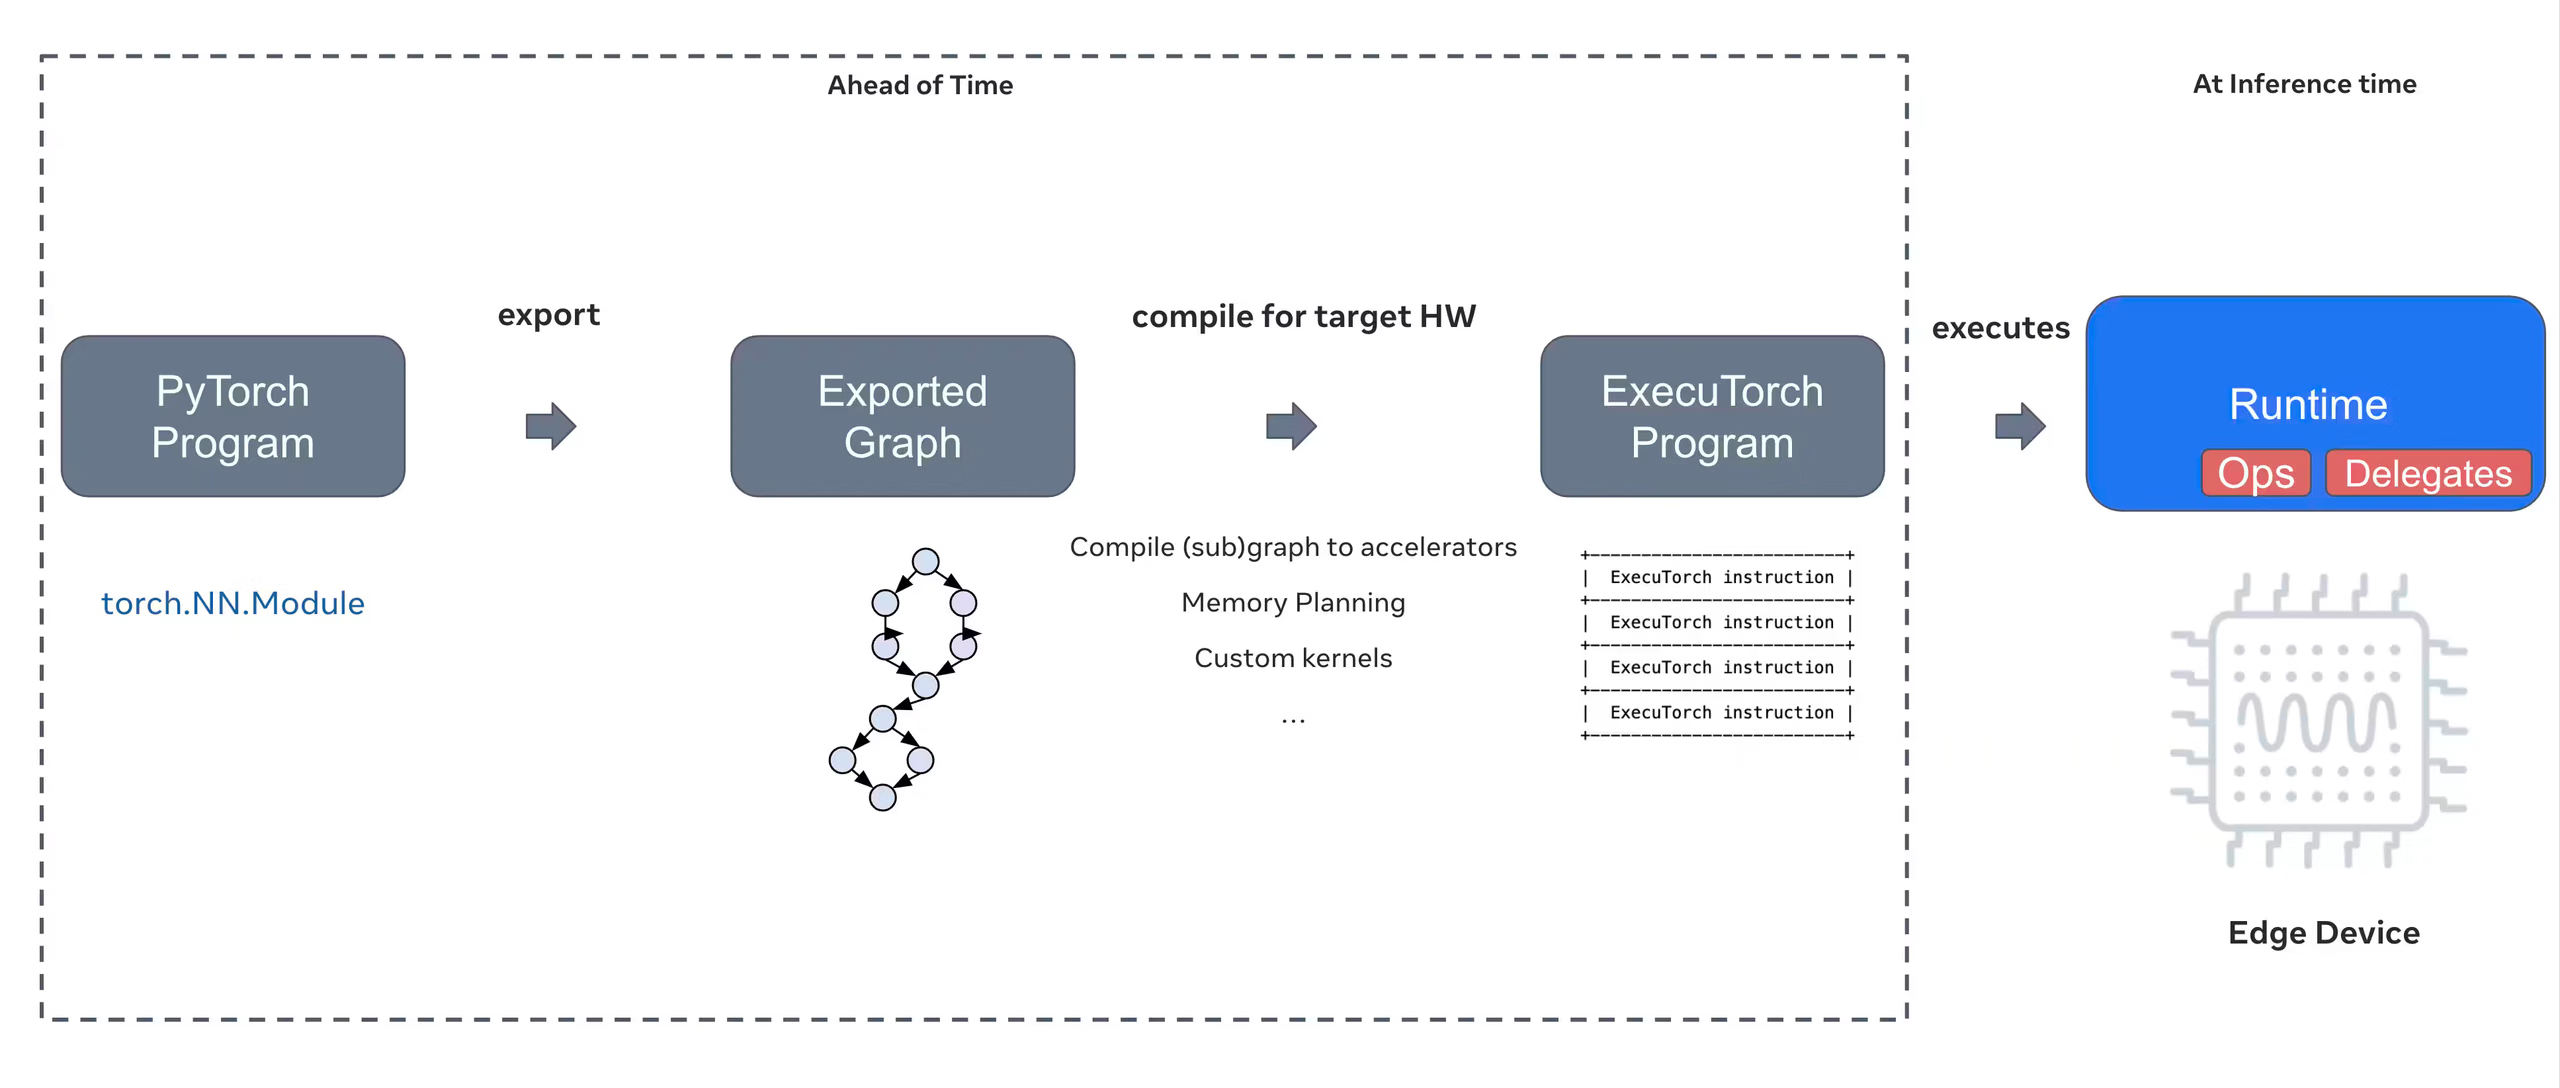
ExecuTorch là giải pháp đầu-cuối của PyTorch, cung cấp khả năng suy luận trên thiết bị di động và edge. Được xây dựng với mục tiêu linh hoạt và hiệu quả, ExecuTorch có thể chạy chương trình PyTorch trên nhiều nền tảng tính toán.
Các tính năng chính của ExecuTorch#
ExecuTorch cung cấp nhiều tính năng mạnh mẽ để triển khai model Ultralytics YOLO trên thiết bị edge:
-
Định dạng model linh hoạt: ExecuTorch sử dụng định dạng
.pte(PyTorch ExecuTorch), được tối ưu hóa về kích thước và tốc độ tải trên các thiết bị có tài nguyên hạn chế. -
Backend XNNPACK: Tích hợp mặc định với XNNPACK giúp tối ưu hóa suy luận trên CPU di động, mang lại hiệu suất vượt trội mà không cần phần cứng chuyên dụng.
-
Sẵn sàng cho lượng tử hóa: Hệ sinh thái ExecuTorch hỗ trợ các kỹ thuật lượng tử hóa để giảm kích thước model và cải thiện tốc độ suy luận; hiện Ultralytics export model FP32 thông qua backend XNNPACK.
-
Sử dụng bộ nhớ hiệu quả: Cơ chế quản lý bộ nhớ được tối ưu hóa giúp giảm mức sử dụng bộ nhớ khi chạy, phù hợp với các thiết bị có RAM hạn chế.
-
Metadata của model: Model được export kèm metadata (kích thước ảnh, tên lớp, v.v.) trong một tệp YAML riêng để dễ dàng tích hợp.
Các tùy chọn triển khai với ExecuTorch#
Có thể triển khai model ExecuTorch trên nhiều nền tảng di động và edge:
-
Ứng dụng di động: Triển khai trên ứng dụng iOS và Android với hiệu suất gốc, cho phép phát hiện đối tượng theo thời gian thực trong ứng dụng di động.
-
Hệ thống nhúng: Chạy trên các thiết bị Linux nhúng như Raspberry Pi, NVIDIA Jetson và các hệ thống khác dựa trên ARM với hiệu suất được tối ưu hóa.
-
Thiết bị AI edge: Triển khai trên phần cứng AI edge chuyên dụng bằng delegate tùy chỉnh để tăng tốc suy luận.
-
Thiết bị IoT: Tích hợp vào thiết bị IoT để suy luận ngay trên thiết bị mà không cần kết nối đám mây.
Các tác vụ được hỗ trợ#
ExecuTorch hỗ trợ export cho cả bảy tác vụ Ultralytics. Phân đoạn ngữ nghĩa và ước tính độ sâu chỉ khả dụng với YOLO26, dòng model duy nhất có sẵn các head này.
Export model Ultralytics YOLO26 sang ExecuTorch#
Chuyển đổi model Ultralytics YOLO26 sang định dạng ExecuTorch cho phép triển khai hiệu quả trên thiết bị di động và edge.
Cài đặt#
Export ExecuTorch yêu cầu Python 3.10-3.14 và PyTorch >= 2.9.0. Ultralytics cài đặt package executorch tương thích khi bạn export hoặc load model ExecuTorch; package được ghim ở phiên bản executorch<1.5 trên PyTorch cũ hơn 2.13, vì vậy không nâng cấp package này thủ công.
# Install Ultralytics package
pip install ultralytics
Để xem hướng dẫn chi tiết và các phương pháp thực hành tốt nhất liên quan đến quy trình cài đặt, hãy tham khảo hướng dẫn cài đặt YOLO26. Nếu gặp khó khăn khi cài đặt các package cần thiết cho YOLO26, hãy xem hướng dẫn về các sự cố thường gặp để tìm giải pháp và mẹo xử lý.
Cách sử dụng#
Export model YOLO26 sang ExecuTorch rất đơn giản:
Định dạng ExecuTorch hỗ trợ các chế độ Export, Predict và Validate. Hãy export model, sau đó tải model đã export để chạy suy luận hoặc xác thực độ chính xác.
from ultralytics import YOLO

# Nạp model YOLO26
model = YOLO("yolo26n.pt")

# Export model sang định dạng ExecuTorch
model.export(format="executorch") # creates 'yolo26n_executorch_model'from ultralytics import YOLO
# Tải model ExecuTorch đã export
model = YOLO("yolo26n_executorch_model")
# Chạy suy luận
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# Tải model ExecuTorch đã export
model = YOLO("yolo26n_executorch_model")
# # Đánh giá độ chính xác trên bộ dữ liệu COCO8
metrics = model.val(data="coco8.yaml")Quá trình export sang ExecuTorch tạo một thư mục gồm tệp .pte và metadata. Dùng runtime ExecuTorch trong ứng dụng di động hoặc ứng dụng nhúng để tải model .pte và thực hiện suy luận.
Các tham số xuất model#
Khi export sang định dạng ExecuTorch, bạn có thể chỉ định các tham số sau:
| Đối số | Kiểu | Mặc định | Mô tả |
|---|---|---|---|
format | str | 'executorch' | Định dạng đích của model đã xuất, xác định khả năng tương thích với nhiều môi trường triển khai. |
imgsz | int hoặc tuple | 640 | Kích thước ảnh mong muốn cho đầu vào model. Có thể là số nguyên cho ảnh vuông hoặc tuple (height, width) để chỉ định kích thước cụ thể. |
quantize | int hoặc str | None | Export FP32 cố định. ExecuTorch không hỗ trợ chuyển đổi độ chính xác FP16, INT8 hoặc W8A16 trong quá trình export. |
batch | int | 1 | Chỉ định kích thước batch suy luận của model khi xuất hoặc số lượng ảnh tối đa mà model đã xuất xử lý đồng thời ở chế độ predict. |
device | str | None | Chỉ định thiết bị dùng để xuất: GPU (device=0), CPU (device=cpu), MPS cho Apple silicon (device=mps). |
Cấu trúc đầu ra#
Quá trình export ExecuTorch tạo một thư mục chứa model và metadata:
yolo26n_executorch_model/
├── model.pte               # ExecuTorch model file
└── metadata.yaml           # Model metadata (classes, image size, etc.)
Sử dụng model ExecuTorch đã export#
Sau khi export model, bạn cần tích hợp model vào ứng dụng đích bằng runtime ExecuTorch.
Tích hợp trên thiết bị di động#
Đối với ứng dụng di động (iOS/Android), bạn cần:
- Thêm runtime ExecuTorch: Đưa thư viện runtime ExecuTorch vào project di động của bạn
- Tải model: Tải tệp
.ptetrong ứng dụng của bạn - Chạy suy luận: Xử lý ảnh và nhận dự đoán
iOS#
Ví dụ tích hợp iOS (Objective-C/C++):
// iOS uses C++ APIs for model loading and inference
// See https://pytorch.org/executorch/stable/using-executorch-ios.html for complete examples

#include <executorch/extension/module/module.h>

using namespace ::executorch::extension;

// Load the model
Module module("/path/to/model.pte");

// Create input tensor
float input[1 * 3 * 640 * 640];
auto tensor = from_blob(input, {1, 3, 640, 640});

// Run inference
const auto result = module.forward(tensor);Android#
Thêm AAR Android của ExecuTorch từ Maven Central:
dependencies {
    implementation("org.pytorch:executorch-android:<version>")
}
Ví dụ tích hợp Android (Kotlin):
import org.pytorch.executorch.EValue
import org.pytorch.executorch.Module
import org.pytorch.executorch.Tensor

// Load the model
val module = Module.load("/path/to/model.pte")

// Prepare input tensor
val inputTensor = Tensor.fromBlob(floatData, longArrayOf(1, 3, 640, 640))
val inputEValue = EValue.from(inputTensor)

// Run inference
val outputs = module.forward(inputEValue)
val scores = outputs[0].toTensor().dataAsFloatArray
Linux nhúng#
Đối với các hệ thống Linux nhúng, hãy sử dụng API C++ của ExecuTorch:
#include <executorch/extension/module/module.h>
#include <executorch/extension/tensor/tensor.h>

using namespace ::executorch::extension;

// Load model
Module module("model.pte");

// Prepare input
std::vector<float> input_data = preprocessImage(image);
auto input_tensor = from_blob(input_data.data(), {1, 3, 640, 640});

// Run inference
const auto outputs = module.forward(input_tensor);
Để biết thêm chi tiết về cách tích hợp ExecuTorch vào ứng dụng, hãy truy cập Tài liệu ExecuTorch.
Tối ưu hóa hiệu năng#
Tối ưu hóa kích thước model#
Để giảm kích thước model khi triển khai:
- Sử dụng model nhỏ hơn: Bắt đầu với YOLO26n (nano) để có footprint nhỏ nhất
- Giảm độ phân giải đầu vào: Sử dụng kích thước ảnh nhỏ hơn (ví dụ:
imgsz=320hoặcimgsz=416) - Lượng tử hóa: Áp dụng các kỹ thuật lượng tử hóa của ExecuTorch bên ngoài Ultralytics (quá trình xuất ExecuTorch của Ultralytics chỉ hỗ trợ FP32)
Tối ưu hóa tốc độ suy luận#
Để suy luận nhanh hơn:
- Backend XNNPACK: Backend XNNPACK mặc định cung cấp khả năng suy luận CPU được tối ưu hóa
- Tăng tốc phần cứng: Sử dụng các delegate dành riêng cho từng nền tảng (ví dụ: CoreML cho iOS)
- Xử lý theo batch: Xử lý nhiều ảnh khi có thể
Benchmark#
Đội ngũ Ultralytics đã benchmark các model YOLO26, so sánh tốc độ và độ chính xác giữa PyTorch và ExecuTorch.
| Model | Định dạng | Trạng thái | Kích thước (MB) | metrics/mAP50-95(B) | Thời gian suy luận (ms/ảnh) |
|---|---|---|---|---|---|
| YOLO26n | PyTorch | ✅ | 5.3 | 0.4790 | 314.80 |
| YOLO26n | ExecuTorch | ✅ | 9.4 | 0.4800 | 142 |
| YOLO26s | PyTorch | ✅ | 19.5 | 0.5730 | 930.90 |
| YOLO26s | ExecuTorch | ✅ | 36.5 | 0.5780 | 376.1 |
Thời gian suy luận không bao gồm tiền xử lý/hậu xử lý.
Khắc phục sự cố#
Các sự cố thường gặp#
Sự cố: Python version error
Giải pháp: ExecuTorch yêu cầu Python từ 3.10 đến 3.14. Tạo môi trường với phiên bản được hỗ trợ:
# Using conda
conda create -n executorch python=3.14
conda activate executorch
Để được hỗ trợ khắc phục sự cố thêm, hãy truy cập Các vấn đề trên GitHub của Ultralytics hoặc Tài liệu ExecuTorch.
Tóm tắt#
Xuất model YOLO26 sang định dạng ExecuTorch cho phép triển khai hiệu quả trên thiết bị di động và thiết bị biên. Với khả năng tích hợp gốc với PyTorch, hỗ trợ đa nền tảng và hiệu năng được tối ưu hóa, ExecuTorch là lựa chọn tuyệt vời cho các ứng dụng AI biên.
Những điểm chính:
- ExecuTorch cung cấp khả năng triển khai trên thiết bị biên với hiệu năng tuyệt vời và tích hợp gốc với PyTorch
- Có thể xuất dễ dàng bằng tham số
format='executorch' - Các model được tối ưu hóa cho CPU di động thông qua backend XNNPACK
- Hỗ trợ các nền tảng iOS, Android và Linux nhúng
- Yêu cầu Python 3.10-3.14 và PyTorch >= 2.9.0
Câu hỏi thường gặp#
Xuất model YOLO26 sang ExecuTorch bằng Python hoặc CLI:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(format="executorch")
hoặc
yolo export model=yolo26n.pt format=executorchQuá trình xuất ExecuTorch yêu cầu:
- Python 3.10 đến 3.14
- Gói
executorch, được tự động cài đặt (executorch<1.5trên PyTorch phiên bản cũ hơn 2.13, không được các runtime ExecuTorch mới hơn hỗ trợ) - PyTorch (được tự động cài đặt cùng với ultralytics)
Lưu ý: Gói
executorchcung cấp các wheel dựng sẵn (có backend XNNPACK), vì vậy không cần biên dịch thêm trong quá trình xuất.Có thể tải trực tiếp các model ExecuTorch bằng
YOLO()để suy luận và xác thực trong Python (xem các ví dụ Predict/Validate ở trên); đồng thời, các model này cũng có thể được triển khai trên thiết bị di động và thiết bị biên bằng các thư viện runtime ExecuTorch.ExecuTorch hỗ trợ:
- Thiết bị di động: iOS và Android
- Linux nhúng: Raspberry Pi, NVIDIA Jetson và các thiết bị ARM khác
- Máy tính để bàn: Linux, macOS và Windows (dành cho phát triển)
Cả ExecuTorch và LiteRT đều là lựa chọn tuyệt vời để triển khai trên thiết bị di động:
- ExecuTorch: Tích hợp PyTorch tốt hơn, quy trình làm việc PyTorch gốc, hệ sinh thái đang phát triển
- LiteRT: Phát triển hoàn thiện hơn, hỗ trợ phần cứng rộng hơn, có nhiều ví dụ triển khai hơn và chạy cùng một model trên Android, iOS và trình duyệt
Hãy chọn ExecuTorch nếu bạn đã sử dụng PyTorch và muốn có lộ trình triển khai gốc. Hãy chọn LiteRT để có khả năng tương thích tối đa và bộ công cụ phát triển hoàn thiện.
Có! ExecuTorch hỗ trợ tăng tốc phần cứng thông qua nhiều backend:
- GPU di động: Thông qua các delegate Vulkan, Metal hoặc OpenCL
- NPU/DSP: Thông qua các delegate dành riêng cho từng nền tảng
- Mặc định: XNNPACK để tối ưu hóa suy luận CPU
Tham khảo Tài liệu ExecuTorch để biết cách thiết lập dành riêng cho từng backend.