YOLO12: Phát hiện đối tượng tập trung vào attention
Tổng quan#
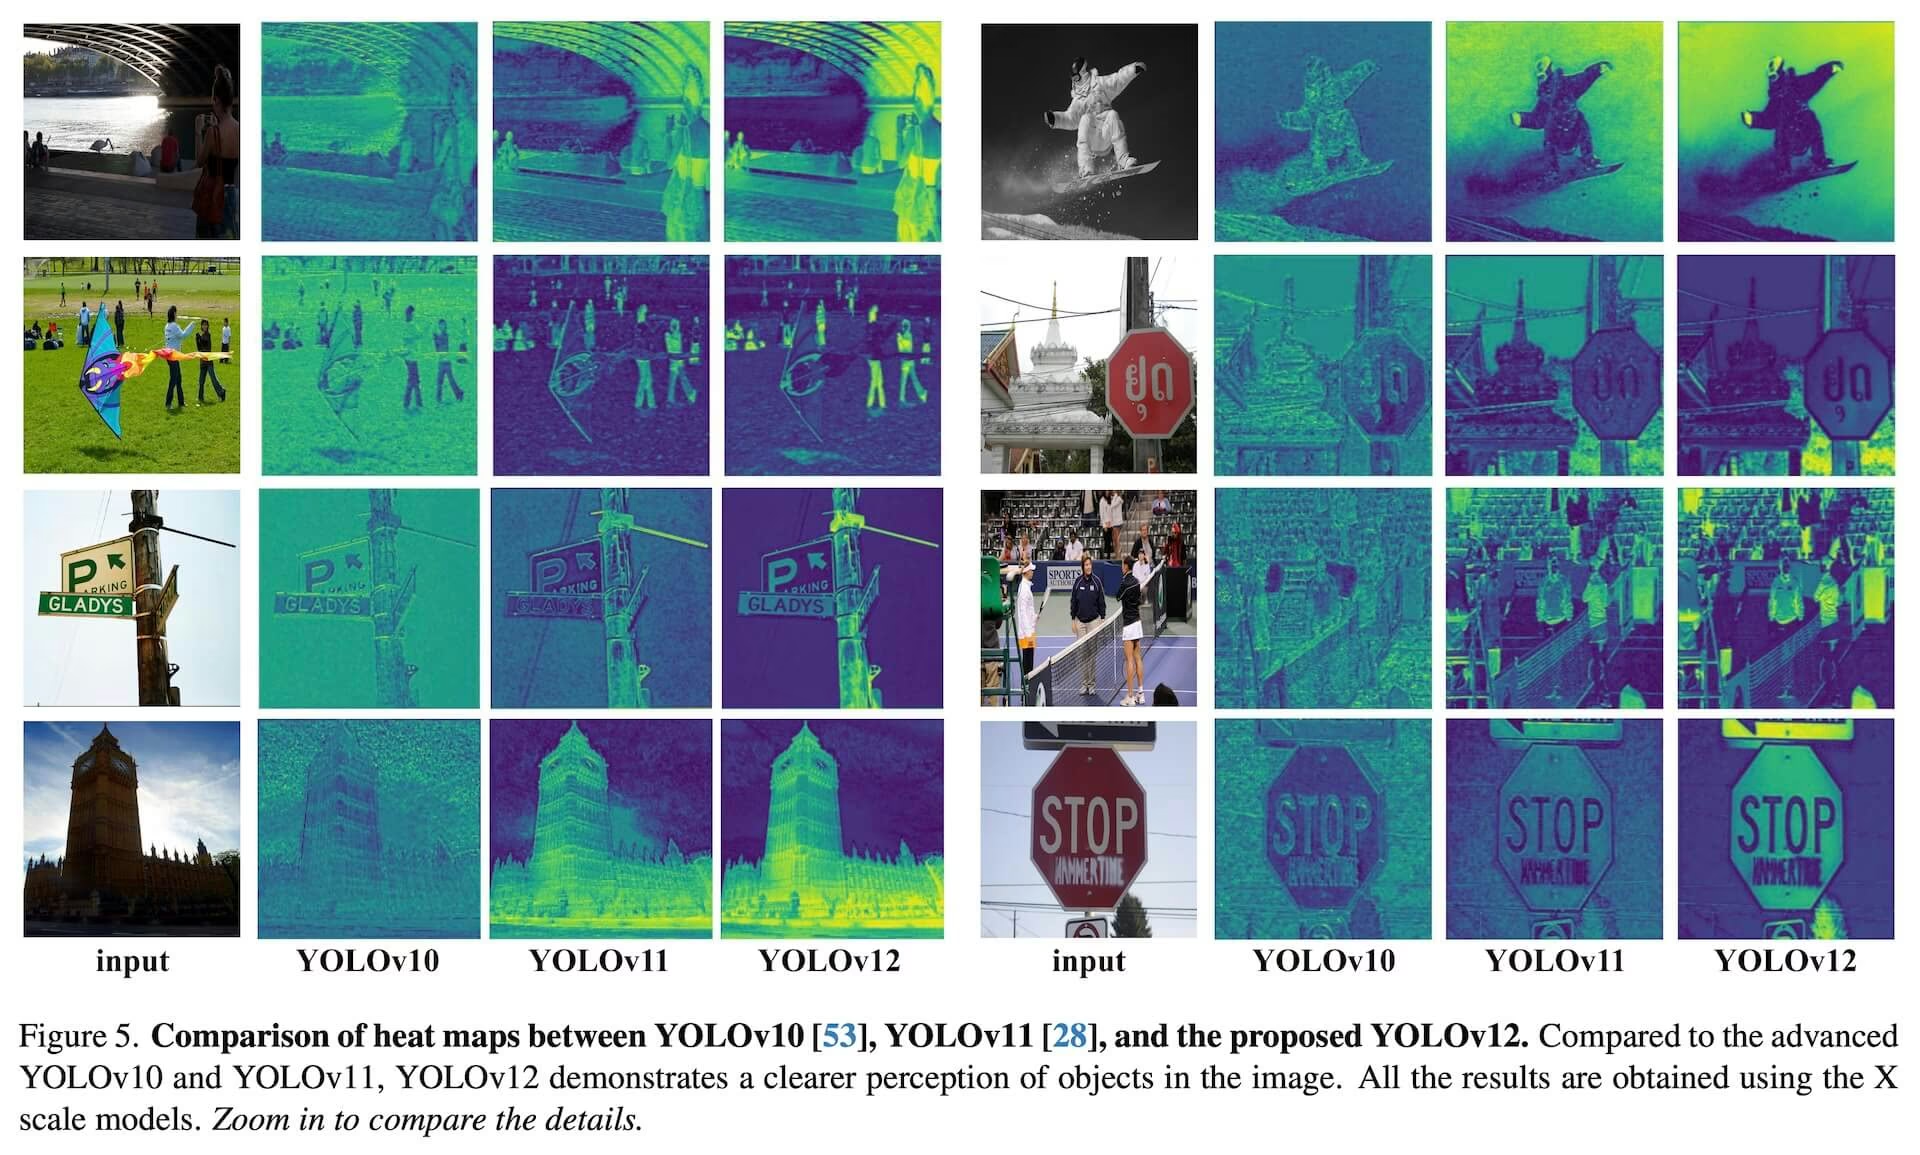
Ra mắt đầu năm 2025, YOLO12 giới thiệu kiến trúc tập trung vào attention, khác với các phương pháp dựa trên CNN truyền thống được sử dụng trong các model YOLO trước đây, nhưng vẫn duy trì tốc độ suy luận thời gian thực thiết yếu cho nhiều ứng dụng. Model đạt độ chính xác phát hiện đối tượng cao nhờ những thay đổi trong cơ chế attention và kiến trúc mạng tổng thể. Dù có những ưu điểm này, YOLO12 vẫn là bản phát hành do cộng đồng phát triển, có thể gặp tình trạng huấn luyện không ổn định, tiêu thụ nhiều bộ nhớ và thông lượng CPU thấp hơn do các khối attention nặng; vì vậy, Ultralytics khuyến nghị dùng YOLO11 hoặc YOLO26 cho hầu hết workload production.
YOLO12 chủ yếu được duy trì để phục vụ benchmark và nghiên cứu. Nếu cần huấn luyện ổn định, mức sử dụng bộ nhớ dễ dự đoán và suy luận CPU được tối ưu, hãy chọn YOLO11 hoặc YOLO26 để triển khai.
Xem: Cách sử dụng YOLO12 để phát hiện đối tượng với package Ultralytics | YOLO12 nhanh hay chậm?
Tính năng chính#
- Cơ chế Area Attention: Một phương pháp self-attention mới xử lý hiệu quả các trường tiếp nhận lớn. Phương pháp này chia feature map thành l vùng có kích thước bằng nhau (mặc định là 4), theo chiều ngang hoặc chiều dọc, tránh các phép toán phức tạp và duy trì trường tiếp nhận hiệu dụng lớn. Cách này giảm đáng kể chi phí tính toán so với self-attention tiêu chuẩn.
- Mạng tổng hợp lớp hiệu quả có kết nối dư (R-ELAN): Module tổng hợp đặc trưng được cải tiến dựa trên ELAN, thiết kế để giải quyết các thách thức trong tối ưu hóa, đặc biệt ở các model tập trung vào attention có quy mô lớn hơn. R-ELAN giới thiệu:
- Các kết nối dư ở cấp khối có scaling (tương tự layer scaling).
- Phương pháp tổng hợp đặc trưng được thiết kế lại, tạo cấu trúc dạng nút thắt cổ chai.
- Kiến trúc attention được tối ưu hóa: YOLO12 tinh giản cơ chế attention tiêu chuẩn để tăng hiệu quả và khả năng tương thích với framework YOLO. Các cải tiến bao gồm:
- Sử dụng FlashAttention để giảm thiểu overhead truy cập bộ nhớ.
- Loại bỏ mã hóa vị trí để model gọn hơn và nhanh hơn.
- Điều chỉnh tỷ lệ MLP (từ mức thông thường là 4 xuống 1.2 hoặc 2) để cân bằng tốt hơn lượng tính toán giữa các lớp attention và feed-forward.
- Giảm độ sâu của các khối xếp chồng để cải thiện quá trình tối ưu hóa.
- Sử dụng các phép tích chập (khi phù hợp) để tận dụng hiệu quả tính toán.
- Bổ sung convolution phân tách 7x7 ("position perceiver") vào cơ chế attention để mã hóa thông tin vị trí một cách ngầm định.
- Hỗ trợ tác vụ toàn diện: YOLO12 hỗ trợ nhiều tác vụ computer vision cốt lõi: phát hiện đối tượng, phân đoạn instance, phân loại ảnh, ước tính tư thế và phát hiện đối tượng định hướng (OBB).
- Hiệu quả được nâng cao: Đạt độ chính xác cao hơn với ít tham số hơn so với nhiều model trước đây, cho thấy sự cân bằng giữa tốc độ và độ chính xác đã được cải thiện.
- Triển khai linh hoạt: Được thiết kế để triển khai trên nhiều nền tảng khác nhau, từ thiết bị edge đến hạ tầng cloud.
Các tác vụ và chế độ được hỗ trợ#
YOLO12 hỗ trợ nhiều tác vụ thị giác máy tính. Bảng dưới đây cho biết các tác vụ được hỗ trợ và những chế độ vận hành (Huấn luyện, Đánh giá, Suy luận và Xuất) khả dụng cho từng tác vụ:
Chỉ weights phát hiện (yolo12n.pt, yolo12s.pt, yolo12m.pt, yolo12l.pt, yolo12x.pt) được phát hành trên ultralytics/assets. Các kiến trúc phân đoạn, phân loại, tư thế và OBB được định nghĩa trong ultralytics/cfg/models/12/, vì vậy các biến thể này hỗ trợ huấn luyện từ đầu bằng config .yaml, nhưng hiện chưa có tệp .pt pretrained cho các biến thể đó. Đối với checkpoint pretrained cho phân đoạn, tư thế, phân loại hoặc OBB, Ultralytics khuyến nghị dùng YOLO11 hoặc YOLO26.
| Loại model | Tác vụ | Weights pretrained | Huấn luyện | Validation | Suy luận | Export |
|---|---|---|---|---|---|---|
| YOLO12 | Phát hiện | ✅ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-seg | Phân đoạn | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-cls | Phân loại | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-pose | Tư thế | ❌ | ✅ | ✅ | ✅ | ✅ |
| YOLO12-obb | OBB | ❌ | ✅ | ✅ | ✅ | ✅ |
Mọi kiến trúc YOLO12 đều hỗ trợ tất cả các chế độ khi đã có checkpoint được huấn luyện. Cột Pretrained Weights chỉ cho biết Ultralytics có phát hành chính thức .pt pretrained trên ultralytics/assets hay không: với phân đoạn, tư thế, phân loại và OBB, bạn phải tự huấn luyện checkpoint từ .yaml tương ứng trước khi chạy suy luận, xác thực hoặc export.
Chỉ số hiệu năng#
YOLO12 cải thiện độ chính xác ở mọi quy mô model, với một số đánh đổi về tốc độ so với các model YOLO trước đây nhanh nhất. Dưới đây là kết quả định lượng cho tác vụ phát hiện đối tượng trên dataset kiểm định COCO:
Hiệu năng phát hiện (COCO val2017)#
| Model | kích thước (pixel) | mAPval50-95 | Tốc độ CPU ONNX (ms) | Tốc độ T4 TensorRT (ms) | params (M) | FLOPs (B) | So sánh (mAP/Tốc độ) |
|---|---|---|---|---|---|---|---|
| YOLO12n | 640 | 40.6 | - | 1.64 | 2.6 | 7.5 | +2.1%/-9% (so với YOLOv10n) |
| YOLO12s | 640 | 48.0 | - | 2.61 | 9.3 | 23.3 | +0.1%/+42% (so với RT-DETRv2) |
| YOLO12m | 640 | 52.5 | - | 4.86 | 20.2 | 70.7 | +1.0%/-3% (so với YOLO11m) |
| YOLO12l | 640 | 53.7 | - | 6.77 | 26.4 | 95.4 | +0.4%/-8% (so với YOLO11l) |
| YOLO12x | 640 | 55.2 | - | 11.79 | 59.1 | 208.9 | +0.6%/-4% (so với YOLO11x) |
- Tốc độ suy luận được đo trên GPU NVIDIA T4 với độ chính xác FP16 bằng TensorRT.
- Các phép so sánh thể hiện mức cải thiện tương đối về mAP và phần trăm thay đổi về tốc độ (số dương nghĩa là nhanh hơn; số âm nghĩa là chậm hơn). Các phép so sánh được thực hiện dựa trên kết quả đã công bố của YOLOv10, YOLO11 và RT-DETR khi có dữ liệu.
Ví dụ sử dụng#
Phần này cung cấp các ví dụ về huấn luyện và suy luận với YOLO12.
Các ví dụ dưới đây tập trung vào model YOLO12 Phát hiện (dùng để phát hiện đối tượng). Để tìm hiểu các tác vụ được hỗ trợ khác (phân đoạn, phân loại, ước tính tư thế và phát hiện đối tượng định hướng), hãy tham khảo tài liệu dành riêng cho từng tác vụ: Phân đoạn, Phân loại, Tư thế và OBB.
Có thể truyền các model *.pt pretrained (sử dụng PyTorch) và các tệp cấu hình *.yaml vào lớp YOLO() để tạo một instance model trong Python:
from ultralytics import YOLO

# Tải model YOLO12n pretrained trên COCO
model = YOLO("yolo12n.pt")

# Huấn luyện model trên dataset mẫu COCO8 trong 100 epoch
results = model.train(data="coco8.yaml", epochs=100, imgsz=640)

# Chạy suy luận bằng model YOLO12n trên ảnh 'bus.jpg'
results = model("path/to/bus.jpg")
Các cải tiến chính#
-
Trích xuất đặc trưng được nâng cao:
- Area Attention: Xử lý hiệu quả các trường tiếp nhận lớn, giúp giảm chi phí tính toán.
- Cân bằng được tối ưu hóa: Cải thiện sự cân bằng giữa lượng tính toán của attention và mạng feed-forward.
- R-ELAN: Nâng cao khả năng tổng hợp đặc trưng bằng kiến trúc R-ELAN.
-
Các cải tiến trong tối ưu hóa:
- Kết nối dư: Giới thiệu các kết nối dư có scaling để ổn định quá trình huấn luyện, đặc biệt ở các model lớn hơn.
- Tích hợp đặc trưng được tinh chỉnh: Triển khai phương pháp cải tiến để tích hợp đặc trưng trong R-ELAN.
- FlashAttention: Tích hợp FlashAttention để giảm overhead truy cập bộ nhớ.
-
Hiệu quả kiến trúc:
- Giảm số lượng tham số: Đạt số lượng tham số thấp hơn trong khi vẫn duy trì hoặc cải thiện độ chính xác so với nhiều model trước đó.
- Attention được tinh giản: Sử dụng cách triển khai attention đơn giản hơn, không cần mã hóa vị trí.
- Tỷ lệ MLP được tối ưu hóa: Điều chỉnh tỷ lệ MLP để phân bổ tài nguyên tính toán hiệu quả hơn.
Yêu cầu#
Mặc định, bản triển khai Ultralytics YOLO12 không yêu cầu FlashAttention. Tuy nhiên, FlashAttention có thể được biên dịch tùy chọn và sử dụng với YOLO12. Để biên dịch FlashAttention, cần có một trong các GPU NVIDIA sau:
- GPU Turing (ví dụ: T4, dòng Quadro RTX)
- GPU Ampere (ví dụ: dòng RTX30, A30/40/100)
- GPU Ada Lovelace (ví dụ: dòng RTX40)
- GPU Hopper (ví dụ: H100/H200)
Trích dẫn và lời cảm ơn#
Nếu sử dụng YOLO12 trong nghiên cứu, vui lòng trích dẫn công trình gốc của University at Buffalo và University of Chinese Academy of Sciences:
@inproceedings{tian2025yolov12,
  title={YOLOv12: Attention-Centric Real-Time Object Detectors},
  author={Tian, Yunjie and Ye, Qixiang and Doermann, David},
  booktitle={Advances in Neural Information Processing Systems},
  volume={38},
  pages={78433--78457},
  year={2025},
  url={https://proceedings.neurips.cc/paper_files/paper/2025/file/7103444259031cc58051f8c9a4868533-Paper-Conference.pdf}
}

@software{yolo12,
  author = {Tian, Yunjie and Ye, Qixiang and Doermann, David},
  title = {YOLO12: Attention-Centric Real-Time Object Detectors},
  year = {2025},
  url = {https://github.com/sunsmarterjie/yolov12},
  license = {AGPL-3.0}
}
Bài báo YOLO12 đã được công bố trong kỷ yếu NeurIPS 2025, với bản tiền ấn phẩm trên arXiv.
Câu hỏi thường gặp#
YOLO12 tích hợp một số cải tiến then chốt để cân bằng tốc độ và độ chính xác. Cơ chế Area Attention xử lý hiệu quả các trường tiếp nhận lớn, giảm chi phí tính toán so với self-attention tiêu chuẩn. Residual Efficient Layer Aggregation Networks (R-ELAN) cải thiện khả năng tổng hợp đặc trưng, giải quyết các thách thức tối ưu hóa trong những model lớn hơn, tập trung vào attention. Kiến trúc Attention được tối ưu, bao gồm việc sử dụng FlashAttention và loại bỏ positional encoding, tiếp tục nâng cao hiệu quả. Những tính năng này giúp YOLO12 đạt độ chính xác cao trong khi vẫn duy trì tốc độ suy luận thời gian thực cần thiết cho nhiều ứng dụng.
YOLO12 hỗ trợ nhiều tác vụ cốt lõi thuộc lĩnh vực thị giác máy tính: phát hiện đối tượng, phân đoạn instance, phân loại ảnh, ước tính tư thế và phát hiện đối tượng định hướng (OBB). Nhờ đó, YOLO12 phù hợp với nhiều lĩnh vực khác nhau, từ robotics và lái xe tự hành đến chẩn đoán hình ảnh y tế và kiểm tra công nghiệp. Lưu ý rằng hiện tại, trọng số
.ptđược huấn luyện trước chỉ được phát hành cho tác vụ phát hiện; các kiến trúc phân đoạn, ước tính tư thế, phân loại và OBB được cung cấp dưới dạng config.yamlđể huấn luyện từ đầu.YOLO12 cải thiện độ chính xác ở mọi quy mô model so với các model YOLO trước đó như YOLOv10 và YOLO11, dù có một số đánh đổi về tốc độ so với các model trước đó nhanh nhất. Ví dụ, YOLO12n cải thiện mAP +2.1% so với YOLOv10n và +1.2% so với YOLO11n trên dataset COCO val2017. So với các model như RT-DETR, YOLO12s cải thiện mAP +1.5% và tăng tốc độ +42%. Các chỉ số này cho thấy YOLO12 cân bằng tốt giữa độ chính xác và hiệu quả.
Theo mặc định, bản triển khai Ultralytics YOLO12 không yêu cầu FlashAttention. Tuy nhiên, có thể biên dịch FlashAttention theo tùy chọn và sử dụng với YOLO12 để giảm thiểu overhead truy cập bộ nhớ. Để biên dịch FlashAttention, cần một trong các GPU NVIDIA sau: GPU Turing (ví dụ: dòng T4, Quadro RTX), GPU Ampere (ví dụ: dòng RTX30, A30/40/100), GPU Ada Lovelace (ví dụ: dòng RTX40) hoặc GPU Hopper (ví dụ: H100/H200). Điều này cho phép người dùng tận dụng FlashAttention khi phần cứng hỗ trợ.
Trang này cung cấp các ví dụ sử dụng cơ bản cho việc huấn luyện và suy luận. YOLO12 sử dụng cùng các chế độ Train, Val, Predict và Export, cùng các giao diện tác vụ Segment, Classify, Pose và OBB như các model Ultralytics khác.


Bình luận69
Đặt câu hỏi, chia sẻ kết quả hoặc giúp đỡ người khác.
Zixuan-He
I try use the YOLO12-seg, but with update to lastest version (> pip install -U ultralytics) it is still showing (No such file or directory: 'YOLO12n-seg.pt) with code (yolo segment train data=data.yaml model=YOLO12n-seg.pt epochs=200 batch=16 imgsz=640 patience=25 ). theYOLO12n.pt for obj is good. Is the code changed or need other input?
1 Glenn JocherUltralytics
@Zixuan-He Answer:
The YOLO12-seg model requires using its specific configuration file. Trymodel=yolo12-seg.yamlinstead of the.ptfile to initialize training. The segmentation weights are not yet released as pretrained.ptfiles, but you can train from scratch using the YAML configuration. For details, see the YOLO12-seg documentation.2LucasGenoud
Hello, thank you for your answer ! Do you have any date estimation of when the pretrained segmentation models for YOLO12 will be available ? Thanks
- Glenn JocherUltralytics
We don't have an official release date for YOLO12-seg pretrained weights yet, but you can train segmentation models from scratch using the YOLO12-seg.yaml configuration. For updates, please monitor the YOLO12 documentation.
Thank you for your response. Great work :)
- Glenn JocherUltralytics
Thank you for your kind words! We don't have a specific release date for YOLO12-seg pretrained weights yet, but you can monitor the YOLO12 documentation for updates. The team typically announces new model releases there first. For now, training from scratch using the YOLO12-seg.yaml configuration remains the recommended approach.
dolokbutarbutar24
Here are some sample images for the healthy class. I also attached some "results" images, hopefully can give more information so you guys can help me with the project.
Pada Sen, 30 Mar 2026 pukul 15.58 Glenn Jocher @.***> menulis:
Thanks for dropping this question here so the Ultralytics team can see it; for leaf-disease datasets, mAP50-95 usually improves more from cleaner labels, balanced class counts, harder negative samples, and reviewing per-class PR/confusion outputs than from pushing loss weights alone, so I’d next tune weight_decay, momentum, warmup_epochs, lrf, translate, shear, perspective, fliplr, and close_mosaic using the hyperparameter tuning guide https://docs.ultralytics.com/guides/hyperparameter-tuning/ and performance metrics guide https://docs.ultralytics.com/guides/yolo-performance-metrics/. If you can share a few sample images, labels, and training curves here, we can suggest a tighter search space, and it’s also worth benchmarking the same split with YOLO26 https://docs.ultralytics.com/models/yolo26/ since YOLO12 is mainly maintained as a community research model.
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/19360?email_source=notifications&email_token=A23CVICPPIXOD6F3LMBB52T4TIZKDA5CNFSNUABIM5UWIORPF5TWS5BNNB2WEL2ENFZWG5LTONUW63SDN5WW2ZLOOQXTCNRTG44DGNRZUZZGKYLTN5XKOY3PNVWWK3TUUVSXMZLOOSWGM33PORSXEX3DNRUWG2Y#discussioncomment-16378369, or unsubscribe https://github.com/notifications/unsubscribe-auth/A23CVIG2PM2BD5335IFZQXT4TIZKDAVCNFSM6AAAAABXS26SR6VHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTMMZXHAZTMOI . You are receiving this because you commented.Message ID: @.*** com>
- Glenn JocherUltralytics
Thanks, that helps; from those samples I’d next verify that the
healthylabels are fully consistent and that the class counts are not skewed, then please attach a few matching image/label.txtpairs plusresults.csvandconfusion_matrix_normalized.pngso we can check whether this is a data issue rather than a YOLO12 training issue, and if you recently fixed labels please delete anylabels/*.cachefiles before retraining.
I am currently working on a project to detect cassava leaf diseases using YOLOv12. The focus of this research is to perform hyperparameter tuning and also determine the most suitable augmentation configuration to improve model performance. So far, the trained model is still hovering around the 0.5 range for the mAP@50-95 evaluation metric. Here are the hyperparameters I have used for tuning so far: epochs=100, patience=20, imgsz=1024, batch=8, optimizer='auto', lr0=0.00511, box=6.32971, cls=2.87957, dfl=2.12658, mosaic=0.25, scale=0.15, mixup=0.0, copy_paste=0.0, degrees=10.0, hsv_h=0.015, hsv_s=0.7, hsv_v=0.4.
What other strategies can I do to improve my model's performance, especially on the mAP@50-95 evaluation metric? Do you have any suggestions for other hyperparameters that need to be added to this project for tuning? I'm sure your experience and skills can answer that and help me hahaha.
- Glenn JocherUltralytics
Thanks for dropping this question here so the Ultralytics team can see it; for leaf-disease datasets, mAP50-95 usually improves more from cleaner labels, balanced class counts, harder negative samples, and reviewing per-class PR/confusion outputs than from pushing loss weights alone, so I’d next tune
weight_decay,momentum,warmup_epochs,lrf,translate,shear,perspective,fliplr, andclose_mosaicusing the hyperparameter tuning guide and performance metrics guide. If you can share a few sample images, labels, and training curves here, we can suggest a tighter search space, and it’s also worth benchmarking the same split with YOLO26 since YOLO12 is mainly maintained as a community research model.
 Clousy
在5090 32G上使用yolo12l训练模型的时候,数据量大概7万左右,batch_size=24 内存占用在24G左右,为啥速度只有2-3it/s 是哪里设置有问题?下面是训练参数: rain_args = dict( data="data.yaml", epochs=500, imgsz=640, batch=24, device=device, workers=16,
cache=False, amp=True, # --- 减少 CPU 负担 --- mosaic=0.0, # 暂时关掉 Mosaic 看看速度是否飙升 mixup=0.0, # 同上 )- Glenn JocherUltralytics
yolo12l本身是重注意力结构,吞吐会比同尺度的 CNN 系列低不少,所以你看到的2–3 it/s在batch=24下未必异常(折算大约是48–72 img/s);如果你目标是更高训练/CPU 端速度,建议直接换到更稳更快的 Ultralytics YOLO26(YOLO12 更偏研究/基准用途,见 YOLO12 文档)。想确认是不是环境/数据读取瓶颈的话,请把yolo checks输出和完整文本训练日志(含第一轮的进度条行、CUDA:/显卡名、DataLoader相关信息)贴在这里;另外你现在cache=False可能会被磁盘 IO 卡住、workers=16在部分系统上也会造成额外调度开销,建议先用下面这组参数做一次对照测试(同一数据/同一imgsz),看it/s是否明显变化:yolo checks yolo train model=yolo12l.pt data=data.yaml epochs=2 imgsz=640 batch=24 device=0 workers=8 cache=True mosaic=0.0 mixup=0.0
is there any video (tutorial) about how to classify plant disease? i'm confused about how to do it because i need guidance to do classify task
- Glenn JocherUltralytics(đã chỉnh sửa)
Yes—plant disease is just a standard image classification workflow; please follow the Ultralytics YOLO classification guide (and drop any follow-up questions here in this discussion so the Ultralytics team can see them), then try:
from ultralytics import YOLO

# ImageNet-pretrained classifier backbone (recommended starting point)
model = YOLO("yolo26n-cls.pt")

# Your dataset folder should contain train/ and val/ with one subfolder per class
model.train(data="path/to/plant_disease_dataset", epochs=50, imgsz=224)
If you share your dataset folder layout (just the directory tree) and what’s confusing you, I can point you to the exact next step.
asad121101
Hello , this new yolo12 is using what architecture in neck ? pan or fpn ? or some thing else ?
Sourabh0052
while working on classification model using YOLO12-cls and i do not make any .yaml file, just simply provide the data source path then will it work same or not
radadiavasu
I faced a problem that recently I put my model on training with yolo12x but at 98/100 epoch it stopped due to units are over on colab pro but when I start again and expect to start from 98 but it start from 1/100 instead of 98 even in results.csv I couldn't get anything. Why this problem occurs?
deldanr
When resuming a training session started with Yolov12, after the AMP check, the training session downloads a Yolov11 model to continue, which I assume is an error.
Attached is part of the log: YOLOv12l summary: 488 layers, 26,389,875 parameters, 26,389,859 gradients, 89.4 GFLOPs
Transferred 1245/1245 items from pretrained weights Freezing layer 'model.21.dfl.conv.weight' AMP: Running Automatic Mixed Precision (AMP) checks... Downloading https://github.com/ultralytics/assets/releases/download/v8.3.0/yolo11n.pt to 'yolo11n.pt'... <-- Here's the error
pvurda
Has anyone found a low-cost, low-latency way to generate a short semantic scene caption (e.g., “two people loading a van”) on top of YOLO12 detections in real time?