Caltech-101 数据集#
Caltech-101 是经典的图像分类基准数据集,包含 9,144 张图像,涵盖 101 个物体类别和一个背景类别。每个类别约有 40 到 800 张真实世界物体图像,包括动物、车辆、家居用品和人物,因此它规模紧凑,却能为物体识别模型提供具有挑战性的基准。
探索 Ultralytics Platform 上的 Caltech-101,预览样本、查看数据集统计信息,并克隆数据集用于训练。
Caltech-101 未预先划分训练集和验证集。以下训练命令会自动按训练集 80% / 验证集 20% 的比例划分数据,因此无需手动准备。
主要功能#
- Caltech-101 包含 9,144 张彩色图像,分属 101 个物体类别和一个
BACKGROUND_Google类别(共 102 个类别文件夹)。 - 这些类别涵盖了各种真实世界物体,包括动物、车辆、家居用品和人物。
- 每个类别约有 40 到 800 张图像,因此类别规模并不平衡。
- 图像尺寸不一,大多数约为 300x200 像素(中等分辨率)。
- Caltech-101 常用于评测图像分类和物体识别算法。
数据集结构#
Caltech-101 以 102 个文件夹的形式分发——每个类别一个文件夹,涵盖 101 个物体类别和一个 BACKGROUND_Google 类别——且没有预先划分训练集和验证集。开始训练时,Ultralytics 会自动划分图像,让模型无需任何手动设置即可在全部 102 个类别上进行训练:
- 类别数:102(101 个物体类别 + 1 个背景类别)
- 图像总数:9,144
- 训练集/验证集划分:自动按 80% / 20% 划分(约 7,280 张训练图像,约 1,864 张验证图像)
- 每类图像数:约 40 到 800 张(类别不平衡)
应用场景#
Caltech-101 广泛用于训练和评估图像分类和对象识别模型,包括卷积神经网络 (CNNs) 和支持向量机 (SVMs)。其类别覆盖面广,图像标注清晰,因此成为机器学习和计算机视觉研究与原型开发中常用的基准数据集。
用法#
在 Caltech-101 上训练 YOLO 模型 100 个轮次,图像尺寸设为 416。有关可用参数的完整列表,请参阅训练页面和图像分类任务指南。
from ultralytics import YOLO

# 加载模型
model = YOLO("yolo26n-cls.pt")  # 加载预训练模型(推荐用于训练)

# 训练模型
results = model.train(data="caltech101", epochs=100, imgsz=416)示例图像和标注#
Caltech-101 数据集包含各种物体的高质量彩色图像,为图像分类任务提供了结构良好的数据集。以下是该数据集中的一些图像示例:
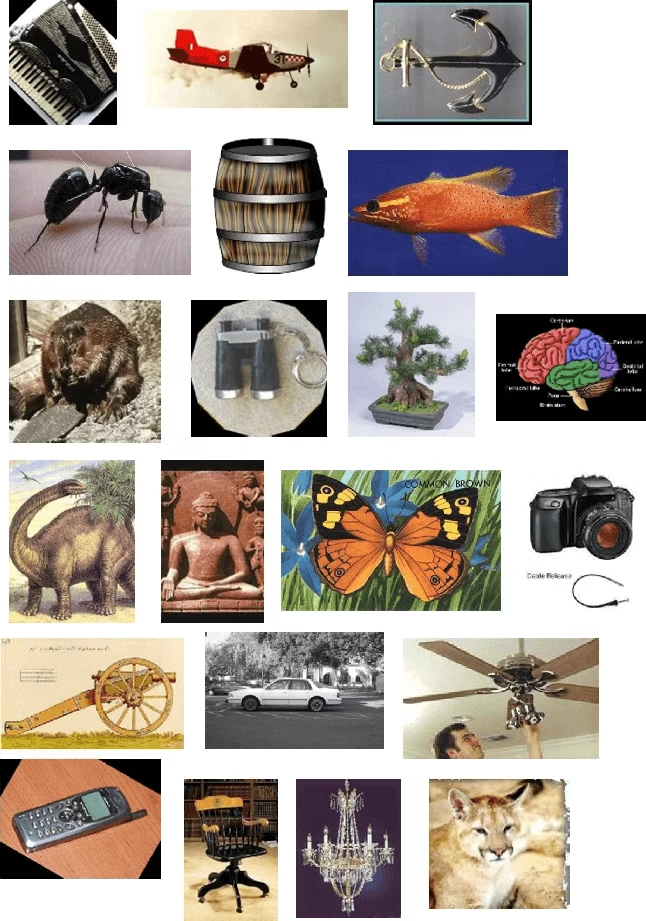
这些样例展现了 Caltech-101 类别的多样性,以及其典型的自然居中构图,因此它是训练稳健对象识别模型的优质起点。
引用与致谢#
如果你在研究或开发工作中使用 Caltech-101 数据集,请引用以下论文:
@article{fei2007learning,
  title={Learning generative visual models from few training examples: An incremental Bayesian approach tested on 101 object categories},
  author={Fei-Fei, Li and Fergus, Rob and Perona, Pietro},
  journal={Computer vision and Image understanding},
  volume={106},
  number={1},
  pages={59--70},
  year={2007},
  publisher={Elsevier}
}
我们感谢 Li Fei-Fei、Rob Fergus 和 Pietro Perona 创建并维护 Caltech-101 数据集,为机器学习和计算机视觉研究社区提供了宝贵资源。有关 Caltech-101 数据集及其创建者的更多信息,请访问 Caltech-101 数据集网站。
常见问题#
Caltech-101 数据集广泛用于训练和评测图像分类及对象识别模型。它包含 9,144 张图像,涵盖 101 个对象类别和一个背景类别,为评估卷积神经网络 (CNNs) 和支持向量机 (SVMs) 等算法提供了具有挑战性的基准。
要使用 Caltech-101 训练 Ultralytics YOLO 模型,请使用下面的代码片段。首次使用时,数据集会自动下载。参数完整列表请参阅模型的训练页面。
训练示例from ultralytics import YOLO # 加载模型 model = YOLO("yolo26n-cls.pt") # 加载预训练模型(推荐用于训练) # 训练模型 results = model.train(data="caltech101", epochs=100, imgsz=416)Caltech-101 包含 101 个对象类别和一个
BACKGROUND_Google类别,共有 102 个类别文件夹和 9,144 张图像。使用 Ultralytics 训练时,模型会学习全部 102 个类别。类别规模不均衡,每类约有 40 到 800 张图像。Caltech-101 没有预定义的数据集划分。首次训练时,Ultralytics 会自动将数据集划分为 80% 训练集和 20% 验证集,即约 7,280 张训练图像和 1,864 张验证图像,因此你无需手动创建划分。若要自行控制划分,请在训练前将图像整理到
train/和val/文件夹中。可以。Ultralytics Platform 可让你管理数据集、训练图像分类模型并部署模型,而无需编写大量代码。它是在云端运行 Caltech-101 实验的便捷方式,你还可以在我们的分类数据集概览中了解更多选项。