YOLO 模型推理
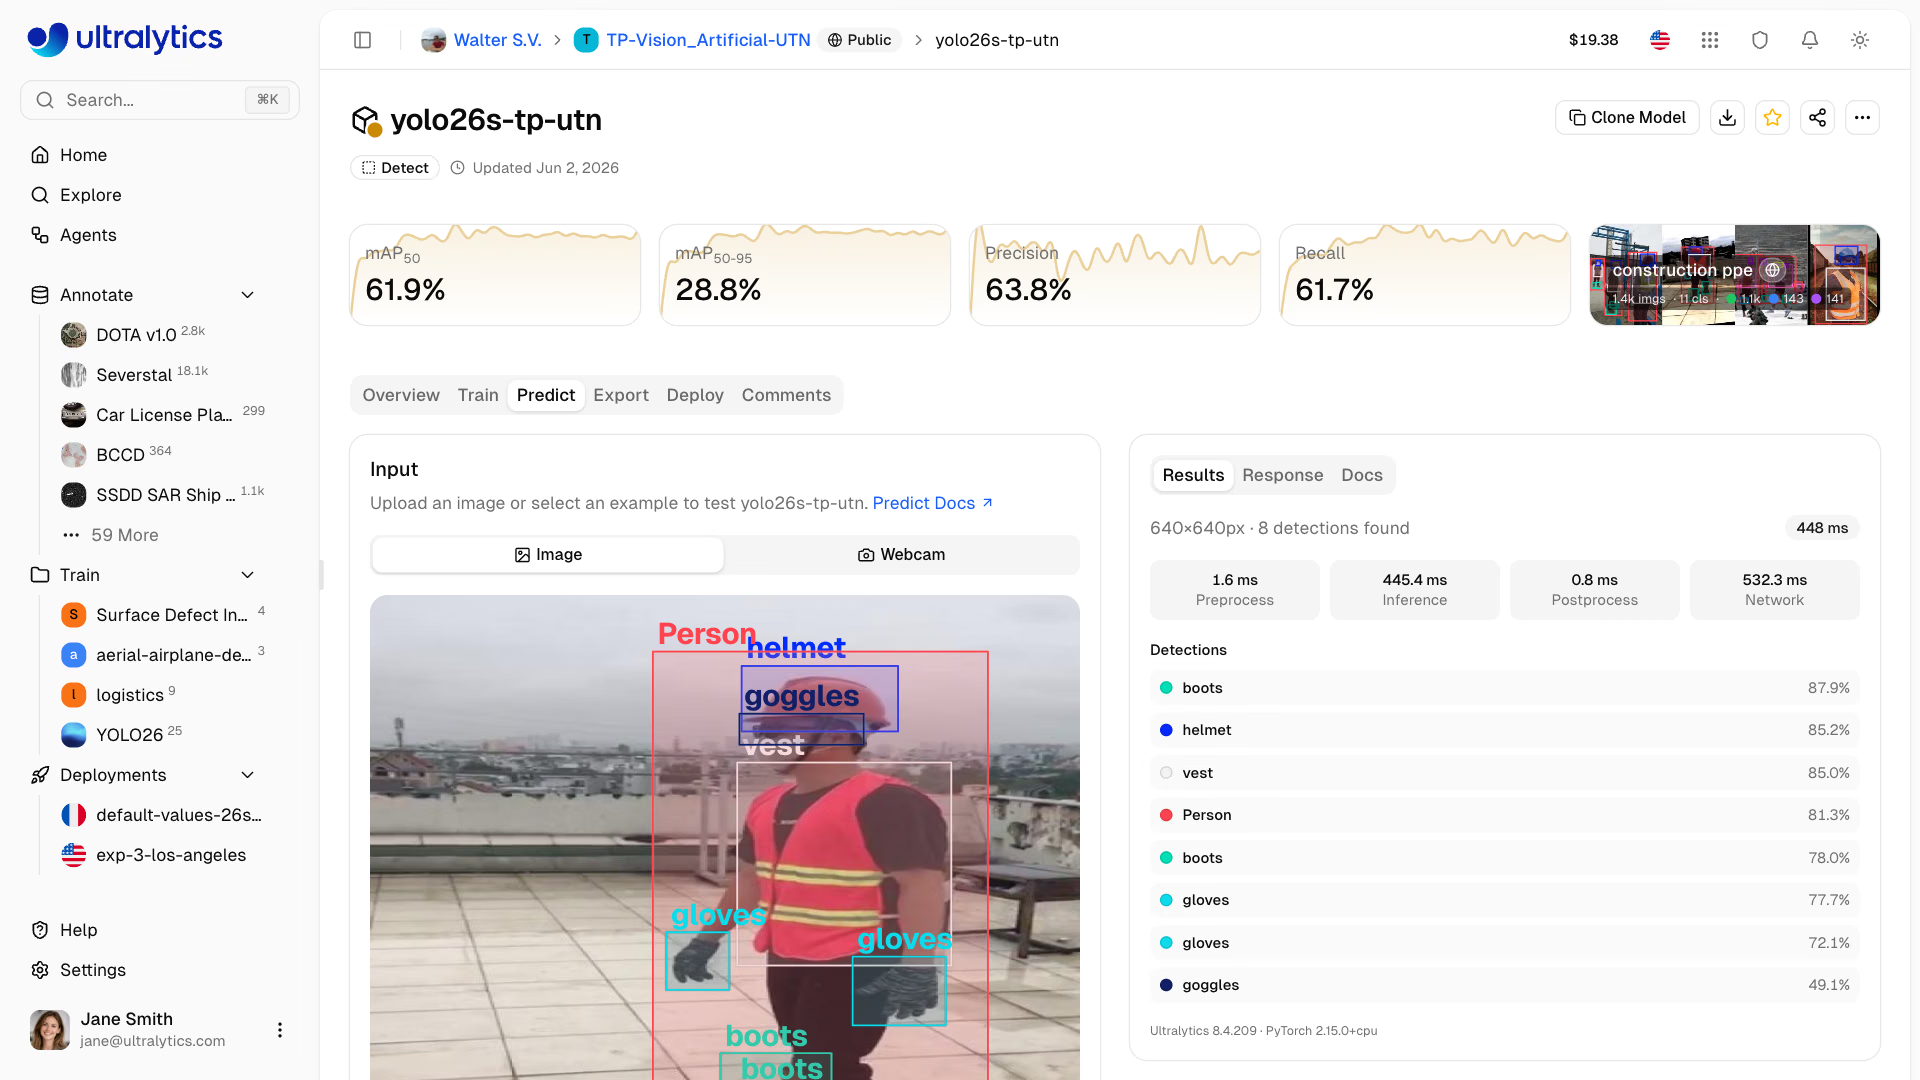
Ultralytics Platform 支持你在其 Predict 选项卡中使用自己的图像测试训练好的 YOLO 模型,然后通过共享或专用端点使用 REST 调用该模型。
预测标签页#
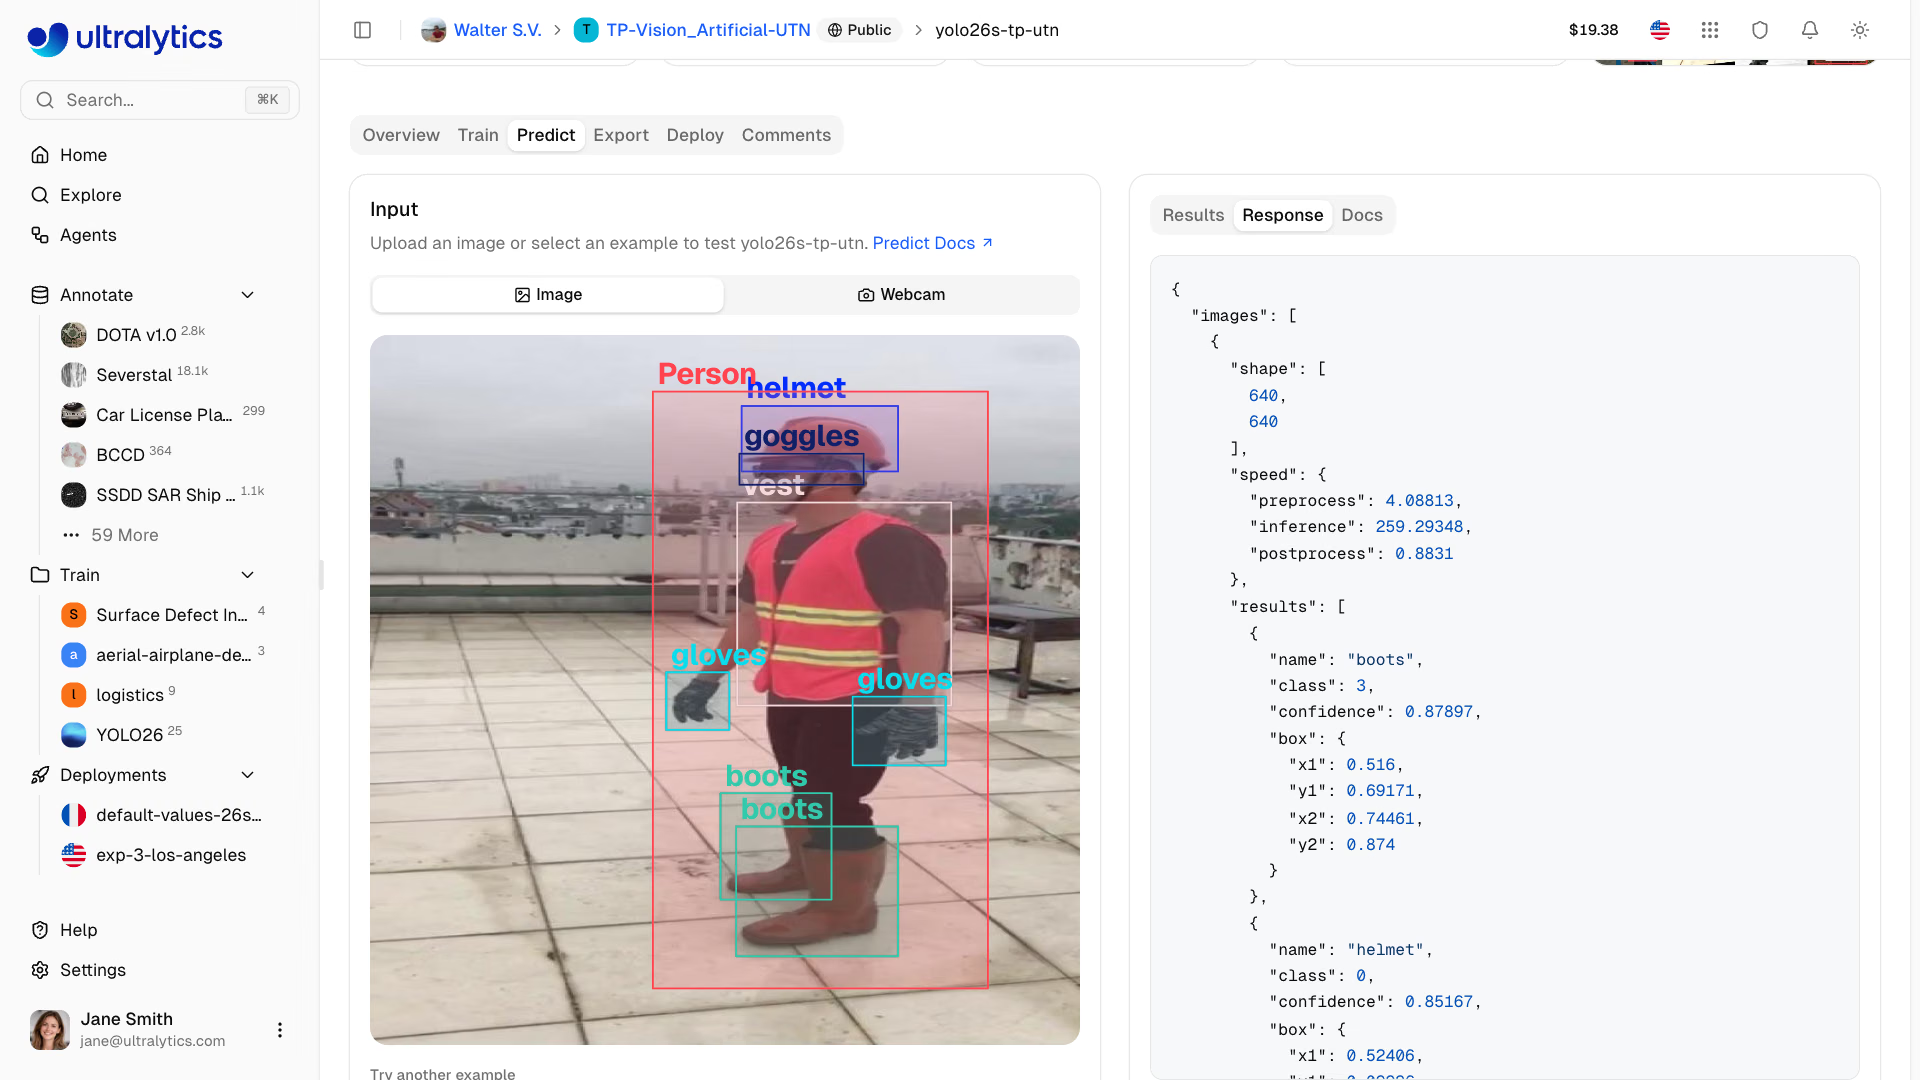
每个包含权重的模型都带有一个 Predict 标签页,可用于基于浏览器的推理:
- 转到你的模型
- 点击 预测 标签页
- 上传图像、使用示例图像,或打开网络摄像头
- 查看任务专属的叠加层、预测摘要、耗时和原始响应
没有权重的模型会显示空状态——请先训练模型或上传权重。
输入方式#
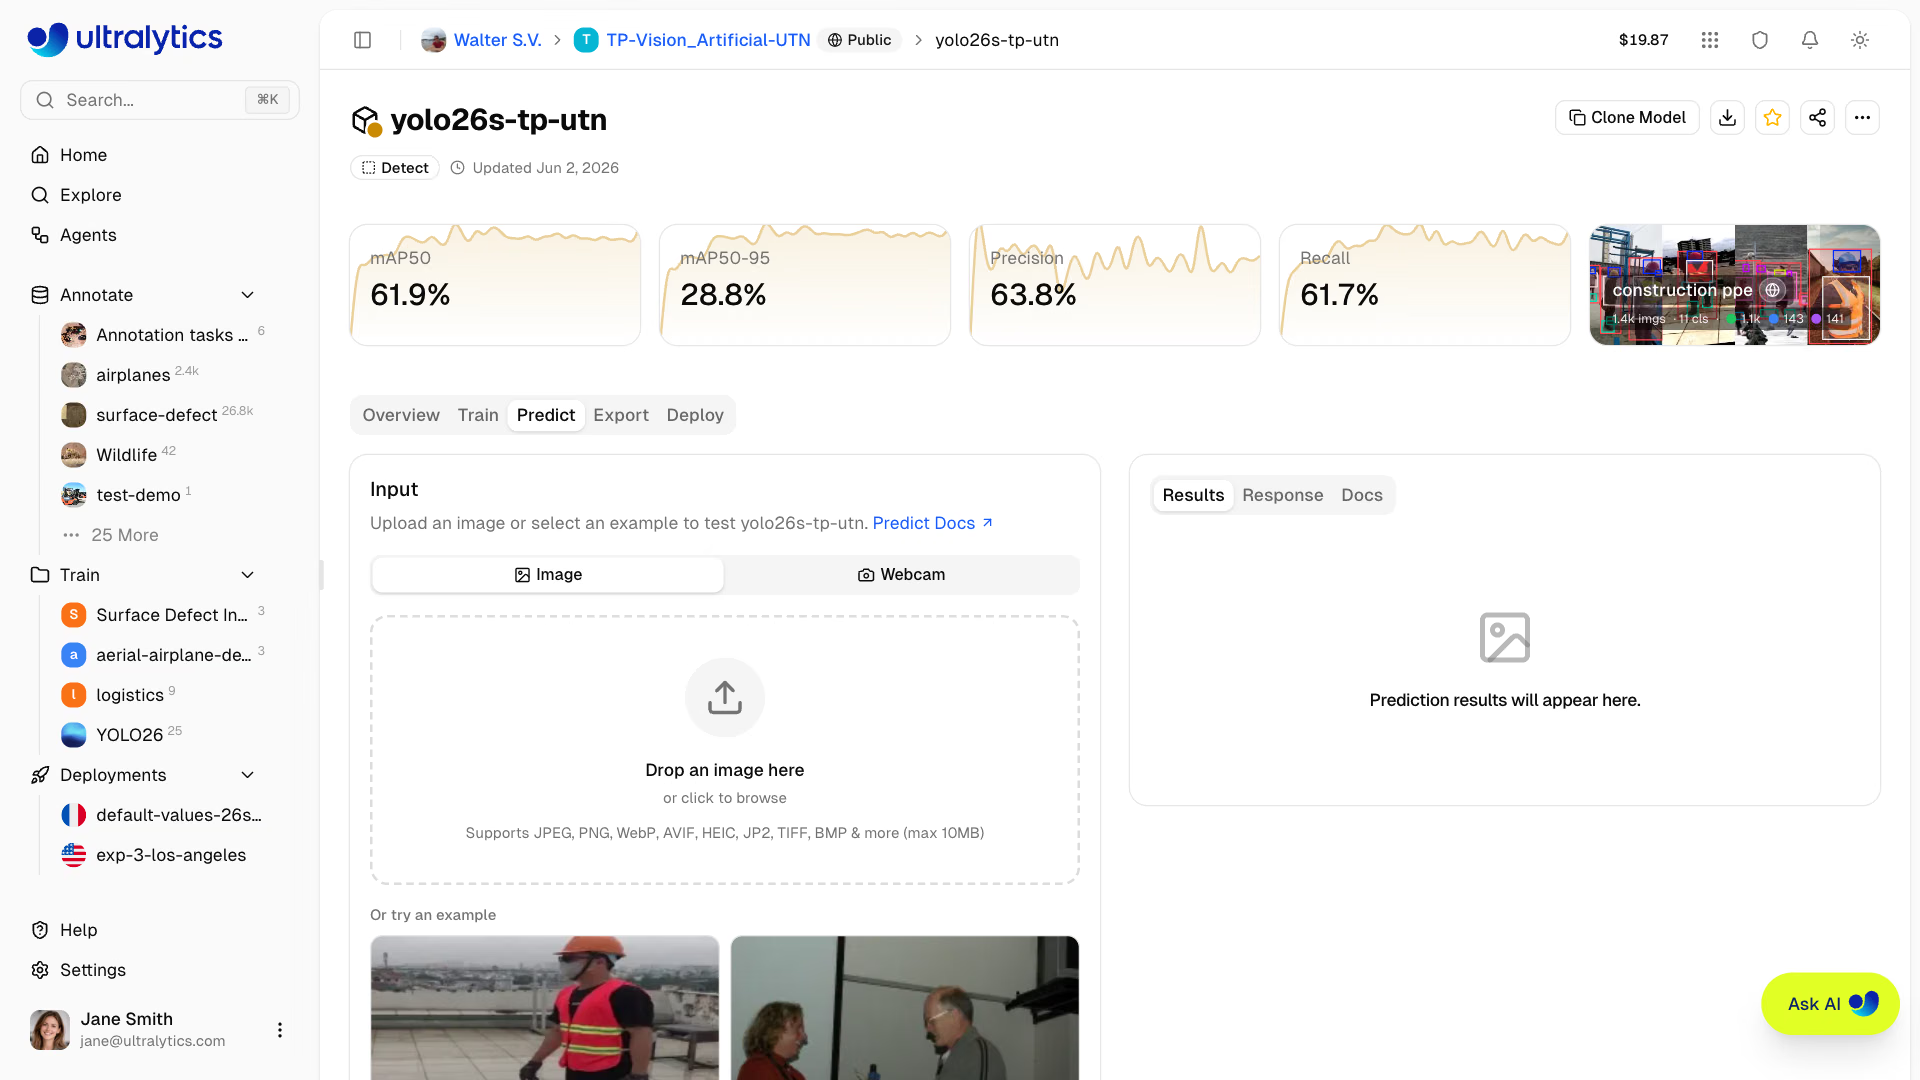
预测面板支持多种输入方式:
| 方法 | 说明 |
|---|---|
| 上传图像 | 拖放或点击以上传图像或 PDF |
| 示例图像 | 点击内置示例(数据集图像或默认示例) |
| 网络摄像头捕获 | 实时摄像头画面,支持捕获单帧 |
| IP 摄像头 | 自有部署上的 RTSP 或 RTSPS 流 |
上传图像#
拖放图像或点击以上传:
- 支持的格式:JPEG、PNG、WebP、AVIF、HEIC、JP2、TIFF、BMP 和 PDF(将 PDF 的第一页渲染为图像并按图像进行预测)
- 最大大小:10 MB
- 自动推理:上传后自动显示结果
上传图像、选择示例或捕获网络摄像头画面时,预测面板会自动运行推理。无需点击按钮。
上传前,如果图像最长边超过所选 Image Size,面板会将图像缩小到该尺寸;如果 JPEG 比原图小(例如 PNG 截图),则会发送 JPEG 而非原图,并请求归一化坐标。这样可以加快浏览器测试;你自行发送的请求不会调整尺寸。浏览器无法直接显示的格式(例如 iPhone HEIC 照片或 Chrome 中的 TIFF)会在浏览器中转换,因此预览效果与其他图像相同,且会以相同方式调整尺寸。HEIC、HEIF 和 BMP 始终以 JPEG 格式发送。
示例图像#
预测面板最多显示来自模型关联数据集的四张示例图像,优先使用 val 切分,然后是 test,最后是 train。如果没有关联数据集,则使用默认示例:
| 图像 | 内容 |
|---|---|
bus.jpg | 包含车辆的街景 |
zidane.jpg | 包含人物的体育场景 |
对于 OBB 模型,则会改为显示船只和机场的航拍图像。
页面加载时会预加载示例图像,因此点击示例即可近乎即时地运行推理,无需等待下载。
网络摄像头#
在图像区域上方选择 网络摄像头,即可启动实时摄像头画面:
- 出现提示时,授予摄像头权限
- 点击视频预览以捕获画面
- 系统会自动对捕获的画面运行推理
- 点击 返回网络摄像头,即可回到实时画面
在你自有部署的 Predict 选项卡中,网络摄像头会持续运行推理。请参阅实时摄像头推理。
查看结果#
推理结果会根据模型任务显示相应输出:边界框、掩码、关键点、旋转框、分类分数、语义覆盖区域或深度图。有可用数据集类别颜色时,对象结果会使用这些颜色。面板还会显示预处理、推理、后处理和网络耗时。
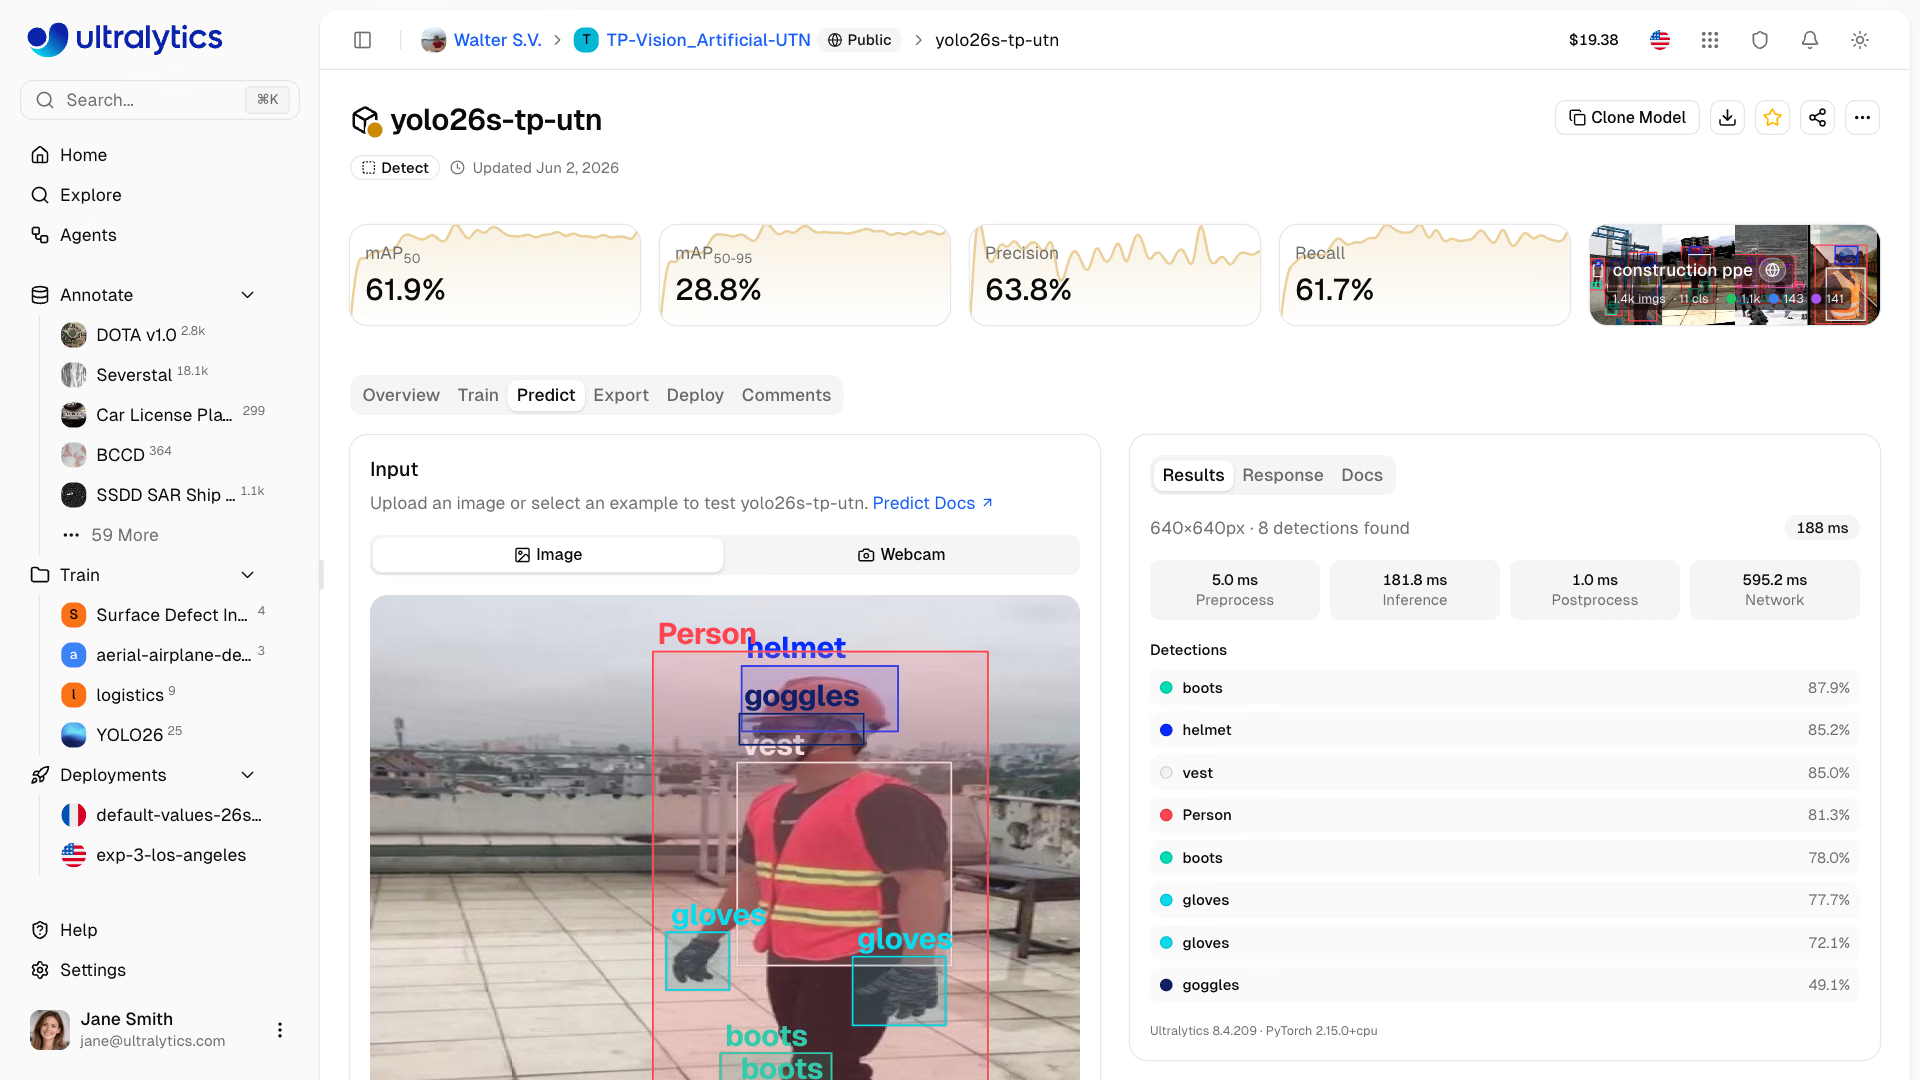
结果面板会显示:
| 字段 | 说明 |
|---|---|
| 结果摘要 | 逐项检测结果列表;对于分类和语义模型,则显示排名前 5 的类别 |
| 速度统计 | 预处理、推理、后处理和网络耗时(毫秒) |
| 版本 | Ultralytics 和 PyTorch 版本,以及适用时显示的深度范围或掩码大小 |
| JSON 响应 | 代码块中的原始 API 响应,其中的 base64 映射数据已省略 |
显示结果后,预览上方会出现两个控件:点击图像可在保留叠加层的情况下放大图像;使用下载按钮可保存当前结果的标注 JPEG 图像。
将鼠标悬停在检测结果的行上,可突出显示对应的框;将鼠标悬停在图像中的框上,可突出显示对应的行并在列表中滚动到该行。如果结果超过 10 个,图像中的框将不显示标签,以免标签遮挡目标;列表会显示每个结果的名称,放大图像则会保留标签。在宽屏上,结果卡片最高可扩展至与输入卡片等高,因此即使结果列表很长(例如拥挤的零售货架),也能保持易读。
模型的 Predict 选项卡每张图像最多返回 1,000 个结果。RT-DETR 模型最多返回 300 个结果,即其解码器中的查询数量。
推理参数#
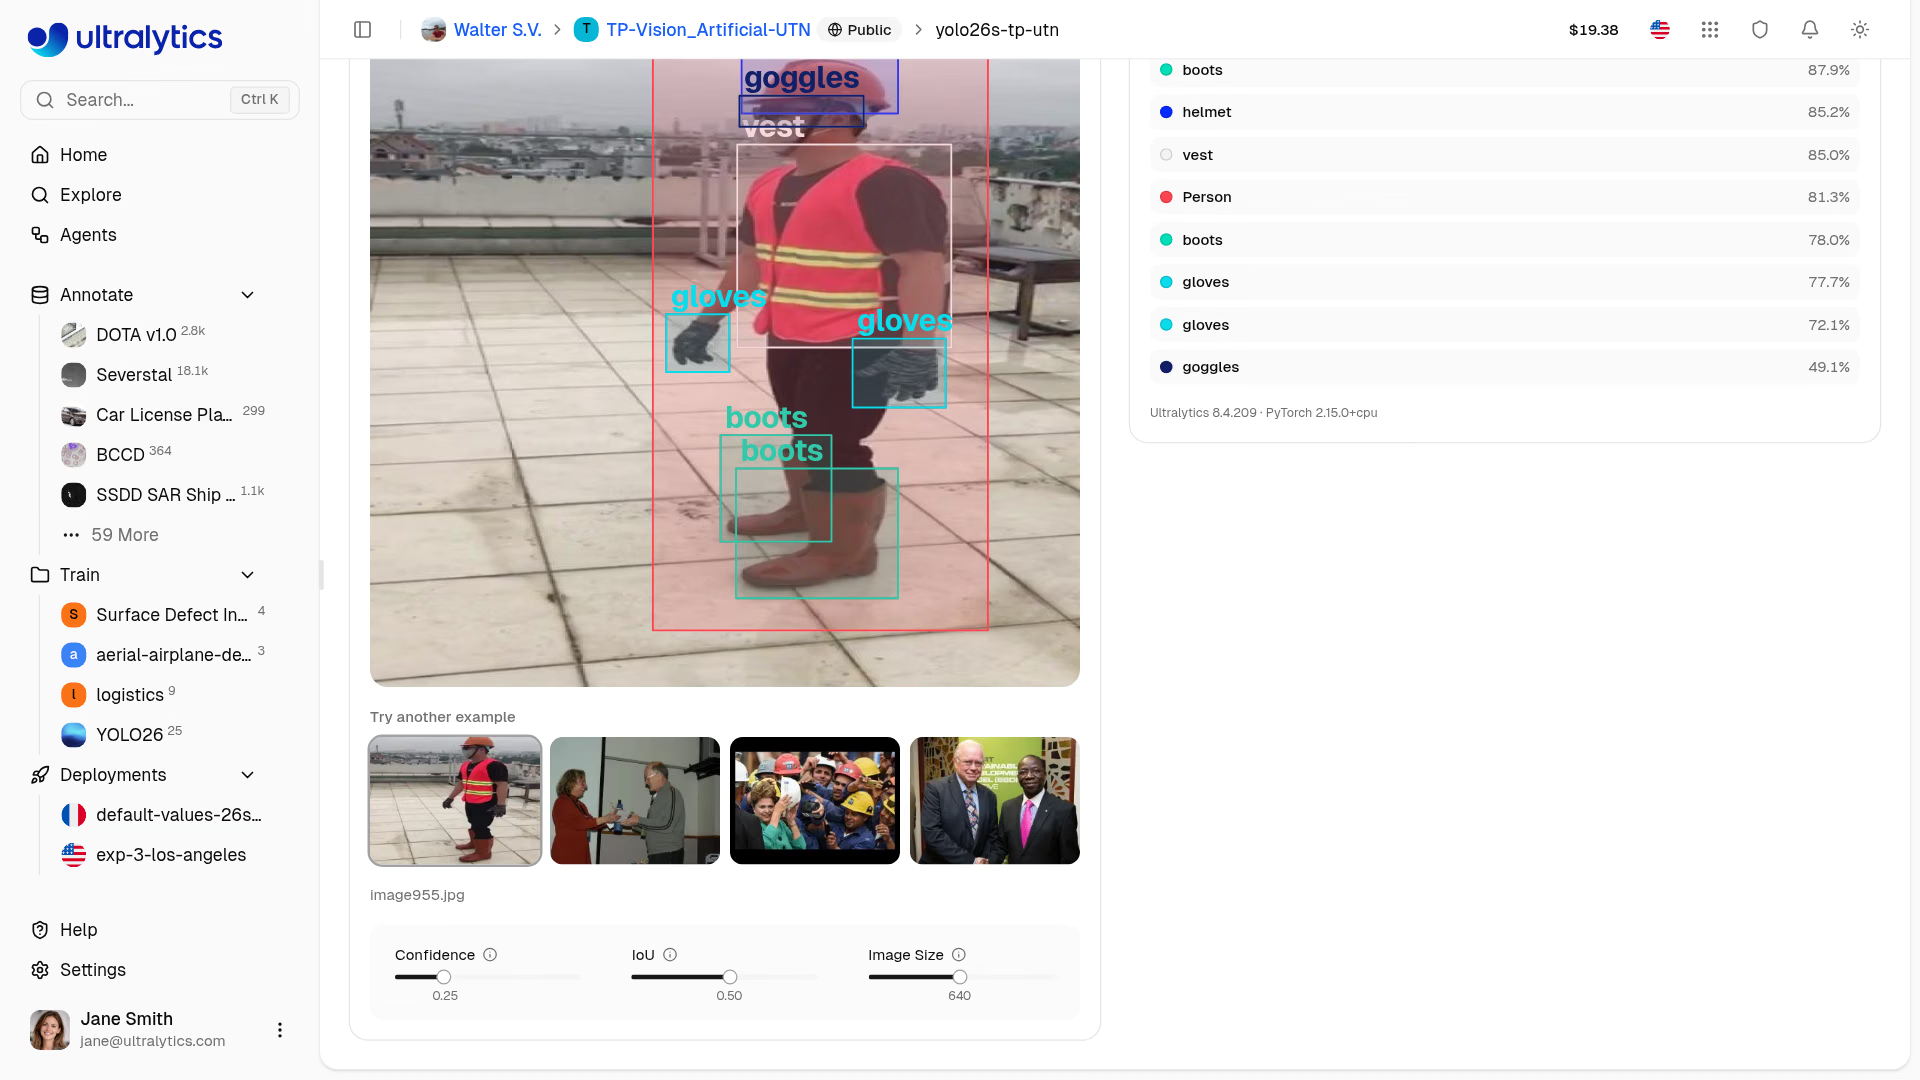
使用图片下方的三个滑块调整推理行为(深度模型仅显示 Image Size):
| 参数 | 范围 | 默认值 | 说明 |
|---|---|---|---|
| 置信度 | 0.01 – 1.0,步长为 0.01 | 0.25 | 最低置信度阈值 |
| IoU | 0.0 – 0.95,步长为 0.01 | 0.5 | NMS IoU 阈值 |
| 图像尺寸 | 32 – 1280,步长为 32 | 640 | 输入缩放尺寸 |
更改任何参数后,都会在 500ms 防抖间隔后,自动对当前图片重新运行推理。无需重新上传。
置信度阈值#
按置信度分数筛选预测结果:
- 较高 (0.5+):预测结果更少,但确定性更高
- 较低 (0.1-0.25):预测结果更多,也会包含一些噪声
- 默认 (0.25):适用于大多数场景的均衡设置
IoU 阈值#
设置非极大值抑制 (NMS),该方法会移除与置信度更高的框的交并比 (IoU)超过此阈值的框:
- 较高 (0.6+):允许更多重叠框
- 较低 (0.3-0.4):更积极地抑制重叠检测结果
- 默认值 (0.5):适用于大多数使用场景的均衡 NMS 行为
部署预测#
每个运行中的专用端点都会在其部署页面中包含一个 Predict 选项卡。此选项卡使用部署自身的推理服务,而不是共享预测服务,因此你可以直接在浏览器中测试已部署的端点。
对于处于就绪状态的端点,已处理的图片也会显示在监控选项卡中。示例和汇总图表是轻量、临时的内存数据;停止、重启、重新部署、调整大小或替换模型都可能清除这些数据。将示例保存到数据集即可保留。
实时摄像头推理#
在你拥有的部署的 Predict 选项卡中,选择 网络摄像头 或 IP 摄像头,即可在实时视频上运行端点:
| 数据源 | 工作原理 |
|---|---|
| 网络摄像头 | 浏览器逐帧向端点发送画面,并将每次推理结果绘制在实时画面上 |
| IP 摄像头 | 输入 rtsp:// 或 rtsps:// URL(包括任何凭据),然后点击 连接;端点会读取摄像头画面,并将每次推理结果流式传回 |
实时推理使用端点绑定的 API 密钥,只有工作区所有者可以加载该密钥;对于其他团队成员,网络摄像头会逐帧捕获单张图像,且 IP 摄像头不可用,与模型的 Predict 选项卡相同。IP 摄像头必须可从互联网访问:端点会拒绝 192.168.x.x 等本地网络地址。每次推理结果对应最新画面,因此推理跟不上时会跳过画面。滑块更改会应用于下一帧网络摄像头画面,并重启 IP 摄像头流。浏览器选项卡隐藏时,实时推理会暂停。点击预览即可捕获画面;点击 断开连接 可停止查看 IP 摄像头。
后台摄像头#
配备自定义 CPU 和内存规格的端点可以持续监控一个 IP 摄像头,即使你断开连接或关闭页面也不受影响。连接的摄像头开始显示结果后,开启 在后台持续运行。部署页眉会显示 摄像头已开启,结果会作为临时示例和预测统计信息显示在监控选项卡中。
- 设置:背景摄像头始终使用默认置信度 (0.25)、IoU (0.5) 和模型的训练图像尺寸;这些滑块不适用于背景摄像头。
- 费用:后台摄像头在端点的预热实例上运行,不额外收费;无论摄像头开启还是关闭,都按小时收取运行时长费用。
- 更改:开启、关闭摄像头或切换到另一台摄像头都会重启端点实例。端点会保持就绪状态,但临时监控数据会被清除。
- 停止:关闭开关即可。断开连接或关闭页面不会停止摄像头;将端点调整为默认规格会移除后台摄像头。如果摄像头离线,端点会持续尝试重新连接。
- 端点生命周期:停止端点会停止摄像头并终止相关费用;重新启动端点后,会恢复已保存的摄像头。
默认规格端点支持实时网络摄像头和 IP 摄像头推理,但不提供后台选项。要通过 API 保存后台摄像头,请使用部署的 camera 操作。
从 API 流式接收结果#
将 RTSP 或 RTSPS URL 作为 source 发送到专用端点 URL,并在 Accept: text/event-stream 标头中提供相应内容,即可通过服务器发送事件接收结果:
curl -N -X POST \
  "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Accept: text/event-stream" \
  -F "source=rtsp://user:password@camera.example.com:554/stream" \
-F "conf=0.25"每个帧事件都会在响应结构中携带 images,其中包含归一化 (0-1) 坐标、该帧的 preview JPEG 数据 URL,以及包含任务和类别名称的 metadata。只有 conf、iou 和 imgsz 会生效;流式传输端点的后台摄像头 URL 时使用默认设置。仅包含 status 的事件不携带画面;包含 error 消息的事件(摄像头无法读取,或端点无法运行模型)会终止流。端点重启或请求达到时限时,流也会关闭;如果流结束时没有错误,请使用退避策略重新连接。Platform API 的部署预测路由和 SDK 不支持流式传输;请使用绑定的 API 密钥,将摄像头请求发送到端点 URL。摄像头 source 若未携带标头,则会返回 400。
专用端点 API#
模型 Predict 选项卡中的 API Docs 卡片包含 Python、JavaScript 和 cURL 请求示例,其中已填入滑块当前设置的置信度、IoU 和图像尺寸。在部署模型之前,URL 和密钥都是占位符——代码选项卡旁边的 Deploy 按钮会跳转到模型的 Deploy 选项卡。部署后,部署页面的 Predict 选项卡中的 Docs 结果选项卡会填入该端点的 URL,并为工作区所有者填入绑定的 API 密钥,供你复制并运行。
身份验证#
在请求中包含你的 API 密钥:
Authorization: Bearer YOUR_API_KEY如果要从自己的脚本、笔记本或应用运行推理,请包含 API 密钥。你可以在 Settings > API Keys 中生成密钥。专用端点只接受创建该端点时使用的那个密钥;共享模型 API 接受工作区中的任何有效密钥,公开模型也接受匿名请求。
端点#
专用端点通过各自的 URL 接收请求:
POST https://YOUR_DEPLOYMENT_URL.run.app/predict共享推理通过 Platform API 使用模型的完整路径:
POST https://platform.ultralytics.com/api/models/{owner}/{project}/{model}/predict两者都接受相同的 multipart/form-data 请求体,并返回相同结构的响应。使用 Python SDK 时,共享推理使用 client.models.predict(owner, project, model, body=...),专用部署使用 client.deployments.predict(owner, deployment, body=...)。这两种 SDK 方法都会调用 Platform API,因此会受到其速率限制和请求大小限制。要避免这些限制,请按请求部分所示,直接向专用端点 URL 发送请求。共享推理示例:
from ultralytics_platform import Platform

client = Platform()  # reads ULTRALYTICS_API_KEY
with open("image.jpg", "rb") as f:
results = client.models.predict("acme-vision", "inspection", "v3", body={"file": f, "conf": 0.25})请求#
import requests

url = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
headers = {"Authorization": "Bearer YOUR_API_KEY"}
data = {"conf": 0.25, "iou": 0.5, "imgsz": 640}

with open("image.jpg", "rb") as image_file:
    response = requests.post(url, headers=headers, files={"file": image_file}, data=data)
print(response.json())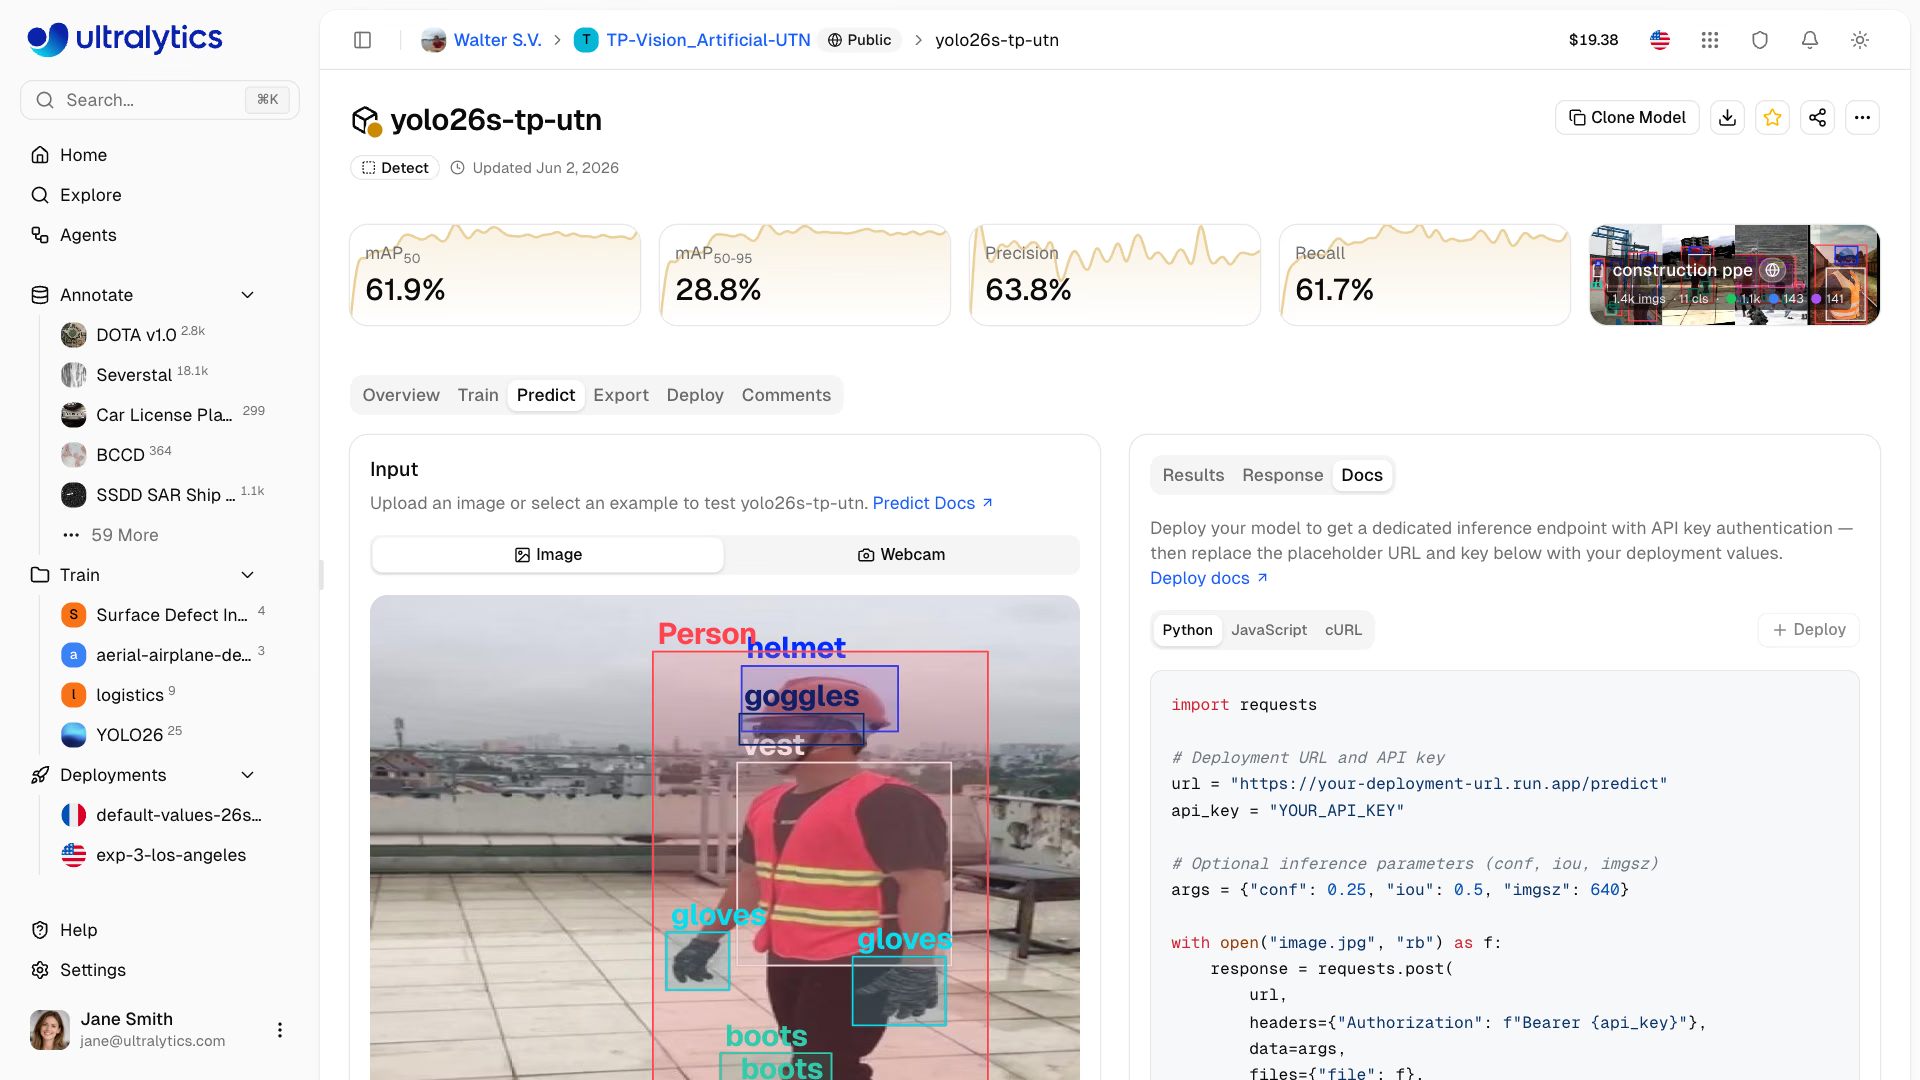
请求参数#
| 参数 | 类型 | 默认值 | 范围 | 说明 |
|---|---|---|---|---|
file | 文件 | - | - | 图像或视频文件(必需,除非设置了 source) |
conf | 浮点数 | 0.25 | 0.01 – 1.0 | 最低置信度阈值 |
iou | 浮点数 | 0.5 | 0.0 – 0.95 | NMS IoU 阈值 |
imgsz | 整数 | - | 32 – 1280 | 输入图像尺寸(像素);默认使用模型的训练尺寸(如果不可用,则为 640) |
normalize | 布尔值 | false | - | 以 0 – 1 的范围返回边界框坐标 |
decimals | 整数 | 5 | 0 – 10 | 坐标值的小数精度 |
vid_stride | 整数 | 1 | ≥ 1 | 每隔 N 帧预测一次视频;对图像无效 |
bits | 整数 | 8 | 8, 12, 16 | 深度图量化,仅适用于深度模型 |
source | 字符串 | - | - | 图像 URL 或 base64 字符串(替代 file);通过 Platform API 发送时最多 4,096 个字符 |
响应#
{
    "images": [
        {
            "shape": [1080, 1920],
            "results": [
                {
                    "class": 0,
                    "name": "person",
                    "confidence": 0.92,
                    "box": { "x1": 100, "y1": 50, "x2": 300, "y2": 400 }
                },
                {
                    "class": 2,
                    "name": "car",
                    "confidence": 0.87,
                    "box": { "x1": 400, "y1": 200, "x2": 600, "y2": 350 }
                }
            ],
            "speed": {
                "preprocess": 1.2,
                "inference": 12.5,
                "postprocess": 2.3
            }
        }
    ],
    "metadata": {
        "imageCount": 1,
        "functionTimeAlive": 1284.51,
        "functionTimeCall": 0.018,
        "task": "detect",
        "version": {
            "ultralytics": "8.x.x",
            "torch": "2.6.0",
            "torchvision": "0.21.0",
            "python": "3.13.0"
        }
    }
}
响应字段#
| 字段 | 类型 | 说明 |
|---|---|---|
images | 数组 | 已处理图像的列表,每个已处理的视频帧对应一个条目 |
images[].shape | 数组 | 图像尺寸 [高度, 宽度] |
images[].results | 数组 | 检测结果列表 |
images[].results[].class | 整数 | 类别索引(整数 ID) |
images[].results[].name | 字符串 | 类别名称 |
images[].results[].confidence | 浮点数 | 检测置信度 (0-1) |
images[].results[].box | 对象 | 边界框坐标 |
images[].semantic_mask | 对象 | 逐像素类别图,仅适用于语义模型 |
images[].depth | 对象 | 逐像素深度图,仅适用于深度模型 |
images[].speed | 对象 | 处理耗时(毫秒) |
metadata | 对象 | 图像数量、服务耗时、任务和版本 |
特定任务的响应#
响应格式因任务而异:
{
  "class": 0,
  "name": "person",
  "confidence": 0.92,
  "box": {"x1": 100, "y1": 50, "x2": 300, "y2": 400}
}速率限制#
共享模型 API 对每个 API 密钥、已登录的调用方或匿名 IP 的限制均为 20 次请求/分钟。Platform 部署预测路由(POST /api/deployments/{owner}/{deployment}/predict)也有相同限制。触发限流时,API 会返回 429,并附带 Retry-After 请求头。请查看完整的速率限制参考,了解所有端点类别。
错误处理#
常见错误响应:
| 代码 | 消息 | 解决方案 |
|---|---|---|
| 400 | 图像无效 | 检查文件格式,或确认模型是否具有训练权重 |
| 401 | 未授权 | 验证 API 密钥 |
| 404 | 未找到模型 | 检查所有者、项目和模型名称 |
| 413 | 输入过大 | 将文件大小减小到端点限制以下 |
| 429 | 请求频率受限 | 等待后重试,或直接向专用端点发送请求 |
| 500 | 服务器错误 | 重试请求 |
| 503 | 服务不可用 | 预测服务正在启动或无法访问;请稍等片刻后重试 |
常见问题#
两种推理方式都接受视频文件:
- 专用端点可直接接受视频文件。支持的格式(每个请求最多 32 MB):ASF、AVI、GIF、M4V、MKV、MOV、MP4、MPEG、MPG、TS、WEBM、WMV。系统会针对每个已处理帧返回结果,单个请求最长可运行 1 小时。详情请参阅专用端点。
- 共享推理(
POST /api/models/{owner}/{project}/{model}/predict)使用相同的预测服务并接受相同的视频格式,但请求大小限制约为 4.5 MB,约 30 秒后会超时,因此只适用于短视频片段。浏览器的 预测 选项卡只会上传图像;处理视频文件请使用专用端点,使用网络摄像头或 IP 摄像头请使用实时摄像头推理。
深度模型不接受视频文件。
在 Predict 选项卡中,预览图上方的下载按钮会将当前结果保存为带标注的 JPEG。API 本身会返回 JSON 预测结果。若要将这些结果可视化:
- 使用预测结果在本地绘制边界框
- 使用 Ultralytics 在本地运行模型,并使用
save()保存带标注的结果(或使用plot()获取数组):
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
results = model("image.jpg")
results[0].save("annotated.jpg")
完整的结果 API 和可视化选项请参阅 预测模式文档。
- 预测选项卡限制:10 MB
- 共享推理 API 限制:每个请求约 4.5 MB,包括通过 Python SDK 发送的请求
- 专用端点限制:直接发送到端点 URL 的每个请求为 32 MB
如果图片最长边超过所选的
Image Size,浏览器会在保持纵横比的同时缩小图片,但浏览器无法解码的图片除外(上传图片)。你自行发送的请求不会调整尺寸,因此超过限制的请求会被413拒绝。当前 API 每个请求处理一张图像。批量处理时:
- 为每张图像分别发送请求
- 适当时,将请求分配到多个专用端点
- 对大型批次使用本地推理
使用 Python 进行批量推理import concurrent.futures import requests url = "https://YOUR_DEPLOYMENT_URL.run.app/predict" headers = {"Authorization": "Bearer YOUR_API_KEY"} images = ["img1.jpg", "img2.jpg", "img3.jpg"] def predict(image_path): with open(image_path, "rb") as f: return requests.post(url, headers=headers, files={"file": f}).json() with concurrent.futures.ThreadPoolExecutor(max_workers=4) as executor: results = list(executor.map(predict, images))


评论2
提出问题、分享结果,或帮助其他人。
 Bob Ass
مدلی که عکس از کالاهای مغازه خوراکی میگیرد عکس بعدی را میگیرد و کم یا زیاد شدن کالاها و تعداد و نامشان را میگوید
 Paula DerrengerUltralytics
بله، میتوانید چنین سامانهای را با YOLO بسازید: مدل را با تصاویر برچسبخوردهٔ کالاهای فروشگاه آموزش دهید تا هر نوع کالا را تشخیص دهد؛ سپس هر عکس را جداگانه پردازش کنید و تعداد هر کالا را با عکس قبلی مقایسه کنید تا نام کالا و میزان افزایش یا کاهش آن گزارش شود. بخش مقایسه و گزارش تغییرات باید در کد برنامهٔ شما پیادهسازی شود؛ خروجی تشخیص بهتنهایی این کار را انجام نمیدهد. فقط کالاهای قابلمشاهده قابلشمارشاند، نه اقلام پنهان پشت آنها. برای شروع، راهنمای مدیریت موجودی با YOLO را ببینید. منظورتان تشخیص دستههایی مثل نوشابه و بیسکویت است یا نام دقیق برند و نوع هر محصول؟