تصدير نماذج YOLO26 إلى ONNX
ONNX (تبادل الشبكات العصبية المفتوح) هو تنسيق نماذج مفتوح تستطيع معظم بيئات تشغيل الاستدلال تحميله. يؤدي تصدير نموذج Ultralytics YOLO26 باستخدام format="onnx" إلى إنشاء ملف .onnx واحد يعمل مع ONNX Runtime على وحدات CPU ووحدات GPU من NVIDIA وAMD وأجهزة Apple silicon وأجهزة Windows.
لمحة سريعة#
| الخاصية | التفاصيل |
|---|---|
وسيطة format | onnx |
| المخرجات | yolo26n.onnx، ملف واحد تتضمن بياناته الوصفية أسماء الفئات والمهمة وحجم الصورة؛ وyolo26n_int8.onnx لتصدير quantize=8 مُعاير |
| يعمل على | وحدات CPU ووحدات GPU من NVIDIA (CUDA)، ووحدات GPU من AMD (MIGraphX)، وأجهزة Apple silicon (موفر تنفيذ Core ML)، وأجهزة Windows ML |
| بيئة التشغيل | ONNX Runtime، أو DNN في OpenCV مع dnn=True |
| الدقة | FP32 وFP16 وINT8. يبلغ حجم YOLO26n 9.9 MB بصيغة FP32، و5.0 MB بصيغة FP16، و3.1 MB بصيغة INT8 |
| جهاز التصدير | Linux أو macOS أو Windows، مع GPU أو من دونه |
يمكن لـ Ultralytics Platform تصدير نموذج مدرّب إلى ONNX نيابةً عنك، فلا تحتاج إلى بيئة تصدير محلية.
البدء السريع#
ثبّت حزمة Ultralytics. يثبّت أول تصدير onnx وonnxslim وonnxruntime إذا لم تكن مثبتة (onnxruntime-gpu عند التصدير باستخدام device=0 على وحدة GPU من NVIDIA).
pip install ultralyticsللاطلاع على طرق التثبيت الأخرى، راجع دليل التثبيت. ثم صدّر النموذج وحمّل الملف المُصدّر لإجراء الاستدلال أو التحقق من دقته.
from ultralytics import YOLO
# تحميل نموذج YOLO26
model = YOLO("yolo26n.pt")
# تصدير النموذج إلى تنسيق ONNX
model.export(format="onnx") # ينشئ 'yolo26n.onnx'
# صدّر نموذج ONNX مكمّمًا إلى INT8 باستخدام بيانات المعايرة
model.export(format="onnx", quantize=8, data="coco8.yaml") # ينشئ الملف 'yolo26n_int8.onnx'from ultralytics import YOLO
# تحميل نموذج ONNX المُصدَّر
model = YOLO("yolo26n.onnx")
# تنفيذ الاستدلال
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# تحميل نموذج ONNX المُصدَّر
model = YOLO("yolo26n.onnx")
# # التحقق من الدقة على مجموعة بيانات COCO8
metrics = model.val(data="coco8.yaml")المهام المدعومة#
يدعم تصدير ONNX مهام Ultralytics السبع جميعها باستخدام نماذج YOLOv8 وYOLO11 وYOLO26: الكشف، والتجزئة، والتجزئة الدلالية، وتقدير العمق، والتصنيف، وتقدير الوضعية، وOBB. لا يتوفر تقدير العمق والتجزئة الدلالية إلا مع YOLO26، وهي العائلة الوحيدة التي تتضمن هذه الرؤوس.
وسيطات التصدير#
| المعامل | النوع | الافتراضي | الوصف |
|---|---|---|---|
format | str | 'onnx' | التنسيق المستهدف للنموذج المُصدَّر، ويحدد مدى توافقه مع بيئات النشر المختلفة. |
imgsz | int أو tuple | 640 | حجم صورة إدخال النموذج: عدد صحيح للصور المربعة أو صف (height, width). إذا لم يُمرر، يستخدم التصدير الحجم الذي دُرّبت عليه نقطة التحقق. تستخدم نقاط التحقق الرسمية لـ YOLO26 القيمة 640 لمهام الكشف والتجزئة والوضعية والنماذج الدلالية المدربة مسبقًا على ADE20K، والقيمة 1024 لـ OBB والنماذج الدلالية المدربة مسبقًا على Cityscapes، والقيمة 768 لتقدير العمق، و224 للتصنيف. |
quantize | int أو str | None | دقة التكميم: 16 (FP16؛ يحافظ تصدير CPU على مدخلات ومخرجات FP32، بينما يحولها تصدير GPU إلى FP16 أيضًا) أو 8 (تكميم ثابت INT8 باستخدام ONNX Runtime وصور معايرة من data، وينتج نموذج _int8.onnx)؛ أما 32/غير المحدد فيعني FP32. تُصدّر نقطة التحقق المدرّبة باستخدام quantize=8 بصيغة INT8 عند ترك quantize دون تحديد أو ضبطه على 8 (وتؤدي القيم الأخرى إلى خطأ)، وذلك على هيئة عقد Q/DQ مستمدة من النطاقات التي تحملها، دون معايرة، وبالاسم العادي .onnx. يحل هذا الخيار محل العلمين المهملين half/int8. |
data | str | None | ملف YAML لمجموعة البيانات المستخدمة في معايرة INT8؛ أما التصنيف فيتطلب دليل مجموعة بيانات أو اسم مجموعة بيانات مضمّنة. إذا لم يُحدّد هذا الملف مع quantize=8، تختار Ultralytics مجموعة بيانات المعايرة الافتراضية لمهمة النموذج؛ ولا يحتاج checkpoint المدرَّب باستخدام quantize=8 إلى مجموعة بيانات. |
fraction | float أو int أو list | 1.0 | مجموعة فرعية للمعايرة محددة كنسبة أو عدد صور أو نسب/أعداد [train, val, test]. تترك القوائم المكوّنة من عنصرين test كاملة، بينما تتجاوزها 0. |
dynamic | bool | False | يجعل محاور الدفعة والارتفاع والعرض للمدخل ديناميكية، بحيث يقبل ملف واحد أحجام دفعات مختلفة (حتى batch الخاص بالتصدير مع nms=True) وأحجام صور مختلفة. راجع التصدير الديناميكي. |
simplify | bool | True | يبسّط مخطط النموذج باستخدام onnxslim. |
opset | int | None | يحدد إصدار opset في ONNX للتوافق مع محللات ONNX وبيئات التشغيل المختلفة. إذا لم يُحدد، يستخدم opset 18 (إصدارًا أقدم مع PyTorch < 2.4)، على ألا يتجاوز إصدار onnx المثبت. راجع الحد الأدنى لإصدار opset. |
nms | bool، اختياري | None | اختر المخرجات الخام (None، وهو الخيار الافتراضي)، أو NMS المضمّن (True)، أو الرأس الخالي من NMS (False). راجع تنسيق المخرجات. |
batch | int | 1 | حجم دفعة النموذج المُصدّر. يثبّت التصدير الساكن حجم الدفعة هذا في شكل المدخل. عند استخدام dynamic=True وnms=True، اضبطه على أكبر حجم دفعة تنوي تشغيله. |
device | str | None | الجهاز المستخدم للتصدير: cpu (الافتراضي، ويُستخدم أيضًا على جهاز مزود بـ GPU)، أو 0 لوحدة GPU من CUDA، أو mps لأجهزة Apple silicon. لا يؤثر ذلك في النتيجة إلا مع quantize=16؛ راجع مدخلات FP16. |
للاطلاع على الوسيطات المشتركة بين جميع التنسيقات، راجع وثائق وضع التصدير.
تكميم INT8#
بالنسبة إلى نقاط التحقق التي لم تُدرَّب باستخدام التدريب الواعي بالتكميم، يطبّق quantize=8 التكميم الثابت في ONNX Runtime على العقد Conv وGemm وMatMul فقط. وتبقى جميع العقد الأخرى بصيغة الفاصلة العائمة، بما فيها العمليات التي تكوّن output0: تشترك إحداثيات الصناديق (بالبكسل) ودرجات الفئات (من 0 إلى 1) في ذلك الموتر، لذا فإن استخدام مقياس INT8 واحد له سيؤدي إلى تقريب كل درجات الفئات إلى الصفر. تُكمَّم الأوزان لكل قناة عند opset 13 وما بعده. استبعد العقد نفسها واضبط per_channel=True إذا شغّلت quantize_static بنفسك على نموذج مُصدَّر بصيغة FP32:
import onnx
from onnxruntime.quantization import quantize_static

model = "yolo26n.onnx"
exclude = [n.name for n in onnx.load(model).graph.node if n.op_type not in {"Conv", "Gemm", "MatMul"}]
quantize_static(model, "yolo26n_int8.onnx", calibration_reader, nodes_to_exclude=exclude, per_channel=True)
هنا، calibration_reader هو onnxruntime.quantization.CalibrationDataReader الذي ينتج {"images": array} بحجم دفعة النموذج، بعد المعالجة المسبقة كما في الاستدلال: إضافة حواف letterbox إلى حجم التصدير (إعادة التحجيم والاقتصاص من المركز للتصنيف)، وRGB، وNCHW، وfloat32 ضمن النطاق 0-1.
يحافظ نموذج INT8 على أنواع مدخلات ومخرجات نموذج FP32، لذا يعمل رمز الاستدلال المكتوب لنموذج FP32 معه دون تعديل. يجعل INT8 الملف أصغر من FP32 بثلاث إلى أربع مرات، لكنه كان أبطأ من FP32 مع ONNX Runtime على GPU وCPU في الاختبارات المعيارية. قِس زمن الاستجابة على العتاد المستهدف قبل اختيار الدقة.
تنسيق المخرجات#
يستقبل النموذج المُصدّر مدخلًا واحدًا اسمه images، وشكله (batch, 3, height, width)، بصيغة RGB ومقياسه من 0 إلى 1. نوع المدخل هو float32، باستثناء عمليات التصدير إلى GPU باستخدام quantize=16، التي تستقبل float16. تحدد الوسيطة nms تخطيط output0. الأشكال أدناه خاصة بنموذج كشف YOLO26n ذي 80 فئة، المُصدّر عند imgsz=640:
nms | شكل output0 | المحتويات |
|---|---|---|
None (افتراضي) | (1, 84, 8400) | لكل واحد من المراسي البالغ عددها 8400: مركز الصندوق x، ومركزه y، وعرضه وارتفاعه بوحدات بكسل الإدخال، ثم درجات الفئات الثمانين. طبّق NMS بنفسك. |
True | (1, 300, 6) | يُنفّذ NMS داخل النموذج. كل صف هو x1, y1, x2, y2, score, class؛ والصفوف التي تلي آخر كشف تكون أصفارًا. |
False | (1, 300, 6) | رأس خالٍ من NMS. كل صف هو x1, y1, x2, y2, score, class، دون خطوة NMS. رشّح الصفوف حسب الدرجة بنفسك. |
تستخدم المهام الأخرى المدخل نفسه وهذه المخرجات. الأشكال خاصة بنقاط التحقق الرسمية لـ YOLO26n عند حجم التصدير الافتراضي، مع نقطة تحقق Cityscapes yolo26n-sem.pt للتجزئة الدلالية:
| المهمة | القيمة الافتراضية imgsz | المخرجات باستخدام nms=None | المخرجات باستخدام nms=False أو nms=True |
|---|---|---|---|
| Detect | 640 | output0 (1, 84, 8400) | output0 (1, 300, 6) |
| Segment | 640 | output0 (1, 116, 8400), output1 (1, 32, 160, 160) | output0 (1, 300, 38), output1 (1, 32, 160, 160) |
| دلالي | 1024 | output0 (1, 1024, 1024)، فهرس الفئة uint8 لكل بكسل | مثل nms=None |
| العمق | 768 | output0 (1, 1, 768, 768)، خريطة العمق | مثل nms=None |
| التصنيف | 224 | output0 (1, 1000)، احتمالات الفئات بعد softmax | مثل nms=None مع nms=False؛ وتؤدي nms=True إلى خطأ |
| الوضعية | 640 | output0 (1, 56, 8400) | output0 (1, 300, 57): 6 قيم للصندوق، ثم 17 نقطة رئيسية × 3 |
| OBB | 1024 | output0 (1, 20, 21504) | output0 (1, 300, 7): center x, center y, width, height, score, class, angle (بالراديان) |
تتضمن صفوف التجزئة 32 معامل قناع بعد قيم الصندوق، ويحمل output1 النماذج الأولية للأقنعة. في نماذج FP32 وINT8، تكون جميع المخرجات float32 باستثناء خريطة الفئات الدلالية.
مع nms=True، تُثبّت عتبة الثقة conf (الافتراضية 0.25)، وعتبة IoU iou (الافتراضية 0.5)، وagnostic_nms، وmax_det (الافتراضية 300) في المخطط عند التصدير. لا يمكن لقيمة conf الأقل أثناء التنبؤ استعادة الاكتشافات التي حذفها المخطط بالفعل، لذا أعد التصدير لتغيير هذه القيم. ينطبق max_det وagnostic_nms أيضًا على nms=False: ينتج max_det=100 شكل output0 وهو (1, 100, 6).
يقرأ YOLO("yolo26n.onnx") التخطيط من بيانات الملف الوصفية، لذا لا تحتاج إلى هذه الأشكال إلا عند تشغيل النموذج في التعليمات البرمجية الخاصة بك. تتوفر البيانات الوصفية أيضًا لرمزك كسلاسل: names وtask وimgsz وstride وbatch وend2end وargs.
import ast
import onnxruntime as ort
meta = ort.InferenceSession("yolo26n.onnx").get_modelmeta().custom_metadata_map
names = ast.literal_eval(meta["names"]) # {0: 'شخص', 1: 'دراجة', ...}
imgsz = ast.literal_eval(meta["imgsz"]) # [640, 640]النشر#
يشغّل YOLO("yolo26n.onnx") النموذج باستخدام ONNX Runtime ويحدد موفر التنفيذ استنادًا إلى الوسيطة device. على جهاز مزود بوحدة GPU من CUDA، تُستخدم وحدة GPU إذا لم تُضبط device.
device | موفر التنفيذ |
|---|---|
cpu | CPUExecutionProvider |
0 على وحدة GPU من NVIDIA | CUDAExecutionProvider، من حزمة onnxruntime-gpu التي تُثبّت عند الاستخدام الأول |
0 على وحدة GPU من AMD ROCm | MIGraphXExecutionProvider، راجع الاستدلال على وحدات GPU من AMD باستخدام MIGraphX |
mps على أجهزة Apple silicon | CoreMLExecutionProvider للعقد ذات الأشكال الثابتة؛ أما العقد ذات الأشكال الديناميكية فتعمل على CPUExecutionProvider |
يوضح سطر السجل Using ONNX Runtime 1.31.1 with CUDAExecutionProvider موفر التنفيذ النشط. يعتمد السلوك أثناء الاستدلال على طريقة تصدير النموذج:
- التصدير الساكن (الافتراضي): يعمل النموذج دائمًا باستخدام
imgszوbatchالخاصين بالتصدير، اللذين تقرؤهما Ultralytics من بيانات الملف الوصفية. يتم تجاهلimgszإذا مُررت إلىpredict. تُقسّم الدفعات الأكبر إلى أجزاء بحجم دفعة التصدير، وتُستكمل الدفعات الأصغر بالحشو، لذا يعمل النموذج مع أي عدد من الصور. - التصدير الديناميكي (
dynamic=True): يقبلpredictأيimgszيكون من مضاعفات خطوة النموذج. يمكن تغيير حجم الدفعة، لكن معnms=Trueيُقيّد بقيمةbatchالمستخدمة عند التصدير، لذا اضبطها على أكبر دفعة تنوي تشغيلها. - ذاكرة GPU: مع
CUDAExecutionProvider، يستخدم النموذج الساكن ربط IO في ONNX Runtime، ما يُبقي موترات الإدخال والإخراج على GPU. أما النموذج الديناميكي فينسخها عبر ذاكرة CPU في كل استدعاء. - خيوط CPU: تحد Ultralytics عدد خيوط العمليات الداخلية في ONNX Runtime إلى 8، أو إلى عدد أنوية CPU الفعلية المتاحة للعملية إذا كان أقل. اضبط متغير البيئة
ORT_INTRA_OP_NUM_THREADSلاستخدام عدد مختلف.
مرّر dnn=True إلى predict أو val لتشغيل النموذج على CPU باستخدام DNN في OpenCV بدلًا من ONNX Runtime. يدعم DNN في OpenCV خيارات تصدير أقل؛ راجع القيود واستكشاف الأخطاء وإصلاحها.
لتشغيل النموذج خارج حزمة Ultralytics، راجع هذه الموارد:
- واجهة Python البرمجية لـ ONNX Runtime: تحميل نموذج ONNX وتشغيله في Python.
- موفرو التنفيذ في ONNX Runtime: واجهات خلفية للعتاد مثل CUDA وTensorRT وOpenVINO وCore ML وDirectML.
- أمثلة Ultralytics: استدلال ONNX Runtime باستخدام Python وC++ وRust، واستدلال DNN في OpenCV باستخدام Python.
- خادم Triton للاستدلال: تقديم نموذج ONNX عبر HTTP أو gRPC باستخدام NVIDIA Triton.
- النشر على الأجهزة الطرفية: دروس ONNX Runtime لأجهزة إنترنت الأشياء والعتاد الطرفي.
استدلال Windows ML#
على Windows 11 24H2 (build 26100) أو إصدار أحدث، مع Python 3.10 أو أحدث، يمكنك تثبيت onnxruntime-windowsml في بيئة منفصلة لتمكين Windows ML من اختيار موفّري التنفيذ الملائمين لأجهزتك. ثبّته بدلًا من إصدارات ONNX Runtime الأخرى، ثم استخدم نموذج .onnx المُصدَّر نفسه مع YOLO("model.onnx"). تحافظ الواجهة الخلفية على عدد خيوط PyTorch وخيارات الجلسة المقدَّمة، بما فيها سياسة موفّر محددة صراحةً. إذا لم تُقدَّم سياسة، يختار Windows ML الأجهزة لتحقيق أقصى أداء، حتى عندما يكون جهاز PyTorch هو cpu. قِس زمن استجابة التنبؤ على جهازك قبل اختيار بيئة التشغيل هذه؛ فهي اختيارية ولا تُثبَّت افتراضيًا.
على وحدات معالجة الرسومات المدمجة التي تتشارك الطاقة مع وحدة المعالجة المركزية، يمكن أن تؤدي خيوط PyTorch الخاملة في المعالجة المسبقة واللاحقة إلى إبطاء الاستدلال باستخدام Windows ML. استدعِ torch.set_num_threads(1) قبل التنبؤ لتقليل ذلك. ينطبق هذا على العملية بأكملها، لذا تعمل نماذج PyTorch الأخرى في العملية نفسها أيضًا باستخدام خيط واحد.
import torch
from ultralytics import YOLO
torch.set_num_threads(1) # اختياري، قِس الأداء على جهازك
results = YOLO("yolo26n.onnx")("https://ultralytics.com/images/bus.jpg")استدلال GPU من AMD باستخدام MIGraphX#
تشغّل Ultralytics نماذج ONNX المُصدَّرة على وحدات GPU من AMD عبر موفّر تنفيذ MIGraphX في ONNX Runtime. على نظام ROCm (HIP) يعمل بـ Python 3.11 أو إصدار أحدث على x86-64، تثبّت الواجهة الخلفية لـ ONNX المكوّن الإضافي onnxruntime-ep-migraphx عند الاستخدام لأول مرة، وتختار MIGraphXExecutionProvider تلقائيًا دون الحاجة إلى أي تغييرات في الشيفرة، مع دعم جميع مهام YOLO26. راجع دليل الاستدلال على وحدات GPU من AMD للاطلاع على المتطلبات الأساسية والتثبيت والاستخدام والاختبارات المعيارية وذاكرة التخزين المؤقت للبرامج المجمّعة.
القيود واستكشاف الأخطاء وإصلاحها#
- الحد الأدنى لإصدار opset: يفشل التصدير مع
ONNX export requires opset>=Nعندما يكونopsetمنخفضًا جدًا بالنسبة إلى النموذج. الحد الأدنى هو7للتصنيف، و9للكشف والتجزئة والتجزئة الدلالية والوضعية وOBB، و11لتقدير العمق، ولنماذج الكشف والتجزئة والوضعية وOBB المُصدّرة باستخدامnms=True، و16لـ RT-DETR. - مدخلات FP16: يتوقع نموذج FP16 المُصدّر على GPU (
quantize=16 device=0) موترات إدخال FP16 في التعليمات البرمجية الخاصة بك. أما نموذج FP16 المُصدّر على CPU فيحتفظ بمدخلات ومخرجات FP32 ويحوّلها داخل المخطط. يمررYOLO()نوع المدخل الصحيح إلى كلا النموذجين، على GPU وعلى CPU. - اسم ملف INT8: ينشئ
quantize=8الملفyolo26n_int8.onnxويحذف ملف FP32 الوسيط، لذا حمّل الملف_int8للاستدلال. والاستثناء هو نقطة التحقق المدرّبة باستخدامquantize=8، إذ يكتب تصديرها عقد Q/DQ إلىyolo26n.onnxويتجاوز المعايرة. - حجم معايرة INT8: يصدر التصدير تحذيرًا إذا احتوى قسم المعايرة على أقل من 300 صورة، وذلك لنقطة تحقق لم تُدرّب باستخدام
quantize=8. يستخدم التكميم قسمvalافتراضيًا، ولا يحتويcoco8.yamlإلا على 4 صور للتحقق؛ لذا استخدم مجموعة بياناتك الخاصة للنموذج الذي تنوي نشره. - NMS المضمّن: يتطلب
nms=Trueإصدار PyTorch 1.13 أو أحدث. ويؤدي إلى'nms=True' is not valid for classification modelsللتصنيف، ويتم تجاهله مع إصدار تحذير لنماذج التجزئة الدلالية وتقدير العمق وRT-DETR. - الرأس الخالي من NMS: يتطلب
nms=Falseنموذجًا ذا رأس خالٍ من NMS، مثل YOLO26 أو YOLOv10. أما النماذج الأخرى، مثل YOLO11، فيصدر التصدير تحذيرًاThis model has no one-to-one head; using one-to-many outputsويكتب المخرجات الخام(1, 84, 8400). - عدم استخدام GPU: إذا أظهر السجل
CUDA requested but CUDAExecutionProvider not available. Using CPU...، فهذا يعني أن إصدار ONNX Runtime المثبت لا يتضمن موفر CUDA يعمل. ثبّتonnxruntime-gpuبدلًا منonnxruntime، وتحقق من توافق إصداري CUDA وcuDNN لديه مع نظامك. - DNN في OpenCV: مع OpenCV 4.14.0، يشغّل
dnn=Trueالنماذج الافتراضية، وnms=False، ونماذج INT8، ونماذج FP16 المُصدّرة إلى GPU. لكنه يفشل في تحميل النماذج المُصدّرة باستخدامnms=Trueأوdynamic=Trueأوquantize=16على CPU. - الأشكال الديناميكية مع NMS: عند الجمع بين
dynamic=Trueوnms=True، اضبط أيضًاbatchعلى أكبر حجم دفعة تنوي تشغيله. يصدر التصدير تحذيرًا إذا تُركbatchعلى1. - تبسيط المخطط: إذا فشل
onnxslim، يسجل التصدير تحذيرًا ويحفظ النموذج دون تبسيط. - إصدار IR: يقيّد المُصدّر إصدار ONNX IR عند 10 كي تتمكن الإصدارات الأقدم من ONNX Runtime من تحميل الملف. ويكون إصدار IR للتصدير الافتراضي عند opset 18 هو 8.
للاطلاع على الأخطاء الأخرى، راجع دليل المشكلات الشائعة.
المعايير المرجعية#
يعمل YOLO26n أسرع بنسبة تصل إلى 43% من YOLO11n مع ONNX Runtime على CPU (Intel Xeon CPU @ 2.00 GHz). تعرض صفحة نموذج YOLO26 سرعة ONNX على CPU لكل نموذج في جميع المهام باستثناء التجزئة الدلالية.
شاهد: اختبار استدلال Ultralytics YOLO26 مقابل Ultralytics YOLO11 على ONNX | استدلال أسرع بنحو 43% مع YOLO26 🚀
FP32 وFP16 وINT8 باستخدام ONNX Runtime#
تقارن الجداول أدناه PyTorch بنماذج ONNX بصيغ FP32 وFP16 وINT8 لكل نموذج كشف من YOLO26، عند تشغيلها باستخدام CUDAExecutionProvider في ONNX Runtime. قيسَت جميع قيم GPU باستخدام وحدة GPU واحدة NVIDIA RTX PRO 6000 Blackwell Server Edition.
بالمللي ثانية لكل صورة؛ الأقل أفضل. التنسيق الأسرع لكل نموذج مكتوب بالخط العريض.
| النموذج | imgsz | PyTorch | ONNX FP32 | ONNX FP16 | ONNX INT8 |
|---|---|---|---|---|---|
| YOLO26n | 640 | 2.85 | 1.96 | 1.88 | 3.73 |
| YOLO26s | 640 | 2.98 | 2.14 | 1.73 | 4.31 |
| YOLO26m | 640 | 3.29 | 3.01 | 2.14 | 5.37 |
| YOLO26l | 640 | 4.70 | 4.09 | 3.08 | 7.51 |
| YOLO26x | 640 | 5.93 | 5.56 | 3.90 | 9.38 |
YOLO26n على CPU (AMD EPYC 9655، وPyTorch وONNX Runtime يستخدم كل منهما 8 خيوط؛ تختلف وحدة CPU عن تلك المستخدمة لجداول نماذج YOLO26):
| المقياس | PyTorch | ONNX FP32 | ONNX FP16 | ONNX INT8 |
|---|---|---|---|---|
| زمن الاستجابة (مللي ثانية/صورة) | 13.2 | 13.4 | 13.2 | 56.5 |
| mAPval 50-95 | 40.8 | 40.9 | 40.9 | 38.7 |
- FP16 خفّض حجم الملف إلى النصف مع فرق لا يتجاوز 0.1 mAP مقارنةً بـ FP32، وكان أسرع بما يصل إلى 1.4 مرة من FP32 على GPU، دون أي تسريع على CPU.
- INT8 أنتج أصغر ملف، لكنه خفّض mAP بمقدار 2.2 إلى 3.0، وكان أبطأ من FP32 على كل من GPU وCPU.
أُجريت القياسات باستخدام ultralytics 8.4.211 وONNX Runtime 1.30.0 وPyTorch 2.15.0 وCUDA 13.2 عند batch=1 في 13 نوفمبر 2026. زمن الاستجابة هو مرحلة الاستدلال التي يعرضها val، ولا يشمل المعالجة المسبقة أو اللاحقة.
نبذة عن ONNX#
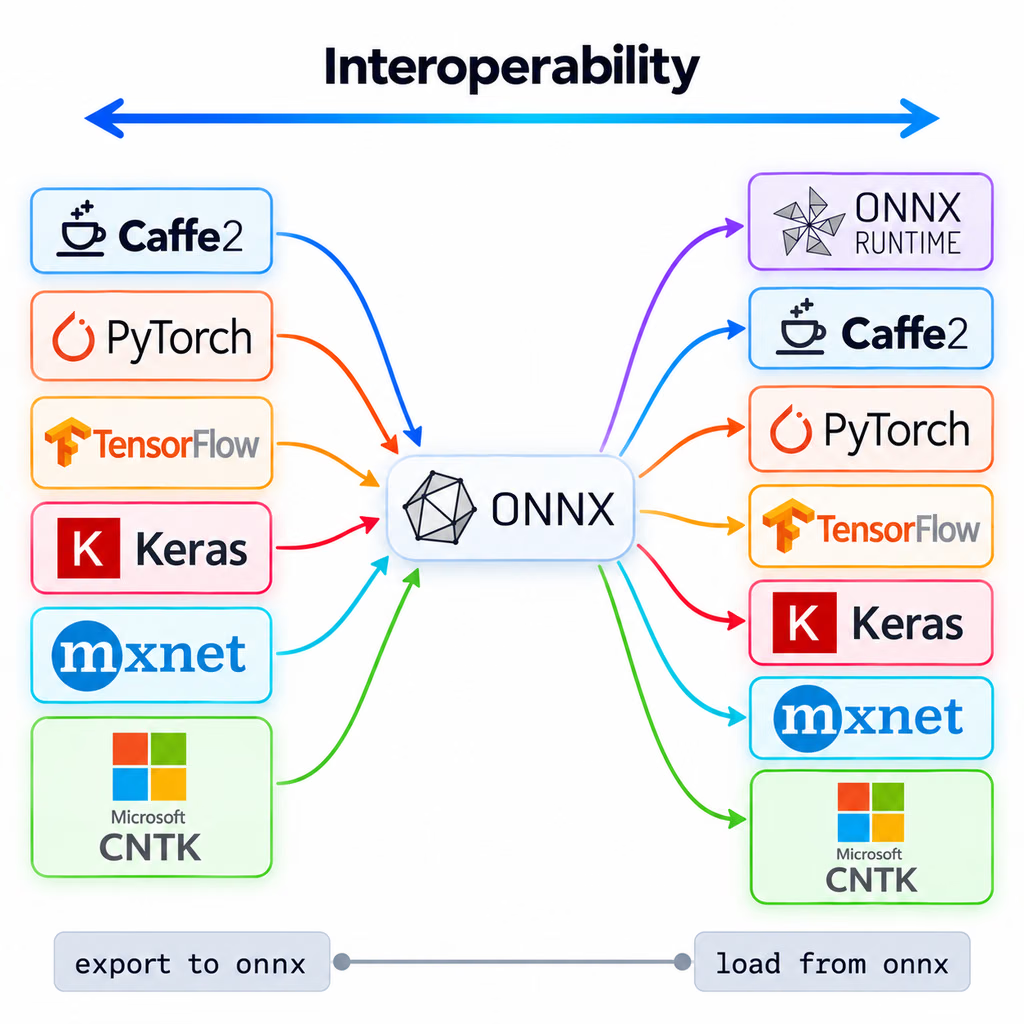
ONNX مشروع مجتمعي أطلقته Facebook وMicrosoft، ويُطوَّر الآن بالتعاون مع مؤسسات مثل IBM وAmazon وGoogle. يعرّف المشروع مجموعة موحّدة من العمليات وتنسيق ملفات لنماذج التعلّم الآلي، ما يتيح تشغيل نموذج دُرّب باستخدام إطار عمل مثل PyTorch على العديد من بيئات التشغيل ومنصات الأجهزة.
ONNX Runtime هو محرك استدلال متعدد المنصات لنماذج ONNX. يستخدم موفّرو التنفيذ فيه مكتبات خاصة بالأجهزة لتشغيل النماذج على وحدات CPU ووحدات GPU والمسرّعات المخصصة.
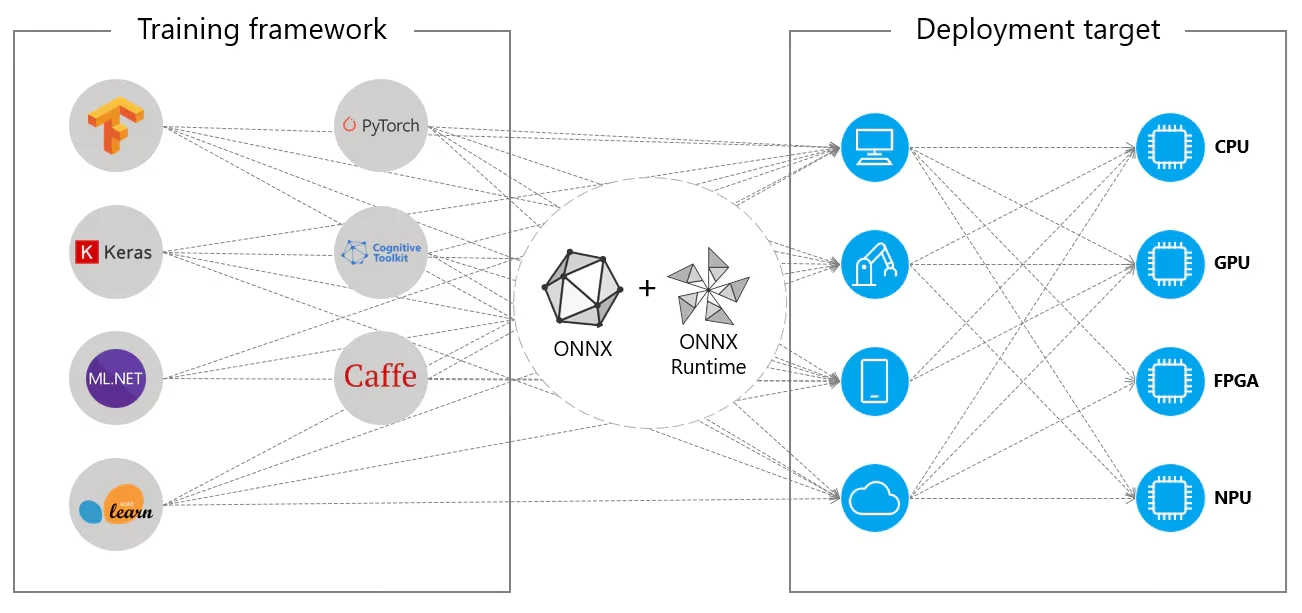
يُعد ONNX أيضًا خطوة وسيطة لتنسيقات التصدير الأخرى في Ultralytics، ومنها TensorRT، كما أنه مدخل لسلاسل أدوات NPU الخاصة بالمورّدين، مثل Huawei Ascend وQualcomm QNN وRockchip RKNN. للاطلاع على المواصفات، راجع وثائق ONNX.
الأسئلة الشائعة#
اترك
opsetدون تعيين ما لم تكن بيئة التشغيل لديك تتطلب إصدارًا محددًا. عندئذٍ يستخدم المُصدِّر opset18مع PyTorch 2.4 والإصدارات الأحدث، وopset17مع PyTorch من الإصدار 1.13 إلى 2.3، وopset أقدم مع إصدارات PyTorch الأقدم، ولا يتجاوز أبدًا ما تدعمه حزمةonnxالمثبّتة. يتوقف الإصدار الافتراضي عند 18 لأن موفّر CUDA في ONNX Runtime يشغّل بعض العمليات من opset 19 والإصدارات الأحدث، مثلResize، على CPU. عيّن قيمة أقل، مثلopset=12، عندما ترفض بيئة تشغيل أو أداة تحويل أقدم القيمة الافتراضية. لا يمكن أن تقل القيمة عن الحد الأدنى لإصدار opset للنموذج.يعتمد ذلك على الوسيط
nmsالذي استخدمته عند التصدير. يعيد التصدير الافتراضي تنبؤات خامًا تتطلب تصفية حسب الثقة وتطبيق NMS. أما التصدير باستخدامnms=Falseأوnms=Trueفيعيد ما يصل إلىmax_det(القيمة الافتراضية 300) من الاكتشافات النهائية لكل صورة، بصيغةx1, y1, x2, y2, score, classوبإحداثيات بكسلات صورة الإدخال، لذا لا تحتاج إلا إلى التصفية حسب الدرجة وإعادة تحجيم الصناديق إلى أبعاد الصورة الأصلية. تحتوي صفوف OBB علىcenter x, center y, width, heightبدلًا من الزوايا، بالإضافة إلى الزاوية. راجع تنسيق المخرجات للاطلاع على الأشكال.قراءة المخرجات الخالية من NMS باستخدام ONNX Runtime# التصدير أولًا: yolo export model=yolo26n.pt format=onnx nms=False import numpy as np import onnxruntime as ort session = ort.InferenceSession("yolo26n.onnx") # تم التصدير باستخدام nms=False image = np.zeros((1, 3, 640, 640), dtype=np.float32) # الصورة التي عالجتها مسبقًا detections = session.run(None, {"images": image})[0][0] # shape (300, 6) detections = detections[detections[:, 4] > 0.25] # الإبقاء على الصفوف التي تتجاوز عتبة الثقةعيّن
dynamic=True. عندها يصبح شكل مدخلimagesهو(batch, 3, height, width)مع ديناميكية حجم الدفعة والارتفاع والعرض، ويكون شكلoutput0للاكتشافات الناتجة افتراضيًا (nms=None) هو(batch, 84, anchors)، لذا يقبل الملف نفسه أحجام دفعات وصورًا مختلفة وقت الاستدلال. عند استخدامnms=True، يقتصر حجم الدفعة على قيمةbatchالمستخدمة عند التصدير. يجب أن يكون الارتفاع والعرض من مضاعفات خطوة النموذج، وهي 32 لنقاط التحقق الرسمية YOLO26 باستثناء التصنيف. لا يستخدم النموذج الديناميكي ربط IO على CUDA ولا يُحمَّل في OpenCV DNN، لذا أبقِ التصدير الساكن الافتراضي عند ثبات حجم الإدخال.التصدير الديناميكيfrom ultralytics import YOLO model = YOLO("yolo26n.pt") model.export(format="onnx", dynamic=True)استخدم ONNX عندما يلزم تشغيل ملف واحد على أجهزة مختلفة، أو عندما لا يكون جهاز النشر هو الجهاز الذي تُجري عليه التصدير. استخدم TensorRT لتحقيق أقل زمن استجابة على وحدة GPU محددة من NVIDIA: إذ يُنشأ محرك TensorRT لبنية وحدة GPU وإصدار TensorRT محددين، ولا يمكن نقله. للاطلاع على أهداف أخرى، راجع دليل خيارات نشر النماذج.
نعم. يتوفر من ONNX Runtime إصدارا الويب والأجهزة المحمولة، ويمكنهما تحميل الملف نفسه
.onnx. صدّر باستخدامnms=Falseلإبقاء المعالجة اللاحقة خارج شيفرة تطبيقك. على الهواتف، يُعد Core ML على iOS وLiteRT على Android التنسيقين الأصليين.


التعليقات77
اطرح سؤالًا، وشارك نتائجك، أو ساعد شخصًا آخر.
dopeggguy
The parameter "half" bost apperence in train and export, what’s difference. when we using this parameter what should we need attention.
 Glenn JocherUltralytics(تم التعديل)
@dopeggguy Good question—summary: training uses mixed precision via
amp=True(weights stay FP32; compute is FP16 where safe), while export usesquantize=16(the formerhalf=True, now deprecated) to write an FP16 model for runtimes that support FP16. During training preferamp; use FP16 only at export/inference, and don't combine it with INT8 (quantize=8). See the train overview and AMP notes in the Train mode docs and thequantizeoption details in Model Export – Arguments and Configuration – Export Settings.from ultralytics import YOLO # Mixed-precision training (recommended) YOLO("yolo26n.yaml").train(data="data.yaml", amp=True) # FP16 export for FP16-capable runtimes (e.g., CUDA/TensorRT/OpenVINO FP16) YOLO("best.pt").export(format="onnx", quantize=16)yoloModel = YOLO(path_dir) yoloModel.export(format='onnx', dynamic=False, half=True, imgsz=(640, 640))
I'm not sure why. I enabled half=True, but the actual size of the exported model doesn't seem to change at all.
- Glenn JocherUltralytics(تم التعديل)
@dopeggguy
half=Trueis deprecated in favor ofquantize=16. On older releases a CPU-only ONNX export ignored the flag and stayed FP32, so the file size was almost identical. Current releases convert CPU ONNX exports to FP16 too (keeping float32 inputs/outputs), and GPU exports are FP16 natively. If you have a GPU, you can force export on it and re-check:from ultralytics import YOLO YOLO(path_dir).export(format="onnx", imgsz=(640, 640), dynamic=False, quantize=16, device=0)You can then open the ONNX in Netron or inspect it with the
onnxPython API to confirm the weights arefloat16; for pure CPU deployments it is often better to keep ONNX as FP32 or use a CPU‑oriented backend (e.g. OpenVINO) for FP16/INT8 optimization instead, with some general ONNX background outlined in the ONNX: Open Neural Network Exchange overview.
bastinj98
Hi, I trained d a YOLOV8-segn model to detect and segment a single class (nc=1) and then exported in to onnx (simplify, nms, half are all False) with opset = 17. The output shape is 1x37x8400.
I am building a C++ pipeline to use this model to run inference. How can I process this output to get the final segmentation mask ?
NgZiming
I exported a yolo 11 segment model to onnx format, and used onnx-runtime to infer. It responded two ndarrays of shapes (1, 37, 21504) and (1, 32, 256, 256). (imgsz=1024) So, how can i extract masks from these two arrays?
- Glenn JocherUltralytics
@NgZiming 这两个输出正是分割模型的“检测头 + 原型掩码”:
(1, 37, 21504)=4(xywh) + nc + 32(mask系数),(1, 32, 256, 256)为32个原型;掩码可由原型与对应检测的32维系数线性组合并裁剪到框内,最小示例(Python/NumPy)如下:import numpy as np import cv2 def sigmoid(x): return 1 / (1 + np.exp(-x)) def mask_from_outputs(det, proto, img_h, img_w, det_idx): # det: (1, C, N) -> (C, N), proto: (1, 32, 256, 256) -> (32, 256, 256) det = det[0]; proto = proto[0] nm, ph, pw = proto.shape # 32, 256, 256 nc = det.shape[0] - 4 - nm # 1) 取该检测的框、类别分数与32维掩码系数 cx, cy, w, h = det[0, det_idx], det[1, det_idx], det[2, det_idx], det[3, det_idx] coeff = det[4+nc:4+nc+nm, det_idx] # (32,) # 2) 原型 × 系数 -> 原始掩码 (ph, pw) m = sigmoid((proto.reshape(nm, -1).T @ coeff).reshape(ph, pw)) # 3) 可选:按框在原型分辨率下裁剪(坐标为[0,1]比例) x0 = int(max(0, (cx - w/2) * pw)); x1 = int(min(pw, (cx + w/2) * pw)) y0 = int(max(0, (cy - h/2) * ph)); y1 = int(min(ph, (cy + h/2) * ph)) crop = np.zeros_like(m); crop[y0:y1, x0:x1] = m[y0:y1, x0:x1] # 4) 上采样到原图尺寸并二值化 mask = cv2.resize(crop, (img_w, img_h), interpolation=cv2.INTER_LINEAR) return (mask > 0.5).astype(np.uint8)要点:确保与推理时的预处理一致(letterbox 缩放与填充、RGB/归一化等),否则框与掩码会错位。关于分割导出产生两个输出(
output0检测+系数,output1原型)的由来,可见导出实现参考的export_onnx说明:export_onnx 函数参考.1 thanks
- Glenn JocherUltralytics
Glad it helped—if you later need a C++ reference for segmentation mask decoding and preprocessing alignment, the step-by-step overview is in the Segmentation task docs.
 User
I have a question. If it's convenient, please answer it. Thank you! I'm working with cell images, and the image size is 3072*2048. I trained with imagesize=3072, but if I use imagesize=640, I can't detect objects. I can predict with a 3072 imagesize using a pt file, but now I'm trying to switch to C++ and call onnx, and the 3072 inference is very slow. Is this normal?
denni281
You should keep the same preprocess way between python-inference and cpp-inference.
- Glenn JocherUltralytics
@giter915 Yes—running 3072×2048 through ONNX/C++ will be much slower; inference time grows quickly with input area. Two practical options: use a faster backend or reduce effective input while keeping accuracy. For GPU, prefer TensorRT; for CPU, OpenVINO FP16/INT8 gives the largest gains. Examples:
from ultralytics import YOLO

# GPU-optimized
YOLO("best.pt").export(format="engine", imgsz=1536, half=True, dynamic=True)

# CPU-optimized
YOLO("best.pt").export(format="openvino", imgsz=1536, half=True)  # add int8=True with calibration if desired
If you must keep 3072, tile the image (e.g., 1024×1024 patches), run ONNX per tile, then merge detections with NMS in C++; this is a common approach for microscopy. Also ensure preprocessing in C++ exactly matches Python (letterbox padding, RGB order, 1/255 scaling)—agree with @DennisJcy here. For backend choices and supported export targets, see the export formats table in Object Detection – Ultralytics YOLO Docs, and for high‑throughput GPU serving consider Triton Inference Server with YOLO11.
- User
Thank you very much!
- Glenn JocherUltralytics
Glad it helped—one extra tip for ONNX Runtime C++: enable full graph optimizations and tune threads to squeeze more speed from large inputs like 3072×2048.
#include <onnxruntime_cxx_api.h>
#include <thread>

Ort::Env env(ORT_LOGGING_LEVEL_WARNING, "yolo");
Ort::SessionOptions so;
so.SetGraphOptimizationLevel(GraphOptimizationLevel::ORT_ENABLE_ALL);
so.SetIntraOpNumThreads(std::thread::hardware_concurrency());
so.SetInterOpNumThreads(1);  // often fine to leave at 1

Ort::Session session(env, "best.onnx", so);
Hello, I use ultratics to export YOLO11 half-Precision onnx model, but when I load the .onnx model to eval by onnxruntime, exception shows :Unexpected input data type. Actual: (tensor(float16)) , expected: (tensor(float)). And I compare the Float32 and Float16(half) .onnx model,These two files are exactly the same in size and input type.So the "half" keyword doesn't take effect when exporting ONNX, right? I remember Ultralytics didn't have this issue last year.
Here is my python script to export half-precision onnx model:
def main(opt): model = YOLO(opt.model) model.export( format="onnx", # opset=12, simplify=True, dynamic=False, imgsz=opt.imgsz, half=opt.half, batch=opt.batch, ) if __name__ == "__main__": multiprocessing.freeze_support() parser = argparse.ArgumentParser() parser.add_argument( "--model", type=str, default="/home/ultralytics/runs/detect/SHFY/weights/best.pt", ) parser.add_argument("--imgsz", type=int, default=640) parser.add_argument("--half", type=bool, default=True) parser.add_argument("--batch", type=int, default=1) opt, unparsed = parser.parse_known_args() print(opt) main(opt)Fine... It's my fault. My docker environment is Python-3.11.9 torch-2.4.1+cu118 CPU (unknown). The error is made by my cpu environment
- Glenn JocherUltralytics(تم التعديل)
@DennisJcy thanks for the update. On older releases
half=Truehad no effect on CPU ONNX exports, so the file stayed FP32. Current Ultralytics usesquantize=16(replacing the deprecatedhalf) and also converts CPU ONNX exports to FP16 while keeping float32 inputs/outputs, whereas GPU exports (device=0) are FP16 natively and need an FP16-capable ONNX Runtime provider. For CPU-optimized FP16 you can also export OpenVINO. For example:from ultralytics import YOLO # FP16 ONNX YOLO("best.pt").export(format="onnx", quantize=16) # CPU-optimized FP16 (OpenVINO) YOLO("best.pt").export(format="openvino", quantize=16)Details on OpenVINO export are in the export_openvino reference.
ShuaibZyx
def yolo_to_onnx(model_path, input_shape=(600, 600)): # Load the YOLOv8 model model = YOLO(model_path)
# Export the model to ONNX format
model.export(format='onnx',
             imgsz=input_shape,
             dynamic=True,
             batch=1,
             device="0")
Ultralytics YOLOv8.0.220 🚀 Python-3.9.18 torch-2.1.1+cu121 CUDA:0 (Tesla T4, 14931MiB) Model summary (fused): 268 layers, 43610463 parameters, 0 gradients, 164.8 GFLOPs
PyTorch: starting from 'best.pt' with input shape (1, 3, 640, 640) BCHW and output shape(s) (1, 9, 8400) (83.6 MB)
ONNX: starting export with onnx 1.18.0 opset 17... ONNX: export success ✅ 3.3s, saved as 'best.onnx' (166.5 MB) 我的模型在训练时是5个类别的目标检测,导出的模型的输出格式是(1, 9, 8400)。 我想请问您其中9具体代表的是什么呢? 如果是为了预测5个类别(1, 9, 8400)的输出格式是正确的嘛? 期待您的帮助!感谢!
xiaoqiang-l
9指的是:[x,y,w,h,class1_scores,class2_scores,class3_scores,class4_scores,class5_scores],即四个坐标及N个类别分数。 8400指的是:640下采样8倍、16倍、32倍特征图的anchor总数,(640/8)(640/8)+(640/16)(640/16)+(640/32)(640/32)=8080+4040+2020=8400
感谢您的指导!
- Glenn JocherUltralytics
@ShuaibZyx you're welcome! @xiaoqiang-l provided an excellent explanation. Just to confirm, the output shape (1, 9, 8400) is indeed correct for your 5-class detection model - the 9 channels represent the 4 bounding box coordinates (x, y, w, h) plus 5 class confidence scores. The 8400 represents all detection anchors across the three feature map scales (80×80 + 40×40 + 20×20 = 8400 total anchors).
UltralyticsAssistantUltralytics
👋 Hello, thank you for your interest in Ultralytics 🚀! We recommend a visit to the Docs for new users where you can find many Python and CLI usage examples, as well as detailed guides about exporting YOLO models to ONNX and other formats.
If this is a 🐛 Bug Report, please provide a minimum reproducible example to help us debug it.
If you have a custom training ❓ Question or require help with ONNX export, please include as much detail as possible—such as your command, model version, logs, and environment details. Also, check out our Tips for Best Training Results for optimal performance.
Join the Ultralytics community where it suits you best! For real-time chat, head to Discord 🎧. For in-depth discussions, try Discourse, or join the conversation on our Subreddit.
Upgrade
Upgrade to the latest
ultralyticspackage including all requirements in a Python>=3.8 environment with PyTorch>=1.8 to ensure you’re using the most up-to-date features and bug fixes:pip install -U ultralyticsEnvironments
YOLO can be run in these up-to-date verified environments, with all dependencies including CUDA/CUDNN, Python, and PyTorch preinstalled:
- Notebooks with free GPU:


- Google Cloud Deep Learning VM. See GCP Quickstart Guide
- Amazon Deep Learning AMI. See AWS Quickstart Guide
- Docker Image. See Docker Quickstart Guide
Status

If this badge is green, all Ultralytics CI tests are currently passing. CI tests verify correct operation of all YOLO Modes and Tasks on macOS, Windows, and Ubuntu every 24 hours and on every commit.
This is an automated response 🤖. An Ultralytics engineer will review your discussion and assist you soon!
- Glenn JocherUltralytics
Hello! Thanks for your interest in exporting YOLO11 models to ONNX format. This is a great option for deployment across different platforms with performance benefits.
Exporting to ONNX is straightforward with Ultralytics:
from ultralytics import YOLO

# Load model
model = YOLO("yolo11n.pt")  # or your custom trained model

# Export to ONNX with optional parameters
model.export(format="onnx", dynamic=True, simplify=True)  # creates 'yolo11n.onnx'

# Use the exported model
onnx_model = YOLO("yolo11n.onnx")
results = onnx_model("https://ultralytics.com/images/bus.jpg")
ONNX export can provide up to 3x CPU speedup compared to PyTorch models. You can customize the export with several parameters like
half=Truefor FP16 precision,dynamic=Truefor variable input sizes, oropsetto specify the ONNX version.For deployment, you can use ONNX Runtime or integrate with platforms like NVIDIA Triton Inference Server for production-scale serving.
If you have specific questions about exporting your models or encounter any issues during the process, please let us know!
- Notebooks with free GPU:
👋 Hello, thank you for your interest in Ultralytics 🚀! For users exploring ONNX integration and YOLO11, we recommend checking out the Docs where you’ll find dedicated Python and CLI tutorials, as well as specific ONNX integration guidance.
If this is a 🐛 Bug Report, please provide a minimum reproducible example to help us investigate further.
For custom deployment or export ❓ questions, please include as many details as possible, such as your export commands, model versions, and error logs. Make sure you review our Tips for Best Training Results for optimal performance.
Join the Ultralytics community where it suits you best: jump into real-time conversations on Discord 🎧, post or search on Discourse, or connect on our Subreddit.
Upgrade
Upgrade to the latest
ultralyticspackage, including all requirements, in a Python>=3.8 environment with PyTorch>=1.8 to ensure you have the latest features and fixes:pip install -U ultralyticsEnvironments
YOLO can be run in any of the following up-to-date verified environments (with all dependencies including CUDA/CUDNN, Python and PyTorch preinstalled):
- Notebooks with free GPU:
- Google Cloud Deep Learning VM. See GCP Quickstart Guide
- Amazon Deep Learning AMI. See AWS Quickstart Guide
- Docker Image. See Docker Quickstart Guide
Status
If this badge is green, all Ultralytics CI tests are currently passing. CI tests verify correct operation of all YOLO Modes and Tasks on macOS, Windows, and Ubuntu every 24 hours and on every commit.
This is an automated response. An Ultralytics engineer will assist you here soon!
- Glenn JocherUltralytics
Yes, you can adjust the batch size dynamically when exporting to ONNX format by using the
dynamic=Trueparameter in your export call. When this is enabled, the batch dimension becomes dynamic, allowing you to use various batch sizes during inference without reexporting the model.Here's a simple example:
from ultralytics import YOLO

# Load your model
model = YOLO("yolo11n.pt")

# Export with dynamic input size
model.export(format="onnx", dynamic=True)
This creates dynamic dimensions in the exported ONNX model, where the batch dimension (as well as height and width) can vary during inference. The resulting model will be more flexible for production deployments where batch size requirements might change.
- Notebooks with free GPU:
skyceeee
First of all, thank you for everything. Can we adjust the batch size dynamically when exporting the model as onnx?
When I export the YOLOV11 onnx model, I use: model.export(format='onnx', imgsz=640, device='cpu'). Then I use onnxruntime (1.14.0) to deploy it on the C++ side, but an error is reported during runtime: onnxruntime::Model::Model Unsupported model IR version: 9, max supported IR version: 8. Is there any parameter or method to set the exported model to support IR version: 8? Because I cannot upgrade onnxruntime to other higher versions locally, I look forward to your help
- Glenn JocherUltralytics
@xiaoqiang-l to resolve the ONNX IR version compatibility issue, you can specify an older
opsetversion during export. Try addingopset=13to your export command:model.export(format='onnx', imgsz=640, device='cpu', opset=13)This will generate an ONNX model compatible with IR version 8. For detailed version mapping, see the ONNX operator version matrix in the ONNX documentation.
