تصدير Intel OpenVINO#

في هذا الدليل، نتناول تصدير نماذج YOLO26 إلى تنسيق OpenVINO، الذي يمكن أن يوفر تسريعًا يصل إلى 3 أضعاف لـ CPU، بالإضافة إلى تسريع استدلال YOLO على أجهزة GPU وNPU من Intel.
OpenVINO، وهو اختصار لمجموعة أدوات تحسين الاستدلال المرئي والشبكات العصبية، مجموعة أدوات شاملة لتحسين نماذج استدلال الذكاء الاصطناعي ونشرها. وعلى الرغم من أن الاسم يتضمن كلمة Visual، فإن OpenVINO يدعم أيضًا مهام إضافية متنوعة، بما في ذلك اللغة والصوت والسلاسل الزمنية وغير ذلك.
Watch: How to Export Ultralytics YOLO26 to Intel OpenVINO Format for Faster Inference 🚀
المهام المدعومة#
يدعم تصدير OpenVINO مهام Ultralytics السبعة جميعها. ولا يتوفر التجزئة الدلالية وتقدير العمق إلا مع YOLO26، وهي العائلة الوحيدة التي تأتي مع تلك الرؤوس.
التثبيت#
قم بتثبيت تبعيات تصدير OpenVINO باستخدام:
pip install "ultralytics[export-openvino]"تتضمن حزمة ultralytics[export] أيضاً هذه التبعيات ويتم تثبيتها تلقائياً عند الحاجة إليها بواسطة عملية التصدير.
أمثلة على الاستخدام#
يدعم تنسيق OpenVINO أوضاع التصدير والتنبؤ والتحقق. صدّر نموذجك، ثم حمّل النموذج المُصدَّر لإجراء الاستدلال أو التحقق من دقته على CPU أو GPU مدمج/منفصل أو NPU من Intel.
from ultralytics import YOLO

# Load a YOLO26 model
model = YOLO("yolo26n.pt")

# Export the model to OpenVINO format
model.export(format="openvino") # creates 'yolo26n_openvino_model/'from ultralytics import YOLO
# Load the exported OpenVINO model
model = YOLO("yolo26n_openvino_model/")
# Run inference
results = model("https://ultralytics.com/images/bus.jpg")
# Run inference on a specific device, available devices: ["intel:gpu", "intel:npu", "intel:cpu"]
results = model("https://ultralytics.com/images/bus.jpg", device="intel:gpu")from ultralytics import YOLO
# Load the exported OpenVINO model
model = YOLO("yolo26n_openvino_model/")
# Validate accuracy on the COCO8 dataset
metrics = model.val(data="coco8.yaml")وسائط التصدير#
| الوسيطة | النوع | الافتراضي | الوصف |
|---|---|---|---|
format | str | 'openvino' | التنسيق المستهدف للنموذج المُصدَّر، والذي يحدد التوافق مع بيئات النشر المختلفة. |
imgsz | int أو tuple | 640 | حجم الصورة المطلوب لإدخال النموذج. يمكن أن يكون عددًا صحيحًا للصور المربعة أو صفًا (height, width) لأبعاد محددة. |
quantize | int أو str | None | دقة التكميم: 16 (FP16) أو 8 (INT8/PTQ؛ يتطلب المعايرة باستخدام data/fraction)؛ أما 32/غير المحدد فهي FP32. ويحل ذلك محل العلامتَين المهجورتَين half/int8. |
dynamic | bool | False | يسمح بأحجام إدخال ديناميكية، مما يعزز المرونة في التعامل مع أبعاد الصور المتفاوتة. |
nms | bool، اختياري | None | حدد الناتج الخام (None، الافتراضي)، أو المعالجة غير اللحظية المدمجة (NMS) (True)، أو رأس النموذج الخالي من المعالجة غير اللحظية (NMS) (False). |
batch | int | 1 | يحدد حجم الدفعة للاستدلال في نموذج التصدير أو الحد الأقصى لعدد الصور التي سيعالجها النموذج المُصدَّر بالتزامن في وضع predict. |
data | str | None | مسار YAML الخاص بـ مجموعة البيانات، وهو ضروري للتكميم؛ بينما يتطلب التصنيف بدلًا من ذلك دليل مجموعة بيانات أو اسم مجموعة بيانات مضمّنة. إذا لم يُحدَّد مع quantize=8، تختار Ultralytics مجموعة بيانات المعايرة الافتراضية لمهمة النموذج. |
fraction | float أو int أو list | 1.0 | مجموعة المعايرة الجزئية كنسبة أو عدد صور أو نسب/أعداد [train, val, test]. تترك القوائم ذات العنصرين test ممتلئًا، بينما تتخطى 0. |
لمزيد من التفاصيل حول عملية التصدير، تفضل بزيارة صفحة توثيق Ultralytics حول التصدير.
يتوافق OpenVINO™ مع معظم معالجات Intel®، ولكن لضمان الأداء الأمثل:
-
التحقق من دعم OpenVINO™ تحقق مما إذا كانت شريحة Intel® لديك مدعومة رسميًا من OpenVINO™ باستخدام قائمة التوافق الخاصة بـ Intel.
-
تحديد المسرّع حدّد ما إذا كان معالجك يتضمن NPU مدمجًا (وحدة معالجة عصبية) أو GPU (GPU مدمجًا) بالرجوع إلى دليل الأجهزة الخاص بـ Intel.
-
تثبيت أحدث برامج التشغيل إذا كانت شريحتك تدعم NPU أو GPU، لكن OpenVINO™ لا يكتشفه، فقد تحتاج إلى تثبيت برامج التشغيل المرتبطة أو تحديثها. اتبع تعليمات تثبيت برامج التشغيل لتمكين التسريع الكامل.
باتباع هذه الخطوات الثلاث، يمكنك ضمان تشغيل OpenVINO™ بأفضل أداء على أجهزة Intel® لديك.
فوائد OpenVINO#
- الأداء: يوفر OpenVINO استدلالًا عالي الأداء من خلال الاستفادة من قوة وحدات CPU من Intel ووحدات GPU المدمجة والمنفصلة ووحدات FPGA.
- دعم التنفيذ غير المتجانس: يوفر OpenVINO واجهة API للكتابة مرة واحدة والنشر على أي أجهزة Intel مدعومة (CPU وGPU وFPGA وVPU وغير ذلك).
- محسّن النماذج: يوفر OpenVINO محسّن نماذج يستورد النماذج من أطر التعلم العميق الشائعة مثل PyTorch وTensorFlow وTensorFlow Lite وKeras وONNX وPaddlePaddle وCaffe، ويحوّلها ويحسّنها.
- سهولة الاستخدام: تأتي مجموعة الأدوات مع مجموعة كبيرة من دفاتر الملاحظات التعليمية، بما في ذلك تحسين YOLO26، التي تشرح جوانب مختلفة من مجموعة الأدوات.
بنية تصدير OpenVINO#
عند تصدير نموذج إلى تنسيق OpenVINO، ينتج عن ذلك دليل يحتوي على ما يلي:
- ملف XML: يصف البنية الطوبولوجية للشبكة.
- ملف BIN: يحتوي على البيانات الثنائية للأوزان والانحيازات.
- ملف التعيين: يحتوي على تعيين موترات مخرجات النموذج الأصلي إلى أسماء موترات OpenVINO.
يمكنك استخدام هذه الملفات لإجراء الاستدلال باستخدام محرك استدلال OpenVINO.
استخدام تصدير OpenVINO في النشر#
بعد تصدير نموذجك بنجاح إلى تنسيق OpenVINO، يتوفر لديك خياران أساسيان لإجراء الاستدلال:
-
استخدم حزمة
ultralytics، التي توفر واجهة API عالية المستوى وتغلّف OpenVINO Runtime. -
استخدم حزمة
openvinoالأصلية للتحكم المتقدم أو المخصص بدرجة أكبر في سلوك الاستدلال.
الاستدلال باستخدام Ultralytics#
تتيح لك حزمة ultralytics إجراء الاستدلال بسهولة باستخدام نموذج OpenVINO المُصدَّر عبر طريقة predict. ويمكنك أيضًا تحديد الجهاز المستهدف (مثل intel:gpu وintel:npu وintel:cpu) باستخدام الوسيطة device.
from ultralytics import YOLO

# Load the exported OpenVINO model
ov_model = YOLO("yolo26n_openvino_model/")  # the path of your exported OpenVINO model
# Run inference with the exported model
ov_model.predict(device="intel:gpu")  # specify the device you want to run inference on
يُعد هذا النهج مثاليًا لإنشاء النماذج الأولية بسرعة أو للنشر عندما لا تحتاج إلى تحكم كامل في خط أنابيب الاستدلال.
الاستدلال باستخدام OpenVINO Runtime#
يوفر OpenVINO Runtime واجهة API موحدة للاستدلال عبر جميع أجهزة Intel المدعومة. كما يوفر إمكانات متقدمة مثل موازنة التحميل عبر أجهزة Intel والتنفيذ غير المتزامن. لمزيد من المعلومات حول إجراء الاستدلال، راجع دفاتر YOLO26.
تذكّر أنك ستحتاج إلى ملفَي XML وBIN، بالإضافة إلى أي إعدادات خاصة بالتطبيق مثل حجم الإدخال وعامل القياس للتطبيع وغير ذلك، لإعداد النموذج واستخدامه بشكل صحيح مع Runtime.
في تطبيق النشر، ستنفذ عادةً الخطوات التالية:
- تهيئة OpenVINO من خلال إنشاء
core = Core(). - تحميل النموذج باستخدام طريقة
core.read_model(). - ترجمة النموذج باستخدام الدالة
core.compile_model(). - إعداد الإدخال (صورة أو نص أو صوت وغير ذلك).
- إجراء الاستدلال باستخدام
compiled_model(input_data).
لمزيد من الخطوات التفصيلية ومقاطع التعليمات البرمجية، راجع توثيق OpenVINO أو البرنامج التعليمي لواجهة API.
معايير YOLO26 على OpenVINO#
أجرى فريق Ultralytics اختبارات معيارية لـ YOLO26 عبر تنسيقات نماذج ودرجات دقة مختلفة، مع تقييم السرعة والدقة على أجهزة Intel مختلفة المتوافقة مع OpenVINO.
-
النتائج المعيارية أدناه مرجعية وقد تختلف حسب تكوين الأجهزة والبرامج الدقيق للنظام، بالإضافة إلى عبء العمل الحالي على النظام وقت إجراء الاختبارات المعيارية.
-
أُجريت جميع الاختبارات المعيارية باستخدام الإصدار 2026.2.1 من حزمة
openvinoPython. -
لا تُدعم نماذج YOLO26 على NPU إلا على أنظمة Intel® Core™ Ultra™ من سلسلة 2xxV وسلسلة 3xx وما فوقها.
Intel® Core™ Ultra#
تمثل سلسلة Intel® Core™ Ultra™ معيارًا جديدًا في الحوسبة عالية الأداء، وقد صُممت لتلبية المتطلبات المتطورة للمستخدمين العصريين، من اللاعبين والمبدعين إلى المحترفين الذين يستفيدون من الذكاء الاصطناعي. ولا تقتصر هذه المجموعة من الجيل التالي على كونها سلسلة CPU تقليدية؛ إذ تجمع بين نوى CPU قوية وإمكانات GPU مدمجة عالية الأداء ووحدة معالجة عصبية (NPU) مخصصة ضمن شريحة واحدة، لتوفير حل موحد لأعباء العمل الحاسوبية المتنوعة والمكثفة.
في صميم بنية Intel® Core Ultra™ يوجد تصميم هجين يتيح أداءً استثنائيًا عبر مهام المعالجة التقليدية وأعباء العمل المسرّعة بواسطة GPU والعمليات المدفوعة بالذكاء الاصطناعي. ويعزز تضمين NPU الاستدلال بالذكاء الاصطناعي على الجهاز، مما يتيح تعلمًا آليًا ومعالجة بيانات أسرع وأكثر كفاءة عبر مجموعة واسعة من التطبيقات.
تضم عائلة Core Ultra™ نماذج متنوعة مصممة لتلبية احتياجات أداء مختلفة، مع خيارات تتراوح من التصميمات الموفرة للطاقة إلى الإصدارات عالية القدرة التي تحمل الرمز "H"، وهي مثالية لأجهزة الكمبيوتر المحمولة والعوامل الشكلية المدمجة التي تتطلب قدرة حاسوبية كبيرة. ويستفيد المستخدمون عبر المجموعة من التكامل المتناغم بين CPU وGPU وNPU، بما يوفر كفاءة واستجابة وقدرات تعدد مهام ملحوظة.
وباعتبارها جزءًا من ابتكار Intel المستمر، تضع سلسلة Core Ultra™ معيارًا جديدًا للحوسبة الجاهزة للمستقبل. ومع توفر نماذج متعددة وظهور المزيد منها مستقبلًا، تؤكد هذه السلسلة التزام Intel بتقديم حلول متطورة للجيل التالي من الأجهزة الذكية المعززة بالذكاء الاصطناعي.
أُجريت المعايير أدناه على Intel® Core™ Ultra™ X7 358H وIntel® Core™ Ultra™ 7 258V وIntel® Core™ Ultra™ 7 155H بدقة FP32 وFP16 وINT8.
Intel® Core™ Ultra™ X7 358H#
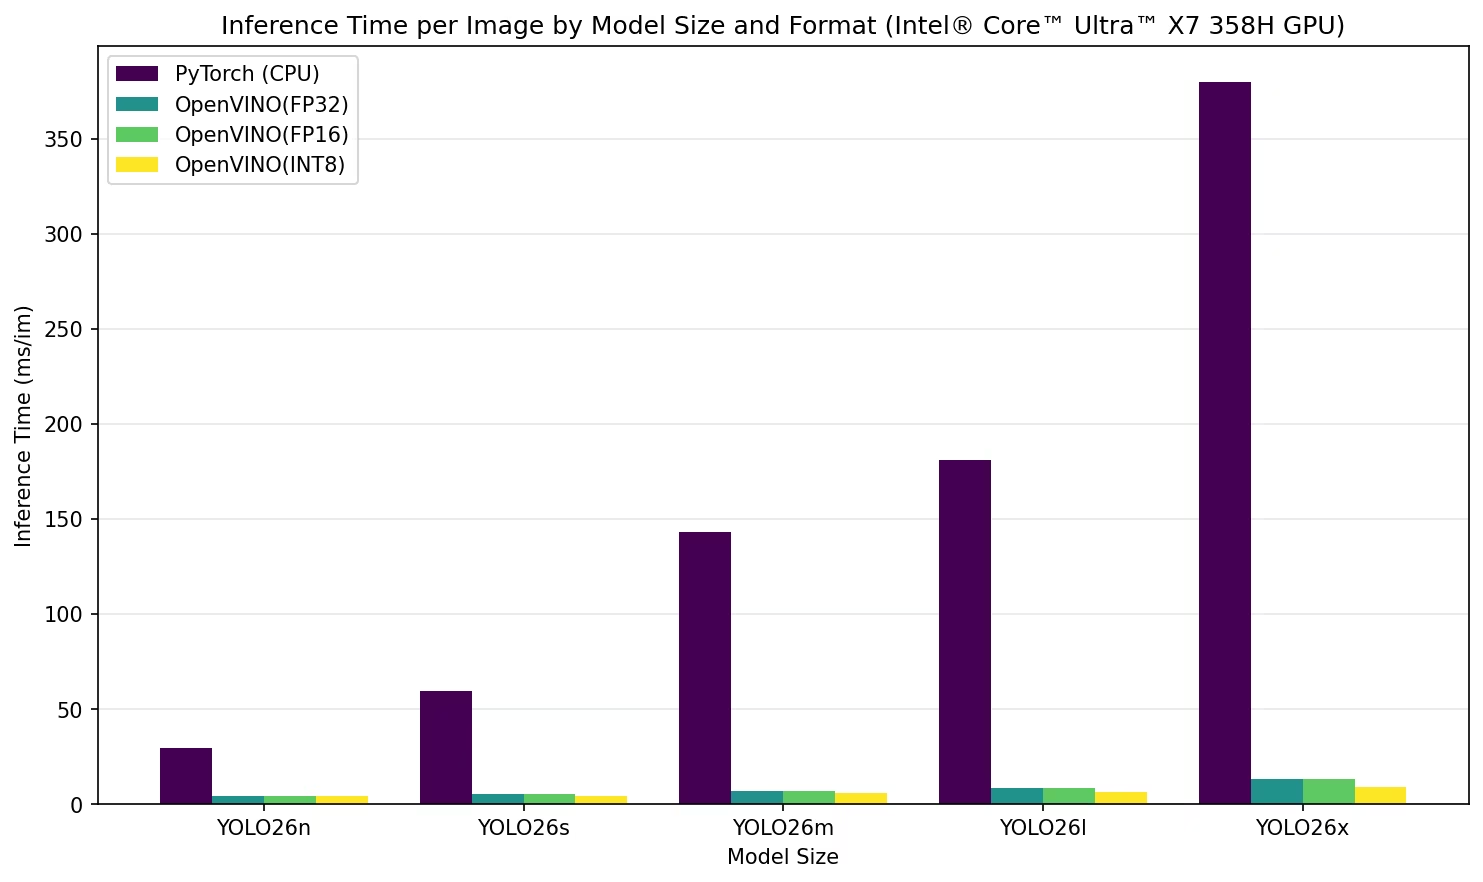
نتائج المعايير التفصيلية
| النموذج | التنسيق | الدقة | الحالة | الحجم (MB) | metrics/mAP50-95(B) | زمن الاستدلال (مللي ثانية/صورة) |
|---|---|---|---|---|---|---|
| YOLO26n | PyTorch (CPU) | FP32 | ✅ | 5.3 | 0.4765 | 29.28 |
| YOLO26n | OpenVINO | FP32 | ✅ | 9.7 | 0.4762 | 4.09 |
| YOLO26n | OpenVINO | FP16 | ✅ | 5.1 | 0.4762 | 4.03 |
| YOLO26n | OpenVINO | INT8 | ✅ | 3.2 | 0.4634 | 4.24 |
| YOLO26s | PyTorch (CPU) | FP32 | ✅ | 19.5 | 0.5703 | 59.32 |
| YOLO26s | OpenVINO | FP32 | ✅ | 36.7 | 0.5616 | 5.08 |
| YOLO26s | OpenVINO | FP16 | ✅ | 18.7 | 0.5616 | 5.14 |
| YOLO26s | OpenVINO | INT8 | ✅ | 10.0 | 0.5462 | 4.47 |
| YOLO26m | PyTorch (CPU) | FP32 | ✅ | 42.2 | 0.6196 | 143.21 |
| YOLO26m | OpenVINO | FP32 | ✅ | 78.4 | 0.6166 | 7.1 |
| YOLO26m | OpenVINO | FP16 | ✅ | 39.5 | 0.6166 | 7.06 |
| YOLO26m | OpenVINO | INT8 | ✅ | 20.6 | 0.6055 | 5.61 |
| YOLO26l | PyTorch (CPU) | FP32 | ✅ | 50.7 | 0.6215 | 181.16 |
| YOLO26l | OpenVINO | FP32 | ✅ | 95.3 | 0.6205 | 8.45 |
| YOLO26l | OpenVINO | FP16 | ✅ | 48.1 | 0.6205 | 8.49 |
| YOLO26l | OpenVINO | INT8 | ✅ | 25.2 | 0.5938 | 6.25 |
| YOLO26x | PyTorch (CPU) | FP32 | ✅ | 113.2 | 0.6512 | 379.75 |
| YOLO26x | OpenVINO | FP32 | ✅ | 213.3 | 0.6568 | 13.03 |
| YOLO26x | OpenVINO | FP16 | ✅ | 107.1 | 0.6568 | 12.98 |
| YOLO26x | OpenVINO | INT8 | ✅ | 54.8 | 0.6385 | 8.74 |
Intel® Core™ Ultra™ 7 258V#
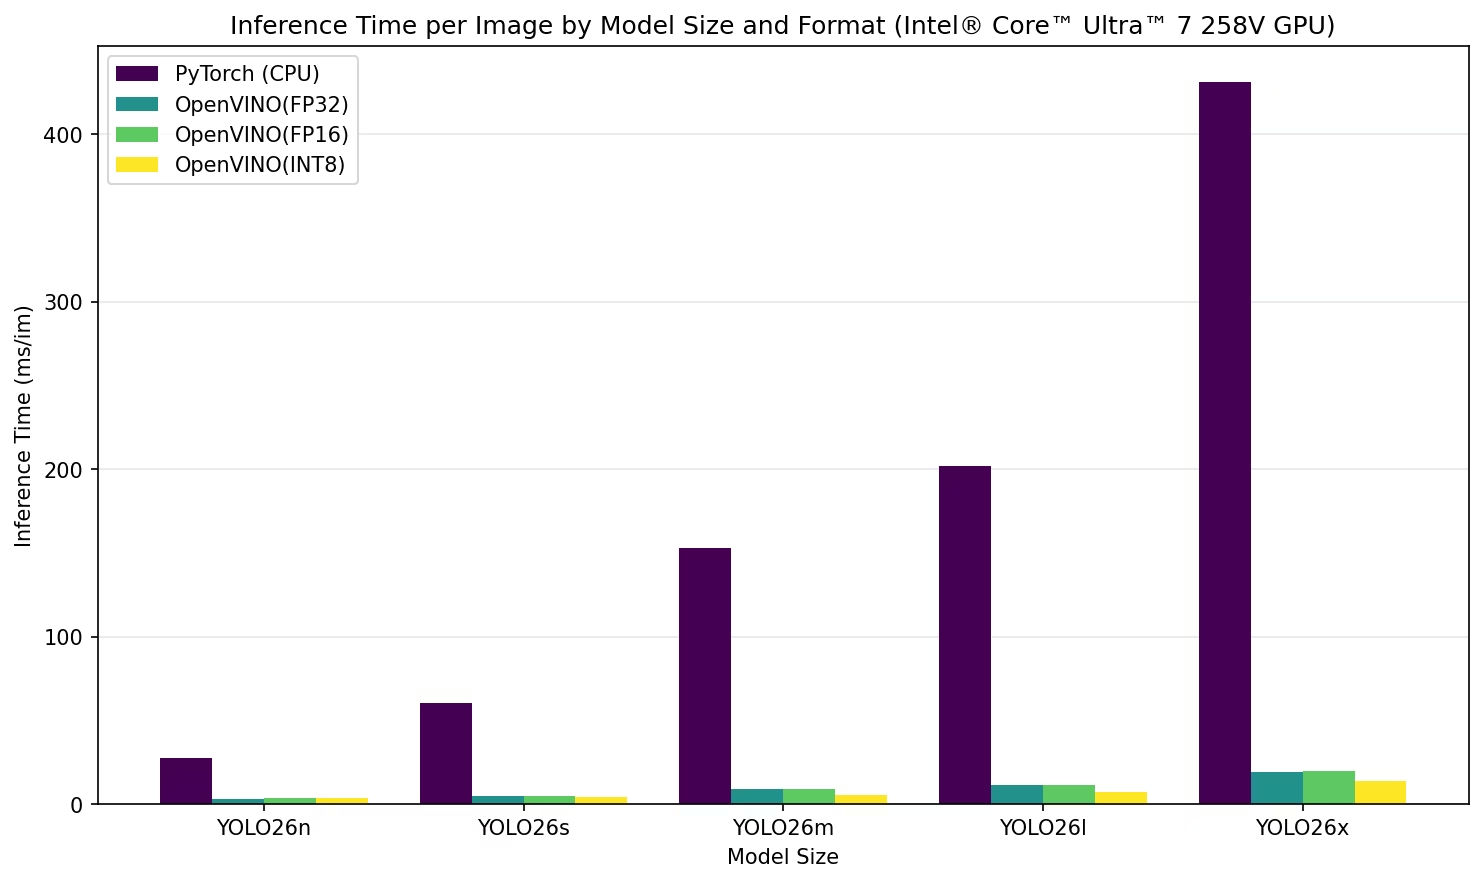
نتائج المعايير التفصيلية
| النموذج | التنسيق | الدقة | الحالة | الحجم (MB) | metrics/mAP50-95(B) | زمن الاستدلال (مللي ثانية/صورة) |
|---|---|---|---|---|---|---|
| YOLO26n | PyTorch (CPU) | FP32 | ✅ | 5.3 | 0.4765 | 27.33 |
| YOLO26n | OpenVINO | FP32 | ✅ | 9.6 | 0.4764 | 3.33 |
| YOLO26n | OpenVINO | FP16 | ✅ | 5.1 | 0.4764 | 3.34 |
| YOLO26n | OpenVINO | INT8 | ✅ | 3.2 | 0.4634 | 3.46 |
| YOLO26s | PyTorch (CPU) | FP32 | ✅ | 19.5 | 0.5703 | 60.2 |
| YOLO26s | OpenVINO | FP32 | ✅ | 36.7 | 0.5616 | 4.66 |
| YOLO26s | OpenVINO | FP16 | ✅ | 18.6 | 0.5616 | 4.65 |
| YOLO26s | OpenVINO | INT8 | ✅ | 10.0 | 0.5462 | 3.99 |
| YOLO26m | PyTorch (CPU) | FP32 | ✅ | 42.2 | 0.6196 | 152.87 |
| YOLO26m | OpenVINO | FP32 | ✅ | 78.4 | 0.6168 | 9.03 |
| YOLO26m | OpenVINO | FP16 | ✅ | 39.5 | 0.6168 | 8.98 |
| YOLO26m | OpenVINO | INT8 | ✅ | 20.6 | 0.6055 | 5.7 |
| YOLO26l | PyTorch (CPU) | FP32 | ✅ | 50.7 | 0.6215 | 201.57 |
| YOLO26l | OpenVINO | FP32 | ✅ | 95.3 | 0.6203 | 11.32 |
| YOLO26l | OpenVINO | FP16 | ✅ | 48.1 | 0.6203 | 11.36 |
| YOLO26l | OpenVINO | INT8 | ✅ | 25.2 | 0.5938 | 7.45 |
| YOLO26x | PyTorch (CPU) | FP32 | ✅ | 113.2 | 0.6512 | 431.04 |
| YOLO26x | OpenVINO | FP32 | ✅ | 213.2 | 0.6568 | 19.08 |
| YOLO26x | OpenVINO | FP16 | ✅ | 107.1 | 0.6568 | 19.63 |
| YOLO26x | OpenVINO | INT8 | ✅ | 54.8 | 0.6385 | 13.69 |
Intel® Core™ Ultra™ 7 155H#
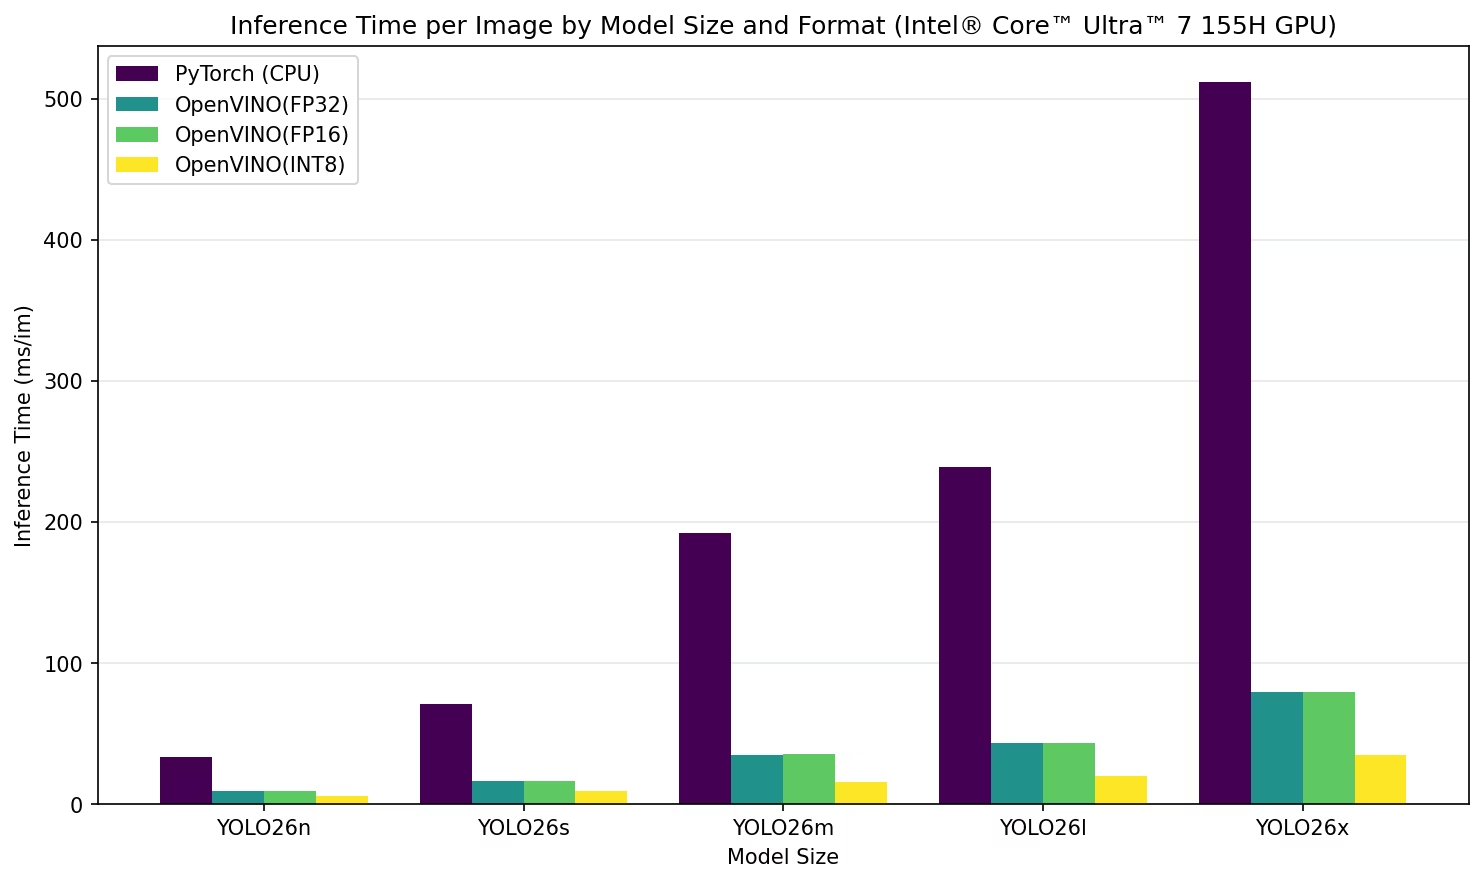
نتائج المعايير التفصيلية
| النموذج | التنسيق | الدقة | الحالة | الحجم (MB) | metrics/mAP50-95(B) | زمن الاستدلال (مللي ثانية/صورة) |
|---|---|---|---|---|---|---|
| YOLO26n | PyTorch (CPU) | FP32 | ✅ | 5.3 | 0.4765 | 33.19 |
| YOLO26n | OpenVINO | FP32 | ✅ | 9.6 | 0.4758 | 9.13 |
| YOLO26n | OpenVINO | FP16 | ✅ | 5.1 | 0.4758 | 9.07 |
| YOLO26n | OpenVINO | INT8 | ✅ | 3.2 | 0.4573 | 5.79 |
| YOLO26s | PyTorch (CPU) | FP32 | ✅ | 19.5 | 0.5703 | 70.92 |
| YOLO26s | OpenVINO | FP32 | ✅ | 36.7 | 0.5616 | 16.37 |
| YOLO26s | OpenVINO | FP16 | ✅ | 18.6 | 0.5616 | 16.65 |
| YOLO26s | OpenVINO | INT8 | ✅ | 10.0 | 0.545 | 9.27 |
| YOLO26m | PyTorch (CPU) | FP32 | ✅ | 42.2 | 0.6196 | 192.45 |
| YOLO26m | OpenVINO | FP32 | ✅ | 78.4 | 0.6167 | 34.47 |
| YOLO26m | OpenVINO | FP16 | ✅ | 39.5 | 0.6167 | 35.71 |
| YOLO26m | OpenVINO | INT8 | ✅ | 20.6 | 0.6039 | 15.46 |
| YOLO26l | PyTorch (CPU) | FP32 | ✅ | 50.7 | 0.6215 | 239.19 |
| YOLO26l | OpenVINO | FP32 | ✅ | 95.3 | 0.621 | 43.24 |
| YOLO26l | OpenVINO | FP16 | ✅ | 48.1 | 0.621 | 43.4 |
| YOLO26l | OpenVINO | INT8 | ✅ | 25.2 | 0.5999 | 19.72 |
| YOLO26x | PyTorch (CPU) | FP32 | ✅ | 113.2 | 0.6512 | 511.89 |
| YOLO26x | OpenVINO | FP32 | ✅ | 213.2 | 0.6552 | 79.49 |
| YOLO26x | OpenVINO | FP16 | ✅ | 107.1 | 0.6552 | 79.45 |
| YOLO26x | OpenVINO | INT8 | ✅ | 54.8 | 0.642 | 34.66 |
إعادة إنتاج نتائجنا#
لإعادة إنتاج معايير Ultralytics أعلاه على جميع تنسيقات التصدير، شغّل هذا الرمز:
from ultralytics import YOLO

# Load a YOLO26n PyTorch model
model = YOLO("yolo26n.pt")

# Benchmark YOLO26n speed and accuracy on the COCO128 dataset for all export formats
results = model.benchmark(data="coco128.yaml")
لاحظ أن نتائج الاختبارات المعيارية قد تختلف حسب تكوين الأجهزة والبرامج الدقيق للنظام، بالإضافة إلى عبء العمل الحالي على النظام وقت إجراء الاختبارات. وللحصول على نتائج أكثر موثوقية، استخدم مجموعة بيانات تحتوي على عدد كبير من الصور، مثل data='coco.yaml' (5000 صورة للتحقق).
الخلاصة#
توضح نتائج الاختبارات المعيارية بجلاء فوائد تصدير نموذج YOLO26 إلى تنسيق OpenVINO. فعبر نماذج ومنصات أجهزة مختلفة، يتفوق تنسيق OpenVINO باستمرار على التنسيقات الأخرى من حيث سرعة الاستدلال، مع الحفاظ على دقة مماثلة.
تؤكد المعايير فعالية OpenVINO كأداة لنشر نماذج التعلم العميق. ومن خلال تحويل النماذج إلى تنسيق OpenVINO، يمكن للمطورين تحقيق تحسينات كبيرة في الأداء، مما يسهّل نشر هذه النماذج في التطبيقات الواقعية.
لمزيد من المعلومات والتعليمات التفصيلية حول استخدام OpenVINO، راجع توثيق OpenVINO الرسمي.
الأسئلة الشائعة#
يمكن أن يؤدي تصدير نماذج YOLO26 إلى تنسيق OpenVINO إلى تحسين سرعة CPU بدرجة كبيرة وتمكين التسريع باستخدام GPU وNPU على أجهزة Intel. وللتصدير، يمكنك استخدام Python أو CLI كما هو موضح أدناه:
مثالfrom ultralytics import YOLO # Load a YOLO26n PyTorch model model = YOLO("yolo26n.pt") # Export the model model.export(format="openvino") # creates 'yolo26n_openvino_model/'لمزيد من المعلومات، راجع توثيق تنسيقات التصدير.
يوفر استخدام مجموعة أدوات OpenVINO من Intel مع نماذج YOLO26 فوائد عديدة:
- الأداء: تحقيق تسريع يصل إلى 3 أضعاف في استدلال CPU والاستفادة من وحدات GPU وNPU من Intel للتسريع.
- محسّن النماذج: تحويل النماذج من أطر شائعة مثل PyTorch وTensorFlow وONNX وتحسينها وتنفيذها.
- سهولة الاستخدام: تتوفر مجموعة كبيرة من دفاتر الملاحظات التعليمية لمساعدة المستخدمين على البدء، بما في ذلك دفاتر مخصصة لـ YOLO26.
- التنفيذ غير المتجانس: نشر النماذج على أجهزة Intel متنوعة باستخدام واجهة API موحدة.
للاطلاع على مقارنات أداء تفصيلية، زُر قسم المعايير.
بعد تصدير نموذج YOLO26n إلى تنسيق OpenVINO، يمكنك إجراء الاستدلال باستخدام Python أو CLI:
مثالfrom ultralytics import YOLO # Load the exported OpenVINO model ov_model = YOLO("yolo26n_openvino_model/") # Run inference results = ov_model("https://ultralytics.com/images/bus.jpg")راجع توثيق وضع التنبؤ لمزيد من التفاصيل.
تم تحسين Ultralytics YOLO26 للكشف عن الأجسام في الوقت الفعلي بدقة وسرعة عاليتين. وعند دمجه مع OpenVINO، يوفر YOLO26 تحديدًا ما يلي:
- تسريع يصل إلى 3 أضعاف على وحدات CPU من Intel
- نشرًا سلسًا على وحدات GPU وNPU من Intel
- دقة ثابتة ومماثلة عبر تنسيقات التصدير المختلفة
لتحليل أداء متعمق، راجع معايير YOLO26 التفصيلية لدينا على أجهزة مختلفة.
نعم، يمكنك إجراء اختبارات معيارية لنماذج YOLO26 بتنسيقات متنوعة، بما في ذلك PyTorch وTorchScript وONNX وOpenVINO. استخدم مقتطف الرمز التالي لإجراء الاختبارات على مجموعة البيانات التي تختارها:
مثالfrom ultralytics import YOLO # Load a YOLO26n PyTorch model model = YOLO("yolo26n.pt") # Benchmark YOLO26n speed and [accuracy](https://www.ultralytics.com/glossary/accuracy) on the COCO8 dataset for all export formats results = model.benchmark(data="coco8.yaml")للاطلاع على نتائج المعايير التفصيلية، راجع قسم المعايير وتوثيق تنسيقات التصدير.