SAM 2: نموذج تقسيم أي شيء 2

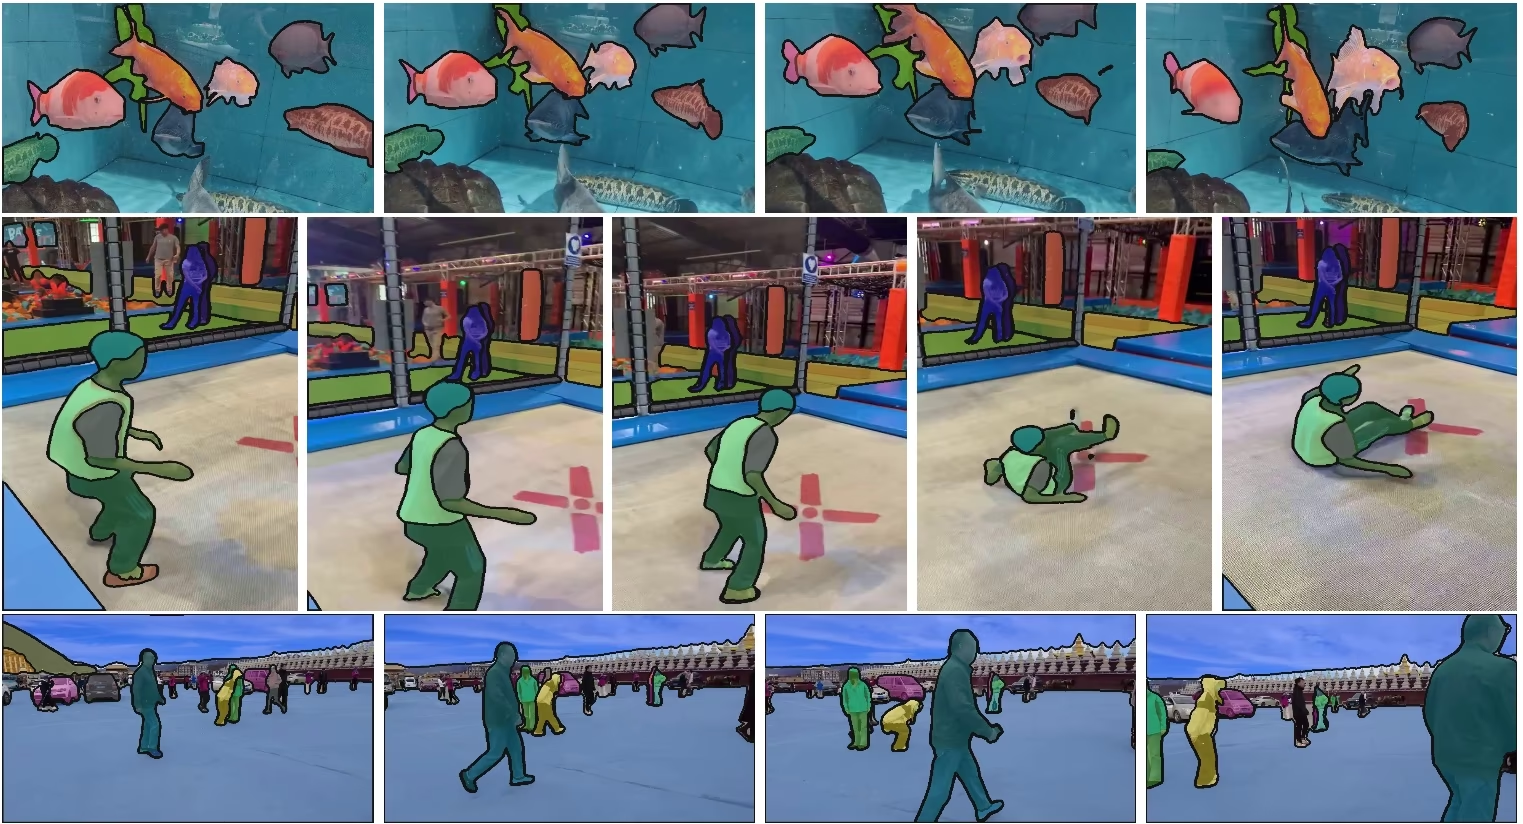
SAM 2، وهو خليفة نموذج Meta لتقسيم كل شيء (SAM)، نموذج موحّد لتقسيم الأجسام القابل للتوجيه في الصور ومقاطع الفيديو على حد سواء. وتدعم بنيته الموحدة القابلة للتوجيه المعالجة الآنية والتعميم دون تدريب مسبق.
تُشغّل نماذج SAM 2.1 ميزة التعليق التوضيحي الذكي على منصة Ultralytics، ما يتيح التقسيم بالنقر لتسريع وسم مجموعات البيانات. راجع دليل التعليق التوضيحي للاطّلاع على التفاصيل.
الميزات الرئيسية#
شاهد: كيفية إجراء الاستدلال باستخدام SAM2 من Meta عبر Ultralytics | دليل خطوة بخطوة
بنية موحّدة للنموذج#
يجمع SAM 2 قدرات تقسيم الصور ومقاطع الفيديو في نموذج واحد. ويسهّل هذا التوحيد عملية النشر ويتيح أداءً متسقًا عبر أنواع الوسائط المختلفة. ويستخدم واجهة مرنة قائمة على المطالبات، تتيح للمستخدمين تحديد الأجسام محل الاهتمام عبر أنواع مختلفة من المطالبات، مثل النقاط أو المربعات المحيطة أو الأقنعة.
أداء آني#
يحقق النموذج سرعات استدلال آنية، إذ يعالج نحو 44 إطارًا في الثانية. وهذا يجعل SAM 2 مناسبًا للتطبيقات التي تتطلب استجابة فورية، مثل تحرير الفيديو والواقع المعزز.
التعميم دون تدريب مسبق#
يمكن لـ SAM 2 تقسيم الكائنات التي لم يسبق له مصادفتها، ما يُظهر قدرة قوية على التعميم دون أمثلة سابقة. ويُعد ذلك مفيدًا بصفة خاصة في المجالات المرئية المتنوعة أو المتغيرة، حيث قد لا تغطي الفئات المحددة مسبقًا جميع الكائنات المحتملة.
التحسين التفاعلي#
يمكن للمستخدمين تحسين نتائج التقسيم تكراريًا عبر تقديم مطالبات إضافية، ما يتيح التحكم الدقيق في المخرجات. ويُعد هذا التفاعل ضروريًا لتحسين النتائج في تطبيقات مثل التعليق التوضيحي على الفيديو أو التصوير الطبي.
التعامل المتقدم مع التحديات المرئية#
يتضمن SAM 2 آليات لمعالجة التحديات الشائعة في تقسيم الفيديو، مثل احتجاب الأجسام وظهورها مجددًا. ويستخدم آلية ذاكرة لتتبع الأجسام عبر الإطارات، بما يضمن استمرارية التتبع حتى عندما تُحجب الأجسام مؤقتًا أو تخرج من المشهد ثم تعود إليه.
للتعمق في فهم بنية SAM 2 وإمكاناته، اطّلع على ورقة البحث الخاصة بـ SAM 2.
الأداء والتفاصيل التقنية#
وفقًا لـMeta، يتفوق SAM 2 على النماذج السابقة في عدة مقاييس:
| المقياس | SAM 2 | أفضل مستوى سابق (SOTA) |
|---|---|---|
| تقسيم الفيديو التفاعلي | الأفضل | - |
| التفاعلات البشرية المطلوبة | أقل بثلاث مرات | خط الأساس |
| دقة تقسيم الصور | مُحسّن | SAM |
| سرعة الاستدلال | أسرع بست مرات | SAM |
بنية النموذج#
المكونات الأساسية#
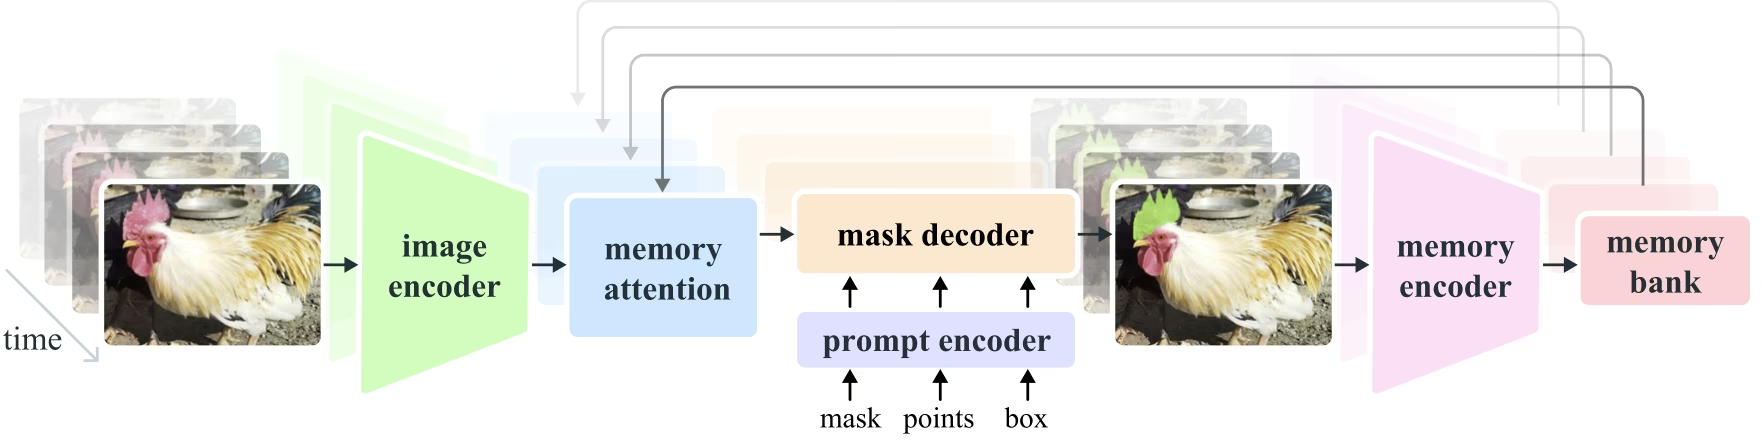
- مُشفّر الصور والفيديو: يستخدم بنية قائمة على Transformer لاستخراج السمات عالية المستوى من الصور وإطارات الفيديو. ويتولى هذا المكوّن فهم المحتوى المرئي في كل خطوة زمنية.
- مُشفّر المطالبات: يعالج المطالبات التي يقدمها المستخدم (النقاط والمربعات والأقنعة) لتوجيه مهمة التقسيم. ويتيح ذلك لـ SAM 2 التكيف مع مدخلات المستخدم واستهداف كائنات محددة ضمن المشهد.
- آلية الذاكرة: تتضمن مُرمّز ذاكرة وبنك ذاكرة ووحدة انتباه الذاكرة. تخزّن هذه المكونات المعلومات من الإطارات السابقة وتستخدمها مجتمعةً، ما يمكّن النموذج من الحفاظ على تتبع الأجسام باستمرار بمرور الوقت.
- مُفكّك ترميز القناع: يُنشئ أقنعة التقسيم النهائية استنادًا إلى سمات الصورة والمطالبات المُرمّزة. وفي الفيديو، يستخدم أيضًا سياق الذاكرة لضمان دقة التتبّع عبر الإطارات.
آلية الذاكرة والتعامل مع الاحتجاب#
تتيح آلية الذاكرة لـ SAM 2 التعامل مع التبعيات الزمنية والاحتجاب في بيانات الفيديو. فمع تحرك الكائنات وتفاعلها، يسجل SAM 2 سماتها في بنك الذاكرة. وعندما يُحجب كائن، يستطيع النموذج الاستناد إلى هذه الذاكرة للتنبؤ بموقعه ومظهره عند ظهوره مجددًا. ويتولى رأس الاحتجاب تحديدًا التعامل مع الحالات التي لا تكون فيها الكائنات مرئية، إذ يتنبأ باحتمال احتجاب الكائن.
حلّ الالتباس بين الأقنعة المتعددة#
في حالات الالتباس (مثل تداخل الأجسام)، يستطيع SAM 2 إنشاء تنبؤات متعددة للأقنعة. ويساعد ذلك على تمثيل المشاهد المعقدة التي قد لا يلتقط فيها قناع واحد الجسم المقصود.
مجموعة بيانات SA-V#
تُعد مجموعة بيانات SA-V، التي طُوّرت لتدريب SAM 2، واحدة من أكبر مجموعات بيانات تقسيم الفيديو وأكثرها تنوعًا. وتشمل:
- أكثر من 51,000 مقطع فيديو: جُمعت في 47 دولة، وتوفر نطاقًا واسعًا من سيناريوهات العالم الحقيقي.
- أكثر من 600,000 شرح للقناع: شروح تفصيلية مكانية وزمنية للأقنعة، تُعرف باسم «masklets»، وتغطي الكائنات كاملةً وأجزاءها.
- حجم مجموعة البيانات: تضم 4.5 أضعاف عدد مقاطع الفيديو و53 ضعف عدد التعليقات التوضيحية مقارنةً بأكبر مجموعات بيانات تقسيم الفيديو السابقة.
المعايير المرجعية#
تقسيم كائنات الفيديو#
يحقق SAM 2 النتائج التالية على معايير تقسيم الفيديو الرئيسية:
| مجموعة البيانات | J&F | J | F |
|---|---|---|---|
| DAVIS 2017 | 82.5 | 79.8 | 85.2 |
| YouTube-VOS | 81.2 | 78.9 | 83.5 |
التقسيم التفاعلي#
يحقق SAM 2 النتائج التالية في مهام التقسيم التفاعلي:
| مجموعة البيانات | NoC@90 | AUC |
|---|---|---|
| DAVIS التفاعلي | 1.54 | 0.872 |
التثبيت#
يُضمّن SAM 2 في حزمة ultralytics. ثبّته باستخدام الأمر التالي؛ إذ تُنزّل أوزان SAM 2 تلقائيًا عند الاستخدام لأول مرة.
pip install ultralyticsكيفية استخدام SAM 2: تعدد الاستخدامات في تقسيم الصور والفيديو#
يفصّل الجدول التالي نماذج SAM 2 المتاحة وأوزانها المدرّبة مسبقًا والمهام المدعومة وتوافقها مع أوضاع التشغيل المختلفة، مثل التدريب والتحقق والاستدلال والتصدير.
| نوع النموذج | الأوزان المدرّبة مسبقاً | المهام المدعومة | التدريب | التحقق | الاستدلال | التصدير |
|---|---|---|---|---|---|---|
| SAM 2 صغير جدًا | sam2_t.pt | تجزئة الكائنات | ❌ | ❌ | ✅ | ❌ |
| SAM 2 صغير | sam2_s.pt | تجزئة الكائنات | ❌ | ❌ | ✅ | ❌ |
| SAM 2 أساسي | sam2_b.pt | تجزئة الكائنات | ❌ | ❌ | ✅ | ❌ |
| SAM 2 كبير | sam2_l.pt | تجزئة الكائنات | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 صغير جدًا | sam2.1_t.pt | تجزئة الكائنات | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 صغير | sam2.1_s.pt | تجزئة الكائنات | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 أساسي | sam2.1_b.pt | تجزئة الكائنات | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 كبير | sam2.1_l.pt | تجزئة الكائنات | ❌ | ❌ | ✅ | ❌ |
أمثلة على تنبؤات SAM 2#
يمكن استخدام SAM 2 في مجموعة واسعة من المهام، تشمل تحرير الفيديو في الوقت الفعلي والتصوير الطبي والأنظمة الذاتية. وتجعله قدرته على تقسيم البيانات المرئية الثابتة والديناميكية أداة متعددة الاستخدامات للباحثين والمطورين.
التقسيم باستخدام المطالبات#
استخدم المطالبات لتقسيم كائنات محددة في الصور أو مقاطع الفيديو.
from ultralytics import SAM
# تحميل نموذج
model = SAM("sam2.1_b.pt")
# عرض معلومات النموذج (اختياري)
model.info()
# تنفيذ الاستدلال باستخدام مطالبة المربعات المحيطة
results = model("path/to/image.jpg", bboxes=[100, 100, 200, 200])
# تنفيذ الاستدلال باستخدام نقطة واحدة
results = model(points=[900, 370], labels=[1])
# تنفيذ الاستدلال باستخدام نقاط متعددة
results = model(points=[[400, 370], [900, 370]], labels=[1, 1])
# تنفيذ الاستدلال باستخدام مطالبة نقاط متعددة لكل كائن
results = model(points=[[[400, 370], [900, 370]]], labels=[[1, 1]])
# تنفيذ الاستدلال باستخدام مطالبة نقاط سلبية
results = model(points=[[[400, 370], [900, 370]]], labels=[[1, 0]])تقسيم كل شيء#
قسّم محتوى الصورة أو الفيديو بأكمله دون مطالبات محددة.
from ultralytics import SAM
# تحميل نموذج
model = SAM("sam2.1_b.pt")
# عرض معلومات النموذج (اختياري)
model.info()
# تنفيذ الاستدلال
model("path/to/video.mp4")- يوضح هذا المثال كيفية استخدام SAM 2 لتقسيم محتوى الصورة أو الفيديو بأكمله عند عدم تقديم أي مطالبات (مربعات محيطة/نقاط/أقنعة).
تقسيم الفيديو وتتبع الكائنات#
قسّم محتوى الفيديو بأكمله باستخدام مطالبات محددة وتتبع الكائنات.
from ultralytics.models.sam import SAM2VideoPredictor
# Create SAM2VideoPredictor
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "imgsz": 1024, "model": "sam2_b.pt"}
predictor = SAM2VideoPredictor(overrides=overrides)
# تنفيذ الاستدلال باستخدام نقطة واحدة
results = predictor(source="test.mp4", points=[920, 470], labels=[1])
# تنفيذ الاستدلال باستخدام نقاط متعددة
results = predictor(source="test.mp4", points=[[920, 470], [909, 138]], labels=[1, 1])
# تنفيذ الاستدلال باستخدام مطالبة نقاط متعددة لكل كائن
results = predictor(source="test.mp4", points=[[[920, 470], [909, 138]]], labels=[[1, 1]])
# تنفيذ الاستدلال باستخدام مطالبة نقاط سلبية
results = predictor(source="test.mp4", points=[[[920, 470], [909, 138]]], labels=[[1, 0]])التقسيم والتتبّع التفاعلي الديناميكي#
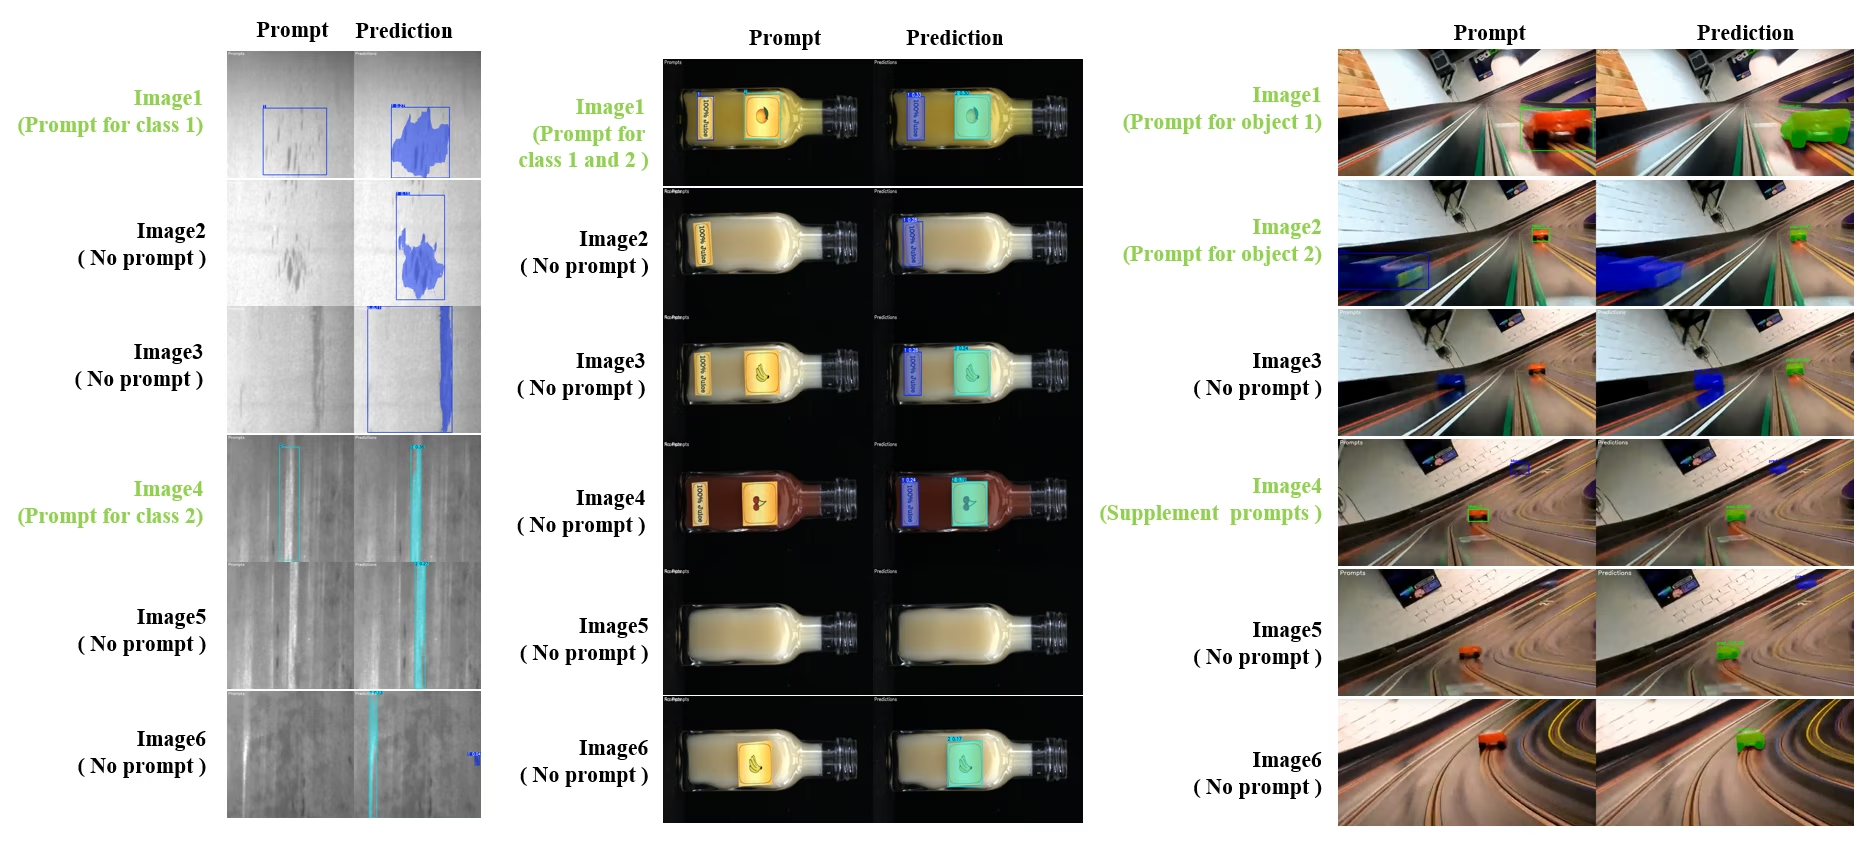
SAM2DynamicInteractivePredictor امتداد لـSAM 2 لا يتطلب تدريبًا، ويتيح التفاعل الديناميكي مع إطارات متعددة وقدرات التعلم المستمر. يدعم هذا المتنبئ تحديث المطالبات وإدارة الذاكرة في الوقت الفعلي لتحسين أداء التتبع عبر سلسلة من الصور. وبالمقارنة مع SAM 2 الأصلي، يعيد SAM2DynamicInteractivePredictor بناء تدفق الاستدلال للاستفادة القصوى من نماذج SAM 2 المدرّبة مسبقًا دون الحاجة إلى تدريب إضافي.
الميزات الرئيسية#
يقدم ثلاثة تحسينات:
- التفاعل الديناميكي: أضف مطالبات لحالات جديدة غير متتبعة في إطارات لاحقة، في أي وقت أثناء معالجة الفيديو.
- التعلم المستمر: أضف مطالبات جديدة للمثيلات الموجودة لتحسين أداء النموذج بمرور الوقت
- دعم الصور المتعددة المستقلة: عالج صورًا مستقلة متعددة (ليس بالضرورة أن تكون من تسلسل فيديو) مع مشاركة الذاكرة وتتبع الكائنات بين الصور
الإمكانات الأساسية#
- مرونة المطالبات: يقبل المربعات المحيطة والنقاط والأقنعة بوصفها مطالبات
- إدارة بنك الذاكرة: يحافظ على بنك ذاكرة ديناميكي لتخزين حالات الكائنات عبر الإطارات
- تتبّع كائنات متعددة: يدعم تتبّع عدة كائنات في الوقت نفسه، مع معرّف مستقل لكل كائن
- التحديثات في الوقت الفعلي: يتيح إضافة مطالبات جديدة أثناء الاستدلال دون إعادة معالجة الإطارات السابقة
- معالجة الصور المستقلة: عالج صورًا منفردة باستخدام سياق ذاكرة مشترك لضمان اتساق الكائنات بين الصور
from ultralytics.models.sam import SAM2DynamicInteractivePredictor
# Create SAM2DynamicInteractivePredictor
overrides = {"conf": 0.01, "task": "segment", "mode": "predict", "imgsz": 1024, "model": "sam2_t.pt", "save": False}
predictor = SAM2DynamicInteractivePredictor(overrides=overrides, max_obj_num=10)
# حدّد فئة باستخدام مطالبة مربع
predictor(source="image1.jpg", bboxes=[[100, 100, 200, 200]], obj_ids=[0], update_memory=True)
# اكتشف هذا الكائن تحديدًا في صورة جديدة
results = predictor(source="image2.jpg")
# أضف فئة جديدة باستخدام معرّف كائن جديد
results = predictor(
source="image4.jpg",
bboxes=[[300, 300, 400, 400]], # كائن جديد
obj_ids=[1], # معرّف كائن جديد
update_memory=True, # أضف إلى الذاكرة
)
# نفّذ الاستدلال
results = predictor(source="image5.jpg")
# أضف مطالبات التنقيح إلى الفئة نفسها لتحسين الأداء
# يساعد ذلك عندما يتغير مظهر الكائن بدرجة كبيرة
results = predictor(
source="image6.jpg",
points=[[150, 150]], # نقطة تنقيح
labels=[1], # نقطة موجبة
obj_ids=[1], # معرّف الكائن نفسه
update_memory=True, # حدّث الذاكرة بمعلومات جديدة
)
# نفّذ الاستدلال على صورة جديدة
results = predictor(source="image7.jpg")صُمّم SAM2DynamicInteractivePredictor للعمل مع نماذج SAM 2، ويدعم إضافة الفئات وتنقيحها باستخدام جميع مطالبات المربعات والنقاط والأقنعة التي يدعمها SAM 2 أصليًا. وهو مفيد على نحو خاص في الحالات التي تظهر فيها الكائنات أو تتغير بمرور الوقت، مثل وسم مقاطع الفيديو أو مهام التحرير التفاعلي.
الوسيطات#
| الاسم | القيمة الافتراضية | نوع البيانات | الوصف |
|---|---|---|---|
max_obj_num | 3 | int | العدد الأقصى المحدد مسبقًا للفئات |
update_memory | False | bool | ما إذا كان ينبغي تحديث الذاكرة بمطالبات جديدة |
obj_ids | None | List[int] | قائمة بمعرّفات الكائنات المقابلة للمطالبات |
حالات الاستخدام#
يُعد SAM2DynamicInteractivePredictor مثاليًا لما يلي:
- سير عمل وسم مقاطع الفيديو الذي تظهر فيه كائنات جديدة أثناء التسلسل
- تحرير مقاطع الفيديو تفاعليًا، الذي يتطلب إضافة الكائنات وتنقيحها في الوقت الفعلي
- تطبيقات المراقبة التي تتطلب تعقبًا ديناميكيًا للكائنات
- التصوير الطبي لتعقب البنى التشريحية عبر السلاسل الزمنية
- الأنظمة ذاتية التشغيل التي تتطلب كشفًا تكيفيًا للكائنات وتعقبها
- مجموعات البيانات متعددة الصور لتحقيق تجزئة متسقة للكائنات عبر صور مستقلة
- تحليل مجموعات الصور التي يلزم فيها تعقب الكائنات عبر مشاهد مختلفة
- التجزئة عبر المجالات بالاستفادة من الذاكرة المستمدة من سياقات صور متنوعة
- الوسم شبه التلقائي لإنشاء مجموعات البيانات بكفاءة مع الحد الأدنى من التدخل اليدوي
مقارنة SAM بنماذج YOLO#
نقارن هنا نماذج SAM 2 من Meta، بما فيها أصغر نموذج SAM2-t، بنماذج Ultralytics للتقسيم، ومنها YOLO26:
| النموذج | الحجم (MB) | المعلمات (M) | السرعة (CPU) (مللي ثانية/صورة) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 41703 |
| Meta SAM2-b | 162 | 80.8 | 28867 |
| Meta SAM2-t | 78.1 | 38.9 | 23430 |
| MobileSAM | 40.7 | 10.1 | 23802 |
| FastSAM-s مع البنية الأساسية لـ YOLOv8 | 23.9 | 11.8 | 58.0 |
| Ultralytics YOLOv8n-seg | 7.1 (أصغر 11.0 مرة) | 3.4 (أقل 11.4 مرة) | 24.8 (أسرع 945 مرة) |
| Ultralytics YOLO11n-seg | 6.2 (أصغر 12.6 مرة) | 2.9 (أقل 13.4 مرة) | 24.3 (أسرع 964 مرة) |
| Ultralytics YOLO26n-seg | 6.7 (أصغر 11.7 مرة) | 2.7 (أقل 14.4 مرة) | 25.2 (أسرع 930 مرة) |
تُظهر هذه المقارنة الفروق الكبيرة في أحجام النماذج وسرعاتها بين إصدارات SAM ونماذج تقسيم YOLO. وعلى الرغم من أن SAM يوفر إمكانات فريدة للتقسيم التلقائي، فإن نماذج YOLO، ولا سيما YOLOv8n-seg وYOLO11n-seg وYOLO26n-seg، أصغر وأسرع وأكثر كفاءة حسابيًا بدرجة كبيرة.
قِيسَت سرعات SAM باستخدام PyTorch، وسرعات YOLO باستخدام ONNX Runtime. أُجريت الاختبارات على Apple M4 Air لعام 2025 بذاكرة RAM سعتها 16GB باستخدام torch==2.10.0 وultralytics==8.4.31 وonnxruntime==1.24.4. لإعادة إجراء هذا الاختبار:
from ultralytics import ASSETS, SAM, YOLO, FastSAM
# تحليل أداء SAM2-t وSAM2-b وSAM-b وMobileSAM
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt"]:
model = SAM(file)
model.info()
model(ASSETS)
# أنشئ ملفًا تعريفيًا لـ FastSAM-s
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)
# تحليل أداء نماذج YOLO (ONNX)
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
model = YOLO(file_name)
model.info()
onnx_path = model.export(format="onnx", dynamic=True, nms=False) # رأس NMS-free في YOLO26؛ لا إجراء لـ YOLOv8/YOLO11
model = YOLO(onnx_path)
model(ASSETS)الوسم التلقائي: إنشاء مجموعات البيانات بكفاءة#
يجمع التعليق التوضيحي التلقائي بين SAM 2 ونموذج كشف مدرّب مسبقًا لإنشاء مجموعات بيانات للتقسيم بسرعة، دون الحاجة إلى كثير من الوسم اليدوي. وتوفر منصة Ultralytics أيضًا تعليقًا توضيحيًا تلقائيًا عبر المتصفح باستخدام نماذج رؤية مستضافة؛ قارن دقة كشفها وتكلفتها وسرعتها على لوحة متصدرّي VLM.
كيفية إجراء الوسم التلقائي باستخدام SAM 2#
شاهد: التعليق التوضيحي التلقائي باستخدام نموذج Segment Anything 2 من Meta عبر Ultralytics | وسم البيانات
لإضافة تعليقات توضيحية تلقائيًا إلى مجموعة بياناتك باستخدام كاشف YOLO26x وSAM 2، اتبع هذا المثال:
from ultralytics.data.annotator import auto_annotate

auto_annotate(data="path/to/images", det_model="yolo26x.pt", sam_model="sam2_b.pt")| المعامل | النوع | الافتراضي | الوصف |
|---|---|---|---|
data | str | مطلوب | مسار الدليل الذي يحتوي على الصور المستهدفة المراد وسمها أو تجزئتها. |
det_model | str | 'yolo26x.pt' | مسار نموذج كشف YOLO لإجراء الكشف الأولي عن الكائنات. |
sam_model | str | 'sam_b.pt' | مسار نموذج SAM لإجراء التجزئة (يدعم أوزان SAM وSAM 2 وMobileSAM وSAM 3). |
device | str | '' | جهاز الحوسبة (مثل 'cuda:0' أو 'cpu' أو '' للكشف التلقائي عن الجهاز). |
conf | float | 0.25 | عتبة الثقة لكشف YOLO لتصفية الكشوفات ضعيفة الثقة. |
iou | float | 0.5 | عتبة IoU لكبت غير الأقصى لتصفية المربعات المتداخلة. |
imgsz | int | 640 | حجم الإدخال لتغيير أبعاد الصور (يُقرّب إلى أقرب مضاعف للعدد 32 عند الحاجة). |
max_det | int | 300 | الحد الأقصى لعدد الكشوفات لكل صورة لترشيد استخدام الذاكرة. |
classes | list[int] | None | قائمة بمؤشرات الفئات المراد كشفها (مثل [0, 1] للشخص والدراجة). |
output_dir | str | None | دليل حفظ الوسوم (الافتراضي: الدليل الشقيق <data>_auto_annotate_labels). |
تحوّل هذه الدالة مجلدًا من الصور غير المصنفة إلى مجموعة بيانات للتقسيم بأقل جهد يدوي.
القيود#
على الرغم من نقاط قوته، يواجه SAM 2 بعض القيود:
- استقرار التعقب: قد يفقد SAM 2 تعقب الكائنات خلال التسلسلات الطويلة أو عند حدوث تغييرات كبيرة في زاوية الرؤية.
- الخلط بين الكائنات: قد يخلط النموذج أحيانًا بين الكائنات المتشابهة في المظهر، ولا سيما في المشاهد المزدحمة.
- الكفاءة مع تعدد الكائنات: تنخفض كفاءة التجزئة عند معالجة عدة كائنات في الوقت نفسه بسبب غياب التواصل بين الكائنات.
- دقة التفاصيل: قد لا يرصد التفاصيل الدقيقة، ولا سيما في حالة الكائنات سريعة الحركة. ويمكن للمطالبات الإضافية معالجة هذه المشكلة جزئيًا، لكن لا يوجد ضمان للسلاسة الزمنية.
الاستشهادات والشكر والتقدير#
إذا استخدمت SAM 2 في أبحاثك أو أعمال التطوير، يُرجى الاستشهاد به باستخدام المرجع التالي:
@article{ravi2024sam2,
  title={SAM 2: Segment Anything in Images and Videos},
  author={Ravi, Nikhila and Gabeur, Valentin and Hu, Yuan-Ting and Hu, Ronghang and Ryali, Chaitanya and Ma, Tengyu and Khedr, Haitham and R{\"a}dle, Roman and Rolland, Chloe and Gustafson, Laura and Mintun, Eric and Pan, Junting and Alwala, Kalyan Vasudev and Carion, Nicolas and Wu, Chao-Yuan and Girshick, Ross and Doll{\'a}r, Piotr and Feichtenhofer, Christoph},
  journal={arXiv preprint},
  year={2024}
}
نشكر Meta AI على إتاحة هذا النموذج ومجموعة البيانات لمجتمع الذكاء الاصطناعي.
الأسئلة الشائعة#
SAM 2، خليفة نموذج Meta لتقسيم أي شيء (SAM)، هو نموذج موحّد قابل للتوجيه بالمطالبات لتقسيم الكائنات في الصور ومقاطع الفيديو. يقدم SAM 2 عدة تحسينات مقارنةً بنموذج SAM الأصلي، منها:
- بنية موحدة للنموذج: تجمع إمكانات تجزئة الصور ومقاطع الفيديو في نموذج واحد.
- الأداء في الوقت الفعلي: يعالج نحو 44 إطارًا في الثانية، ما يجعله مناسبًا للتطبيقات التي تتطلب استجابة فورية.
- التعميم دون أمثلة: يجزّئ كائنات لم يسبق له مصادفتها، وهو ما يفيد في مجالات مرئية متنوعة.
- التنقيح التفاعلي: يتيح للمستخدمين تنقيح نتائج التجزئة تكراريًا من خلال تقديم مطالبات إضافية.
- التعامل المتقدم مع التحديات المرئية: يعالج تحديات تجزئة الفيديو الشائعة، مثل احتجاب الكائنات وظهورها مجددًا.
لمزيد من التفاصيل حول بنية SAM 2 وإمكاناته، اطّلع على ورقة البحث الخاصة بـSAM 2.
يدعم SAM 2 تقسيم الفيديو في الوقت الفعلي عبر واجهته القابلة للتوجيه بالمطالبات والاستدلال السريع. إليك مثالًا أساسيًا:
التقسيم باستخدام المطالباتاستخدم المطالبات لتقسيم كائنات محددة في الصور أو مقاطع الفيديو.
from ultralytics import SAM # تحميل نموذج model = SAM("sam2_b.pt") # عرض معلومات النموذج (اختياري) model.info() # التجزئة باستخدام مطالبة مربع إحاطة results = model("path/to/image.jpg", bboxes=[100, 100, 200, 200]) # التجزئة باستخدام مطالبة نقطة results = model("path/to/image.jpg", points=[150, 150], labels=[1])للاطلاع على شرح أكثر شمولًا للاستخدام، راجع قسم كيفية استخدام SAM 2.
دُرّب SAM 2 على مجموعة بيانات SA-V، وهي واحدة من أكبر مجموعات بيانات تجزئة الفيديو وأكثرها تنوعًا. وتشمل مجموعة بيانات SA-V ما يلي:
- أكثر من 51,000 مقطع فيديو: جُمعت في 47 دولة، وتوفر نطاقًا واسعًا من سيناريوهات العالم الحقيقي.
- أكثر من 600,000 شرح للقناع: شروح تفصيلية مكانية وزمنية للأقنعة، تُعرف باسم «masklets»، وتغطي الكائنات كاملةً وأجزاءها.
- حجم مجموعة البيانات: تضم مقاطع فيديو أكثر بـ4.5 مرات وتعليقات توضيحية أكثر بـ53 مرة مقارنةً بأكبر مجموعات البيانات السابقة، ما يوفر تنوعًا وتعقيدًا غير مسبوقين.
تتيح مجموعة البيانات هذه لـ SAM 2 تحقيق نتائج قوية في معايير تجزئة الفيديو الرئيسية، وتعزز قدراته على التعميم من دون أمثلة سابقة.
يتضمن SAM 2 آلية ذاكرة لإدارة الاعتماديات الزمنية والحجب في بيانات الفيديو. وتتألف آلية الذاكرة من:
- مُرمِّز الذاكرة وبنك الذاكرة: يخزّنان السمات من الإطارات السابقة.
- وحدة انتباه الذاكرة: تستخدم المعلومات المخزنة للحفاظ على اتساق تعقب الكائنات بمرور الوقت.
- رأس الاحتجاب: يتعامل تحديدًا مع الحالات التي لا تكون فيها الكائنات مرئية، ويتنبأ باحتمال احتجاب الكائن.
تضمن هذه الآلية الاستمرارية حتى عندما تُحجب الكائنات مؤقتًا أو تغادر المشهد ثم تعود إليه. لمزيد من التفاصيل، راجع قسم آلية الذاكرة والتعامل مع الاحتجاب.
توفر نماذج SAM 2، مثل SAM2-t وSAM2-b من Meta، إمكانات قوية للتجزئة دون أمثلة، لكنها أكبر وأبطأ بكثير من نماذج YOLO. فعلى سبيل المثال، فإن YOLO26n-seg أصغر بنحو 24 مرة وأسرع بأكثر من 1145 مرة من SAM2-b على CPU. وبينما يتفوق SAM 2 في سيناريوهات التجزئة المتنوعة والقائمة على المطالبات ودون أمثلة، فإن YOLO26 محسّن للسرعة والكفاءة والتطبيقات الآنية، مع استدلال شامل لا يستخدم NMS، ما يجعله أنسب للنشر في البيئات محدودة الموارد.


التعليقات150
اطرح سؤالًا، وشارك نتائجك، أو ساعد شخصًا آخر.
 Glenn JocherUltralytics
Hey everyone! We wanted to give you a quick update: our team is currently busy integrating SAM 2 (Segment Anything Model 2) into the Ultralytics package. This new model is super exciting, with features like real-time performance and the ability to segment objects it’s never seen before.
We're really pumped about what SAM2 can do, but it's still in the works. Thanks for your patience as we get everything set up! We'll keep you posted as we make progress. Stay tuned!
10- Glenn JocherUltralytics
Update: SAM 2 is now fully integrated! Update your package to
ultralytics>=8.2.70withpip install -U ultralyticsand then for example:from ultralytics import ASSETS, SAM # Load a model model = SAM("sam2_s.pt") # Segment with point prompt results = model(ASSETS / "bus.jpg", points=[150, 150], labels=[1], device="cpu")1
avasanjesh
Hello,
Can i use sam2.1 for real time segmentation? i want to specify the object on the first frame of live video webcam then sam2.1 shows the segmentation and continue to track and show the result of segmentation of that object. Is it possible to do this?
1thedatamask
Breaking News: 🚨 SAM 1.0 outperforms SAM 2.0 on low-contrast images like CT Scan and MRI images! Check out this insightful video from Data Mask YouTube channel where they dive deep into the architecture, demos, and limitations of both Meta's segmentation models. Discover when to use SAM 1.0 for superior results on challenging images.
Use case with ultralytics
https://www.youtube.com/watch?v=vMI-TnyNLYU
Please do like and subscribe for exciting video like above .
#SAM #SAM2.0 #MetaAI #ImageSegmentation #AI #MachineLearning #DeepLearning #DataMask #BreakingNews
1- Glenn JocherUltralytics
@thedatamask thank you for sharing the video. For insights on SAM 2's capabilities and its comparison with other models, you can explore our documentation. If you have specific questions about using SAM 2 with Ultralytics, feel free to ask!
ram-from-tvl
Hi Team,
the below is the code I have been using to annotate some items in a folder of several images. I am planning to segment everything first and then try to cherry pick the ones that are to be annotated for a downstream segmentation task. Could you please tailor the code for the same. I am not getting any help from the docs regarding the same. i have tried auto annotate but its not working for my use case. So please help me in this approach
` from ultralytics import SAM
Load a model
model = SAM("sam2.1_b.pt")
Display model information (optional)
model.info()
Run inference
model("/kaggle/working/10_random_frames") `
Thankyou
Regards Ram
 Onuralp SezerUltralytics
Hi Team,
the below is the code I have been using to annotate some items in a folder of several images. I am planning to segment everything first and then try to cherry pick the ones that are to be annotated for a downstream segmentation task. Could you please tailor the code for the same. I am not getting any help from the docs regarding the same. i have tried auto annotate but its not working for my use case. So please help me in this approach
` from ultralytics import SAM
Load a model
model = SAM("sam2.1_b.pt")
Display model information (optional)
model.info()
Run inference
model("/kaggle/working/10_random_frames") `
Thankyou
Regards Ram
You may want check out here https://docs.ultralytics.com/reference/data/annotator/#ultralytics.data.annotator.auto_annotate
zhaowangalready
Hello, dear doctor, I encountered some problems in the automatic annotation segmentation. I used the successfully annotated data for verification and found that the data of each species has a serial number border. How can I remove the serial number border? I hope to hear from you.
- Glenn JocherUltralytics
auto_annotate()生成的是标准 YOLO-seg 标签:每一行开头的“数字”是类别class_id(必需字段,不能删),如果你看到的是验证/预测保存出来的图片上带编号的边框/轮廓,那只是可视化绘图,不会写进数据本身;你可以按 SAM 2 文档 继续用同一套数据训练/验证,同时关掉这些 plot:yolo val model=yolo26n-seg.pt data=path/to/data.yaml plots=False yolo predict model=sam2.1_b.pt source=path/to/images show_labels=False show_boxes=False方便的话把“带序号边框”的截图 + 对应的一行标签
.txt内容贴在这个 discussion 里,我帮你确认你看到的到底是class_id还是绘图叠加效果。
cyberpunk-edgerunner
I have to question related to SAM2 :
- How to use text-prompt for segmentation using SAM ?
- Along with the bounding box coordinates, is there a way to tell SAM what not to segment ?
I have two questions regarding segmentation with SAM2 and YOLOv11:
1. Visualization and Editing with SAM2 I've used the
auto_annotatefeature and I'm wondering:- How can I visualize the segmentations produced by the SAM2 model?
- Is there a way to manually inspect or edit these segmentations?
I'm aiming to verify the outputs before proceeding further.
2. Saving and Cropping Segmentations I'm using the following code to detect and segment images with YOLOv11 and SAM2:
from ultralytics import YOLO
from ultralytics import SAM

model = YOLO(r"runs\detect\train2\weights\best.pt")
sam_model = SAM("sam2_b.pt")

results = model("more_test_images", save=True)

for result in results:
    class_ids = result.boxes.cls.int().tolist()

    if len(class_ids):
        boxes = result.boxes.xyxy
        sam_results = sam_model(result.orig_img, bboxes=boxes, verbose=False, save=True)
The detection results from YOLOv11 are saved correctly, but only one segmented result is saved by SAM2.
Questions:
- How can I ensure all SAM2 segmentations are saved for each image?
- How can I crop and save only the segmented parts (i.e., masked regions) from each image? I need these as separate images, containing only the segmented pixels.
Any help or pointers would be greatly appreciated!
fangyuZ1025
Hello, dear doctor, I encountered some problems in the automatic annotation segmentation. The automatic annotation automatically marked various marks on my output, but in fact, this is not the correct mark of my picture, and even some pictures cannot recognise the objects in it. How can I make it change the label uniform? For example, all of them are labelled as "fruit", "vehicle" and so on? I hope to get your reply.
from ultralytics.data.annotator import auto_annotate
auto_annotate(data=r"D:\graduation.thesis\mydata\mt_label\images", det_model="yolov8n.pt", sam_model="sam2_b.pt")
image 19/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112848.jpg: 640x640 (no detections), 33.4ms image 20/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112858.jpg: 640x640 1 orange, 31.9ms image 21/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112907.jpg: 640x640 1 apple, 35.3ms image 22/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112916.jpg: 640x640 (no detections), 34.0ms image 23/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112938.jpg: 640x640 (no detections), 35.3ms image 24/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112947.jpg: 640x640 1 donut, 32.1ms image 25/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113004.jpg: 640x640 (no detections), 28.6ms image 26/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113014.jpg: 640x640 1 donut, 33.9ms image 27/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113028.jpg: 640x640 1 apple, 1 donut, 35.8ms
- Glenn JocherUltralytics(تم التعديل)
@fangyuZ1025 to improve label consistency in auto-annotation, you'll need to train a custom detection model with your specific classes ("fruit", "vehicle") first. The auto_annotate function relies on your detection model's class definitions - it doesn't rename labels but uses whatever classes your det_model was trained on. For immediate improvement, try a newer detection model such as YOLO26 (for example
det_model="yolo26n.pt"), which is more accurate than YOLOv8.
Fatima-khanjar
Hello, I am using SAM2 with my fine-tuned YOLOv11 on my custom dataset to perform auto-annotation for an object detection task. However, the annotations in the .txt file are not in the YOLO format (class_label x_center y_center width height).
Could you clarify the format of the labels generated when using both SAM2 and YOLOv11 for auto-annotation?
- Glenn JocherUltralytics
@Fatima-khanjar the auto-annotation function generates segmentation masks in YOLO segmentation format (polygon points normalized 0-1), not bounding boxes. For object detection tasks, you'll need to convert these masks to bounding boxes using
masks.xyfrom Results objects. We recommend reviewing the Auto-Annotation with SAM2 documentation for implementation details and conversion examples.1
danieltudosiu(تم التعديل)
How does one use SAM2 with a numpy input? I saw how to do it with SAM but SAM2 does not have a preprocess method like SAM.
- Glenn JocherUltralytics(تم التعديل)
@danieltudosiu you can pass numpy arrays directly as the source to
SAM. Here's a minimal example:import numpy as np from ultralytics import SAM model = SAM("sam2.1_b.pt") img = np.random.randint(0, 255, (640, 640, 3), dtype=np.uint8) # Your numpy array results = model(img, points=[100, 100], labels=[1])For more details, see the SAM 2 documentation.
But what about the Image one? Or just use the Video one for Images as well?
- Glenn JocherUltralytics(تم التعديل)
You can pass numpy arrays or file paths directly to
SAM("sam2.1_b.pt"), for examplemodel(img_array, points=[100, 100], labels=[1]).SAM2VideoPredictoris only needed for video. For image-specific examples, see the SAM 2 documentation.