Argoverse-Datensatz
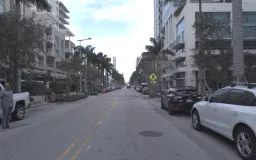
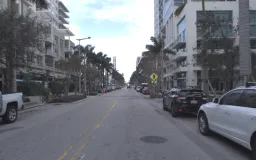
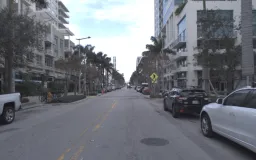
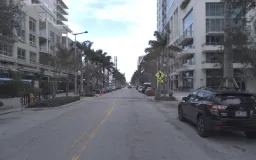
Der Ultralytics-Argoverse-Datensatz (Argoverse-HD) ist ein Datensatz zur 2D-Objekterkennung mit 54.446 annotierten Bildern aus dem autonomen Fahren – 39.384 Trainings- und 15.062 Validierungsbilder – und 8 Klassen: Person, Fahrrad, Auto, Motorrad, Bus, Lkw, Ampel und Stoppschild. Die Bilder wurden mit der Ring-Front-Center-Kamera eines Fahrzeugs aufgenommen. Die Annotationen stammen aus dem Streaming-Perception-Projekt der Carnegie Mellon University, das auf den Argoverse-1.1-Fahrdaten von Argo AI aufbaut. Der Datensatz ist ein umfangreicher Benchmark aus der realen Welt, um Computer-Vision-Modelle für die Erkennung von Straßenobjekten in Szenarien des autonomen Fahrens zu trainieren.
Besuche Argoverse-HD auf der Ultralytics Platform, um annotierte Beispiele anzusehen, Datensatzstatistiken zu prüfen und den Datensatz für das Training zu klonen.
Verwende Python 3.11 oder neuer und setze ULTRALYTICS_API_KEY auf einen Schlüssel aus den Platform-Einstellungen. Übergib die Argoverse-Dataset-URL als data, um die Bilder herunterzuladen und YOLO-Labels automatisch vorzubereiten. Die Konfiguration Argoverse.yaml lädt ebenfalls von Platform herunter, wenn das Dataset lokal fehlt.
Wichtige Funktionen#
- 8 Klassen für die Objekterkennung: Person, Fahrrad, Auto, Motorrad, Bus, Lastwagen, Ampel und Stoppschild.
- 54.446 annotierte Bilder — 39.384 Trainings- und 15.062 Validierungsbilder — sowie eine nicht annotierte Testaufteilung, die für die eval.ai-Challenge reserviert ist.
- 1920 × 1200-Aufnahmen der zentralen Frontkamera des Rings, erfasst in urbanen Szenen des autonomen Fahrens.
- Die Annotationen werden bei der ersten Verwendung automatisch in das YOLO-Format konvertiert. Dadurch lässt sich der Datensatz direkt mit Ultralytics-YOLO-Modellen zur Objekterkennung trainieren.
Datensatzstruktur#
Das Argoverse-HD-Dataset auf Platform behält die drei vordefinierten Teilmengen bei:
| Aufteilung | Bilder | Beschriftungen |
|---|---|---|
| Trainieren | 39,384 | Ja |
| Validierung | 15,062 | Ja |
| Test | 12,507 | Unbeschriftet (eval.ai-Challenge) |
Alle Bilder enthalten dieselben 8 Objektklassen (Indizes 0–7): Person, Fahrrad, Auto, Motorrad, Bus, Lastwagen, Ampel und Stoppschild.
Ultralytics lädt das Dataset von Platform herunter und wandelt seine Annotationen automatisch in YOLO-Labels für die Objekterkennung um, sodass keine manuelle Vorverarbeitung erforderlich ist.
Anwendungsfälle#
Der Argoverse-HD-Datensatz unterstützt eine Reihe von Anwendungen zur Objekterkennung beim autonomen Fahren:
- Wahrnehmung für autonomes Fahren — Erkenne Fahrzeuge, Fußgänger und Radfahrer mit einer nach vorne gerichteten Kamera, um die Navigation von autonomen Fahrzeugen zu unterstützen.
- Fahrerassistenzsysteme (ADAS) — Erkenne Ampeln und Stoppschilder, um Fahrer in Echtzeit zu warnen.
- Verkehrsüberwachung — Zähle und verfolge Verkehrsteilnehmer in städtischen Szenen für Analysen im Bereich Smart Cities.
- Forschung und Prototyping — Ein umfangreicher Benchmark aus der Praxis, um Modelltraining und Vorhersagen mit Fahrdaten zu erlernen.
YAML-Datei des Datensatzes#
Eine YAML-Datei definiert die Dataset-Konfiguration, einschließlich Pfaden, Klassen und weiteren relevanten Details. Für den Argoverse-Datensatz wird die Datei Argoverse.yaml unter https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/Argoverse.yaml gepflegt.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Argoverse-HD dataset (ring-front-center camera) by Argo AI: https://www.cs.cmu.edu/~mengtial/proj/streaming/
# Documentation: https://docs.ultralytics.com/datasets/detect/argoverse
# Example usage: yolo train data=Argoverse.yaml
# Download: https://platform.ultralytics.com/ultralytics/datasets/argoverse (requires ULTRALYTICS_API_KEY)
# parent
# ├── ultralytics
# └── datasets
#     └── Argoverse ← existing local dataset

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: Argoverse # dataset root dir
train: Argoverse-1.1/images/train/ # train images (relative to 'path') 39384 images
val: Argoverse-1.1/images/val/ # val images (relative to 'path') 15062 images
test: Argoverse-1.1/images/test/ # test images (optional) https://eval.ai/web/challenges/challenge-page/800/overview

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: bus
  5: truck
  6: traffic_light
  7: stop_sign

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  from ultralytics.data.utils import check_det_dataset, convert_ndjson_to_yolo_if_needed

  data = convert_ndjson_to_yolo_if_needed("https://platform.ultralytics.com/ultralytics/datasets/argoverse")
yaml.update(check_det_dataset(data))Verwendung#
Um ein YOLO26n-Modell 100 Epochen lang mit Bildgröße 640 auf dem Argoverse-Datensatz zu trainieren, verwende die folgenden Codebeispiele.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n.pt")  # ein vortrainiertes Modell laden (für das Training empfohlen)

# Das Modell trainieren
results = model.train(data="https://platform.ultralytics.com/ultralytics/datasets/argoverse", epochs=100, imgsz=640)
Führe nach dem Training mit dem feinabgestimmten Modell Inferenz auf neuen Fahrbildern oder Videos aus:
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("path/to/best.pt")  # ein mit Argoverse feinabgestimmtes Modell laden

# Inferenz mit dem Modell
results = model.predict("path/to/driving-scene.jpg")
Beispieldaten und Annotationen#
Der Argoverse-HD-Datensatz enthält hochauflösende Fahrbilder, die mit einer mittig vorne am Fahrzeug angebrachten Ringkamera aufgenommen wurden. Die Bilder sind mit 2D-Bounding-Boxen für die 8 Objektklassen annotiert. Unten siehst du ein Beispielbild aus dem Datensatz mit den entsprechenden Annotationen:
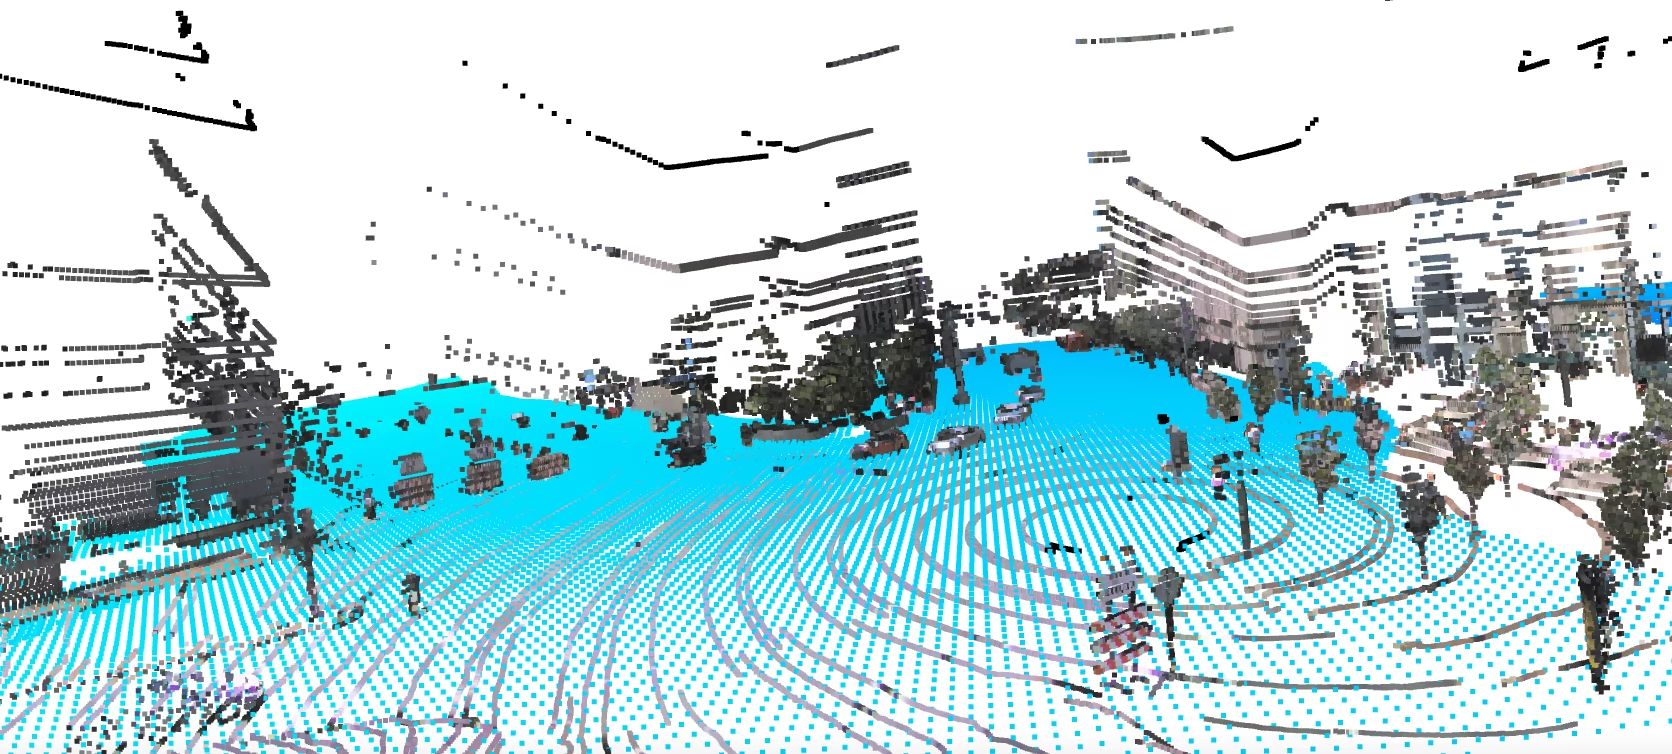
- Annotierte Fahrszene: Dieses Bild zeigt Verkehrsobjekte — etwa Fahrzeuge und Fußgänger —, die mit 2D-Bounding-Boxen markiert sind. Dieses Format lernen YOLO-Modelle während des Trainings vorherzusagen.
Zitate und Danksagungen#
Die in diesem Datensatz verwendeten 2D-Erkennungsannotationen von Argoverse-HD stammen aus der Arbeit zur Streaming-Wahrnehmung der Carnegie Mellon University. Wenn du den Datensatz in deiner Forschung oder Entwicklung verwendest, zitiere bitte:
@inproceedings{li2020towards,
  title={Towards Streaming Perception},
  author={Li, Mengtian and Wang, Yu-Xiong and Ramanan, Deva},
  booktitle={Proceedings of the European Conference on Computer Vision (ECCV)},
  pages={473--488},
  year={2020}
}

@inproceedings{chang2019argoverse,
  title={Argoverse: 3D Tracking and Forecasting with Rich Maps},
  author={Chang, Ming-Fang and Lambert, John and Sangkloy, Patsorn and Singh, Jagjeet and Bak, Slawomir and Hartnett, Andrew and Wang, Dequan and Carr, Peter and Lucey, Simon and Ramanan, Deva and others},
  booktitle={Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition},
  pages={8748--8757},
  year={2019}
}
Wir möchten der Carnegie Mellon University für die Argoverse-HD-Erkennungsannotationen und Argo AI für die Erstellung des ursprünglichen Argoverse-Datensatzes danken, der der Forschungsgemeinschaft für autonomes Fahren als wertvolle Ressource dient.
Häufig gestellte Fragen#
Der Argoverse-Datensatz von Ultralytics (Argoverse-HD) ist ein 2D-Datensatz zur Objekterkennung mit 54.446 Bildern aus dem Bereich des autonomen Fahrens und 8 Klassen — Person, Fahrrad, Auto, Motorrad, Bus, Lastwagen, Ampel und Stoppschild. Er wird zum Trainieren und Evaluieren von Modellen verwendet, die Verkehrsobjekte mit einer nach vorne gerichteten Fahrzeugkamera erkennen. Damit unterstützt er die Forschung zu Wahrnehmung für autonomes Fahren, ADAS und Verkehrsüberwachung.
Der Argoverse-HD-Datensatz umfasst 8 Klassen (Person, Fahrrad, Auto, Motorrad, Bus, Lastwagen, Ampel und Stoppschild) sowie 54.446 annotierte Bilder — 39.384 für das Training und 15.062 für die Validierung — und eine unbeschriftete Testteilmenge, die der eval.ai-Challenge vorbehalten ist.
In Ultralytics ist der Datensatz ein 2D-Objekterkennungsdatensatz (Argoverse-HD-Kamerabilder mit 2D-Bounding-Boxen) und nicht die Forschungsumgebung des umfassenderen Argoverse-Programms für 3D-Tracking, Bewegungsprognosen oder LiDAR. Du trainierst ihn mit einem Standardmodell zur Objekterkennung wie
yolo26n.pt.Setze
ULTRALYTICS_API_KEYund trainiere direkt mit der Dataset-URL von Platform:Beispielfrom ultralytics import YOLO # Ein Modell laden model = YOLO("yolo26n.pt") # ein vortrainiertes Modell laden (für das Training empfohlen) # Das Modell trainieren results = model.train(data="https://platform.ultralytics.com/ultralytics/datasets/argoverse", epochs=100, imgsz=640)Eine ausführliche Erläuterung der Argumente findest du auf der Seite zum Training des Modells.
Lade Argoverse von der Ultralytics Platform herunter. Nachdem du
ULTRALYTICS_API_KEYgesetzt hast, kannst du diese URL direkt als Trainingsargumentdataübergeben; Ultralytics lädt das Dataset herunter und bereitet seine YOLO-Labels automatisch vor.Ja. Öffne Argoverse-HD auf Ultralytics Platform, um die Bilder und Annotationen anzusehen, das Dataset zu klonen und Modelle zur Objekterkennung in der Cloud zu trainieren. Du kannst auch verwandte Datasets in der Übersicht der Datasets zur Objekterkennung durchsuchen.


Kommentare
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.