TT100K-Datensatz#
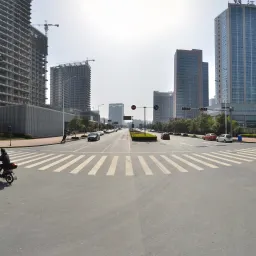
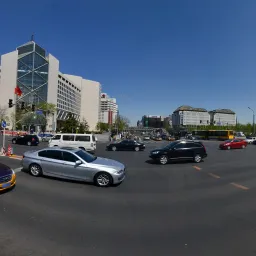
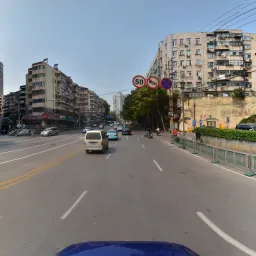
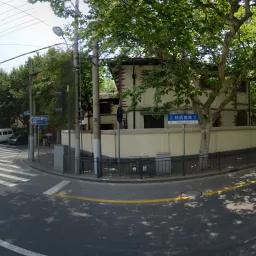
Der Tsinghua-Tencent 100K (TT100K)-Datensatz ist ein Benchmark für die Erkennung von Verkehrszeichen mittels Objekterkennung. Zhu et al. erstellten ihn für die CVPR-Arbeit von 2016 Traffic-Sign Detection and Classification in the Wild. Die Ultralytics-Konfiguration für TT100K umfasst 16,817 Bilder (6,105 Training / 7,641 Validierung / 3,071 Test) aus 221 Verkehrszeichenkategorien. Der ursprüngliche Benchmark umfasst laut Bericht über 30.000 Verkehrszeicheninstanzen. „100K“ im Namen bezieht sich auf die etwa 100.000 Tencent Street View-Bilder, aus denen der Benchmark erstellt wurde – nicht auf die Anzahl der Bilder, die du herunterlädst und zum Trainieren verwendest. Da in der ursprünglichen Arbeit nur Kategorien mit mindestens 100 Trainingsinstanzen berücksichtigt werden, gibt es eine häufig verwendete Teilmenge mit 45 Klassen. Die Ultralytics-Konfiguration behält jedoch alle 221 annotierten Kategorien bei, von denen viele nur spärlich vertreten sind.
Die hochauflösenden Street-View-Bilder zeigen große Unterschiede bei Beleuchtung, Wetter, Blickwinkel und Entfernung. Dadurch ist TT100K ein anspruchsvoller Benchmark für die Erkennung kleiner Objekte in realen Verkehrsszenen.
Wichtige Funktionen#
- Erkennung mit mehreren Klassen: 221 Verkehrszeichenkategorien, darunter chinesische Geschwindigkeitsbegrenzungs-, Verbots-, Warn-, Höhen- und Breitenbegrenzungs- sowie Hinweisschilder.
- Hohe Auflösung: Die Bilder haben eine Auflösung von 2048×2048 Pixeln. Verkehrszeichen reichen von groß und nah bis zu winzigen Markierungen in der Ferne, was die fein abgestufte Erkennung anspruchsvoll macht.
- Reale Bedingungen: Große Unterschiede bei Wetter, Beleuchtung, Blickwinkel und Verdeckung.
- Bounding-Box-Annotationen: Jedes Verkehrszeichen ist nach der automatischen Konvertierung mit einer Klasse und einer Bounding Box im YOLO-Format gekennzeichnet.
- Vordefinierte Aufteilungen: Feste Trainings-, Validierungs- und Testaufteilungen (6,105 / 7,641 / 3,071 Bilder) ermöglichen eine konsistente Auswertung.
Datensatzstruktur#
Die Ultralytics-Konfiguration für TT100K ist in drei Teilmengen unterteilt, die dieselben 221 Kategorien verwenden:
| Aufteilung | Bilder | Beschreibung |
|---|---|---|
| Trainieren | 6,105 | Annotierte Verkehrsszenenbilder zum Trainieren des Detektors |
| Validierung | 7,641 | Die ursprüngliche „other“-Teilmenge des Datensatzes zur Auswertung |
| Test | 3,071 | Zurückgehaltene Bilder zur abschließenden Auswertung des trainierten Modells |
Die 221 Kategorien sind in mehrere Hauptgruppen unterteilt:
- Geschwindigkeitsbegrenzungsschilder — Verbotsgrenzen
pl*(z. B. pl5–pl120) und Mindestgeschwindigkeitenpm*(z. B. pm5–pm55). - Verbotsschilder — allgemeine Verbote
p1–p29, Einfahrts- und Parkverbotepn/pnesowie Beschränkungenpr*(pr10–pr100). - Warnschilder —
w1–w67für Gefahren im Straßenverkehr wie Übergänge, scharfe Kurven, rutschige Straßen und Baustellen. - Höhen- und Breitenbegrenzungsschilder — Höhenbegrenzungen
ph*(z. B. ph2–ph5.5) und Breitenbegrenzungenpb/pw*. - Hinweisschilder — allgemeine Informationen
i1–i15, Informationen zu Geschwindigkeitsbegrenzungenil*(il50–il110), sonstige Hinweiseiound Informationstafelnip.
Anwendungsfälle#
TT100K wird häufig zur Entwicklung und zum Benchmarking der Erkennung von Verkehrszeichen unter realen Bedingungen verwendet. Typische Anwendungsbereiche sind:
- Wahrnehmungssysteme für autonomes Fahren
- Fortschrittliche Fahrerassistenzsysteme (ADAS)
- Verkehrsüberwachung und Analyse der Straßeninfrastruktur
- Stadtplanung und Untersuchungen des Verkehrsflusses
- Computer-Vision-Forschung zu kleinen Objekten in hochauflösenden Bildern
YAML-Datei des Datensatzes#
Die Datei TT100K.yaml legt die Datensatzkonfiguration fest – die Datensatzpfade, Klassennamen und das Skript zum automatischen Herunterladen und Konvertieren. Sie wird im Ultralytics-Repository unter https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/TT100K.yaml gepflegt.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Tsinghua-Tencent 100K (TT100K) dataset https://cg.cs.tsinghua.edu.cn/traffic-sign/ by Tsinghua University
# Documentation: https://cg.cs.tsinghua.edu.cn/traffic-sign/tutorial.html
# Paper: Traffic-Sign Detection and Classification in the Wild (CVPR 2016)
# License: CC BY-NC 2.0 license for non-commercial use only
# Example usage: yolo train data=TT100K.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── TT100K ← downloads here (~18 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: TT100K # dataset root dir
train: images/train # train images (relative to 'path') 6105 images
val: images/val # val images (relative to 'path') 7641 images (original 'other' split)
test: images/test # test images (relative to 'path') 3071 images

# Classes (221 traffic sign categories, 45 with sufficient training instances)
names:
  0: i1
  1: i10
  2: i11
  3: i12
  4: i13
  5: i14
  6: i15
  7: i2
  8: i3
  9: i4
  10: i5
  11: il100
  12: il110
  13: il50
  14: il60
  15: il70
  16: il80
  17: il90
  18: io
  19: ip
  20: p1
  21: p10
  22: p11
  23: p12
  24: p13
  25: p14
  26: p15
  27: p16
  28: p17
  29: p18
  30: p19
  31: p2
  32: p20
  33: p21
  34: p22
  35: p23
  36: p24
  37: p25
  38: p26
  39: p27
  40: p28
  41: p3
  42: p4
  43: p5
  44: p6
  45: p7
  46: p8
  47: p9
  48: pa10
  49: pa12
  50: pa13
  51: pa14
  52: pa8
  53: pb
  54: pc
  55: pg
  56: ph1.5
  57: ph2
  58: ph2.1
  59: ph2.2
  60: ph2.4
  61: ph2.5
  62: ph2.8
  63: ph2.9
  64: ph3
  65: ph3.2
  66: ph3.5
  67: ph3.8
  68: ph4
  69: ph4.2
  70: ph4.3
  71: ph4.5
  72: ph4.8
  73: ph5
  74: ph5.3
  75: ph5.5
  76: pl10
  77: pl100
  78: pl110
  79: pl120
  80: pl15
  81: pl20
  82: pl25
  83: pl30
  84: pl35
  85: pl40
  86: pl5
  87: pl50
  88: pl60
  89: pl65
  90: pl70
  91: pl80
  92: pl90
  93: pm10
  94: pm13
  95: pm15
  96: pm1.5
  97: pm2
  98: pm20
  99: pm25
  100: pm30
  101: pm35
  102: pm40
  103: pm46
  104: pm5
  105: pm50
  106: pm55
  107: pm8
  108: pn
  109: pne
  110: po
  111: pr10
  112: pr100
  113: pr20
  114: pr30
  115: pr40
  116: pr45
  117: pr50
  118: pr60
  119: pr70
  120: pr80
  121: ps
  122: pw2
  123: pw2.5
  124: pw3
  125: pw3.2
  126: pw3.5
  127: pw4
  128: pw4.2
  129: pw4.5
  130: w1
  131: w10
  132: w12
  133: w13
  134: w16
  135: w18
  136: w20
  137: w21
  138: w22
  139: w24
  140: w28
  141: w3
  142: w30
  143: w31
  144: w32
  145: w34
  146: w35
  147: w37
  148: w38
  149: w41
  150: w42
  151: w43
  152: w44
  153: w45
  154: w46
  155: w47
  156: w48
  157: w49
  158: w5
  159: w50
  160: w55
  161: w56
  162: w57
  163: w58
  164: w59
  165: w60
  166: w62
  167: w63
  168: w66
  169: w8
  170: wo
  171: i6
  172: i7
  173: i8
  174: i9
  175: ilx
  176: p29
  177: w29
  178: w33
  179: w36
  180: w39
  181: w4
  182: w40
  183: w51
  184: w52
  185: w53
  186: w54
  187: w6
  188: w61
  189: w64
  190: w65
  191: w67
  192: w7
  193: w9
  194: pax
  195: pd
  196: pe
  197: phx
  198: plx
  199: pmx
  200: pnl
  201: prx
  202: pwx
  203: w11
  204: w14
  205: w15
  206: w17
  207: w19
  208: w2
  209: w23
  210: w25
  211: w26
  212: w27
  213: pl0
  214: pl4
  215: pl3
  216: pm2.5
  217: ph4.4
  218: pn40
  219: ph3.3
  220: ph2.6

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import json
  import shutil
  from pathlib import Path

  from PIL import Image

  from ultralytics.utils import TQDM
  from ultralytics.utils.downloads import download

  def tt100k2yolo(dir):
      """Convert TT100K annotations to YOLO format with images/{split} and labels/{split} structure."""
      data_dir = dir / "data"
      anno_file = data_dir / "annotations.json"

      print("Loading annotations...")
      with open(anno_file, encoding="utf-8") as f:
          data = json.load(f)

      # Build class name to index mapping from yaml
      names = yaml["names"]
      class_to_idx = {v: k for k, v in names.items()}

      # Create directories
      for split in ["train", "val", "test"]:
          (dir / "images" / split).mkdir(parents=True, exist_ok=True)
          (dir / "labels" / split).mkdir(parents=True, exist_ok=True)

      print("Converting annotations to YOLO format...")
      skipped = 0
      for img_id, img_data in TQDM(data["imgs"].items(), desc="Processing"):
          img_path_str = img_data["path"]
          if "train" in img_path_str:
              split = "train"
          elif "test" in img_path_str:
              split = "test"
          else:
              split = "val"

          # Source and destination paths
          src_img = data_dir / img_path_str
          if not src_img.exists():
              continue

          dst_img = dir / "images" / split / src_img.name

          # Get image dimensions
          try:
              with Image.open(src_img) as img:
                  img_width, img_height = img.size
          except Exception as e:
              print(f"Error reading {src_img}: {e}")
              continue

          # Copy image to destination
          shutil.copy2(src_img, dst_img)

          # Convert annotations
          label_file = dir / "labels" / split / f"{src_img.stem}.txt"
          lines = []

          for obj in img_data.get("objects", []):
              category = obj["category"]
              if category not in class_to_idx:
                  skipped += 1
                  continue

              bbox = obj["bbox"]
              xmin, ymin = bbox["xmin"], bbox["ymin"]
              xmax, ymax = bbox["xmax"], bbox["ymax"]

              # Convert to YOLO format (normalized center coordinates and dimensions)
              x_center = ((xmin + xmax) / 2.0) / img_width
              y_center = ((ymin + ymax) / 2.0) / img_height
              width = (xmax - xmin) / img_width
              height = (ymax - ymin) / img_height

              # Clip to valid range
              x_center = max(0, min(1, x_center))
              y_center = max(0, min(1, y_center))
              width = max(0, min(1, width))
              height = max(0, min(1, height))

              cls_idx = class_to_idx[category]
              lines.append(f"{cls_idx} {x_center:.6f} {y_center:.6f} {width:.6f} {height:.6f}\n")

          # Write label file
          if lines:
              label_file.write_text("".join(lines), encoding="utf-8")

      if skipped:
          print(f"Skipped {skipped} annotations with unknown categories")
      print("Conversion complete!")

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  urls = ["https://cg.cs.tsinghua.edu.cn/traffic-sign/data_model_code/data.zip"]
  download(urls, dir=dir, curl=True, threads=1)

  # Convert
tt100k2yolo(dir)Verwendung#
TT100K wird beim ersten Training automatisch heruntergeladen und benötigt etwa 18 GB freien Speicherplatz. Bei der ersten Verwendung lädt das Skript die Originaldaten herunter und konvertiert die Annotationen ins YOLO-Format. Dieser Vorgang kann mehrere Minuten dauern.
Um ein YOLO26n-Modell 100 Epochen lang mit dem TT100K-Datensatz und einer Bildgröße von 640 zu trainieren, kannst du die folgenden Codebeispiele verwenden. Eine vollständige Liste der verfügbaren Argumente findest du auf der Seite zum Training des Modells.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n.pt")  # ein vortrainiertes Modell laden (für das Training empfohlen)

# Modell trainieren – der Datensatz wird beim ersten Ausführen automatisch heruntergeladen
results = model.train(data="TT100K.yaml", epochs=100, imgsz=640)
Um weitere Verkehrszeichenbilder zu kennzeichnen und TT100K-Trainingsläufe in deinem Browser zu verwalten, verwende die Ultralytics Platform.
Beispieldaten und Annotationen#
TT100K-Bilder sind 2048×2048 Pixel große Straßenszenen, in denen Verkehrszeichen oft nur einen kleinen Teil des Bildes einnehmen. Ein einzelnes Bild kann mehrere Schilder in unterschiedlichen Größen und Entfernungen enthalten, von denen einige teilweise durch Fahrzeuge, Vegetation oder Bauwerke verdeckt und bei Tag oder Nacht sowie bei klarem oder regnerischem Wetter aufgenommen wurden. Diese Kombination aus kleinen Objekten und anspruchsvollen Bedingungen macht den Datensatz zu einem aussagekräftigen Test für die Robustheit von Detektoren.
Zitate und Danksagungen#
Wenn du den TT100K-Datensatz in deiner Forschung oder Entwicklungsarbeit verwendest, zitiere bitte die folgende Arbeit:
@InProceedings{Zhu_2016_CVPR,
    author = {Zhu, Zhe and Liang, Dun and Zhang, Songhai and Huang, Xiaolei and Li, Baoli and Hu, Shimin},
    title = {Traffic-Sign Detection and Classification in the Wild},
    booktitle = {The IEEE Conference on Computer Vision and Pattern Recognition (CVPR)},
    month = {June},
    year = {2016}
}
Wir möchten der Zusammenarbeit zwischen der Tsinghua-Universität und Tencent danken, die diese wertvolle Ressource für die Computer-Vision- und autonomes-Fahren-Community erstellt und gepflegt hat. Weitere Informationen zum TT100K-Datensatz findest du auf der offiziellen Datensatz-Website.
Häufig gestellte Fragen#
Der Datensatz Tsinghua-Tencent 100K (TT100K) wird zur Erkennung und Klassifizierung von Verkehrszeichen unter realen Bedingungen verwendet. Mit seinen 221 Kategorien und hochauflösenden Straßenansichten ist er ein verbreiteter Benchmark für die Wahrnehmung beim autonomen Fahren, fortschrittliche Fahrerassistenzsysteme (ADAS) und die Forschung zur Erkennung kleiner Objekte.
Die Ultralytics-Konfiguration für TT100K enthält 16.817 Bilder: 6.105 für das Training, 7.641 für die Validierung (der ursprüngliche „other“-Split des Datensatzes) und 3.071 für den Test. Die vollständige Aufschlüsselung findest du im Abschnitt Datensatzstruktur.
„100K“ bezieht sich auf die rund 100.000 Tencent-Street-View-Bilder, aus denen der ursprüngliche Benchmark erstellt wurde. Die Ultralytics-Konfiguration zur Objekterkennung stellt 16.817 dieser Bilder mit Beschriftungen im YOLO-Format bereit; der Name bezieht sich auf die Ausgangssammlung und nicht auf die Größe des Trainingssatzes.
TT100K umfasst 221 Kategorien für Geschwindigkeitsbegrenzungen, Verbote, Warnungen, Höhen- und Breitenbegrenzungen sowie Informationsschilder. Die ursprüngliche Arbeit berücksichtigt nur die 45 Kategorien mit mindestens 100 Trainingsinstanzen, die Ultralytics-Konfiguration enthält jedoch alle 221. Die Aufschlüsselung nach Gruppen findest du unter Datensatzstruktur.
TT100K ist etwa 18 GB groß und wird beim ersten Training mit
data="TT100K.yaml"automatisch heruntergeladen – ein manueller Download ist nicht nötig. Das Skript konvertiert außerdem beim ersten Durchlauf die ursprünglichen Annotationen ins YOLO-Format.Trainiere ein YOLO26n-Modell 100 Epochen lang mit TT100K und einer Bildgröße von 640:
Trainingsbeispielfrom ultralytics import YOLO # Ein Modell laden model = YOLO("yolo26n.pt") # ein vortrainiertes Modell laden (für das Training empfohlen) # Das Modell trainieren results = model.train(data="TT100K.yaml", epochs=100, imgsz=640)Ausführliche Konfigurationen findest du auf der Seite Training und in den Tipps zum Modelltraining.
Beginne mit
imgsz=640für erste Experimente und erhöhe den Wert dann aufimgsz=1280(mit einem kleinerenbatch), wenn dein GPU-Speicher ausreicht. Die höhere Auflösung hilft dabei, kleine, weit entfernte Schilder zu erkennen:model.train(data="TT100K.yaml", imgsz=1280, batch=4) # höhere Auflösung für kleine SchilderDu kannst auch die Datenerweiterung abstimmen und bei sehr kleinen Objekten Kachelstrategien in Betracht ziehen. Weitere Informationen findest du unter Tipps zum Modelltraining.