COCO128-Seg-Datensatz#
Einführung#
Der COCO128-Seg-Datensatz von Ultralytics ist ein kleiner, aber vielseitiger Datensatz zur Instanzsegmentierung, der aus den ersten 128 Bildern des COCO-train2017-Datensatzes besteht. Er eignet sich ideal zum Testen und Debuggen von Segmentierungsmodellen sowie zum Ausprobieren neuer Segmentierungsansätze. Mit 128 Bildern ist er klein genug, um sich einfach verwalten zu lassen, und zugleich vielfältig genug, um Trainingspipelines auf Fehler zu prüfen und vor dem Training mit größeren Datensätzen einen Plausibilitätstest durchzuführen.
Datensatzstruktur#
- Bilder: insgesamt 128; die Aufteilung in Train und Val ist identisch (siehe Hinweis unten).
- Klassen: dieselben 80 Objektkategorien wie bei COCO.
- Labels: Polygone im YOLO-Format, gespeichert unter
labels/train2017für das gemeinsame Train- und Val-Bildverzeichnis. - Downloadgröße: ~7 MB.
Die Standard-YAML-Datei verweist bei Train und Val auf dieselben 128 Bilder. Daher messen die Validierungsmetriken die Anpassung an den Trainingssatz statt die Generalisierung auf zurückgehaltene Daten. Wenn du einen echten zurückgehaltenen Datensatz benötigst, erstelle eine Kopie der Aufteilung oder passe sie an.
Dieser Datensatz ist für die Verwendung mit der Ultralytics Platform und YOLO26 vorgesehen.
YAML-Datei des Datensatzes#
Eine YAML-Datei dient zur Definition der Datensatzkonfiguration. Sie enthält Informationen zu den Pfaden, Klassen und weiteren relevanten Eigenschaften des Datensatzes. Für den COCO128-Seg-Datensatz wird die Datei coco128-seg.yaml unter https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco128-seg.yaml verwaltet.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO128-seg dataset https://www.kaggle.com/datasets/ultralytics/coco128 (first 128 images from COCO train2017) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/segment/coco128-seg
# Example usage: yolo train data=coco128-seg.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco128-seg ← downloads here (7 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco128-seg # dataset root dir
train: images/train2017 # train images (relative to 'path') 128 images
val: images/train2017 # val images (relative to 'path') 128 images
test: # test images (optional)

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/coco128-seg.zipVerwendung#
Um ein YOLO26n-seg-Modell mit dem COCO128-Seg-Datensatz 100 Epochen lang bei einer Bildgröße von 640 zu trainieren, kannst du die folgenden Codeausschnitte verwenden. Eine vollständige Liste der verfügbaren Argumente findest du auf der Seite zum Training des Modells.
from ultralytics import YOLO

# Ein Modell laden
model = YOLO("yolo26n-seg.pt")  # ein vortrainiertes Modell laden (für das Training empfohlen)

# Das Modell trainieren
results = model.train(data="coco128-seg.yaml", epochs=100, imgsz=640)
Beispielbilder und Annotationen#
Hier siehst du einige Beispielbilder aus dem COCO128-Seg-Datensatz und die zugehörigen Annotationen:
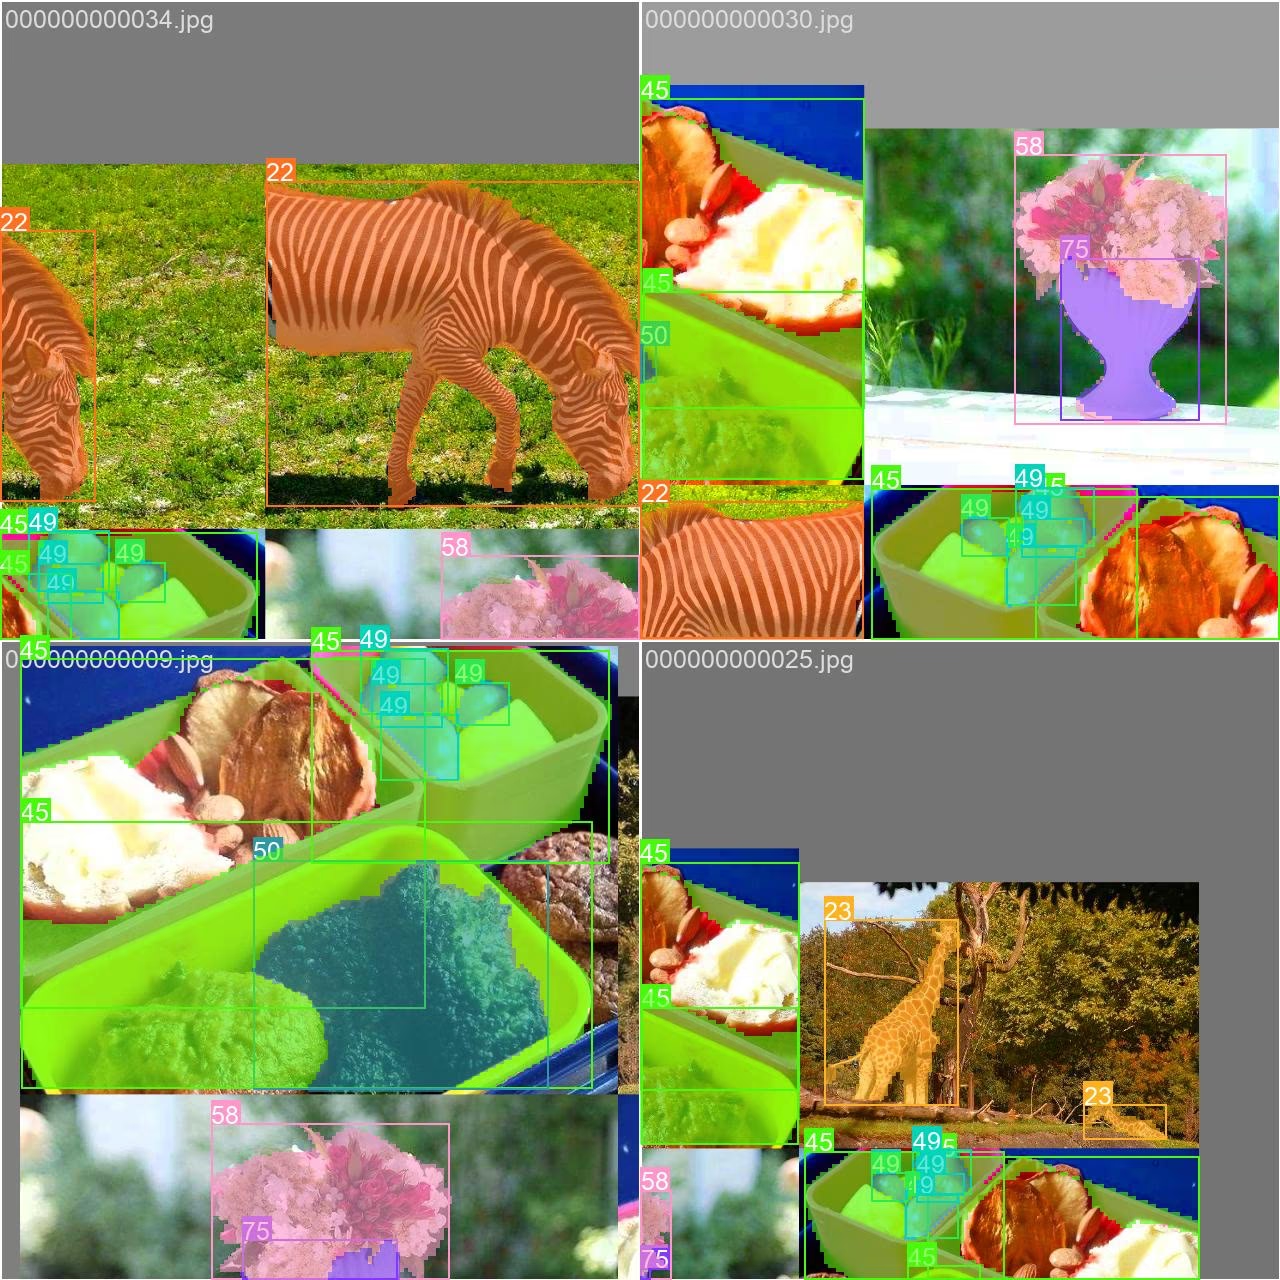
- Mosaikbild: Dieses Bild zeigt einen Trainingsbatch aus mosaikartig kombinierten Datensatzbildern. Beim Mosaikverfahren werden während des Trainings mehrere Bilder zu einem einzigen Bild kombiniert, um die Vielfalt der Objekte und Szenen in jedem Trainingsbatch zu erhöhen. Dadurch kann das Modell besser auf unterschiedliche Objektgrößen, Seitenverhältnisse und Kontexte generalisieren.
Zitate und Danksagungen#
Wenn du den COCO-Datensatz für deine Forschung oder Entwicklungsarbeit verwendest, zitiere bitte die folgende Arbeit:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Wir möchten dem COCO-Konsortium dafür danken, dass es diese wertvolle Ressource für die Computer-Vision-Community erstellt und pflegt. Weitere Informationen zum COCO-Datensatz und seinen Urhebern findest du auf der COCO-Datensatz-Website.
Häufig gestellte Fragen#
Der COCO128-Seg-Datensatz ist ein kompakter Datensatz zur Instanzsegmentierung von Ultralytics und besteht aus den ersten 128 Bildern des COCO-train2017-Datensatzes. Er eignet sich zum Testen und Debuggen von Segmentierungsmodellen sowie zum Ausprobieren neuer Segmentierungsmethoden. Besonders nützlich ist er zusammen mit Ultralytics YOLO26 und der Platform, um schnell Änderungen vorzunehmen und Pipelinefehler zu prüfen, bevor du auf größere Datensätze umsteigst. Eine ausführliche Anleitung zur Verwendung findest du auf der Seite zum Training des Modells.
Um ein YOLO26n-seg-Modell mit dem COCO128-Seg-Datensatz 100 Epochen lang bei einer Bildgröße von 640 zu trainieren, kannst du Python- oder CLI-Befehle verwenden. Hier ist ein kurzes Beispiel:
Trainingsbeispielfrom ultralytics import YOLO # Ein Modell laden model = YOLO("yolo26n-seg.pt") # Ein vortrainiertes Modell laden (für das Training empfohlen) # Das Modell trainieren results = model.train(data="coco128-seg.yaml", epochs=100, imgsz=640)Eine ausführliche Erklärung der verfügbaren Argumente und Konfigurationsoptionen findest du in der Trainingsdokumentation.
Da Download und Train/Val-Schleife viel kleiner ausfallen als bei COCO in voller Größe, kannst du mit COCO128-Seg eine Plausibilitätsprüfung über eine Epoche für eine neue Pipeline durchführen. Dabei prüfst du, ob das Modell korrekt trainiert, validiert und Prüfpunkte speichert, bevor du auf den vollständigen COCO-Seg-Datensatz umsteigst. Weitere Informationen zu unterstützten Datensatzformaten findest du im Ultralytics-Leitfaden zu Segmentierungsdatensätzen.
Die YAML-Konfigurationsdatei für den COCO128-Seg-Datensatz ist im Ultralytics-Repository verfügbar. Du kannst direkt unter https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco128-seg.yaml auf die Datei zugreifen. Die YAML-Datei enthält wichtige Informationen zu Datensatzpfaden, Klassen und Konfigurationseinstellungen, die für das Training und die Validierung des Modells erforderlich sind.
COCO128-Seg (128 Bilder) liegt größenmäßig zwischen COCO8-Seg (8 Bilder) und dem vollständigen COCO-Seg-Datensatz (118.287 Trainingsbilder):
- COCO8-Seg: 8 Bilder (4 Train, 4 Val) – ideal für schnelle Plausibilitätsprüfungen und Debugging.
- COCO128-Seg: 128 Bilder – ein ausgewogenes Verhältnis von Größe und Vielfalt; Train und Val verwenden dasselbe Verzeichnis.
- COCO-Seg in voller Größe: 118.287 Trainingsbilder – umfassend, aber ressourcenintensiv und beim ersten Download etwa ~20 GB groß.
COCO128-Seg bietet mehr Vielfalt als COCO8-Seg und ist zugleich deutlich überschaubarer als der vollständige COCO-Seg-Datensatz – ideal für Experimente und die anfängliche Modellentwicklung.