Leitfaden zur Optimierung von Hyperparametern für Ultralytics YOLO
Die Hyperparameteroptimierung in Ultralytics YOLO ist eine automatisierte, iterative Suche, die Einstellungen wie Lernrate, Verlustgewichte und Stärke der Augmentierung optimiert, um die Leistungskennzahlen eines maschinellen Lern-Modells wie Genauigkeit, Präzision und Trefferquote zu maximieren. Anstatt diese Werte manuell zu testen, durchsucht Ultralytics YOLO den Hyperparameterraum mit einem genetischen Algorithmus, der Kandidatenkonfigurationen verändert und sie über viele kurze Trainingsläufe bewertet.
Ansehen: So optimierst du Hyperparameter für eine bessere Modellleistung 🚀
Was sind Hyperparameter?#
Hyperparameter sind übergeordnete, strukturelle Einstellungen des Algorithmus. Sie werden vor der Trainingsphase festgelegt und bleiben währenddessen konstant. Hier sind einige häufig in Ultralytics YOLO optimierte Hyperparameter:
- Lernrate
lr0: Bestimmt die Schrittweite bei jeder Iteration auf dem Weg zu einem Minimum der Verlustfunktion. - Batchgröße
batch: Anzahl der Bilder, die gleichzeitig in einem Forward Pass verarbeitet werden. - Anzahl der Epochen
epochs: Eine Epoche umfasst einen vollständigen Forward- und Backward-Pass aller Trainingsbeispiele. - Architekturspezifikationen: Zum Beispiel Anzahl der Kanäle und Schichten, Typen der Aktivierungsfunktionen usw. Diese sind in der YAML-Modellkonfiguration festgelegt und nicht in den Trainingsargumenten.
Von diesen vier Elementen gehört nur die Lernrate zum standardmäßigen Suchraum: batch, epochs und die Architektur bleiben unverändert. Der Optimierer verändert außerdem den Zeitplan, die Gewichte der Verlustfunktion und die Augmentierungen, die weiter unten aufgeführt sind.
Genetische Evolution und Mutation#
Ultralytics YOLO verwendet genetische Algorithmen, eine Gruppe evolutionärer Algorithmen, um Hyperparameter zu optimieren. Genetische Algorithmen sind von den Mechanismen der natürlichen Selektion und der Genetik inspiriert.
- Selektion: Bei jeder Iteration wird eine von bis zu neun Konfigurationen mit der höchsten Fitness ausgewählt, wobei die Auswahl nach Fitness gewichtet wird. Nach 30 Ergebnissen wird anhand der besten 20 % aller Ergebnisse (bis zu 30) zusätzlich die Parameterkovarianz geschätzt. Ihr Einfluss nimmt zu, wenn sich mehr Belege aus Elite-Ergebnissen ansammeln.
- Mutation: Bei jeder Iteration wird etwa die Hälfte der Parameter mithilfe gaußscher Schritte verändert, die auf ihre Suchbereiche normiert sind. Sobald die Kovarianz aktiv ist, wird ein nach Konfidenz gewichteter Anteil von höchstens 40 % mit korrelierten Schritten verändert. Eine Spiegelung hält diese Schritte innerhalb der Grenzen, ohne abgeschnittene Werte anzusammeln. Wenn sich Versuche ohne Verbesserung häufen, werden die Schrittweiten über 25 Versuche hinweg linear um bis zu 20 % verkleinert und bei einem neuen Bestwert zurückgesetzt. Iteration 1 hat keinen Elternkandidaten und verwendet die standardmäßigen Trainings-Hyperparameter als Ausgangsbasis.
Vorbereitung auf das Hyperparameter-Tuning#
Bevor du mit dem Tuning beginnst, solltest du Folgendes beachten:
- Metriken bestimmen: Der integrierte Optimierer (
use_ray=False) ordnet Versuche nach demfitness-Wert der jeweiligen Aufgabe, währenduse_ray=Truedie Aufgabenmetrik verwendet. Entscheide, welche zusätzlichen Metriken du untersuchen möchtest, zum Beispiel AP50 oder den F1-Wert. - Optimierungsbudget festlegen: Lege fest, wie viel Rechenleistung du bereitstellen möchtest. Die Hyperparameteroptimierung kann rechenintensiv sein.
Ablauf der Tuning-Schleife#
Bei jeder Iteration wiederholt der integrierte Optimierer die folgende Schleife:
- Hyperparameter initialisieren — Beginne mit einer geeigneten Ausgangsbasis: entweder mit den standardmäßigen Hyperparametern von Ultralytics YOLO oder mit Werten, die auf deinem Fachwissen oder früheren Experimenten beruhen.
- Hyperparameter verändern — Die Klasse
Tunererstellt automatisch mit ihrer Methode_mutateeinen neuen Satz Hyperparameter auf Grundlage des vorhandenen Satzes. - Modell trainieren — Trainiere das Modell mit den veränderten Hyperparametern und bewerte anschließend die Trainingsleistung anhand der ausgewählten Kennzahlen.
- Modell bewerten — Der Bewertungsprozess liefert den Fitnesswert der Iteration. Dieser wird mit den Werten vorheriger Iterationen verglichen, um festzustellen, ob die aktuellen Hyperparameter eine Verbesserung darstellen.
- Ergebnisse protokollieren — Halte sowohl die Leistungskennzahlen als auch die zugehörigen Hyperparameter zur späteren Verwendung fest. Ultralytics YOLO speichert diese Ergebnisse automatisch im NDJSON-Format.
- Wiederholen — Fahre fort, bis die festgelegte Anzahl von Iterationen erreicht ist. Jede Iteration baut auf den Erkenntnissen aus früheren Durchläufen auf. Der integrierte Optimierer führt alle
iterationsaus. Ray Tune meldet die Kennzahlen nach jeder Fit-Epoche, sodass ASHA schwache Versuche nach Ablauf der Kulanzzeit beenden kann.
Iterationen und Populationsgröße#
Beim integrierten Optimierer (use_ray=False) legt iterations die Gesamtzahl der aufeinanderfolgenden Versuche fest. Der Standardwert ist 300. Bei jedem Versuch wird ein Modell mit einer Hyperparameterkonfiguration trainiert. Zum Beispiel plant iterations=40 mit epochs=50 40 unabhängige Trainingsläufe mit je 50 Epochen – nicht einen 50-Epochen-Lauf mit einer separaten Population aus 40 Kandidaten.
Der integrierte genetische Algorithmus hat keinen expliziten Parameter für die Populationsgröße. Sobald frühere Versuche vorliegen, wählt er aus bis zu neun Konfigurationen mit der höchsten Fitness aus und verändert bei jeder Iteration einen Kandidaten.
Für parallele Versuche oder erweiterte Suchstrategien setze use_ray=True auf Ray Tune. Ray Tune verwendet denselben Standardwert von 300 Versuchen und erhält iterations als num_samples. Weitere Informationen findest du in der Integrationsanleitung zu Ray Tune.
Standardmäßiger Suchraum#
Die folgende Tabelle führt die Standardparameter des Suchraums für das Hyperparameter-Tuning in YOLO26 auf. Für jeden Parameter ist ein bestimmter Wertebereich als Tupel (min, max) definiert.
| Parameter | Typ | Wertebereich | Beschreibung |
|---|---|---|---|
lr0 | float | (1e-5, 1e-2) | Anfangslernrate zu Beginn des Trainings. Niedrigere Werte sorgen für ein stabileres Training, verlangsamen aber die Konvergenz. |
lrf | float | (0.01, 1.0) | Faktor für die finale Lernrate als Anteil von lr0. Bestimmt, wie stark die Lernrate während des Trainings sinkt. |
momentum | float | (0.7, 0.98) | SGD-Momentumfaktor. Höhere Werte tragen dazu bei, die Gradientenrichtung beizubehalten, und können die Konvergenz beschleunigen. |
weight_decay | float | (0.0, 0.001) | L2-Regularisierungsfaktor zur Vermeidung von Overfitting. Höhere Werte bewirken eine stärkere Regularisierung. |
warmup_epochs | float | (0.0, 5.0) | Anzahl der Epochen für das lineare Aufwärmen der Lernrate. Hilft, Instabilität zu Beginn des Trainings zu vermeiden. |
warmup_momentum | float | (0.0, 0.95) | Anfangsmomentum während der Aufwärmphase. Steigt schrittweise bis zum finalen Momentumwert an. |
box | float | (1.0, 20.0) | Gewichtung des BBox-Verlusts in der Gesamtverlustfunktion. Gleicht Box-Regression und Klassifizierung gegeneinander ab. |
cls | float | (0.1, 4.0) | Gewichtung des Klassifizierungsverlusts in der Gesamtverlustfunktion. Höhere Werte betonen die korrekte Klassenvorhersage. |
cls_pw | float | (0.0, 1.0) | Klassengewichtungsfaktor zum Ausgleich unausgewogener Klassen. Höhere Werte verstärken die Gewichtung seltener Klassen. |
dfl | float | (0.4, 12.0) | Gewichtung des Regressionsanteils für den Box-Abstand. Das DFL-freie YOLO26 wendet diesen Faktor auf einen L1-Verlust der normalisierten Box-Abstände an; höhere Werte betonen eine präzise Lokalisierung. |
hsv_h | float | (0.0, 0.1) | Bereich der zufälligen Farbton-Augmentierung im HSV-Farbraum. Hilft dem Modell, bei Farbabweichungen zuverlässige Ergebnisse zu liefern. |
hsv_s | float | (0.0, 0.9) | Bereich der zufälligen Sättigungsaugmentierung im HSV-Farbraum. Simuliert unterschiedliche Lichtverhältnisse. |
hsv_v | float | (0.0, 0.9) | Bereich der zufälligen Helligkeitsaugmentierung. Hilft dem Modell, mit unterschiedlichen Belichtungsstufen umzugehen. |
degrees | float | (0.0, 45.0) | Maximale Rotationsaugmentierung in Grad. Hilft dem Modell, unabhängig von der Objektausrichtung zu werden. |
translate | float | (0.0, 0.9) | Maximale Verschiebungsaugmentierung als Anteil der Bildgröße. Erhöht die Robustheit gegenüber unterschiedlichen Objektpositionen. |
scale | float | (0.0, 0.95) | Bereich der zufälligen Skalierungsaugmentierung. Hilft dem Modell, Objekte unterschiedlicher Größe zu erkennen. |
shear | float | (0.0, 10.0) | Maximale Scherungsaugmentierung in Grad. Fügt den Trainingsbildern perspektivähnliche Verzerrungen hinzu. |
perspective | float | (0.0, 0.001) | Bereich der zufälligen Perspektivaugmentierung. Simuliert unterschiedliche Blickwinkel. |
flipud | float | (0.0, 1.0) | Wahrscheinlichkeit einer vertikalen Bildspiegelung während des Trainings. Nützlich für Aufnahmen aus der Vogelperspektive und Luftbilder. |
fliplr | float | (0.0, 1.0) | Wahrscheinlichkeit einer horizontalen Bildspiegelung. Hilft dem Modell, unabhängig von der Objektrichtung zu werden. |
bgr | float | (0.0, 1.0) | Wahrscheinlichkeit für eine BGR-Augmentierung, bei der die Farbkanäle vertauscht werden. Kann die Unabhängigkeit von der Farbgebung verbessern. |
mosaic | float | (0.0, 1.0) | Wahrscheinlichkeit für eine Mosaikaugmentierung, bei der 4 Bilder kombiniert werden. Besonders nützlich für die Erkennung kleiner Objekte. |
mixup | float | (0.0, 1.0) | Wahrscheinlichkeit für eine MixUp-Augmentierung, bei der zwei Bilder miteinander vermischt werden. Kann die Robustheit des Modells verbessern. |
cutmix | float | (0.0, 1.0) | Wahrscheinlichkeit für eine CutMix-Augmentierung. Kombiniert Bildbereiche, wobei lokale Merkmale erhalten bleiben. |
copy_paste | float | (0.0, 1.0) | Im Modus flip der Anteil der geeigneten Objekte, die kopiert werden; im Modus mixup außerdem die Wahrscheinlichkeit, mit der die Augmentierung angewendet wird. |
close_mosaic | int | (0.0, 10.0) | Deaktiviert Mosaik in den letzten N Epochen, um das Training vor Abschluss zu stabilisieren. Wird als Fließkommazahl verändert und anschließend auf eine ganze Anzahl von Epochen gerundet. |
Beispiel für einen benutzerdefinierten Suchraum#
Das folgende Beispiel definiert einen Suchraum und ruft model.tune() auf. Dabei wird die Klasse Tuner ausgeführt, um YOLO26n 30 Epochen lang mit dem COCO8-Datensatz und dem Optimierer AdamW zu optimieren. Für eine schnellere Optimierung werden Diagramme, Checkpoint-Erstellung und Validierungen außerhalb der letzten Epoche übersprungen.
Dieses Beispiel dient ausschließlich der Veranschaulichung. Hyperparameter, die aus kurzen oder kleinen Tuning-Läufen hervorgehen, sind für das Training unter realen Bedingungen selten optimal. In der Praxis sollte das Tuning unter Bedingungen erfolgen, die dem vollständigen Training ähneln – einschließlich vergleichbarer Datensätze, Epochen und Augmentierungen –, damit die Ergebnisse zuverlässig und übertragbar sind. Schnelles Tuning kann Parameter begünstigen, die eine schnellere Konvergenz oder kurzfristige Verbesserungen bei der Validierung erzielen, sich aber nicht verallgemeinern lassen.
from ultralytics import YOLO

# YOLO-Modell initialisieren
model = YOLO("yolo26n.pt")

# Suchraum definieren
search_space = {
    "lr0": (1e-5, 1e-2),
    "degrees": (0.0, 45.0),
}

# Hyperparameter auf COCO8 über 30 Epochen optimieren
model.tune(
    data="coco8.yaml",
    epochs=30,
    iterations=300,
    optimizer="AdamW",
    space=search_space,
    plots=False,
    save=False,
    val=False,
)
Unterbrochenes Hyperparameter-Tuning fortsetzen#
Du kannst eine unterbrochene Hyperparameter-Tuning-Sitzung fortsetzen, indem du resume=True übergibst. Optional kannst du das Verzeichnis name angeben, das unter runs/{task} verwendet wurde, um die Sitzung fortzusetzen. Ohne name wird das Verzeichnis mit dem Namen tune fortgesetzt. Dies ist der Standardname und nicht unbedingt der zuletzt ausgeführten Sitzung. Gib daher name für jeden Lauf an, den du mit einem benutzerdefinierten Namen gestartet hast. Außerdem musst du alle vorherigen Trainingsargumente angeben, darunter data, epochs, iterations und space.
from ultralytics import YOLO

# YOLO-Modell definieren
model = YOLO("yolo26n.pt")

# Suchraum definieren
search_space = {
    "lr0": (1e-5, 1e-2),
    "degrees": (0.0, 45.0),
}

# Vorherigen Lauf fortsetzen
results = model.tune(data="coco8.yaml", epochs=50, iterations=300, space=search_space, resume=True)

# Tuning-Lauf mit dem Namen 'tune_exp' fortsetzen
results = model.tune(data="coco8.yaml", epochs=50, iterations=300, space=search_space, name="tune_exp", resume=True)Ergebnisse#
Nach erfolgreichem Abschluss des Hyperparameter-Tunings erhältst du mehrere Dateien und Verzeichnisse mit den Ergebnissen des Tunings. Im Folgenden werden sie beschrieben:
Dateistruktur#
So sieht die Verzeichnisstruktur der Ergebnisse aus. Sweep-Verzeichnisse wie multitrain/ und multitrain-2/ enthalten einzelne Tuning-Iterationen, also jeweils ein Modell, das pro Datensatz mit einem Hyperparametersatz trainiert wurde. Für jeden Datensatz gibt es ein eigenes Unterverzeichnis. Um Speicherplatz zu sparen, löscht der Optimierer die Laufverzeichnisse der Datensätze für Iterationen, die nicht den aktuellen Bestwert erzielt haben. Das Verzeichnis tune/ enthält die Tuning-Ergebnisse aller einzelnen Modelltrainings:
runs/
└── detect/
    ├── multitrain/
    │   └── coco8/
    ├── multitrain-2/
    ├── ...
    └── tune/
        ├── best_hyperparameters.yaml
        ├── tune_fitness.png
        ├── tune_results.ndjson
        ├── tune_scatter_plots.png
        └── weights/
            ├── last.pt
└── best.ptDateibeschreibungen#
best_hyperparameters.yaml#
Diese YAML-Datei enthält die leistungsstärksten Hyperparameter, die während des Tunings gefunden wurden. Du kannst diese Datei verwenden, um künftige Trainings mit diesen optimierten Einstellungen zu initialisieren.
-
Format: YAML
-
Verwendung: Hyperparameter-Ergebnisse
-
Beispiel:
# 558/900 iterations complete ✅ (45536.81s)
# Results saved to /usr/src/ultralytics/runs/detect/tune
# Best fitness=0.64297 observed at iteration 498
# Best fitness metrics are {'metrics/precision(B)': 0.87247, 'metrics/recall(B)': 0.71387, 'metrics/mAP50(B)': 0.79106, 'metrics/mAP50-95(B)': 0.62651, 'val/box_loss': 2.79884, 'val/cls_loss': 2.72386, 'val/l1_loss': 0.68503, 'fitness': 0.64297}
# Best fitness model is /usr/src/ultralytics/runs/detect/tune/weights
# Best fitness hyperparameters are printed below.

lr0: 0.00269
lrf: 0.00288
momentum: 0.73375
weight_decay: 0.00015
warmup_epochs: 1.22935
warmup_momentum: 0.1525
box: 18.27875
cls: 1.32899
dfl: 0.56016
hsv_h: 0.01148
hsv_s: 0.53554
hsv_v: 0.13636
degrees: 0.0
translate: 0.12431
scale: 0.07643
shear: 0.0
perspective: 0.0
flipud: 0.0
fliplr: 0.08631
mosaic: 0.42551
mixup: 0.0
copy_paste: 0.0
tune_fitness.png#
Dieses Diagramm zeigt die Fitness in Abhängigkeit von der Anzahl der Iterationen. Damit kannst du nachvollziehen, wie sich der genetische Algorithmus im Laufe der Zeit entwickelt hat.
- Format: PNG
- Verwendung: Visualisierung der Leistung
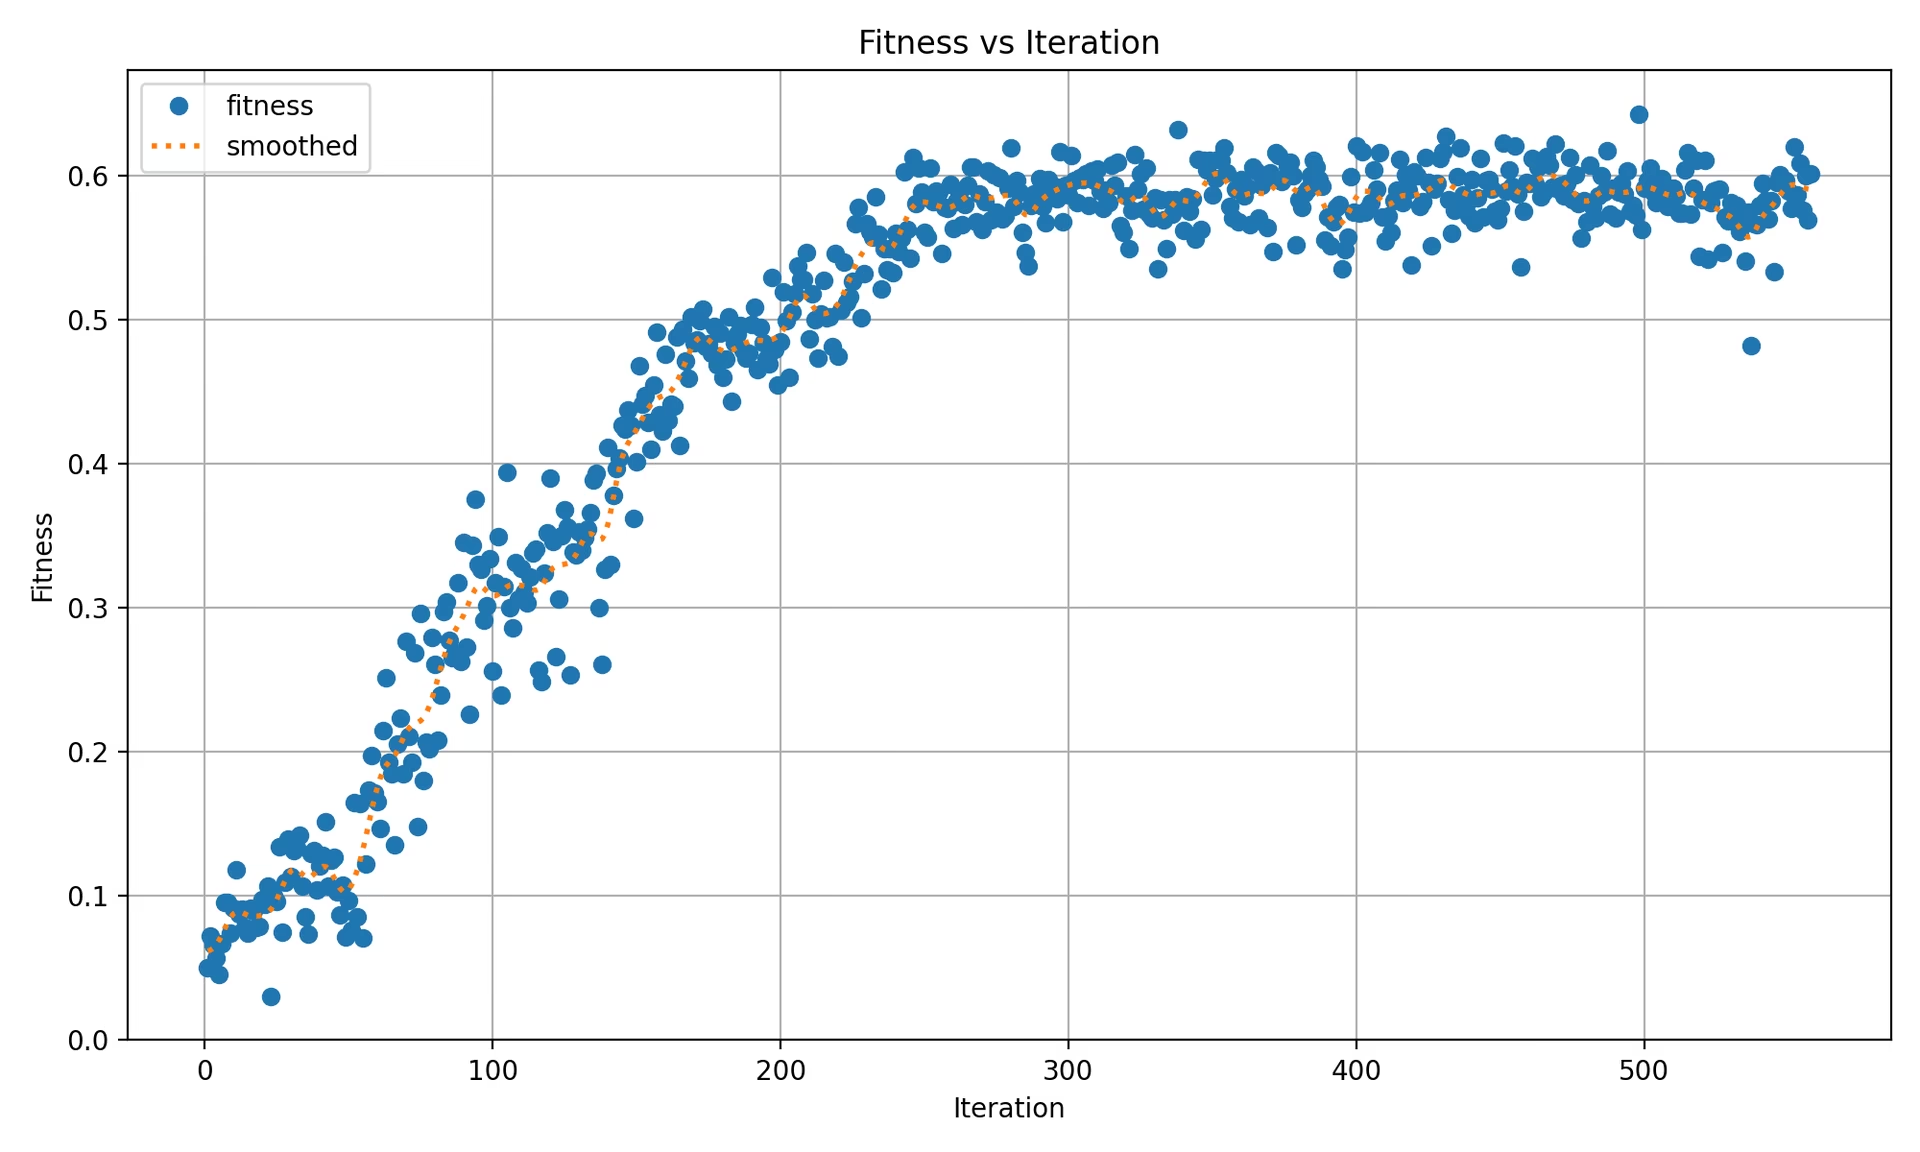
Das Diagramm enthält:
- Eine Markierung pro Iteration und Datensatz. Ein Lauf mit einem Datensatz zeigt daher einen Punkt pro Iteration, ein Lauf mit mehreren Datensätzen einen Punkt pro Datensatz und Iteration.
- Eine gepunktete Linie für den „geglätteten Mittelwert“, berechnet durch eine Gaußsche Glättung (
sigma=3) der übergeordneten Fitnesswerte pro Iteration.
tune_results.ndjson#
Eine NDJSON-Datei mit ausführlichen Ergebnissen jeder Tuning-Iteration. Jede Zeile enthält ein JSON-Objekt mit der aggregierten Fitness, den optimierten Hyperparametern und den Kennzahlen pro Datensatz. Für das Tuning mit einem oder mehreren Datensätzen wird dasselbe Dateiformat verwendet.
- Format: NDJSON
- Verwendung: Ergebnisse der einzelnen Iterationen nachverfolgen.
- Beispiel:
Zur besseren Lesbarkeit folgt ein formatiertes Beispiel. In der tatsächlichen Datei .ndjson wird jedes Objekt in einer einzelnen Zeile gespeichert.
{
    "iteration": 1,
    "fitness": 0.48628,
    "hyperparameters": {
        "lr0": 0.01,
        "lrf": 0.01,
        "momentum": 0.937,
        "weight_decay": 0.0005
    },
    "datasets": {
        "coco8": {
            "metrics/precision(B)": 0.65666,
            "metrics/recall(B)": 0.85,
            "metrics/mAP50(B)": 0.85086,
            "metrics/mAP50-95(B)": 0.64104,
            "val/box_loss": 1.57958,
            "val/cls_loss": 1.04986,
            "val/l1_loss": 1.32641,
            "fitness": 0.64104
        },
        "coco8-grayscale": {
            "metrics/precision(B)": 0.6582,
            "metrics/recall(B)": 0.51667,
            "metrics/mAP50(B)": 0.59106,
            "metrics/mAP50-95(B)": 0.33152,
            "val/box_loss": 1.95424,
            "val/cls_loss": 1.64059,
            "val/l1_loss": 1.70226,
            "fitness": 0.33152
        }
    },
    "save_dirs": {
        "coco8": "runs/detect/multitrain/coco8",
        "coco8-grayscale": "runs/detect/multitrain/coco8-grayscale"
    }
}
Der Wert fitness auf oberster Ebene ist der arithmetische Mittelwert der fitness-Werte der einzelnen Datensätze. Beim Tuning mit einem Datensatz enthält das datasets-Wörterbuch einen Eintrag, dessen fitness dem fitness-Wert auf oberster Ebene entspricht. Für jede abgeschlossene Iteration wird ein JSON-Objekt gespeichert. Die tatsächlichen Pfade save_dirs sind absolut und wurden oben aus Gründen der Lesbarkeit abgekürzt.
tune_scatter_plots.png#
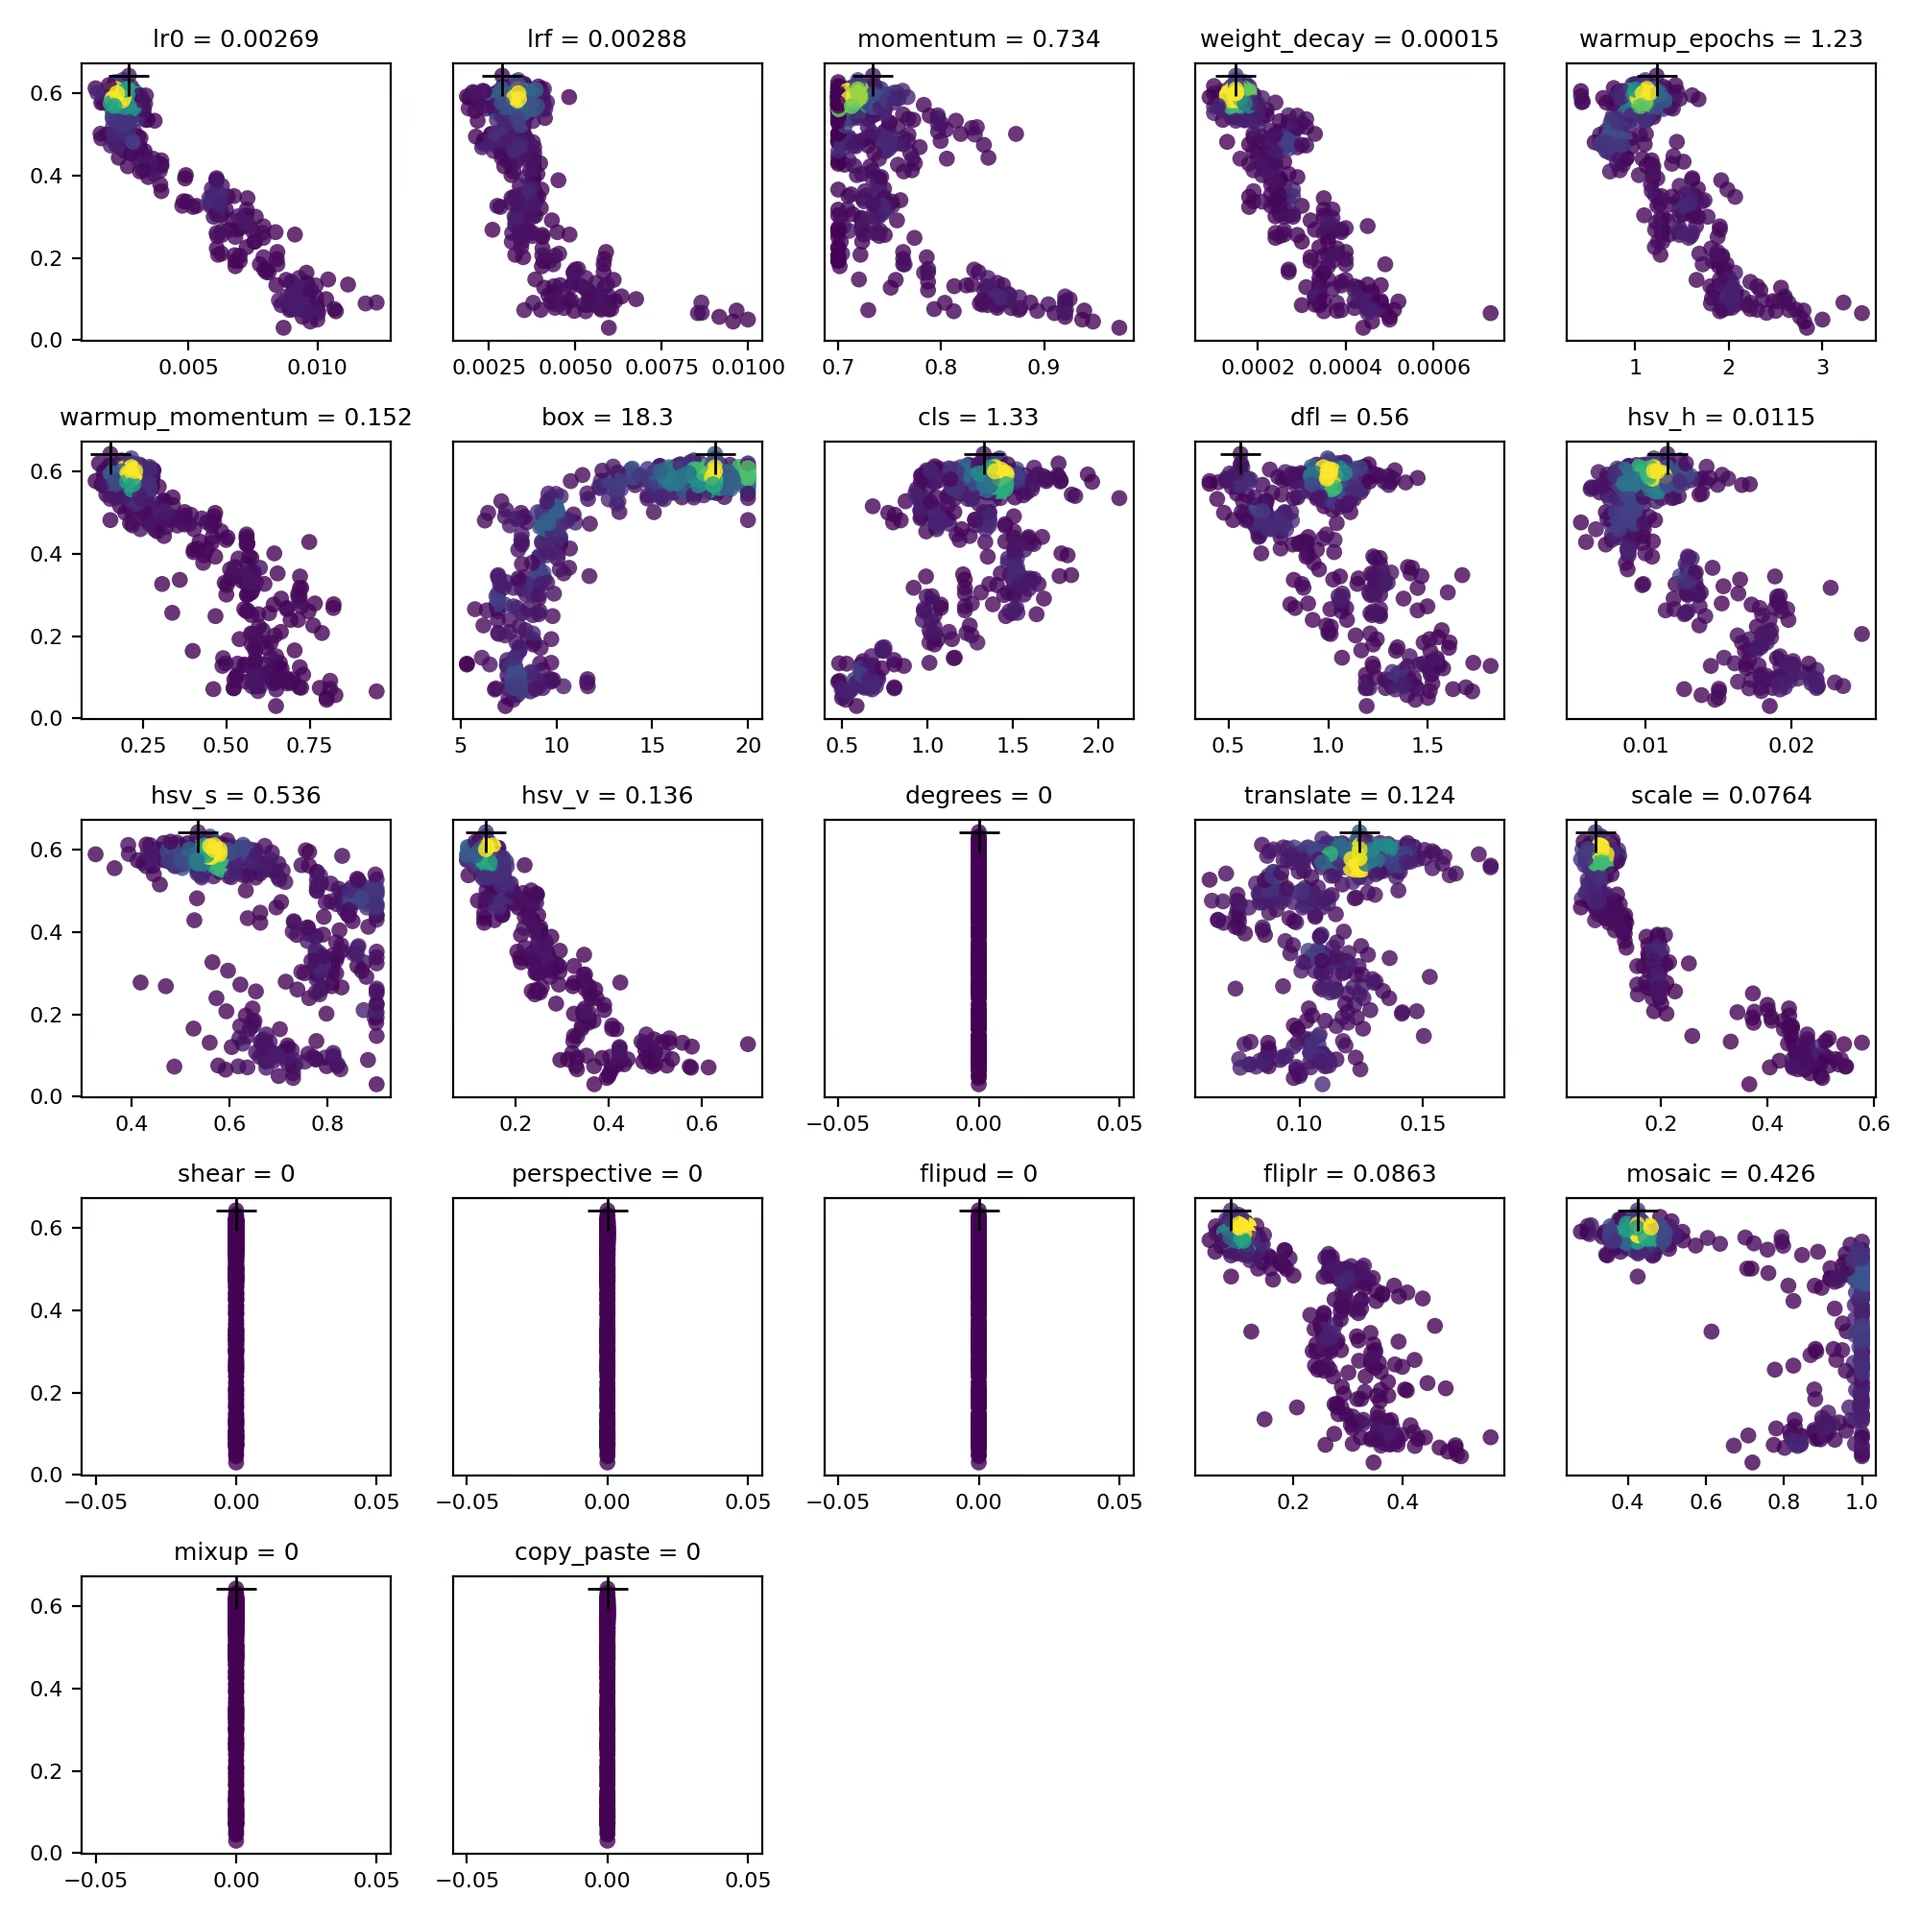
Diese Datei enthält Streudiagramme aus tune_results.ndjson, mit denen du Beziehungen zwischen verschiedenen Hyperparametern und Leistungskennzahlen untersuchen kannst. Bei der Mutation wird der konfigurierte Wertebereich jedes Hyperparameters verwendet. Daher können sich Werte ausgehend von Standardeinstellungen mit dem Wert null wie degrees und shear weiterentwickeln.
- Format: PNG
- Verwendung: Explorative Datenanalyse
weights/#
Dieses Verzeichnis enthält die gespeicherten PyTorch-Modelle aus der Iteration mit der höchsten Fitness des Tuning-Laufs. Beide Dateien stammen aus derselben Iteration:
last.pt: Gewichte aus der letzten Epoche des Trainingslaufs dieser Iteration.best.pt: Gewichte aus der Epoche mit der besten Fitness in dieser Iteration des Trainingslaufs.
Anhand dieser Ergebnisse kannst du fundiertere Entscheidungen für künftige Modelltrainings und Analysen treffen.
Fazit#
Das Optimieren von Hyperparametern in Ultralytics YOLO lässt sich einfach starten und ist unter der Haube leistungsstark: Ein genetischer Algorithmus nutzt eine fitnessgewichtete Auswahl und eine an den Wertebereich angepasste Mutation. Wenn du den in diesem Leitfaden beschriebenen Ablauf befolgst, kannst du dein Modell systematisch optimieren und die resultierende best_hyperparameters.yaml anschließend als Ausgangspunkt für künftige Trainingsläufe verwenden. Um die Optimierung auf parallele Versuche und fortgeschrittenere Suchalgorithmen auszuweiten, lies den Integrationsleitfaden zu Ray Tune oder führe verwaltete Jobs mit konfigurierbaren Hyperparametern und Echtzeit-Metriken auf der Ultralytics Platform mithilfe von Cloud-Training aus.
Für Einstellungen, die sich nicht über ein Argument festlegen lassen, etwa Lernraten pro Schicht oder eine benutzerdefinierte Fitnessmetrik, solltest du stattdessen den Trainer ableiten. Für einen tieferen Einblick kannst du den Quellcode der Klasse Tuner untersuchen. Bei Fragen oder Funktionswünschen kannst du dich über GitHub oder Discord an uns wenden.
Häufig gestellte Fragen#
Lege mit dem Parameter
lr0einen Anfangswert fest – übliche Werte reichen von0.001bis0.01– und lass ihn anschließend durch die Optimierung verändern, um den optimalen Wert zu finden. Das kannst du mit der Methodemodel.tune()automatisieren. Zum Beispiel:Beispielfrom ultralytics import YOLO # YOLO-Modell initialisieren model = YOLO("yolo26n.pt") # Hyperparameter auf COCO8 über 30 Epochen optimieren model.tune(data="coco8.yaml", epochs=30, iterations=300, optimizer="AdamW", plots=False, save=False, val=False)Weitere Einzelheiten findest du auf der Konfigurationsseite von Ultralytics YOLO.
Genetische Algorithmen bieten Ultralytics YOLO26 eine zuverlässige Möglichkeit, den Hyperparameterraum ohne manuelles Ausprobieren zu durchsuchen. Zu den wichtigsten Vorteilen gehören:
- Effiziente Suche: Die fitnessgewichtete Auswahl erhält leistungsstarke Konfigurationen, während die an den Wertebereich angepasste Mutation neue Kandidaten untersucht.
- Lokale Minima vermeiden: Zufällige Mutationen helfen der Suche, lokale Minima zu verlassen, in denen eine rein gierige Suche stecken bleiben könnte.
- Leistungsmetriken: Sie richten sich nach einem aufgabenspezifischen Eignungswert (bei Erkennung mAP50-95).
Wie genetische Algorithmen Hyperparameter optimieren können, erfährst du im Leitfaden zur Hyperparameterentwicklung.
Wie lange die Hyperparameteroptimierung mit Ultralytics YOLO dauert, hängt vor allem von Faktoren wie der Größe des Datensatzes, der Komplexität der Modellarchitektur, der Anzahl der Iterationen und den verfügbaren Rechenressourcen ab. So kann die Optimierung von YOLO26n auf einem Datensatz wie COCO8 über 30 Epochen je nach Hardware mehrere Stunden bis Tage dauern.
Lege vorab ein klares Zeitbudget für die Optimierung fest, wie unter Vorbereitung auf die Hyperparameteroptimierung beschrieben. So kannst du den Einsatz der Ressourcen und deine Optimierungsziele aufeinander abstimmen.
Um die Modellleistung während der Hyperparameteroptimierung in YOLO zu bewerten, kannst du mehrere wichtige Metriken heranziehen:
- AP50: Die durchschnittliche Präzision bei einem IoU-Schwellenwert von 0.50.
- F1-Wert: das harmonische Mittel aus Präzision und Trefferquote.
- Präzision und Trefferquote: Einzelmetriken, die die Genauigkeit des Modells bei der Erkennung echter positiver Fälle im Vergleich zu falsch positiven und falsch negativen Fällen angeben.
Diese Metriken helfen dir, verschiedene Aspekte der Modellleistung zu verstehen.
Ja, Ultralytics YOLO26 lässt sich für eine erweiterte Hyperparameteroptimierung in Ray Tune integrieren. Ray Tune bietet Suchalgorithmen wie Bayes'sche Optimierung und Hyperband sowie die Möglichkeit zur parallelen Ausführung, um den Optimierungsprozess zu beschleunigen.
Um Ray Tune mit YOLO26 zu verwenden, setze den Parameter
use_ray=Truein deinem Methodenaufrufmodel.tune().


Kommentare152
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
GengBin414(bearbeitet)
I tuned my defect detection dataset ,which are composed of 8000+ images, this is my tune code: model.tune( data="../data/data20260420_line_scan_merged_6ch.yaml", epochs=300, iterations=300, #space=search_space, #optimizer="AdamW", optimizer="MuSGD", lr0=0.01, momentum=0.9, shear=1, degrees=1, perspective=0.0001, mixup=0.1, cutmix=0.1, batch=20 )
I got the best mAP 0.586 at iteration 5 after tuned 30+ iterations, then I retrain the dataset with the following code: model.train( data="../data/data20260420_line_scan_merged_6ch.yaml", epochs=300, batch=20, imgsz=640, device=0, workers=16, optimizer="MuSGD", lr0=0.00721, lrf=0.01267, momentum=0.81816, weight_decay=0.00077, warmup_epochs=3.31429, warmup_momentum=0.95, box=7.11682, cls=0.48318, dfl=0.9397, hsv_h=0.00364, hsv_s=0.9, hsv_v=0.29751, degrees=0.99922, translate=0.07662, scale=0.51303, shear=0.76723, perspective=0.0, flipud=0.00019, fliplr=0.57639, bgr=0.00634, mosaic=0.62424, mixup=0.11307, cutmix=0.13007, copy_paste=0.00583, close_mosaic=10 #cfg="best_hyperparameters_map0.586.yaml" )
I copied the hyperparameters from best_hyperparameters_map0.586.yaml, but I got the best mAP 0.568, what cause the discrepancy?Can sb help me out? Thanks.
 Glenn JocherUltralytics
A small gap like
0.586 -> 0.568is usually expected becausetune()saves the best single stochastic run, while your latertrain()is a fresh run with different randomness and augmentation order; please first validate the tuning checkpointruns/detect/tune/weights/best.pt, then retrain with the exact same args plusseed=0anddeterministic=True, and make sure you are comparing the same metric (fitness/mAP50-95) described in the Hyperparameter Tuning guide. If the gap still looks too large, please share the text output from validating that checkpoint and the matching row fromtune_results.ndjsonhere in Discussions so the team can compare them directly.Thank you for your timely reply, I validated the tuning checkpoint, here is the text output from validating that checkpoint: (yolo26) ps@ps:~/Desktop/GB/ultralytics$ python val.py Ultralytics 8.4.26 🚀 Python-3.11.15 torch-2.5.1 CUDA:0 (NVIDIA GeForce RTX 4090 D, 24208MiB) YOLO26x summary (fused): 190 layers, 55,645,380 parameters, 0 gradients, 193.9 GFLOPs val: Fast image access ✅ (ping: 0.0±0.0 ms, read: 10744.4±1424.6 MB/s, size: 734.1 KB) val: Scanning /home/ps/Desktop/GB/ultralytics/datasets/Merged_6Chanel_20260420/imagesH/val.cache... 786 images, 47 backgrounds, 0 corrupt: 100% ━━━━━━━━━━━━ 786/786 412.1Mit/s 0.0s Class Images Instances Box(P R mAP50 mAP50-95): 100% ━━━━━━━━━━━━ 50/50 6.9it/s 7.2s all 786 1363 0.843 0.69 0.765 0.585 black 45 47 0.914 0.677 0.828 0.648 crack 120 145 0.681 0.517 0.55 0.334 edge 184 195 0.916 0.899 0.94 0.833 line 116 147 0.809 0.646 0.736 0.544 pit 73 89 0.775 0.543 0.642 0.447 raw 279 318 0.861 0.745 0.81 0.644 white 95 106 0.9 0.623 0.712 0.46 yellow 299 316 0.884 0.873 0.9 0.773 Speed: 0.9ms preprocess, 7.3ms inference, 0.0ms loss, 0.0ms postprocess per image Results saved to /home/ps/Desktop/GB/ultralytics/runs/detect/val81
I checked my retrain args, it show that seed=0 and deterministic=True already set: python train.py New https://pypi.org/project/ultralytics/8.4.53 available 😃 Update with 'pip install -U ultralytics' Ultralytics 8.4.26 🚀 Python-3.11.15 torch-2.5.1 CUDA:0 (NVIDIA GeForce RTX 4090 D, 24208MiB) engine/trainer: agnostic_nms=False, amp=True, angle=1.0, augment=False, auto_augment=randaugment, batch=20, bgr=0.00634, box=7.11682, cache=False, cfg=None, classes=None, close_mosaic=10, cls=0.48318, compile=False, conf=None, copy_paste=0.00583, copy_paste_mode=flip, cos_lr=False, cutmix=0.13007, data=../data/data20260420_line_scan_merged_6ch.yaml, degrees=0.99922, deterministic=True, device=0, dfl=0.9397, dnn=False, dropout=0.0, dynamic=False, embed=None, end2end=None, epochs=500, erasing=0.4, exist_ok=False, fliplr=0.57639, flipud=0.00019, format=torchscript, fraction=1.0, freeze=None, half=False, hsv_h=0.00364, hsv_s=0.9, hsv_v=0.29751, imgsz=640, int8=False, iou=0.7, keras=False, kobj=1.0, line_width=None, lr0=0.00721, lrf=0.01267, mask_ratio=4, max_det=300, mixup=0.11307, mode=train, model=yolo26x.pt, momentum=0.81816, mosaic=0.62424, multi_scale=0.0, name=train137, nbs=64, nms=False, opset=None, optimize=False, optimizer=MuSGD, overlap_mask=True, patience=100, perspective=0.0, plots=True, pose=12.0, pretrained=True, profile=False, project=None, rect=False, resume=False, retina_masks=False, rle=1.0, save=True, save_conf=False, save_crop=False, save_dir=/home/ps/Desktop/GB/ultralytics/runs/detect/train137, save_frames=False, save_json=False, save_period=-1, save_txt=False, scale=0.51303, seed=0, shear=0.76723, show=False, show_boxes=True, show_conf=True, show_labels=True, simplify=True, single_cls=False, source=None, split=val, stream_buffer=False, task=detect, time=None, tracker=botsort.yaml, translate=0.07662, val=True, verbose=True, vid_stride=1, visualize=False, warmup_bias_lr=0.1, warmup_epochs=3.31429, warmup_momentum=0.95, weight_decay=0.00077, workers=16, workspace=None
And here is the train output: Epoch GPU_mem box_loss cls_loss dfl_loss Instances Size 260/300 20.8G 0.4503 0.4947 0.004246 50 640: 100% ━━━━━━━━━━━━ 354/354 2.7it/s 2:10 Class Images Instances Box(P R mAP50 mAP50-95): 100% ━━━━━━━━━━━━ 20/20 4.5it/s 4.4s all 786 1363 0.841 0.682 0.751 0.564 EarlyStopping: Training stopped early as no improvement observed in last 100 epochs. Best results observed at epoch 160, best model saved as best.pt. To update EarlyStopping(patience=100) pass a new patience value, i.e.
patience=300or usepatience=0to disable EarlyStopping.260 epochs completed in 9.792 hours. Optimizer stripped from /home/ps/Desktop/GB/ultralytics/runs/detect/train138/weights/last.pt, 118.4MB Optimizer stripped from /home/ps/Desktop/GB/ultralytics/runs/detect/train138/weights/best.pt, 118.4MB
Validating /home/ps/Desktop/GB/ultralytics/runs/detect/train138/weights/best.pt... Ultralytics 8.4.26 🚀 Python-3.11.15 torch-2.5.1 CUDA:0 (NVIDIA GeForce RTX 4090 D, 24208MiB) YOLO26x summary (fused): 190 layers, 55,645,380 parameters, 0 gradients, 193.9 GFLOPs Class Images Instances Box(P R mAP50 mAP50-95): 100% ━━━━━━━━━━━━ 20/20 4.9it/s 4.1s all 786 1363 0.826 0.685 0.758 0.568 black 45 47 0.882 0.634 0.773 0.579 crack 120 145 0.675 0.559 0.577 0.314 edge 184 195 0.925 0.885 0.949 0.824 line 116 147 0.785 0.667 0.714 0.52 pit 73 89 0.84 0.528 0.662 0.447 raw 279 318 0.812 0.72 0.804 0.638 white 95 106 0.802 0.611 0.674 0.434 yellow 299 316 0.888 0.877 0.911 0.787 Speed: 0.1ms preprocess, 4.4ms inference, 0.0ms loss, 0.0ms postprocess per image Results saved to /home/ps/Desktop/GB/ultralytics/runs/detect/train138
And I don't know where to find tune_results.ndjson mentioned in your reply. I guess you mean the matching row from tune_results.csv then here is: fitness lr0 lrf momentum weight_decay warmup_epochs warmup_momentum box cls dfl hsv_h hsv_s hsv_v degrees translate scale shear perspective flipud fliplr bgr mosaic mixup cutmix copy_paste close_mosaic 0.58582 0.00721 0.01267 0.81816 0.00077 3.31429 0.95 7.11682 0.48318 0.9397 0.00364 0.9 0.29751 0.99922 0.07662 0.51303 0.76723 0 0.00019 0.57639 0.00634 0.62424 0.11307 0.13007 0.00583 10
- Glenn JocherUltralytics
The main issue I see is that your retrain is not matching the tuned trial: the runtime log shows
epochs=500rather than300, so the schedule driven bylr0andlrfis different and that alone can explain0.585 -> 0.568; the current Hyperparameter Tuning guide writestune_results.ndjsonunderruns/detect/tune/, but in your older8.4.26install the equivalent may betune_results.csv, so please rerun with the exact runtime args from the best trial, especiallyepochs=300and the samepatience, and if it still printsepochs=500then another override is being applied. Sorry, after hyperparameter tuning, I retrained first with epochs=500, observed mAP=0.57, then I changed epochs=300, observed mAP=0.568. In the previous reply, I mistakenly copied the retrain args from the epochs=500 run. But the train output is correctly copied from the epochs=300 run, you can tell this out from the EarlyStopping output: Epoch GPU_mem box_loss cls_loss dfl_loss Instances Size 260/300 20.8G 0.4503 0.4947 0.004246 50 640: 100% ━━━━━━━━━━━━ 354/354 2.7it/s 2:10 Class Images Instances Box(P R mAP50 mAP50-95): 100% ━━━━━━━━━━━━ 20/20 4.5it/s 4.4s all 786 1363 0.841 0.682 0.751 0.564 EarlyStopping: Training stopped early as no improvement observed in last 100 epochs. Best results observed at epoch 160, best model saved as best.pt. To update EarlyStopping(patience=100) pass a new patience value, i.e. patience=300 or use patience=0 to disable EarlyStopping.
And the retrain args of the epochs=300 run, it shows that seed=0 and deterministic=True already set: python train.py New https://pypi.org/project/ultralytics/8.4.53 available 😃 Update with 'pip install -U ultralytics' Ultralytics 8.4.26 🚀 Python-3.11.15 torch-2.5.1 CUDA:0 (NVIDIA GeForce RTX 4090 D, 24208MiB) engine/trainer: agnostic_nms=False, amp=True, angle=1.0, augment=False, auto_augment=randaugment, batch=20, bgr=0.00634, box=7.11682, cache=False, cfg=None, classes=None, close_mosaic=10, cls=0.48318, compile=False, conf=None, copy_paste=0.00583, copy_paste_mode=flip, cos_lr=False, cutmix=0.13007, data=../data/data20260420_line_scan_merged_6ch.yaml, degrees=0.99922, deterministic=True, device=0, dfl=0.9397, dnn=False, dropout=0.0, dynamic=False, embed=None, end2end=None, epochs=300, erasing=0.4, exist_ok=False, fliplr=0.57639, flipud=0.00019, format=torchscript, fraction=1.0, freeze=None, half=False, hsv_h=0.00364, hsv_s=0.9, hsv_v=0.29751, imgsz=640, int8=False, iou=0.7, keras=False, kobj=1.0, line_width=None, lr0=0.00721, lrf=0.01267, mask_ratio=4, max_det=300, mixup=0.11307, mode=train, model=yolo26x.pt, momentum=0.81816, mosaic=0.62424, multi_scale=0.0, name=train138, nbs=64, nms=False, opset=None, optimize=False, optimizer=MuSGD, overlap_mask=True, patience=100, perspective=0.0, plots=True, pose=12.0, pretrained=True, profile=False, project=None, rect=False, resume=False, retina_masks=False, rle=1.0, save=True, save_conf=False, save_crop=False, save_dir=/home/ps/Desktop/GB/ultralytics/runs/detect/train138, save_frames=False, save_json=False, save_period=-1, save_txt=False, scale=0.51303, seed=0, shear=0.76723, show=False, show_boxes=True, show_conf=True, show_labels=True, simplify=True, single_cls=False, source=None, split=val, stream_buffer=False, task=detect, time=None, tracker=botsort.yaml, translate=0.07662, val=True, verbose=True, vid_stride=1, visualize=False, warmup_bias_lr=0.1, warmup_epochs=3.31429, warmup_momentum=0.95, weight_decay=0.00077, workers=16, workspace=None
 Murat Raimbekov
quick check on what is likely going on, framed generally: tune saves the best of N stochastic trials, and a single retrain is one new stochastic draw with the same hyperparameters. bit-exact reproduction between the two is not guaranteed even with
seed=0, deterministic=True. ourinit_seeds(deterministic=True)setstorch.use_deterministic_algorithms(True, warn_only=True)inultralytics/utils/torch_utils.py, matching the pytorch reproducibility notes - cuda ops without a deterministic alternative still run non-deterministically with just a warning. over many epochs on a real dataset that variance can compound.a few practical takeaways before assuming the gap is a tuning bug:
- your trial weights at
runs/detect/tune/weights/best.ptalready validate to 0.585, so the trial result is real and reusable - if you need exactly that performance for deployment, use that checkpoint directly. - the recommended way to reuse tuned hyperparameters in a fresh train run is
cfg="runs/detect/tune/best_hyperparameters.yaml"(the commented-out line in your script). that file contains the exact values the trial used and matches the workflow described in the hyperparameter tuning guide. - to bound run-to-run variance, retrain a few times with
seed=0,seed=1,seed=2and compare the mean against the tune's reported best, not a single retrain.
unrelated, you are on ultralytics 8.4.26 and the current release is 8.4.53; for new tuning runs it is worth updating.
- your trial weights at
 User
Hi, I have a question about Hyperparameter Tuning. What value of
epochsanditerationsshould I pass to model.tune(). Default value of epochs is 100, and iterations is 10. Are the default values OK, or should I change them ? My dataset is about 10,000 images.- Glenn JocherUltralytics
For a 10k-image dataset, the defaults are fine for a quick sanity check, but for useful tuning you should set
epochsclose to your real training length becauseepochsis per trial, whileiterationsis how many different trials are tested; a practical starting point isepochs=50to100withiterations=30to100depending on your compute budget, then retrain once with the best settings frombest_hyperparameters.yamlas shown in the Hyperparameter Tuning guide.1 - User
Thank you very much ! I will try to search the best hyperparameters !
- Glenn JocherUltralytics
You're welcome — sounds good; if anything looks off during tuning, please share your
model.tune()call plus the resultingbest_hyperparameters.yamlortune_results.ndjsonhere, and we can help compare it against the expected outputs in the Hyperparameter Tuning guide.
harunemrekiran61
You’ve shown the box range as 0.02 to 0.2, but the default value appears to be 7.5. Is there a mistake here? Could you please check?
- Glenn JocherUltralytics
Good catch —
boxis a loss gain (default7.5during training), so the0.02–0.2range shown in the docs table is outdated/incorrect; the current built-in tuner boundsboxto1.0–20.0(see the Tuner class reference), and you can always override it viaspace={...}as shown in the Hyperparameter Tuning guide.
Larry-zhai
How can I directly apply the optimized best_hyperparameters.yaml to my training? In fact, when I use code similar to the following: from ultralytics import YOLO model = YOLO("yolov8n.pt") model.train(data="data.yaml", hyp="hyp.yaml") an error occurs: SyntaxError: 'hyp' is not a valid YOLO argument.
 J.Q. Pan
Hi I have used the above code to apply the tuning but neither the diagram nor the models will be saved. I only get a single tune folder with all tuning details. I may ask if someone else has also the same problem.
BrianNieuwenhuis
When running the code below the model.tune() call does not recognize my model specification. Could someone explain to me what I am doing wrong. I am using model.overrides so that I can also tune the shear and perspective parameters that are otherwise initialized at 0.
from ultralytics import YOLO import wandb from ultralytics import settings settings.update({"wandb": True})
import argparse
def main(): # parse command-line args if needed parser = argparse.ArgumentParser() parser.add_argument("--gpus", type=int, default=1) parser.add_argument("--workers", type=int, default=4) args = parser.parse_args()
# Define a YOLO model
model = YOLO("yolo11x.pt")

# Dynamically assign GPUs based on --gpus argument
device = list(range(args.gpus))  # e.g., [0, 1, 2, 3] if args.gpus = 4

# Define search space
search_space = {
    "lr0": (1e-5, 1e-1),
    "lrf": (0.01, 1.0),
    "momentum": (0.6, 0.98),
    "weight_decay": (0.0, 0.001),
    "warmup_epochs": (0, 5),
    "warmup_momentum": (0.0,0.95),
    "box": (0.02, 0.2),
    "cls": (0.2, 4.0),
    "hsv_h": (0.0, 0.1),
    "hsv_s": (0.0, 0.9),
    "hsv_v": (0.0, 0.9),
    "translate":(0.0, 0.9),
    "scale": (0.0, 0.9),
    "shear": (0.0, 10.0),
    "perspective": (0.0, 0.001),
    "mosaic": (0.0,1.0),
    "mixup": (0.0, 1.0),
    "copy_paste": (0.0, 1.0)
}

# Manually initialize certain hperparameters that would not be tuned otherwise
model.overrides = {
    'shear': 1,
    'perspective': 0.001,
    'mixup': 0.01,
    'copy_paste' : 0.01,

}

# tune the model
results = model.tune(project='./tune/crop1344',name="tune_default_batch16_v100", use_ray = False,
    data="data.yaml",
    #hyp="custom_hyp.yaml", # this does not seem to work work for tune scripts!!
    batch = 16,
    imgsz = 1344,
    device = device,
    workers = args.workers,

    degrees = 180, #these parameters are fixed in the model tune
    flipud = 0.5,
    fliplr = 0.5,
    bgr = 0,
    auto_augment = None,
    #erasing = 0,

    epochs = 100,
    iterations=10,
    space=search_space,
    optimizer="AdamW",
    resume=False,  #start over or resume previous checkpoint
    plots=False,  # don't make plots etc to save time until last timepoint
    save=False,
    val=False,
    verbose=False)
if name == "main": main()
yyagmurkyaa
Hello again, I have trained new models using the parameters you provided and by organizing my datasets. However, a common issue across all of them is that the models mistakenly classify objects like myself or nearby computer screens as the traffic sign "turn right ahead" (which is one of the labeled classes in my dataset). I have checked my dataset and confirmed that there are no such unrelated objects in the background.
Additionally, the models sometimes confuse left and right directional signs.
Why might these errors be occurring, and how can I fix them? Thank you in advance for your help.
- Glenn JocherUltralytics(bearbeitet)
@Fatima-khanjar to balance precision and recall in your over-predicting model, try these adjustments:
- Increase confidence threshold during inference (not training) to filter out low-confidence predictions
- Adjust IoU threshold in NMS to reduce duplicate detections
- Increase classification loss weight with
cls=1.0or higher to improve class discrimination - Check annotation quality in your dataset, especially for small or ambiguous objects
- Add hard negative examples to your dataset - images with objects similar to your classes but not actually part of them
These changes should help improve precision without significantly sacrificing your excellent recall. For implementation details, see our NMS documentation for confidence thresholding examples.
@yyagmurkyaa for your traffic sign confusion issues:
-
For the model detecting unrelated objects as "turn right ahead" signs:
- Add "hard negative" examples to your training set (images with computers, people, but no traffic signs)
- Increase
cls=1.0or higher to improve classification accuracy - Check if the "turn right ahead" sign has visual similarities to these false positives
-
For left/right confusion:
- Create specific augmentations for directional signs without flipping (as you noted)
- Ensure balanced examples of both directional types
- Consider using a slightly larger model like YOLO26m for better feature discrimination
These targeted adjustments should help address the specific confusion patterns you're seeing.
Fatima-khanjar
Hello again!!
First of all, thank you so much for your help @glenn-jocher __ you've truly helped me a lot, and I really appreciate it!
I have a question regarding fine-tuning a pre-trained YOLO model (e.g., trained on the COCO dataset) for my custom use case. My dataset includes a combination of both new classes (not present in COCO) and some of the existing COCO classes , but with different layouts or contexts.
What I’d like to do is the following:
Add my new classes starting from index 80, while still leveraging the pre-trained weights for the existing COCO classes.
Ideally, I want to preserve the learned knowledge for the COCO classes (especially the ones shared with my dataset), and only train the model further on the new classes.
Is it possible to:
Fine-tune the model in such a way that it uses the pre-trained weights for the common classes, and only learns new classes from scratch starting from a different index?
Retain and benefit from the original COCO knowledge while introducing and training on new class definitions?
Also, I’ve noticed that when I fine-tune a pre-trained model and define my own data.yaml file — completely different from coco.yaml — I redefine the class names and indexes based on my custom dataset, completely removing the COCO classes not present in my data. In this case, what really happens during fine-tuning or transfer learning under the hood? Is the model discarding unused class weights? Are shared class weights still used effectively?
I'd greatly appreciate any clarification or guidance on how to approach this setup properly.
Best regards,
- Glenn JocherUltralytics
@Fatima-khanjar great question about fine-tuning with mixed COCO and custom classes!
Yes, you can leverage pre-trained COCO weights while adding new classes. Here's how:
-
When fine-tuning a YOLO model, the model's detection head is automatically resized to accommodate your new class count. The weights for existing classes are preserved where possible.
-
For classes that overlap with COCO, the model will leverage transfer learning from those pre-trained weights, while new classes will be initialized with random weights.
-
You don't need to explicitly start from index 80 - just define your classes in your data.yaml file, and the model will handle the mapping automatically.
-
During fine-tuning, the model doesn't discard unused class weights but rather reshapes the classification head to match your class count. Weights for classes that exist in both datasets are transferred and further optimized for your specific data.
For best results with mixed classes, I recommend using a smaller learning rate initially (e.g.,
lr0=0.001) to preserve the knowledge in the pre-trained weights while allowing the model to adapt to your new classes. -
Hello! @glenn-jocher thank you so much for your explanation!
I have a follow-up question regarding class index matching. Let's say the person class in the COCO dataset is indexed as 0, but in my data.yaml file, I assign person to index 5. In this case, the model will not treat the person at index 5 as the same class as COCO’s index 0, correct?
So, to benefit from the pretrained weights of shared classes, do the class indices in my custom dataset need to match the COCO indices exactly?
Best regards,
- Glenn JocherUltralytics(bearbeitet)
@Fatima-khanjar you're asking a crucial question about class mapping during transfer learning!
You no longer need to keep COCO's class indices. With
cls_remap=True(the default), training copies the pretrained classification-head rows by class name, so a class such aspersonkeeps its pretrained weights at whatever index it has in your dataset, while new classes such astraffic_signstart from fresh weights. Training printsRemapped N/M cls head rows from pretrained weights by class namewhen rows are copied, andcls_remap=Falsedisables it. For example, thisdata.yamlworks:names: 0: person 1: car 2: traffic_signJust make sure the shared classes use the same names as in COCO. See the Fine-Tuning Guide for details.
@glenn-jocher Hello again!!!
Thank you so much for your clarification! I have a quick follow-up question.
Let’s say the COCO dataset defines the following class indices in its YAML file: 0: person, 2: car, 3: cat.
In my own dataset, I share only the person and car classes with COCO — I don’t want to include cat. If I define my shared classes using the same indices as COCO (i.e., 0: person, 2: car), but then replace the COCO class cat at index 3 with a new class (e.g., 3: animal), will I still benefit from the pretrained weights for the shared classes (person and car)?
Or will assigning a new class at an index previously used by COCO (like 3) cause any issues?
best regards,
- Glenn JocherUltralytics(bearbeitet)
@Fatima-khanjar great question about reusing COCO indices for new classes!
With
cls_remap=True(the default), pretrained classification-head rows are matched by class name, not by index. Shared classes such aspersonandcarkeep their pretrained weights wherever they sit in your dataset. A new class like "animal" at index 3 does not inherit the pretrained "cat" row, because the names do not match, so it starts from fresh weights. Reusing a COCO index therefore neither helps nor hurts the shared classes.If a new class is close to a pretrained one, give it that class's name so its row is copied. Using a lower learning rate initially (e.g.,
lr0=0.001) also helps preserve the pretrained features while the model adapts to your new classes.1
Thank you for your feedback. I trained my dataset using YOLOv11s. Although I didn’t experience severe overfitting with the current parameters, I couldn’t achieve optimal performance either. Some traffic signs were misclassified or not detected at all.
While searching for the best hyperparameters, I realized that I hadn't applied data augmentation—except for the flip parameter. I have an example parameter file, and I plan to include all relevant augmentation options except for flipping.
I would really appreciate your help in finding the most suitable parameters for my dataset, as I’m planning to participate in a competition soon. I need to enhance my model by adjusting the parameters properly to achieve the best possible performance.
Thank you in advance for your support.
On Sun, Apr 20, 2025 at 1:51 PM phatima khanjar @.***> wrote:
Hello,
I hope this message finds you well.
image.png (view on web) https://github.com/user-attachments/assets/be6db84b-fe0d-4356-ba77-9b4426c253ee
I fine-tuned YOLOv11s on my custom dataset, which is relatively small (1,156 images split into 75% training, 15% validation, and 10% test). The dataset consists of 41 classes, with each class containing between 200 and 300 images. I experimented with three different sets of hyperparameters: the default values, those optimized using Ray Tune, and others obtained through a Genetic Algorithm. In all cases, I observed oscillations in the validation dfl and box losses, which may indicate signs of overfitting. I would appreciate any suggestions or insights on how to address this issue, particularly given the small size of the dataset, and how to improve model generalization.
best regards,
— Reply to this email directly, view it on GitHub https://github.com/orgs/ultralytics/discussions/9536#discussioncomment-12889695, or unsubscribe https://github.com/notifications/unsubscribe-auth/BPQ7ZLAQ2G7ZL434FN3WFYD22N345AVCNFSM6AAAAABFVXPSL2VHI2DSMVQWIX3LMV43URDJONRXK43TNFXW4Q3PNVWWK3TUHMYTEOBYHE3DSNI . You are receiving this because you were mentioned.Message ID: @.*** com>
- Glenn JocherUltralytics(bearbeitet)
@yyagmurkyaa for traffic sign detection and classification with YOLO26s, I recommend focusing on these specific augmentation and training parameters:
from ultralytics import YOLO

model = YOLO("yolo26s.pt")
model.train(
    data="your_traffic_signs.yaml",
    epochs=100,
    patience=25,
    batch=16,
    imgsz=640,  # Consider 800+ for small traffic signs
    hsv_h=0.015,  # Color augmentation helps with varying lighting conditions
    hsv_s=0.7,
    hsv_v=0.4,
    scale=0.5,  # Scale augmentation critical for varying distances
    translate=0.1,  # Helps with signs at different positions
    mosaic=1.0,  # Excellent for object detection tasks
    mixup=0.1,  # Light mixup can help with generalization
    perspective=0.0005,  # Slight perspective change for different viewing angles
    weight_decay=0.0005,  # Regularization to reduce overfitting
    optimizer="AdamW",
    lr0=0.001,
    lrf=0.01,
    cos_lr=True  # Cosine learning rate scheduler
)
For traffic sign detection specifically:
- Increase image size to better detect small signs
- Focus on color-preserving augmentations as colors are critical for traffic signs
- Use perspective transformations to simulate different viewing angles
- Enable strong scale/translate augmentations to handle varying distances
Consider running
model.tune()with these parameters as starting points to find the optimal configuration for your competition. You might also need to address class imbalance if some signs appear less frequently in your dataset. You're very welcome! I wasn't expecting such a quick response either. I'm excited to hear that you'll be training with these parameters and look forward to seeing the results as soon as possible. Thank you again for your support!
- Glenn JocherUltralytics(bearbeitet)
@Fatima-khanjar for a small dataset (1,156 images) with 41 classes, oscillations in validation losses often indicate overfitting. Here are specific recommendations to improve generalization:
-
Strengthen regularization:
- Increase
weight_decayto 0.001-0.003 - Add dropout with
dropout=0.1to reduce co-adaptation
- Increase
-
Enhance data augmentation:
- Maximize augmentations:
mosaic=1.0,mixup=0.2,copy_paste=0.1 - Use strong geometric transforms:
translate=0.2,scale=0.5
- Maximize augmentations:
-
Training modifications:
- Reduce model complexity by using YOLO26n instead of YOLO26s
- Implement gradual unfreezing (
freezelayers at first) - Enable
cos_lr=Truefor smoother learning rate decay
-
Consider transfer learning modifications:
- Start with a model pre-trained on a domain similar to yours
- Use fewer epochs with higher
patiencefor early stopping
With 41 classes and limited samples per class, these techniques should help stabilize training and improve generalization. You might also benefit from training ensembles of multiple models if computational resources allow. For more details, refer to our Model Training Tips.
-
Hello,
Thank you for your advice! Your instructions have improved my model’s performance compared to before. I have now achieved the following metrics:
Mean Precision: 0.794 Mean Recall: 0.99 Mean F1 Score: 0.881 mAP@0.5: 0.938 mAP@0.5-0.95: 0.827
After analyzing these results, it seems that the model is over-predicting. Do you have any suggestions on how I can better balance precision and recall?
best regards,
Hello,
I hope this message finds you well.
I fine-tuned YOLOv11s on my custom dataset, which is relatively small (1,156 images split into 75% training, 15% validation, and 10% test). The dataset consists of 41 classes, with each class containing between 200 and 300 images. I experimented with three different sets of hyperparameters: the default values, those optimized using Ray Tune, and others obtained through a Genetic Algorithm. In all cases, I observed oscillations in the validation dfl and box losses, which may indicate signs of overfitting. I would appreciate any suggestions or insights on how to address this issue, particularly given the small size of the dataset, and how to improve model generalization.
best regards,
Hello, I am training a model using YOLOv11, and the dataset consists of traffic signs. There are 22 classes, and each class has 400 labeled images. I’m not sure what parameters I should use for training. What parameters should I set to prevent overfitting, and what are the correct values? Could you help me with this?
- Glenn JocherUltralytics(bearbeitet)
@yyagmurkyaa your dataset of 22 classes with 400 images per class should provide a good foundation for traffic sign detection. To prevent overfitting with YOLO26, I'd recommend:
- Start with hyperparameter tuning using the
model.tune()method to find optimal values:
from ultralytics import YOLO model = YOLO("yolo26n.pt") # Start with a smaller model for faster tuning model.tune( data="your_traffic_signs.yaml", epochs=30, iterations=100, weight_decay=0.0005, # Try higher values like 0.001-0.005 to increase regularization patience=15, # Early stopping val=True )-
Key hyperparameters to prevent overfitting:
- Increase
weight_decay(0.001-0.005) - Enable strong data augmentation (
hsv_h,hsv_s,translate,scale,fliplr,mosaic) - Use early stopping with reasonable
patience - Consider reducing model capacity (use n or s model variants)
- Increase
-
Monitor validation metrics to detect overfitting (when training accuracy continues improving but validation metrics plateau or decline)
The automated tuning process should help identify the optimal parameter values for your specific dataset. For more details, check out our Hyperparameter Tuning Guide.
- Start with hyperparameter tuning using the
Thank you for your feedback. I trained my dataset using YOLOv11s. Although I didn’t experience severe overfitting with the current parameters, I couldn’t achieve optimal performance either. Some traffic signs were misclassified or not detected at all.
While searching for the best hyperparameters, I realized that I hadn't applied data augmentation—except for the flip parameter. I have an example parameter file, and I plan to include all relevant augmentation options except for flipping.
I would really appreciate your help in finding the most suitable parameters for my dataset, as I’m planning to participate in a competition soon. I need to enhance my model by adjusting the parameters properly to achieve the best possible performance.
Thank you in advance for your support.