SAM 2: Segmentierungsmodell 2 für beliebige Objekte

SAM 2, der Nachfolger von Metas Segment Anything Model (SAM), ist ein einheitliches Modell für die promptbasierte Objektsegmentierung in Bildern und Videos. Seine einheitliche, über Eingabeaufforderungen steuerbare Architektur unterstützt Echtzeitverarbeitung und Zero-Shot-Generalisierung.
SAM 2.1-Modelle ermöglichen die Funktion für intelligente Annotationen auf der Ultralytics Platform und damit eine klickbasierte Segmentierung für die schnelle Kennzeichnung von Datensätzen. Einzelheiten findest du in der Anleitung zur Annotation.
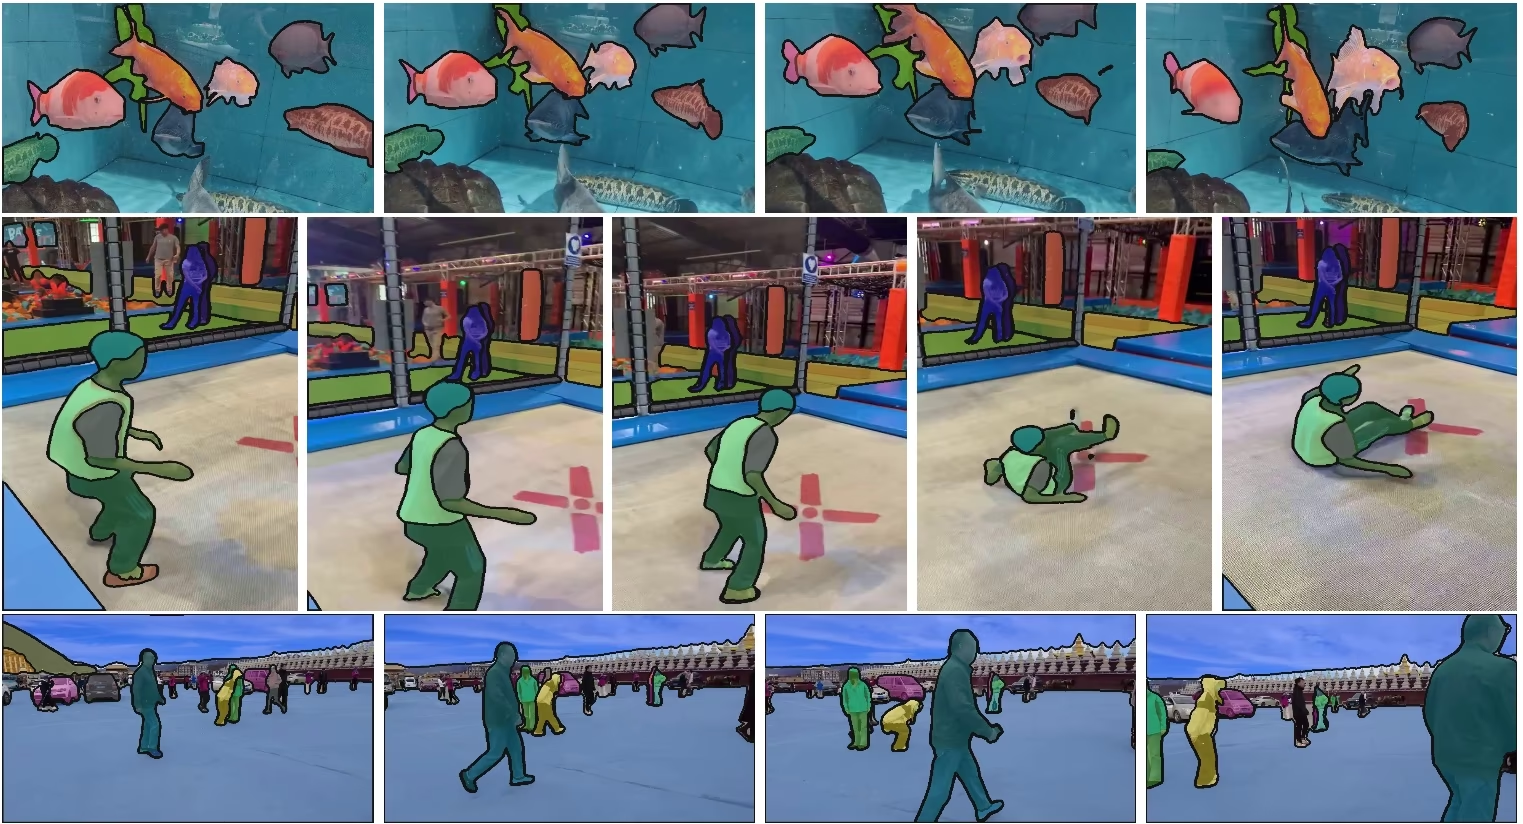
Wichtige Funktionen#
Ansehen: So führst du mit Ultralytics Inferenz mit Metas SAM2 aus | Schritt-für-Schritt-Anleitung
Einheitliche Modellarchitektur#
SAM 2 vereint die Funktionen zur Segmentierung von Bildern und Videos in einem einzigen Modell. Diese Vereinheitlichung vereinfacht die Bereitstellung und ermöglicht eine konsistente Leistung bei unterschiedlichen Medientypen. Das Modell verwendet eine flexible eingabeaufforderungsbasierte Schnittstelle, über die du interessante Objekte mit verschiedenen Arten von Eingaben wie Punkten, Begrenzungsrahmen oder Masken angeben kannst.
Echtzeitleistung#
Das Modell erreicht Inferenzgeschwindigkeiten in Echtzeit und verarbeitet ungefähr 44 Bilder pro Sekunde. Dadurch eignet sich SAM 2 für Anwendungen, die eine unmittelbare Rückmeldung erfordern, etwa Videobearbeitung und erweiterte Realität.
Zero-Shot-Verallgemeinerung#
SAM 2 kann Objekte segmentieren, denen das Modell noch nie zuvor begegnet ist, und zeigt damit eine starke Zero-Shot-Generalisierung. Das ist besonders nützlich in vielfältigen oder sich wandelnden visuellen Bereichen, in denen vordefinierte Kategorien möglicherweise nicht alle vorkommenden Objekte abdecken.
Interaktive Verfeinerung#
Du kannst die Segmentierungsergebnisse iterativ verfeinern, indem du weitere Eingabeaufforderungen hinzufügst. So erhältst du präzise Kontrolle über die Ausgabe. Diese Interaktivität ist wichtig, um Ergebnisse in Anwendungen wie der Videoannotation oder der medizinischen Bildgebung zu verfeinern.
Fortgeschrittener Umgang mit visuellen Herausforderungen#
SAM 2 umfasst Mechanismen zum Umgang mit häufigen Herausforderungen bei der Videosegmentierung, etwa Verdeckung und Wiederauftauchen von Objekten. Ein Speichermechanismus verfolgt Objekte über mehrere Einzelbilder hinweg und gewährleistet die Kontinuität, auch wenn Objekte vorübergehend verdeckt werden oder die Szene verlassen und wieder betreten.
Weitere Einblicke in die Architektur und die Funktionen von SAM 2 findest du im Forschungspapier zu SAM 2.
Leistung und technische Details#
Meta zufolge übertrifft SAM 2 frühere Modelle bei mehreren Kennzahlen:
| Kennzahl | SAM 2 | Bisheriger SOTA |
|---|---|---|
| Interaktive Videosegmentierung | Am besten | - |
| Erforderliche menschliche Interaktionen | 3-mal weniger | Ausgangswert |
| Genauigkeit der Bildsegmentierung | Verbessert | SAM |
| Inferenzgeschwindigkeit | 6-mal schneller | SAM |
Modellarchitektur#
Kernkomponenten#
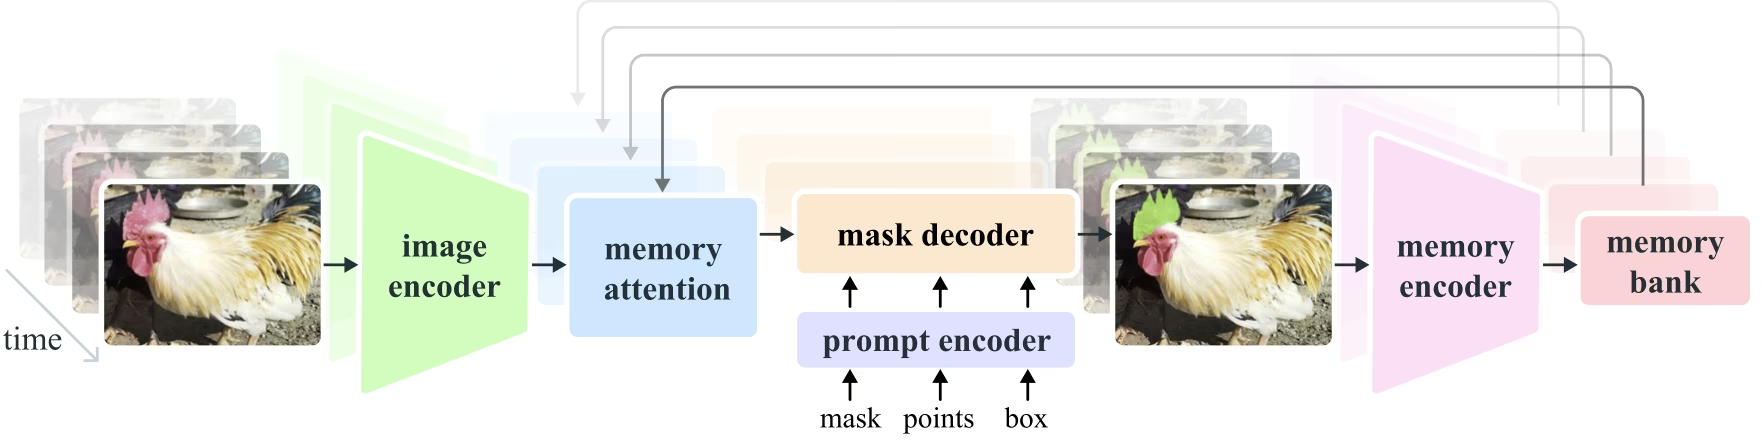
- Bild- und Videoencoder: Nutzt eine auf Transformern basierende Architektur, um übergeordnete Merkmale aus Bildern und Videoframes zu extrahieren. Diese Komponente ist dafür zuständig, den visuellen Inhalt zu jedem Zeitpunkt zu erfassen.
- Prompt-Encoder: Verarbeitet vom Nutzer bereitgestellte Prompts (Punkte, Begrenzungsrahmen, Masken), um die Segmentierungsaufgabe zu steuern. So kann SAM 2 auf Nutzereingaben reagieren und gezielt bestimmte Objekte innerhalb einer Szene auswählen.
- Speichermechanismus: Umfasst einen Speicherencoder, eine Speicherbank und ein Speicheraufmerksamkeitsmodul. Zusammen speichern und nutzen diese Komponenten Informationen aus früheren Einzelbildern und ermöglichen dem Modell so eine konsistente Objektverfolgung über einen längeren Zeitraum.
- Maskendecoder: Erstellt die endgültigen Segmentierungsmasken anhand der codierten Bildmerkmale und Prompts. Bei Videos nutzt er außerdem den Speicherkontext, um eine genaue Verfolgung über mehrere Frames hinweg zu gewährleisten.
Speichermechanismus und Umgang mit Verdeckungen#
Der Speichermechanismus ermöglicht SAM 2, zeitliche Abhängigkeiten und Verdeckungen in Videodaten zu verarbeiten. Während sich Objekte bewegen und miteinander interagieren, speichert SAM 2 ihre Merkmale in einer Speicherbank. Wird ein Objekt verdeckt, kann das Modell auf diese gespeicherten Informationen zurückgreifen, um seine Position und sein Aussehen beim Wiederauftauchen vorherzusagen. Der Verdeckungskopf behandelt gezielt Situationen, in denen Objekte nicht sichtbar sind, und sagt die Wahrscheinlichkeit voraus, dass ein Objekt verdeckt ist.
Auflösung von Mehrdeutigkeiten bei mehreren Masken#
In mehrdeutigen Situationen, etwa bei sich überlappenden Objekten, kann SAM 2 mehrere Maskenvorhersagen erzeugen. So lassen sich komplexe Szenen darstellen, in denen eine einzelne Maske das gewünschte Objekt möglicherweise nicht erfasst.
SA-V-Datensatz#
Der für das Training von SAM 2 entwickelte SA-V-Datensatz gehört zu den größten und vielfältigsten verfügbaren Datensätzen für die Videosegmentierung. Er umfasst:
- Über 51.000 Videos: Aufgenommen in 47 Ländern und mit einer großen Bandbreite realer Szenarien.
- Über 600.000 Maskenannotationen: Detaillierte räumlich-zeitliche Maskenannotationen, sogenannte „Masklets“, die ganze Objekte und Teile davon abdecken.
- Umfang des Datensatzes: Er umfasst 4,5-mal mehr Videos und 53-mal mehr Annotationen als die bisher größten Datensätze für die Videosegmentierung.
Benchmarks#
Videosegmentierung von Objekten#
SAM 2 erzielt folgende Ergebnisse bei wichtigen Benchmarks zur Videosegmentierung:
| Datensatz | J&F | J | F |
|---|---|---|---|
| DAVIS 2017 | 82.5 | 79.8 | 85.2 |
| YouTube-VOS | 81.2 | 78.9 | 83.5 |
Interaktive Segmentierung#
Bei Aufgaben zur interaktiven Segmentierung erzielt SAM 2 folgende Ergebnisse:
| Datensatz | NoC@90 | AUC |
|---|---|---|
| DAVIS Interactive | 1.54 | 0.872 |
Installation#
SAM 2 ist im Paket ultralytics enthalten. Installiere das Paket mit dem folgenden Befehl. Die SAM-2-Gewichte werden bei der ersten Verwendung automatisch heruntergeladen.
pip install ultralyticsSo verwendest du SAM 2: Vielseitigkeit bei der Bild- und Videosegmentierung#
Die folgende Tabelle enthält Details zu den verfügbaren SAM-2-Modellen, ihren vortrainierten Gewichten, den unterstützten Aufgaben und ihrer Kompatibilität mit verschiedenen Betriebsmodi wie Training, Validierung, Inferenz und Export.
| Modelltyp | Vortrainierte Gewichte | Unterstützte Aufgaben | Training | Validierung | Inferenz | Exportieren |
|---|---|---|---|---|---|---|
| SAM 2 tiny | sam2_t.pt | Instanzsegmentierung | ❌ | ❌ | ✅ | ❌ |
| SAM 2 small | sam2_s.pt | Instanzsegmentierung | ❌ | ❌ | ✅ | ❌ |
| SAM 2 base | sam2_b.pt | Instanzsegmentierung | ❌ | ❌ | ✅ | ❌ |
| SAM 2 large | sam2_l.pt | Instanzsegmentierung | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 tiny | sam2.1_t.pt | Instanzsegmentierung | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 small | sam2.1_s.pt | Instanzsegmentierung | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 base | sam2.1_b.pt | Instanzsegmentierung | ❌ | ❌ | ✅ | ❌ |
| SAM 2.1 large | sam2.1_l.pt | Instanzsegmentierung | ❌ | ❌ | ✅ | ❌ |
Beispiele für SAM-2-Vorhersagen#
SAM 2 eignet sich für ein breites Aufgabenspektrum, darunter Videobearbeitung in Echtzeit, medizinische Bildgebung und autonome Systeme. Da das Modell sowohl statische als auch dynamische visuelle Daten segmentieren kann, ist es ein vielseitiges Werkzeug für Forschende und Entwickler.
Segmentierung mit Prompts#
Verwende Prompts, um bestimmte Objekte in Bildern oder Videos zu segmentieren.
from ultralytics import SAM

# Ein Modell laden
model = SAM("sam2.1_b.pt")

# Modellinformationen anzeigen (optional)
model.info()

# Inferenz mit Begrenzungsrahmen-Prompt ausführen
results = model("path/to/image.jpg", bboxes=[100, 100, 200, 200])

# Inferenz mit einem einzelnen Punkt ausführen
results = model(points=[900, 370], labels=[1])

# Inferenz mit mehreren Punkten ausführen
results = model(points=[[400, 370], [900, 370]], labels=[1, 1])

# Inferenz mit mehreren Punkt-Prompts pro Objekt ausführen
results = model(points=[[[400, 370], [900, 370]]], labels=[[1, 1]])

# Inferenz mit einem Negativpunkt-Prompt ausführen
results = model(points=[[[400, 370], [900, 370]]], labels=[[1, 0]])
Alles segmentieren#
Segmentiere den gesamten Bild- oder Videoinhalt ohne bestimmte Prompts.
from ultralytics import SAM

# Ein Modell laden
model = SAM("sam2.1_b.pt")

# Modellinformationen anzeigen (optional)
model.info()

# Inferenz ausführen
model("path/to/video.mp4")- Dieses Beispiel zeigt, wie SAM 2 den gesamten Inhalt eines Bildes oder Videos segmentieren kann, wenn keine Prompts (Begrenzungsrahmen/Punkte/Masken) angegeben werden.
Video segmentieren und Objekte verfolgen#
Segmentiere den gesamten Videoinhalt mit bestimmten Prompts und verfolge Objekte.
from ultralytics.models.sam import SAM2VideoPredictor

# Create SAM2VideoPredictor
overrides = {"conf": 0.25, "task": "segment", "mode": "predict", "imgsz": 1024, "model": "sam2_b.pt"}
predictor = SAM2VideoPredictor(overrides=overrides)

# Inferenz mit einem einzelnen Punkt ausführen
results = predictor(source="test.mp4", points=[920, 470], labels=[1])

# Inferenz mit mehreren Punkten ausführen
results = predictor(source="test.mp4", points=[[920, 470], [909, 138]], labels=[1, 1])

# Inferenz mit mehreren Punkt-Prompts pro Objekt ausführen
results = predictor(source="test.mp4", points=[[[920, 470], [909, 138]]], labels=[[1, 1]])

# Inferenz mit einem Negativpunkt-Prompt ausführen
results = predictor(source="test.mp4", points=[[[920, 470], [909, 138]]], labels=[[1, 0]])
Dynamische interaktive Segmentierung und Verfolgung#
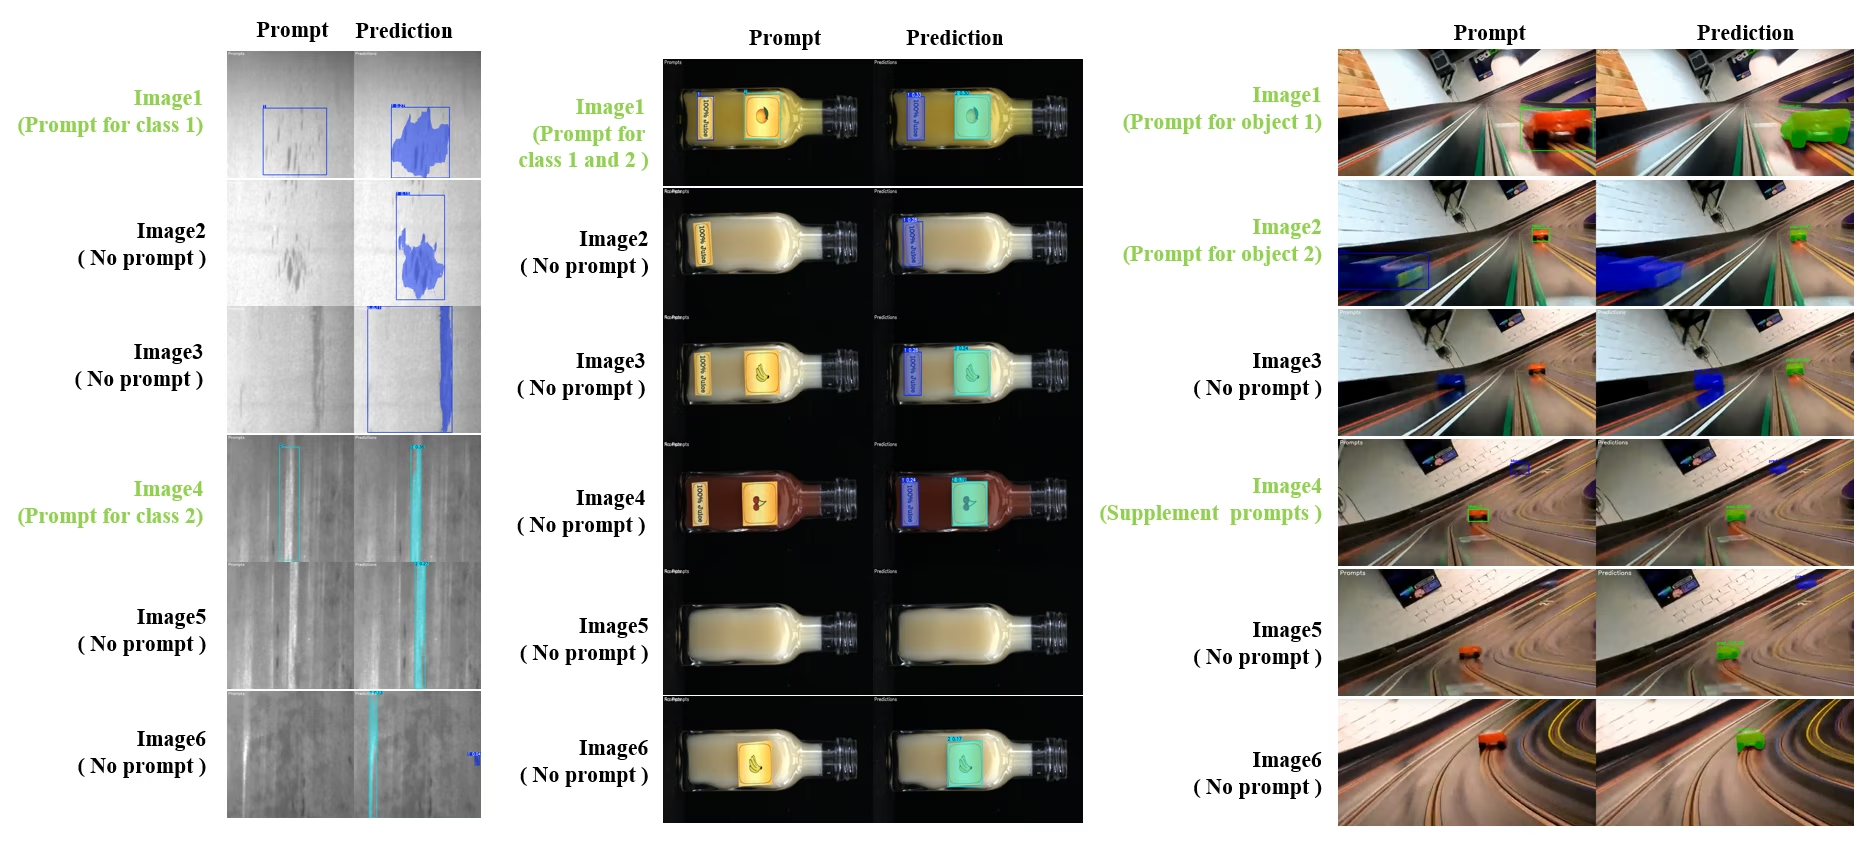
SAM2DynamicInteractivePredictor ist eine erweiterte SAM-2-Version, die ohne Training auskommt und dynamische Interaktion mit mehreren Einzelbildern sowie kontinuierliches Lernen ermöglicht. Dieser Prädiktor unterstützt Aktualisierungen der Eingabeaufforderungen in Echtzeit und eine Speicherverwaltung, die die Verfolgungsleistung über eine Bildsequenz hinweg verbessert. Im Gegensatz zum ursprünglichen SAM 2 gestaltet SAM2DynamicInteractivePredictor den Inferenzablauf neu, um vortrainierte SAM-2-Modelle optimal zu nutzen, ohne zusätzliches Training zu erfordern.
Wichtige Funktionen#
Das Modell bietet drei Verbesserungen:
- Dynamische Interaktion: Füge während der Videoverarbeitung jederzeit in späteren Einzelbildern Eingabeaufforderungen für neue, noch nicht verfolgte Instanzen hinzu.
- Kontinuierliches Lernen: Füge bestehende Instanzen mit neuen Prompts hinzu, um die Modellleistung mit der Zeit zu verbessern.
- Unabhängige Unterstützung mehrerer Bilder: Verarbeite mehrere unabhängige Bilder, die nicht unbedingt aus einer Videosequenz stammen, mit gemeinsamem Speicher und bildübergreifender Objektverfolgung.
Kernfunktionen#
- Flexible Prompts: Unterstützt Begrenzungsrahmen, Punkte und Masken als Prompts.
- Verwaltung der Speicherbank: Verwaltet eine dynamische Speicherbank, in der Objektzustände über mehrere Frames hinweg gespeichert werden.
- Verfolgung mehrerer Objekte: Unterstützt die gleichzeitige Verfolgung mehrerer Objekte mit individuellen Objekt-IDs.
- Aktualisierungen in Echtzeit: Ermöglicht das Hinzufügen neuer Prompts während der Inferenz, ohne vorherige Frames erneut zu verarbeiten.
- Unabhängige Bildverarbeitung: Verarbeite einzelne Bilder mit gemeinsamem Speicherkontext, um die Konsistenz von Objekten über mehrere Bilder hinweg sicherzustellen.
from ultralytics.models.sam import SAM2DynamicInteractivePredictor

# Create SAM2DynamicInteractivePredictor
overrides = {"conf": 0.01, "task": "segment", "mode": "predict", "imgsz": 1024, "model": "sam2_t.pt", "save": False}
predictor = SAM2DynamicInteractivePredictor(overrides=overrides, max_obj_num=10)

# Kategorie mithilfe eines Begrenzungsrahmen-Prompts definieren
predictor(source="image1.jpg", bboxes=[[100, 100, 200, 200]], obj_ids=[0], update_memory=True)

# Dieses bestimmte Objekt in einem neuen Bild erkennen
results = predictor(source="image2.jpg")

# Neue Kategorie mit einer neuen Objekt-ID hinzufügen
results = predictor(
    source="image4.jpg",
    bboxes=[[300, 300, 400, 400]],  # Neues Objekt
    obj_ids=[1],  # Neue Objekt-ID
    update_memory=True,  # Zum Speicher hinzufügen
)
# Inferenz ausführen
results = predictor(source="image5.jpg")

# Verfeinerungs-Prompts derselben Kategorie hinzufügen, um die Leistung zu steigern
# Das ist hilfreich, wenn sich das Aussehen eines Objekts deutlich verändert
results = predictor(
    source="image6.jpg",
    points=[[150, 150]],  # Verfeinerungspunkt
    labels=[1],  # Positiver Punkt
    obj_ids=[1],  # Dieselbe Objekt-ID
    update_memory=True,  # Speicher mit neuen Informationen aktualisieren
)
# Inferenz auf einem neuen Bild ausführen
results = predictor(source="image7.jpg")SAM2DynamicInteractivePredictor wurde für die Verwendung mit SAM 2-Modellen entwickelt und unterstützt das Hinzufügen und Verfeinern von Kategorien mit allen Prompts für Boxen, Punkte und Masken, die SAM 2 nativ unterstützt. Das ist besonders nützlich in Szenarien, in denen Objekte im Laufe der Zeit erscheinen oder sich verändern, etwa bei der Videoannotation oder interaktiven Bearbeitungsaufgaben.
Argumente#
| Name | Standardwert | Datentyp | Beschreibung |
|---|---|---|---|
max_obj_num | 3 | int | Die voreingestellte Höchstzahl an Kategorien |
update_memory | False | bool | Gibt an, ob der Speicher mit neuen Prompts aktualisiert werden soll |
obj_ids | None | List[int] | Liste der Objekt-IDs, die den Prompts entsprechen |
Anwendungsfälle#
SAM2DynamicInteractivePredictor eignet sich ideal für:
- Videoannotations-Workflows, in denen während der Sequenz neue Objekte erscheinen
- Interaktive Videobearbeitung, bei der Objekte in Echtzeit hinzugefügt und verfeinert werden müssen
- Überwachungsanwendungen mit Bedarf an dynamischer Objektverfolgung
- Medizinische Bildgebung zur Verfolgung anatomischer Strukturen über Zeitreihen hinweg
- Autonome Systeme, die adaptive Objekterkennung und -verfolgung erfordern
- Datensätze mit mehreren Bildern für eine konsistente Objektsegmentierung über unabhängige Bilder hinweg
- Analyse von Bildsammlungen, bei der Objekte über verschiedene Szenen hinweg verfolgt werden müssen
- Domänenübergreifende Segmentierung, bei der der Speicher aus unterschiedlichen Bildkontexten genutzt wird
- Teilautomatische Annotation für die effiziente Erstellung von Datensätzen mit minimalem manuellem Aufwand
Vergleich von SAM und YOLO#
Hier vergleichen wir Metas SAM-2-Modelle, einschließlich der kleinsten Variante SAM2-t, mit den Segmentierungsmodellen von Ultralytics, darunter YOLO26:
| Modell | Größe (MB) | Parameter (M) | Geschwindigkeit (CPU) (ms/Bild) |
|---|---|---|---|
| Meta SAM-b | 375 | 93.7 | 41703 |
| Meta SAM2-b | 162 | 80.8 | 28867 |
| Meta SAM2-t | 78.1 | 38.9 | 23430 |
| MobileSAM | 40.7 | 10.1 | 23802 |
| FastSAM-s mit YOLOv8-Backbone | 23.9 | 11.8 | 58.0 |
| Ultralytics YOLOv8n-seg | 7.1 (11.0-mal kleiner) | 3.4 (11.4-mal weniger) | 24.8 (945-mal schneller) |
| Ultralytics YOLO11n-seg | 6.2 (12.6-mal kleiner) | 2.9 (13.4-mal weniger) | 24.3 (964-mal schneller) |
| Ultralytics YOLO26n-seg | 6.7 (11.7-mal kleiner) | 2.7 (14.4-mal weniger) | 25.2 (930-mal schneller) |
Dieser Vergleich zeigt die erheblichen Unterschiede bei Modellgrößen und Geschwindigkeiten zwischen SAM-Varianten und YOLO-Segmentierungsmodellen. SAM bietet zwar einzigartige Möglichkeiten zur automatischen Segmentierung, doch YOLO-Modelle, insbesondere YOLOv8n-seg, YOLO11n-seg und YOLO26n-seg, sind deutlich kleiner, schneller und recheneffizienter.
Die Geschwindigkeiten von SAM wurden mit PyTorch gemessen, die von YOLO mit ONNX Runtime. Die Tests wurden auf einem Apple M4 Air aus dem Jahr 2025 mit 16 GB RAM und torch==2.10.0, ultralytics==8.4.31 und onnxruntime==1.24.4 durchgeführt. So kannst du diesen Test reproduzieren:
from ultralytics import ASSETS, SAM, YOLO, FastSAM

# SAM2-t, SAM2-b, SAM-b, MobileSAM profilieren
for file in ["sam_b.pt", "sam2_b.pt", "sam2_t.pt", "mobile_sam.pt"]:
    model = SAM(file)
    model.info()
    model(ASSETS)

# FastSAM-s profilieren
model = FastSAM("FastSAM-s.pt")
model.info()
model(ASSETS)

# YOLO-Modelle profilieren (ONNX)
for file_name in ["yolov8n-seg.pt", "yolo11n-seg.pt", "yolo26n-seg.pt"]:
    model = YOLO(file_name)
    model.info()
    onnx_path = model.export(format="onnx", dynamic=True, nms=False)  # NMS-freier YOLO26-Head; für YOLOv8/YOLO11 ohne Funktion
    model = YOLO(onnx_path)
    model(ASSETS)
Automatische Annotation: effiziente Erstellung von Datensätzen#
Bei der automatischen Annotation wird SAM 2 mit einem vortrainierten Erkennungsmodell kombiniert, um Segmentierungsdatensätze schnell und ohne umfangreiche manuelle Beschriftung zu erstellen. Ultralytics Platform bietet außerdem browserbasierte automatische Annotation mit gehosteten Vision-Modellen. Vergleiche deren Erkennungsgenauigkeit, Kosten und Geschwindigkeit auf der VLM-Bestenliste.
So annotierst du mit SAM 2 automatisch#
Ansehen: Automatische Annotation mit Metas Segment Anything 2 über Ultralytics | Datenbeschriftung
Folge diesem Beispiel, um deinen Datensatz mit einem YOLO26x-Detektor und SAM 2 automatisch zu annotieren:
from ultralytics.data.annotator import auto_annotate

auto_annotate(data="path/to/images", det_model="yolo26x.pt", sam_model="sam2_b.pt")| Argument | Typ | Standard | Beschreibung |
|---|---|---|---|
data | str | erforderlich | Pfad zum Verzeichnis mit den Zielbildern für die Annotation oder Segmentierung. |
det_model | str | 'yolo26x.pt' | Pfad zum YOLO-Erkennungsmodell für die anfängliche Objekterkennung. |
sam_model | str | 'sam_b.pt' | Pfad zum SAM-Modell für die Segmentierung (unterstützt SAM-, SAM 2-, MobileSAM- und SAM 3-Gewichte). |
device | str | '' | Rechengerät (z. B. 'cuda:0', 'cpu' oder '' zur automatischen Geräteerkennung). |
conf | float | 0.25 | Konfidenzschwelle der YOLO-Erkennung, um unsichere Erkennungen herauszufiltern. |
iou | float | 0.5 | IoU-Schwelle für Non-Maximum Suppression, um überlappende Boxen herauszufiltern. |
imgsz | int | 640 | Eingabegröße für die Größenanpassung von Bildern (bei Bedarf auf das nächste Vielfache von 32 aufgerundet). |
max_det | int | 300 | Höchstzahl der Erkennungen pro Bild zur effizienten Speichernutzung. |
classes | list[int] | None | Liste der zu erkennenden Klassenindizes (z. B. [0, 1] für Person und Fahrrad). |
output_dir | str | None | Speicherverzeichnis für Annotationen (standardmäßig ein Verzeichnis neben <data>_auto_annotate_labels). |
Mit dieser Funktion wandelst du einen Ordner mit nicht annotierten Bildern mit minimalem manuellen Aufwand in einen Segmentierungsdatensatz um.
Einschränkungen#
Trotz seiner Stärken hat SAM 2 gewisse Einschränkungen:
- Stabilität der Verfolgung: Bei längeren Sequenzen oder erheblichen Änderungen des Blickwinkels kann SAM 2 die Spur von Objekten verlieren.
- Verwechslung von Objekten: Das Modell kann ähnlich aussehende Objekte manchmal verwechseln, insbesondere in überfüllten Szenen.
- Effizienz bei mehreren Objekten: Die Segmentierung wird weniger effizient, wenn mehrere Objekte gleichzeitig verarbeitet werden, da die Kommunikation zwischen Objekten fehlt.
- Detailgenauigkeit Genauigkeit: Feine Details können übersehen werden, besonders bei sich schnell bewegenden Objekten. Zusätzliche Prompts können dieses Problem teilweise beheben, aber eine zeitliche Glätte ist nicht garantiert.
Zitate und Danksagungen#
Wenn du SAM 2 in deiner Forschung oder Entwicklungsarbeit verwendest, zitiere es bitte mit folgendem Verweis:
@article{ravi2024sam2,
  title={SAM 2: Segment Anything in Images and Videos},
  author={Ravi, Nikhila and Gabeur, Valentin and Hu, Yuan-Ting and Hu, Ronghang and Ryali, Chaitanya and Ma, Tengyu and Khedr, Haitham and R{\"a}dle, Roman and Rolland, Chloe and Gustafson, Laura and Mintun, Eric and Pan, Junting and Alwala, Kalyan Vasudev and Carion, Nicolas and Wu, Chao-Yuan and Girshick, Ross and Doll{\'a}r, Piotr and Feichtenhofer, Christoph},
  journal={arXiv preprint},
  year={2024}
}
Wir danken Meta AI dafür, dass das Modell und der Datensatz der KI-Community zur Verfügung gestellt wurden.
Häufig gestellte Fragen#
SAM 2, der Nachfolger von Metas Segment Anything Model (SAM), ist ein einheitliches, promptbasiertes Modell zur Segmentierung von Objekten in Bildern und Videos. SAM 2 bietet gegenüber dem ursprünglichen SAM mehrere Verbesserungen, darunter:
- Einheitliche Modellarchitektur: Vereint die Fähigkeiten zur Bild- und Videosegmentierung in einem einzigen Modell.
- Echtzeitleistung: Verarbeitet etwa 44 Bilder pro Sekunde und eignet sich damit für Anwendungen, die sofortiges Feedback erfordern.
- Zero-Shot-Generalisierung: Segmentiert Objekte, denen das Modell zuvor noch nicht begegnet ist – nützlich in vielfältigen visuellen Domänen.
- Interaktive Verfeinerung: Ermöglicht es Nutzern, Segmentierungsergebnisse iterativ durch zusätzliche Prompts zu verfeinern.
- Fortgeschrittener Umgang mit visuellen Herausforderungen: Bewältigt gängige Herausforderungen der Videosegmentierung, etwa das Verdecken und Wiedererscheinen von Objekten.
Weitere Einzelheiten zur Architektur und den Fähigkeiten von SAM 2 findest du in der SAM 2-Forschungsarbeit.
SAM 2 unterstützt die Echtzeit-Videosegmentierung über seine promptbasierte Schnittstelle und schnelle Inferenz. Hier ein einfaches Beispiel:
Segmentierung mit PromptsVerwende Prompts, um bestimmte Objekte in Bildern oder Videos zu segmentieren.
from ultralytics import SAM

# Ein Modell laden
model = SAM("sam2_b.pt")

# Modellinformationen anzeigen (optional)
model.info()

# Mit einer Begrenzungsbox als Prompt segmentieren
results = model("path/to/image.jpg", bboxes=[100, 100, 200, 200])

# Mit einem Punkt als Prompt segmentieren
results = model("path/to/image.jpg", points=[150, 150], labels=[1])
Eine umfassendere Anleitung zur Verwendung findest du im Abschnitt So verwendest du SAM 2.
SAM 2 wird auf dem SA-V-Datensatz trainiert, einem der größten und vielfältigsten verfügbaren Datensätze für die Videosegmentierung. Der SA-V-Datensatz umfasst:
- Über 51.000 Videos: Aufgenommen in 47 Ländern und mit einer großen Bandbreite realer Szenarien.
- Über 600.000 Maskenannotationen: Detaillierte räumlich-zeitliche Maskenannotationen, sogenannte „Masklets“, die ganze Objekte und Teile davon abdecken.
- Umfang des Datensatzes: Er enthält 4,5-mal mehr Videos und 53-mal mehr Annotationen als die bisher größten Datensätze und bietet damit eine beispiellose Vielfalt und Komplexität.
Mit diesem Datensatz erzielt SAM 2 starke Ergebnisse bei wichtigen Benchmarks zur Videosegmentierung und verbessert seine Generalisierungsfähigkeit ohne zusätzliche Trainingsbeispiele.
SAM 2 enthält einen Speichermechanismus, der zeitliche Abhängigkeiten und Verdeckungen in Videodaten verwaltet. Der Speichermechanismus besteht aus:
- Speicher-Encoder und Speicherbank: Speichern Merkmale aus früheren Bildern.
- Speicher-Aufmerksamkeitsmodul: Nutzt gespeicherte Informationen, um die konsistente Objektverfolgung im Zeitverlauf aufrechtzuerhalten.
- Verdeckungsmodul: Behandelt gezielt Situationen, in denen Objekte nicht sichtbar sind, und sagt die Wahrscheinlichkeit voraus, dass ein Objekt verdeckt ist.
Dieser Mechanismus gewährleistet Kontinuität, selbst wenn Objekte vorübergehend verdeckt werden oder die Szene verlassen und wieder betreten. Weitere Einzelheiten findest du im Abschnitt Speichermechanismus und Umgang mit Verdeckungen.
SAM 2-Modelle wie Metas SAM2-t und SAM2-b bieten leistungsstarke Zero-Shot-Segmentierungsfunktionen, sind jedoch deutlich größer und langsamer als YOLO-Modelle. So ist YOLO26n-seg auf einer CPU etwa 24-mal kleiner und über 1145-mal schneller als SAM2-b. Während SAM 2 bei vielseitigen, promptbasierten und Zero-Shot-Segmentierungsszenarien überzeugt, ist YOLO26 auf Geschwindigkeit, Effizienz und Echtzeitanwendungen mit durchgängiger Inferenz ohne NMS optimiert und daher besser für den Einsatz in Umgebungen mit begrenzten Ressourcen geeignet.


Kommentare150
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
 Glenn JocherUltralytics
Hey everyone! We wanted to give you a quick update: our team is currently busy integrating SAM 2 (Segment Anything Model 2) into the Ultralytics package. This new model is super exciting, with features like real-time performance and the ability to segment objects it’s never seen before.
We're really pumped about what SAM2 can do, but it's still in the works. Thanks for your patience as we get everything set up! We'll keep you posted as we make progress. Stay tuned!
10- Glenn JocherUltralytics
Update: SAM 2 is now fully integrated! Update your package to
ultralytics>=8.2.70withpip install -U ultralyticsand then for example:from ultralytics import ASSETS, SAM # Load a model model = SAM("sam2_s.pt") # Segment with point prompt results = model(ASSETS / "bus.jpg", points=[150, 150], labels=[1], device="cpu")1
avasanjesh
Hello,
Can i use sam2.1 for real time segmentation? i want to specify the object on the first frame of live video webcam then sam2.1 shows the segmentation and continue to track and show the result of segmentation of that object. Is it possible to do this?
1thedatamask
Breaking News: 🚨 SAM 1.0 outperforms SAM 2.0 on low-contrast images like CT Scan and MRI images! Check out this insightful video from Data Mask YouTube channel where they dive deep into the architecture, demos, and limitations of both Meta's segmentation models. Discover when to use SAM 1.0 for superior results on challenging images.
Use case with ultralytics
https://www.youtube.com/watch?v=vMI-TnyNLYU
Please do like and subscribe for exciting video like above .
#SAM #SAM2.0 #MetaAI #ImageSegmentation #AI #MachineLearning #DeepLearning #DataMask #BreakingNews
1- Glenn JocherUltralytics
@thedatamask thank you for sharing the video. For insights on SAM 2's capabilities and its comparison with other models, you can explore our documentation. If you have specific questions about using SAM 2 with Ultralytics, feel free to ask!
ram-from-tvl
Hi Team,
the below is the code I have been using to annotate some items in a folder of several images. I am planning to segment everything first and then try to cherry pick the ones that are to be annotated for a downstream segmentation task. Could you please tailor the code for the same. I am not getting any help from the docs regarding the same. i have tried auto annotate but its not working for my use case. So please help me in this approach
` from ultralytics import SAM
Load a model
model = SAM("sam2.1_b.pt")
Display model information (optional)
model.info()
Run inference
model("/kaggle/working/10_random_frames") `
Thankyou
Regards Ram
 Onuralp SezerUltralytics
Hi Team,
the below is the code I have been using to annotate some items in a folder of several images. I am planning to segment everything first and then try to cherry pick the ones that are to be annotated for a downstream segmentation task. Could you please tailor the code for the same. I am not getting any help from the docs regarding the same. i have tried auto annotate but its not working for my use case. So please help me in this approach
` from ultralytics import SAM
Load a model
model = SAM("sam2.1_b.pt")
Display model information (optional)
model.info()
Run inference
model("/kaggle/working/10_random_frames") `
Thankyou
Regards Ram
You may want check out here https://docs.ultralytics.com/reference/data/annotator/#ultralytics.data.annotator.auto_annotate
zhaowangalready
Hello, dear doctor, I encountered some problems in the automatic annotation segmentation. I used the successfully annotated data for verification and found that the data of each species has a serial number border. How can I remove the serial number border? I hope to hear from you.
- Glenn JocherUltralytics
auto_annotate()生成的是标准 YOLO-seg 标签:每一行开头的“数字”是类别class_id(必需字段,不能删),如果你看到的是验证/预测保存出来的图片上带编号的边框/轮廓,那只是可视化绘图,不会写进数据本身;你可以按 SAM 2 文档 继续用同一套数据训练/验证,同时关掉这些 plot:yolo val model=yolo26n-seg.pt data=path/to/data.yaml plots=False yolo predict model=sam2.1_b.pt source=path/to/images show_labels=False show_boxes=False方便的话把“带序号边框”的截图 + 对应的一行标签
.txt内容贴在这个 discussion 里,我帮你确认你看到的到底是class_id还是绘图叠加效果。
cyberpunk-edgerunner
I have to question related to SAM2 :
- How to use text-prompt for segmentation using SAM ?
- Along with the bounding box coordinates, is there a way to tell SAM what not to segment ?
I have two questions regarding segmentation with SAM2 and YOLOv11:
1. Visualization and Editing with SAM2 I've used the
auto_annotatefeature and I'm wondering:- How can I visualize the segmentations produced by the SAM2 model?
- Is there a way to manually inspect or edit these segmentations?
I'm aiming to verify the outputs before proceeding further.
2. Saving and Cropping Segmentations I'm using the following code to detect and segment images with YOLOv11 and SAM2:
from ultralytics import YOLO
from ultralytics import SAM

model = YOLO(r"runs\detect\train2\weights\best.pt")
sam_model = SAM("sam2_b.pt")

results = model("more_test_images", save=True)

for result in results:
    class_ids = result.boxes.cls.int().tolist()

    if len(class_ids):
        boxes = result.boxes.xyxy
        sam_results = sam_model(result.orig_img, bboxes=boxes, verbose=False, save=True)
The detection results from YOLOv11 are saved correctly, but only one segmented result is saved by SAM2.
Questions:
- How can I ensure all SAM2 segmentations are saved for each image?
- How can I crop and save only the segmented parts (i.e., masked regions) from each image? I need these as separate images, containing only the segmented pixels.
Any help or pointers would be greatly appreciated!
fangyuZ1025
Hello, dear doctor, I encountered some problems in the automatic annotation segmentation. The automatic annotation automatically marked various marks on my output, but in fact, this is not the correct mark of my picture, and even some pictures cannot recognise the objects in it. How can I make it change the label uniform? For example, all of them are labelled as "fruit", "vehicle" and so on? I hope to get your reply.
from ultralytics.data.annotator import auto_annotate
auto_annotate(data=r"D:\graduation.thesis\mydata\mt_label\images", det_model="yolov8n.pt", sam_model="sam2_b.pt")
image 19/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112848.jpg: 640x640 (no detections), 33.4ms image 20/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112858.jpg: 640x640 1 orange, 31.9ms image 21/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112907.jpg: 640x640 1 apple, 35.3ms image 22/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112916.jpg: 640x640 (no detections), 34.0ms image 23/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112938.jpg: 640x640 (no detections), 35.3ms image 24/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_112947.jpg: 640x640 1 donut, 32.1ms image 25/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113004.jpg: 640x640 (no detections), 28.6ms image 26/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113014.jpg: 640x640 1 donut, 33.9ms image 27/461 D:\graduation.thesis\mydata\mt_label\images\IMG_20241003_113028.jpg: 640x640 1 apple, 1 donut, 35.8ms
- Glenn JocherUltralytics(bearbeitet)
@fangyuZ1025 to improve label consistency in auto-annotation, you'll need to train a custom detection model with your specific classes ("fruit", "vehicle") first. The auto_annotate function relies on your detection model's class definitions - it doesn't rename labels but uses whatever classes your det_model was trained on. For immediate improvement, try a newer detection model such as YOLO26 (for example
det_model="yolo26n.pt"), which is more accurate than YOLOv8.
Fatima-khanjar
Hello, I am using SAM2 with my fine-tuned YOLOv11 on my custom dataset to perform auto-annotation for an object detection task. However, the annotations in the .txt file are not in the YOLO format (class_label x_center y_center width height).
Could you clarify the format of the labels generated when using both SAM2 and YOLOv11 for auto-annotation?
- Glenn JocherUltralytics
@Fatima-khanjar the auto-annotation function generates segmentation masks in YOLO segmentation format (polygon points normalized 0-1), not bounding boxes. For object detection tasks, you'll need to convert these masks to bounding boxes using
masks.xyfrom Results objects. We recommend reviewing the Auto-Annotation with SAM2 documentation for implementation details and conversion examples.1
danieltudosiu(bearbeitet)
How does one use SAM2 with a numpy input? I saw how to do it with SAM but SAM2 does not have a preprocess method like SAM.
- Glenn JocherUltralytics(bearbeitet)
@danieltudosiu you can pass numpy arrays directly as the source to
SAM. Here's a minimal example:import numpy as np from ultralytics import SAM model = SAM("sam2.1_b.pt") img = np.random.randint(0, 255, (640, 640, 3), dtype=np.uint8) # Your numpy array results = model(img, points=[100, 100], labels=[1])For more details, see the SAM 2 documentation.
But what about the Image one? Or just use the Video one for Images as well?
- Glenn JocherUltralytics(bearbeitet)
You can pass numpy arrays or file paths directly to
SAM("sam2.1_b.pt"), for examplemodel(img_array, points=[100, 100], labels=[1]).SAM2VideoPredictoris only needed for video. For image-specific examples, see the SAM 2 documentation.