YOLOv10: Echtzeit-Objekterkennung von Anfang bis Ende
YOLOv10, veröffentlicht im Mai 2024 und basierend auf dem Python-Paket Ultralytics von Forschern der Tsinghua-Universität, führt einen neuen Ansatz für die Objekterkennung in Echtzeit ein. Er behebt sowohl Mängel bei der Nachverarbeitung als auch bei der Modellarchitektur früherer YOLO-Versionen. Durch den Verzicht auf Nicht-Maximum-Unterdrückung (NMS) und die Optimierung verschiedener Modellkomponenten erzielte YOLOv10 zum Zeitpunkt seiner Veröffentlichung eine starke Leistung bei deutlich geringerem Rechenaufwand. Sein NMS-freies End-to-End-Design ebnete den Weg für einen Ansatz, der mit YOLO26 weiterentwickelt wurde.
Ansehen: So trainierst du YOLOv10 mit dem SKU-110k-Datensatz über Ultralytics | Einzelhandelsdatensatz
Übersicht#
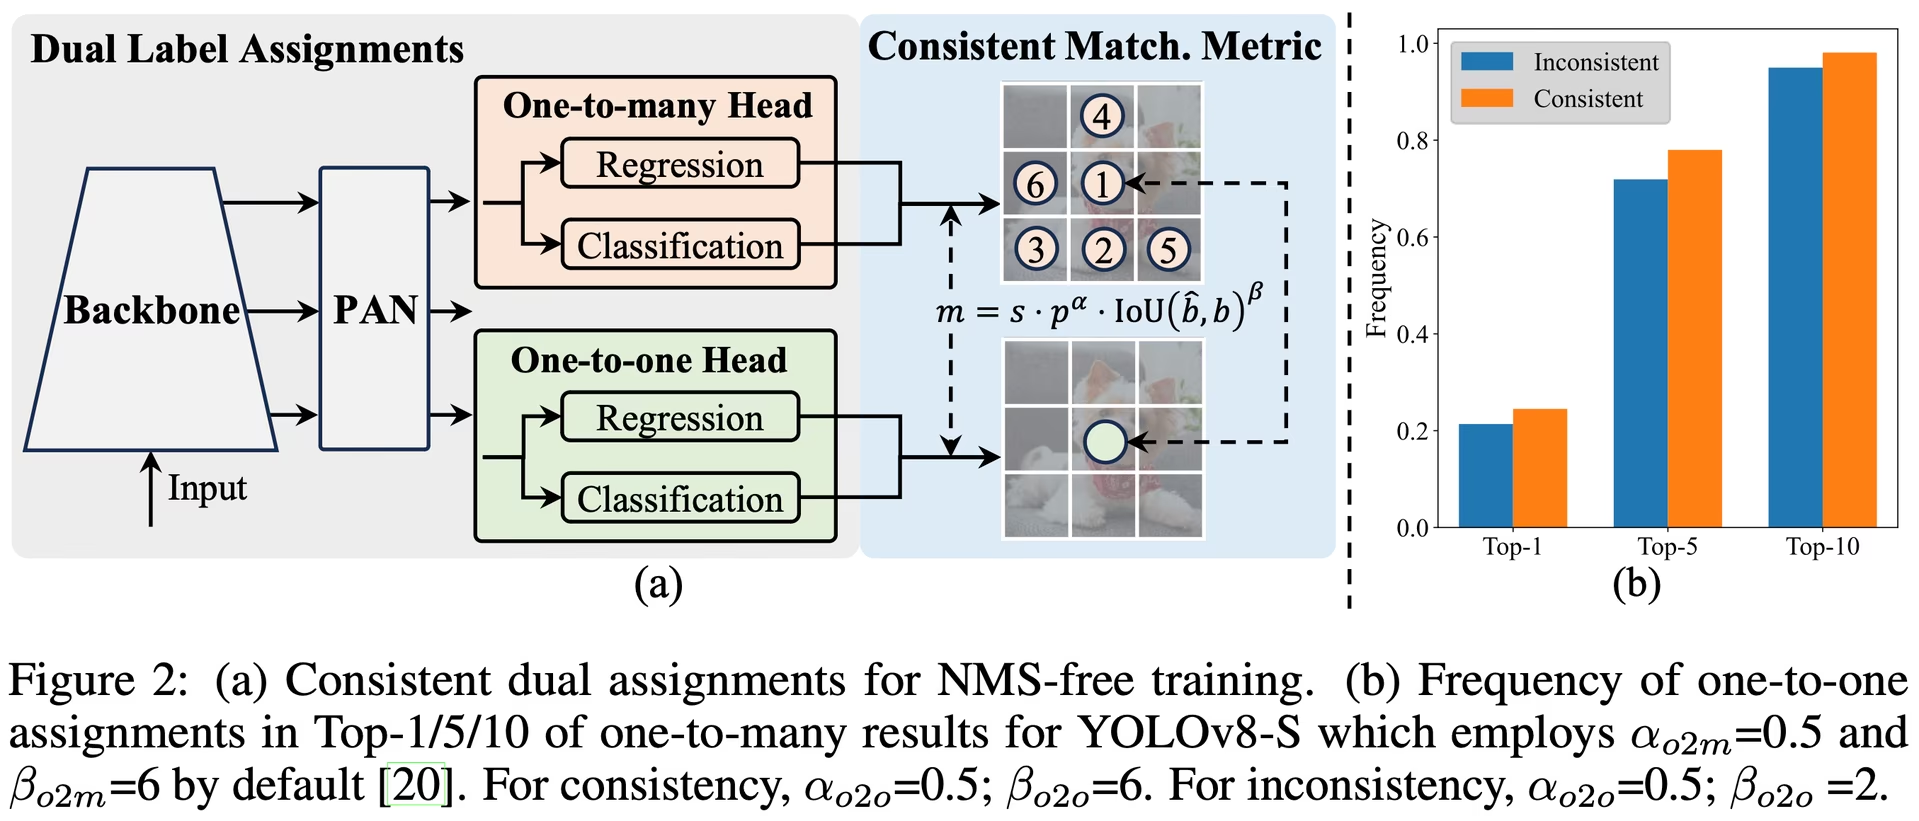
Bei der Objekterkennung in Echtzeit geht es darum, Objektklassen und -positionen in Bildern mit geringer Latenz präzise vorherzusagen. Die YOLO-Modellreihe ist dank ihres ausgewogenen Verhältnisses von Leistung und Effizienz ein Vorreiter auf diesem Gebiet. Die Abhängigkeit von NMS und ineffiziente Architekturen haben jedoch die optimale Leistung beeinträchtigt. YOLOv10 begegnet diesen Problemen mit konsistenten dualen Zuordnungen für das Training ohne NMS und einer ganzheitlichen, auf Effizienz und Genauigkeit ausgerichteten Modellgestaltung.
Architektur#
Die Architektur von YOLOv10 baut auf den Stärken früherer YOLO-Modelle auf und führt zugleich mehrere wichtige Neuerungen ein. Die Modellarchitektur besteht aus folgenden Komponenten:
- Backbone: Das Backbone von YOLOv10 ist für die Merkmalsextraktion zuständig und verwendet eine verbesserte Version von CSPNet (Cross-Stage-Partial-Netzwerk), um den Gradientenfluss zu verbessern und rechnerische Redundanzen zu verringern.
- Neck: Der Neck fasst Merkmale aus verschiedenen Skalen zusammen und leitet sie an den Head weiter. Er umfasst PAN-Schichten (Path-Aggregation-Netzwerk) für eine effektive Fusion von Merkmalen aus mehreren Skalen.
- One-to-Many-Head: Erzeugt während des Trainings mehrere Vorhersagen pro Objekt, um reichhaltige Lernsignale bereitzustellen und die Lernpräzision zu verbessern.
- One-to-One-Kopf: Erzeugt während der Inferenz für jedes Objekt genau eine beste Vorhersage. Dadurch entfällt NMS, was die Latenz verringert und die Effizienz verbessert.
Wichtige Funktionen#
- NMS-freies Training: Verwendet konsistente doppelte Zuweisungen, um NMS überflüssig zu machen und die Inferenzlatenz zu verringern.
- Ganzheitliches Modelldesign: Umfassende Optimierung verschiedener Komponenten im Hinblick auf Effizienz und Genauigkeit, darunter leichte Klassifizierungsköpfe, räumlich-kanalweise entkoppeltes Downsampling und ein ranggesteuertes Blockdesign.
- Erweiterte Modellfunktionen: Umfasst großkernelige Faltungen und partielle Self-Attention-Module, um die Leistung ohne erheblichen Rechenaufwand zu verbessern.
Modellvarianten#
YOLOv10 ist in verschiedenen Modellgrößen erhältlich, um unterschiedlichen Anwendungsanforderungen gerecht zu werden:
- YOLOv10n: Nano-Version für Umgebungen mit äußerst begrenzten Ressourcen.
- YOLOv10s: Small-Version als ausgewogene Kombination aus Geschwindigkeit und Genauigkeit.
- YOLOv10m: Medium-Version für den allgemeinen Einsatz.
- YOLOv10b: Ausgewogene Version mit größerer Breite für höhere Genauigkeit.
- YOLOv10l: Large-Version für höhere Genauigkeit bei entsprechend höherem Rechenaufwand.
- YOLOv10x: Extra-Large-Version für maximale Genauigkeit und Leistung.
Leistung#
Bei seiner Veröffentlichung übertraf YOLOv10 frühere YOLO-Versionen und andere hochmoderne Modelle hinsichtlich Genauigkeit und Effizienz. So ist YOLOv10s 1,8-mal schneller als RT-DETR-R18 und erzielt eine ähnliche AP auf dem COCO-Datensatz. YOLOv10b hat bei gleicher Leistung eine um 46 % geringere Latenz und 25 % weniger Parameter als YOLOv9-C.
Die Latenz wurde mit TensorRT FP16 auf einer T4 GPU gemessen.
| Modell | Eingabegröße | APval50-95 | FLOPs (G) | Latenz (ms) |
|---|---|---|---|---|
| [YOLOv10n][1] | 640 | 38.5 | 6.7 | 1.84 |
| [YOLOv10s][2] | 640 | 46.3 | 21.6 | 2.49 |
| [YOLOv10m][3] | 640 | 51.1 | 59.1 | 4.74 |
| [YOLOv10b][4] | 640 | 52.5 | 92.0 | 5.74 |
| [YOLOv10l][5] | 640 | 53.2 | 120.3 | 7.28 |
| [YOLOv10x][6] | 640 | 54.4 | 160.4 | 10.70 |
Methodik#
Konsistente doppelte Zuweisungen für NMS-freies Training#
YOLOv10 verwendet duale Labelzuweisungen und kombiniert beim Training Eins-zu-viele- und Eins-zu-eins-Strategien, um eine umfassende Überwachung und eine effiziente End-to-End-Bereitstellung zu gewährleisten. Bei Vorhersage und Validierung mit Ultralytics wird standardmäßig der Eins-zu-viele-Kopf mit NMS verwendet; setze nms=False, um den NMS-freien Kopf auszuwählen. Die konsistente Zuordnungsmetrik gleicht die Überwachung beider Strategien aufeinander ab und verbessert so die Qualität der Vorhersagen während der Inferenz.
Ganzheitliche, auf Effizienz und Genauigkeit ausgerichtete Modellgestaltung#
Effizienzsteigerungen#
- Leichter Klassifizierungskopf: Verringert den Rechenaufwand des Klassifizierungskopfs durch tiefenweise separierbare Faltungen.
- Entkoppeltes räumliches und kanalbezogenes Downsampling: Entkoppelt die räumliche Verkleinerung und die Kanalmodulation, um Informationsverlust und Rechenaufwand zu minimieren.
- Ranggesteuertes Blockdesign: Passt das Blockdesign an die intrinsische Redundanz der jeweiligen Stufe an, um eine optimale Parameternutzung sicherzustellen.
Genauigkeitssteigerungen#
- Faltung mit großem Kernel: Vergrößert das rezeptive Feld, um die Fähigkeit zur Merkmalsextraktion zu verbessern.
- Partielle Self-Attention (PSA): Verwendet Self-Attention-Module, um das Lernen globaler Repräsentationen mit minimalem Mehraufwand zu verbessern.
Experimente und Ergebnisse#
YOLOv10 wurde anhand von Standardbenchmarks wie COCO bewertet. Bei seiner Veröffentlichung verbesserte jede Variante den Kompromiss zwischen Latenz und Genauigkeit gegenüber früheren YOLO-Versionen und anderen damals aktuellen Detektoren.
Vergleiche#
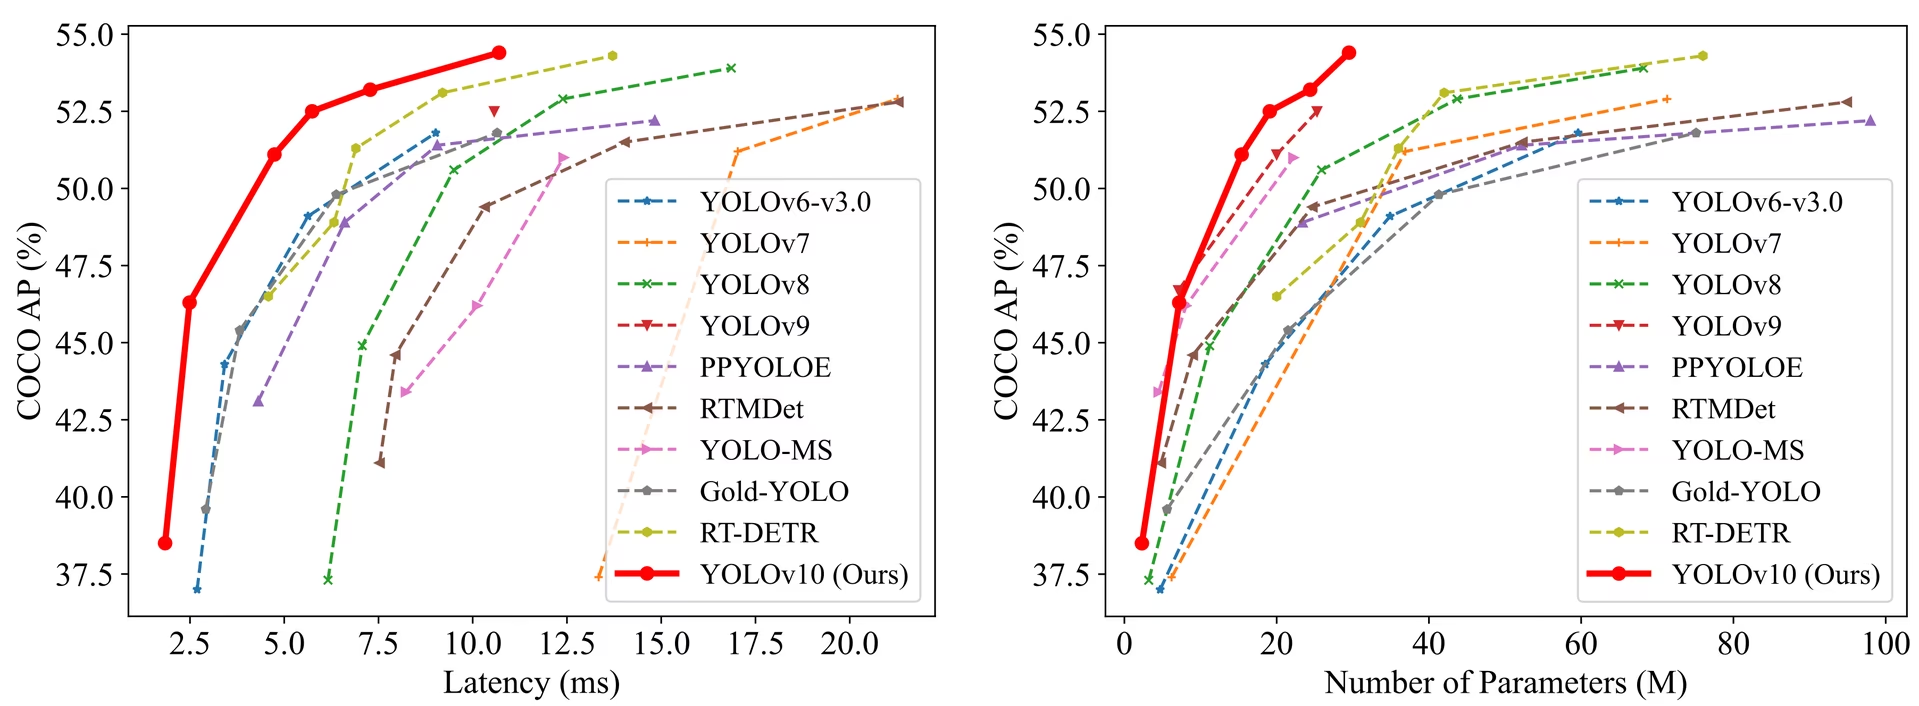
Im Vergleich zu anderen hochmodernen Detektoren:
- YOLOv10s / x sind 1,8× / 1,3× schneller als RT-DETR-R18 / R101 und erzielen eine ähnliche Genauigkeit
- YOLOv10b hat bei gleicher Genauigkeit 25 % weniger Parameter und eine um 46 % geringere Latenz als YOLOv9-C
- YOLOv10l / x übertreffen YOLOv8l / x um 0,3 AP / 0,5 AP und benötigen 1,8× / 2,3× weniger Parameter
Die folgenden Werte stammen aus der YOLOv10-Studie und wurden nach deren eigenem Protokoll gemessen. Daher sind sie nicht direkt mit den Werten auf den Ultralytics-Modellseiten vergleichbar:
| Modell | Parameter (M) | FLOPs (G) | mAPval50-95 | Latenz (ms) | Vorwärtslatenz (ms) |
|---|---|---|---|---|---|
| YOLOv6-3.0-N | 4.7 | 11.4 | 37.0 | 2.69 | 1.76 |
| Gold-YOLO-N | 5.6 | 12.1 | 39.6 | 2.92 | 1.82 |
| YOLOv8n | 3.2 | 8.7 | 37.3 | 6.16 | 1.77 |
| YOLOv10n | 2.3 | 6.7 | 38.5 | 1.84 | 1.79 |
| YOLOv6-3.0-S | 18.5 | 45.3 | 44.3 | 3.42 | 2.35 |
| Gold-YOLO-S | 21.5 | 46.0 | 45.4 | 3.82 | 2.73 |
| YOLOv8s | 11.2 | 28.6 | 44.9 | 7.07 | 2.33 |
| YOLOv10s | 7.2 | 21.6 | 46.3 | 2.49 | 2.39 |
| RT-DETR-R18 | 20.0 | 60.0 | 46.5 | 4.58 | 4.49 |
| YOLOv6-3.0-M | 34.9 | 85.8 | 49.1 | 5.63 | 4.56 |
| Gold-YOLO-M | 41.3 | 87.5 | 49.8 | 6.38 | 5.45 |
| YOLOv8m | 25.9 | 78.9 | 50.6 | 9.50 | 5.09 |
| YOLOv10m | 15.4 | 59.1 | 51.1 | 4.74 | 4.63 |
| YOLOv6-3.0-L | 59.6 | 150.7 | 51.8 | 9.02 | 7.90 |
| Gold-YOLO-L | 75.1 | 151.7 | 51.8 | 10.65 | 9.78 |
| YOLOv8l | 43.7 | 165.2 | 52.9 | 12.39 | 8.06 |
| RT-DETR-R50 | 42.0 | 136.0 | 53.1 | 9.20 | 9.07 |
| YOLOv10l | 24.4 | 120.3 | 53.2 | 7.28 | 7.21 |
| YOLOv8x | 68.2 | 257.8 | 53.9 | 16.86 | 12.83 |
| RT-DETR-R101 | 76.0 | 259.0 | 54.3 | 13.71 | 13.58 |
| YOLOv10x | 29.5 | 160.4 | 54.4 | 10.70 | 10.60 |
Die Werte für Parameter und FLOPs beziehen sich auf das zusammengeführte Modell nach model.fuse(). Dabei werden Conv- und BatchNorm-Schichten zusammengeführt und der zusätzliche One-to-Many-Erkennungskopf entfernt. Vortrainierte Checkpoints behalten die vollständige Trainingsarchitektur bei und können daher höhere Werte aufweisen.
Anwendungsbeispiele#
Modelle können auch auf Cloud-GPUs über die Ultralytics Platform trainiert werden. So führst du mit YOLOv10 Vorhersagen für neue Bilder aus:
from ultralytics import YOLO

# Ein vortrainiertes YOLOv10n-Modell laden
model = YOLO("yolov10n.pt")

# Objekterkennung in einem Bild durchführen
results = model("image.jpg")

# Ergebnisse anzeigen
results[0].show()
So trainierst du YOLOv10 mit einem benutzerdefinierten Datensatz:
from ultralytics import YOLO

# YOLOv10n-Modell von Grund auf laden
model = YOLO("yolov10n.yaml")

# Das Modell trainieren
model.train(data="coco8.yaml", epochs=100, imgsz=640)
Unterstützte Aufgaben und Modi#
Die YOLOv10-Modellreihe bietet verschiedene Modelle, die jeweils für die Objekterkennung optimiert sind. Die Varianten decken unterschiedliche Rechenbudgets und Genauigkeitsanforderungen ab.
| Modell | Dateinamen | Aufgaben | Training | Validierung | Inferenz | Exportieren |
|---|---|---|---|---|---|---|
| YOLOv10 | yolov10n.pt yolov10s.pt yolov10m.pt yolov10b.pt yolov10l.pt yolov10x.pt | Objekterkennung | ✅ | ✅ | ✅ | ✅ |
YOLOv10 exportieren#
Aufgrund der neuen Operationen in YOLOv10 werden derzeit nicht alle von Ultralytics angebotenen Exportformate unterstützt. Die folgende Tabelle enthält die Formate, in die Ultralytics YOLOv10 erfolgreich konvertiert hat. Beiträge in Form von Pull Requests, die den Export in weitere Formate ermöglichen, sind willkommen.
| Exportformat | Exportunterstützung | Inferenz mit exportiertem Modell | Hinweise |
|---|---|---|---|
| TorchScript | ✅ | ✅ | Standardmäßiges PyTorch-Modellformat. |
| ONNX | ✅ | ✅ | Weitgehend für die Bereitstellung unterstützt. |
| OpenVINO | ✅ | ✅ | Für Intel-Hardware optimiert. |
| TensorRT | ✅ | ✅ | Für NVIDIA GPUs optimiert. |
| CoreML | ✅ | ✅ | Auf Apple-Geräte beschränkt. |
| TF SavedModel | ✅ | ✅ | Standardmäßiges Modellformat von TensorFlow. |
| TF GraphDef | ✅ | ✅ | Veraltetes TensorFlow-Format. |
| TF Edge TPU | ✅ | ✅ | Speziell für die Edge TPU-Geräte von Google. |
| LiteRT | ✅ | ✅ | Für Mobilgeräte, eingebettete Systeme und Browser (LiteRT.js) optimiert. |
| PaddlePaddle | ✅ | ✅ | In China beliebt; außerhalb davon weniger verbreitet. |
| NCNN | ✅ | ✅ | Optimiert für Mobilgeräte und eingebettete Geräte. |
Fazit#
Bei seiner Veröffentlichung brachte YOLOv10 die Objekterkennung in Echtzeit voran, indem es auf die NMS-Nachverarbeitung verzichtete und Modellkomponenten auf Effizienz und Genauigkeit ausrichtete. Sein NMS-freier Ansatz ebnete in der YOLO-Familie den Weg für die End-to-End-Objekterkennung. Das neueste Ultralytics-Modell YOLO26 baut darauf auf und bietet verbesserte Leistung sowie NMS-freie Inferenz.
Zitate und Danksagungen#
Wir möchten den YOLOv10-Autoren der Tsinghua-Universität für ihre umfangreiche Forschungsarbeit und bedeutenden Beiträge zum Ultralytics-Framework danken:
@inproceedings{wang2024yolov10,
  title={YOLOv10: Real-Time End-to-End Object Detection},
  author={Wang, Ao and Chen, Hui and Liu, Lihao and Chen, Kai and Lin, Zijia and Han, Jungong and Ding, Guiguang},
  booktitle={Advances in Neural Information Processing Systems},
  doi = {10.52202/079017-3429},
  url = {https://proceedings.neurips.cc/paper_files/paper/2024/file/c34ddd05eb089991f06f3c5dc36836e0-Paper-Conference.pdf},
  volume={37},
  pages={107984--108011},
  year={2024}
}
Ausführliche Informationen zur Implementierung, zu architektonischen Neuerungen und zu den Versuchsergebnissen findest du in der Forschungsarbeit zu YOLOv10 und im GitHub-Repository des Teams der Tsinghua-Universität.
Häufig gestellte Fragen#
YOLOv10, entwickelt von Forschenden der Tsinghua-Universität, führt mehrere wichtige Neuerungen für die Objekterkennung in Echtzeit ein. Durch konsistente duale Zuweisungen während des Trainings entfällt die Notwendigkeit einer nicht maximalen Unterdrückung (NMS). Außerdem werden Modellkomponenten optimiert, um den Rechenaufwand zu verringern.
Führe die Inferenz über die Ultralytics-Python-API oder die Befehlszeilenschnittstelle (CLI) aus. Nachfolgend findest du Beispiele für Vorhersagen auf neuen Bildern mit YOLOv10:
Beispielfrom ultralytics import YOLO # Das vortrainierte YOLOv10n-Modell laden model = YOLO("yolov10n.pt") results = model("image.jpg") results[0].show()Weitere Anwendungsbeispiele findest du im Abschnitt Anwendungsbeispiele.
YOLOv10 bietet mehrere Modellvarianten für unterschiedliche Anwendungsfälle:
- YOLOv10n: Geeignet für Umgebungen mit äußerst begrenzten Ressourcen
- YOLOv10s: Bietet eine ausgewogene Kombination aus Geschwindigkeit und Genauigkeit
- YOLOv10m: Für den allgemeinen Einsatz
- YOLOv10b: Höhere Genauigkeit durch größere Breite
- YOLOv10l: Hohe Genauigkeit bei entsprechendem Rechenaufwand
- YOLOv10x: Maximale Genauigkeit und Leistung
Jede Variante ist auf unterschiedliche Rechenanforderungen und Genauigkeitsanforderungen ausgelegt und eignet sich dadurch für vielfältige Anwendungen. Weitere Informationen findest du im Abschnitt Modellvarianten.
YOLOv10 wird mit konsistenten dualen Zuordnungen trainiert, sodass der Eins-zu-eins-Kopf für jedes Objekt die beste einzelne Vorhersage erzeugt. Dadurch ist bei der Inferenz keine nichtmaximale Unterdrückung (NMS) erforderlich. Die Vorhersage und Validierung in Ultralytics verwenden standardmäßig den Eins-zu-viele-Kopf mit NMS; setze
nms=False, um den NMS-freien Kopf auszuwählen und den NMS-Schritt zu überspringen. Eine ausführliche Erklärung findest du im Abschnitt Konsistente duale Zuordnungen für NMS-freies Training.YOLOv10 unterstützt mehrere Exportformate, darunter TorchScript, ONNX, OpenVINO und TensorRT. Aufgrund seiner neuen Operationen werden derzeit jedoch nicht alle von Ultralytics angebotenen Exportformate für YOLOv10 unterstützt. Details zu den unterstützten Formaten und Anweisungen zum Exportieren findest du im Abschnitt YOLOv10 exportieren.
Bei seiner Veröffentlichung übertraf YOLOv10 frühere YOLO-Versionen und andere hochmoderne Modelle sowohl in puncto Genauigkeit als auch Effizienz. So ist YOLOv10s 1,8-mal schneller als RT-DETR-R18 und erzielt eine ähnliche AP auf dem COCO-Datensatz. YOLOv10b hat bei gleicher Leistung eine um 46 % geringere Latenz und 25 % weniger Parameter als YOLOv9-C. Detaillierte Benchmark-Ergebnisse findest du im Abschnitt Vergleiche.


Kommentare188
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
 Glenn JocherUltralytics(bearbeitet)
I'm super excited about the groundbreaking work on YOLOv10 by the researchers at Tsinghua University. Just a week ago, @pderrenger and I had the privilege of presenting YOLO to ML graduate students at Tsinghua University in Shenzhen, and I was thoroughly impressed by their enthusiasm and expertise.
Now, seeing the remarkable advancements in real-time object detection with YOLOv10, I'm thrilled to collaborate with the Tsinghua team to officially bring YOLOv10 support to the Ultralytics Python package soon. The innovative approach to NMS-free training and holistic model design optimizations demonstrates their commitment to pushing the boundaries of what's possible.
Stay tuned for the official release of YOLOv10 support in the Ultralytics package, and get ready to experience the incredible capabilities of this revolutionary real-time object detector!
38jameslahm
Thank you so much for your great support for YOLOv10! We are truly grateful for your efforts to bring YOLOv10 to the Ultralytics package. ❤️
2
heynewyeah
您好。如果我想在训练结束后,以last.pt的模型权重继续训练(因为还未收敛),有什么办法能获取last epoch的优化器状态吗,用于继续训练。或者有什么其他方法能够完成继续训练吗?
alephpi(bearbeitet)
from ultralytics import YOLO

# Load a model
model = YOLO("path/to/last.pt")  # load a partially trained model

# Resume training
results = model.train(resume=True)
Anser1
Hello, I'm sorry to disturb you. I want to conduct the training for the segmentation task based on YOLOv10, but I found that there seems to be no YAML structure file for the segmentation model. What should I do?
zlj127
Does YOLOv10 have the pose function? Currently, I have only found a pre-trained model for gestures under the GitHub of the Hagrid dataset, but it is still used for detection.
- Glenn JocherUltralytics(bearbeitet)
@zlj127 YOLOv10 currently focuses on object detection tasks and does not include built-in pose estimation functionality. For pose/keypoint estimation, we recommend using YOLO26 which offers integrated support for pose estimation along with detection, segmentation, and classification. See the YOLO26 Pose documentation for implementation details and code examples.
ok,thank you
- Glenn JocherUltralytics(bearbeitet)
@zlj127 you're welcome! For pose estimation tasks, we recommend using YOLO26 which offers integrated support. Let us know if you need help getting started with the Pose documentation.
gniqeh
It is important to configure the correct threshold of dual label assignments in the paper. But how can we change the threshold in yolov10 of ultralytics module?
Es importante configurar el umbral correcto de asignaciones de etiquetas duales en el documento. pero ¿cómo podemos cambiar el umbral en yolov10 del módulo ultralytics?
- Glenn JocherUltralytics(bearbeitet)
@gniqeh the dual label assignment settings are not exposed in the model YAML or as training arguments. They are set in the loss code (
E2EDetectLossinultralytics/utils/loss.py), where the one-to-many branch usestal_topk=10and the one-to-one branch usestal_topk=1. To change them, edit those values in a local copy of the package. For details, see the YOLOv10 Ultralytics documentation. Let us know if you need further clarification! Thx for your reply my friend, I have checked the documentation and API ref. of yolov10 but there is only the basical introductiong about it. And i am pleasure if u can provide further implementation explaining. Thanks again!
- Glenn JocherUltralytics
Thank you for your feedback! For a deeper understanding of YOLOv10 implementation, you can explore the specifics of its architecture and features in the YOLOv10 documentation. If you have particular aspects or technical details you'd like clarified, feel free to let us know!
Ly2003ykjy
Are YOLOV10 and 11 really superior to v7 and v8 in small target detection?
- Glenn JocherUltralytics
YOLOv10 and YOLO11 introduce innovations like NMS-free training, which can enhance small target detection performance compared to YOLOv7 and YOLOv8, but results may vary based on specific use cases and datasets.
abaldanz
Hello, do you plan to provide weights for the pre-trained model on 1280p size images?
- Glenn JocherUltralytics
@abaldanz thank you for your interest. Currently, we don't have plans to provide pre-trained weights specifically for 1280p images. For updates, please keep an eye on our repository and documentation.
Yuwenliula
请问一下,yolov10是否内置了IOU计算的功能,在val结果中未见到IOU的输出,如果没有的话,能方便提供代码进行IOU计算吗?
- Glenn JocherUltralytics
@Yuwenliula yOLOv10 does not directly output IoU in validation results. You can calculate IoU using the bounding box coordinates from the model's predictions. If you need further assistance, please refer to the Ultralytics documentation for guidance.
qruiwu
what is the each parameter mean in results.csv after training a model?
- Glenn JocherUltralytics
@wuqrcn the
results.csvfile contains metrics such as precision, recall, mAP, and loss values for each epoch during training. These metrics help evaluate the model's performance and convergence. For more details, please refer to the documentation.
alifazeli00
Why do the weights uploaded here: https://github.com/THU-MIG/yolov10?tab=readme-ov-file#performance not give the same results on the dataset as the weights uploaded on Ultralytics? I checked their architectures, and they seem to be identical.
- Glenn JocherUltralytics
@alifazeli00 the difference in results might be due to variations in training data, hyperparameters, or preprocessing steps. Ensure both models are evaluated under identical conditions for accurate comparison.
They are all the same except for the val_period parameter, which is only present in the THU-MIG model. However, the Ultralytics model performs better. I tested x and noticed differences in the weights. Are you saying that these two models should produce identical results?
- Glenn JocherUltralytics
The differences in results could be due to variations in training data, hyperparameters, or preprocessing steps. Ensure both models are evaluated under identical conditions for accurate comparison.
-1