Multi-Objekt-Tracking mit Ultralytics YOLO
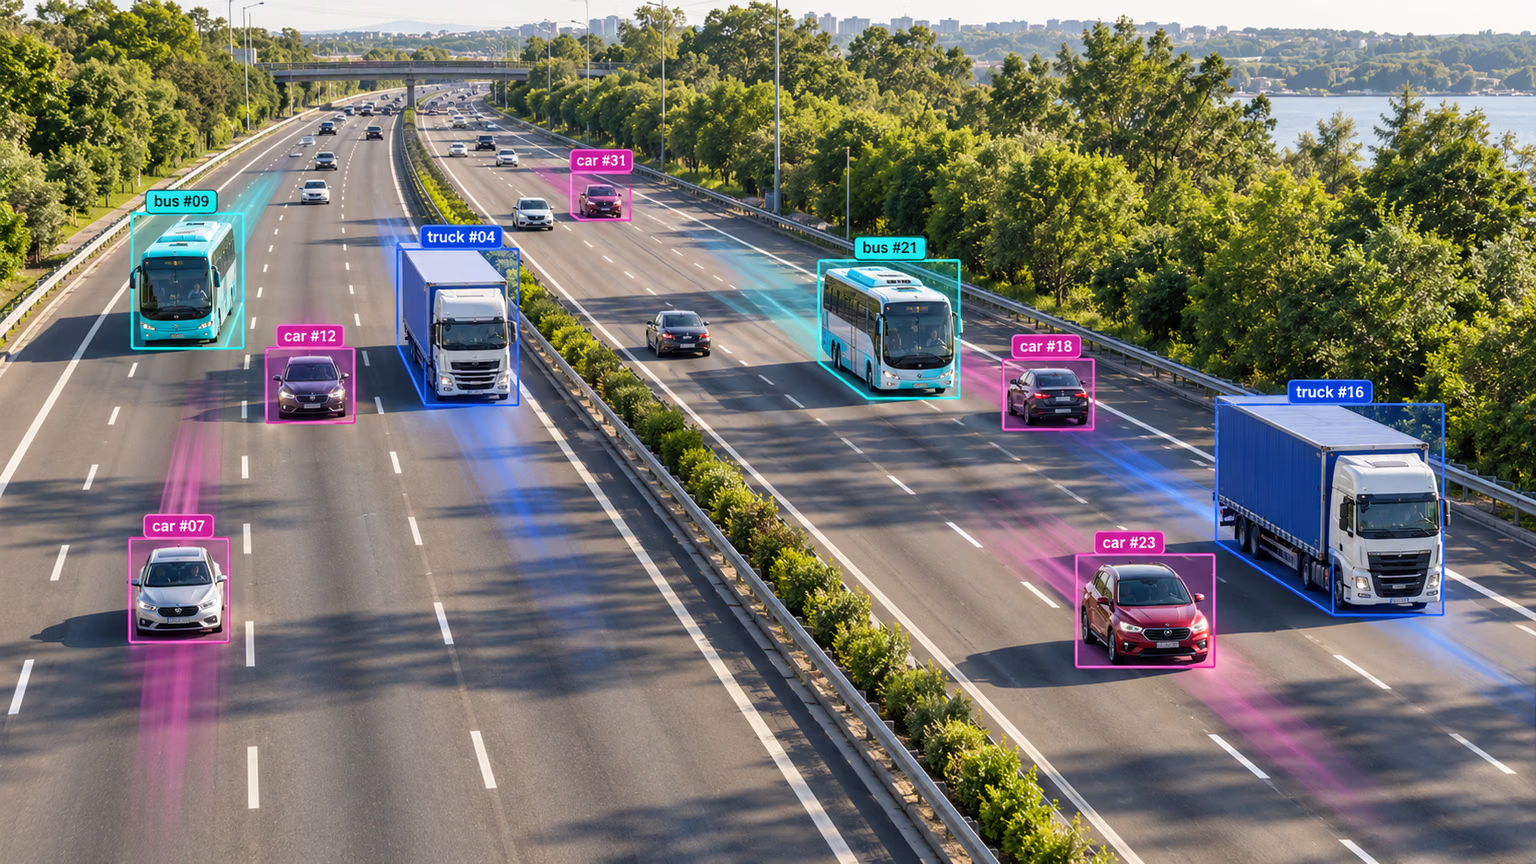
Multi-Objekt-Tracking in der Videoanalyse ermittelt in jedem Einzelbild Position und Klasse von Objekten und ordnet jedem erkannten Objekt eine eindeutige ID zu, während das Video fortschreitet. Die Anwendungsbereiche reichen von Überwachung und Sicherheit bis zur Sportanalyse in Echtzeit.
Sieh dir die Vorschau des noch nicht veröffentlichten YOLO27 an, um mehr über die geplante Tracking-Unterstützung zu erfahren.
Ab Version ultralytics 8.4.63 sind OC-SORT, Deep OC-SORT, FastTracker und TrackTrack zusätzlich zu BoT-SORT und ByteTrack verfügbar.
Warum solltest du Ultralytics YOLO für Objekt-Tracking verwenden?#
Die Ausgabe von Ultralytics-Trackern entspricht der standardmäßigen Objekterkennung, enthält aber zusätzlich Objekt-IDs. So lassen sich Objekte in Videostreams verfolgen und anschließend analysieren. Wichtige Gründe für die Verwendung von Ultralytics YOLO zum Objekt-Tracking:
- Effizienz: Verarbeite Videostreams in Echtzeit, ohne die Genauigkeit zu beeinträchtigen.
- Flexibilität: Unterstützt mehrere Tracking-Algorithmen und Konfigurationen.
- Einfache Bedienung: Eine einfache Python-API und CLI-Optionen ermöglichen die schnelle Integration und Bereitstellung.
- Anpassbarkeit: Lässt sich leicht mit eigenen trainierten YOLO-Modellen verwenden und in anwendungsspezifische Lösungen integrieren.
Ansehen: So führst du die Verfolgung mehrerer Objekte mit Ultralytics YOLO26 aus | BoT-SORT und ByteTrack | VisionAI 🚀
Anwendungen in der Praxis#
| Transport | Einzelhandel | Aquakultur |
|---|---|---|
| Fahrzeug-Tracking | Personen-Tracking | Fisch-Tracking |
Schnellstart#
Führe das Tracking in einem Video mit dem standardmäßigen TrackTrack-Tracker aus. Wechsle zu einem anderen Tracker, indem du das Argument tracker änderst.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# Standard-Tracker (TrackTrack)
results = model.track(source="https://youtu.be/LNwODJXcvt4", show=True)

# Zu ByteTrack wechseln
results = model.track(source="https://youtu.be/LNwODJXcvt4", show=True, tracker="bytetrack.yaml")
Um den Tracker auf Videostreams auszuführen, verwende ein trainiertes Detect-, Segment-, Pose- oder OBB-Modell wie YOLO26n, YOLO26n-seg, YOLO26n-pose oder YOLO26n-obb. Alle sind in der YOLO26-Sammlung auf der Ultralytics Platform verfügbar. Du kannst benutzerdefinierte Modelle lokal oder mit dem Cloud-Training der Ultralytics Platform trainieren.
from ultralytics import YOLO

# Ein offizielles oder eigenes Modell laden
model = YOLO("yolo26n.pt")  # Ein offizielles Detect-Modell laden
model = YOLO("yolo26n-seg.pt")  # Ein offizielles Segment-Modell laden
model = YOLO("yolo26n-pose.pt")  # Ein offizielles Pose-Modell laden
model = YOLO("path/to/best.pt")  # Ein eigenes trainiertes Modell laden

# Mit dem Modell Tracking ausführen
results = model.track("https://youtu.be/LNwODJXcvt4", show=True)  # Tracking mit dem Standard-Tracker
results = model.track("https://youtu.be/LNwODJXcvt4", show=True, tracker="bytetrack.yaml")  # mit ByteTrack
Unterstützte Tracker#
Ultralytics YOLO enthält sechs integrierte Tracker. Aktiviere einen davon, indem du seine YAML-Konfigurationsdatei an das Argument tracker übergibst.
| Tracker | Konfigurationsdatei | Bewegungsmodell | Erscheinungsbild / ReID | Kompensation von Kamerabewegungen | Umgang mit Verdeckungen |
|---|---|---|---|---|---|
| BoT-SORT | botsort.yaml | Linearer Kalman-Filter | Optional (with_reid) | Konfigurierbar (gmc_method) | Track-Puffer + ReID-Neuzuordnung |
| ByteTrack | bytetrack.yaml | Linearer Kalman-Filter | Keine | Nein | Zweistufige Wiederaufnahme von Erkennungen mit niedriger Konfidenz |
| OC-SORT | ocsort.yaml | Beobachtungszentrierter Kalman-Filter | Keine | Nein | ORU, OCM, OCR: erneute Aktualisierung anhand der letzten Beobachtung |
| Deep OC-SORT | deepocsort.yaml | Beobachtungszentrierter Kalman-Filter | Optional (with_reid) | Konfigurierbar (gmc_method) | OC-SORT + optionale adaptive EMA für das Erscheinungsbild |
| FastTracker | fasttrack.yaml | Linearer Kalman-Filter + Zurücksetzen | Keine | Nein | Kalman-Zurücksetzen + Vergrößerung der BBox bei Verdeckung |
| TrackTrack | tracktrack.yaml | Linearer Kalman-Filter (NSA) | Optional (with_reid) | Konfigurierbar (gmc_method) | Iterative Zuordnung anhand mehrerer Merkmale + TAI |
Welchen Tracker solltest du verwenden?#
Nutze diesen Ablauf als Ausgangspunkt. Wenn du kein tracker übergibst, wird tracktrack.yaml verwendet:
- Du brauchst eine möglichst schnelle und einfache Basis? → ByteTrack (kein ReID, keine Kompensation von Kamerabewegungen, minimaler Zusatzaufwand).
- Aufnahmen mit Handkamera, Drohne oder bewegter Kamera? → BoT-SORT (bietet Kompensation von Kamerabewegungen und optionales ReID).
- Nichtlineare Bewegungen (Sport, Tanzen, abrupte Richtungswechsel) und kein ReID? → OC-SORT (beobachtungszentrierte Korrekturen ohne Aufwand für den Abgleich des Erscheinungsbilds).
- Dicht gedrängte Szenen mit bewegter Kamera, in denen ID-Wechsel das Hauptproblem sind? → Deep OC-SORT oder TrackTrack (beide unterstützen den optionalen Abgleich des Erscheinungsbilds; TrackTrack bietet zusätzlich eine Zuordnung anhand mehrerer Merkmale und unterdrückt doppelte IDs).
- Häufige teilweise Überlappungen in Echtzeit, aber kein Budget für ReID? → FastTracker (eine für Verdeckungen ausgelegte ByteTrack-Variante mit Kalman-Zurücksetzen).
Tracker wechseln#
Übergib den Dateinamen der Tracker-Konfiguration an tracker=. Der übrige Code bleibt unverändert.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

results = model.track(source="path/to/video.mp4", tracker="bytetrack.yaml")
results = model.track(source="path/to/video.mp4", tracker="ocsort.yaml")
results = model.track(source="path/to/video.mp4", tracker="tracktrack.yaml")Konfiguration#
Tracking-Argumente#
Die Tracking-Konfiguration verwendet dieselben Inferenzargumente wie der Predict-Modus, zum Beispiel conf, iou und show.
from ultralytics import YOLO

# Tracking-Parameter konfigurieren und Tracker ausführen
model = YOLO("yolo26n.pt")
results = model.track(source="https://youtu.be/LNwODJXcvt4", conf=0.1, iou=0.5, show=True)
Eigene Tracker-Konfiguration#
Um eine geänderte Tracker-Konfiguration zu verwenden, kopiere eine Tracker-Konfigurationsdatei (zum Beispiel als custom_tracker.yaml) aus ultralytics/cfg/trackers und ändere beliebige Einstellungen außer tracker_type.
from ultralytics import YOLO

# Modell laden und Tracker mit einer eigenen Konfigurationsdatei ausführen
model = YOLO("yolo26n.pt")
results = model.track(source="https://youtu.be/LNwODJXcvt4", tracker="custom_tracker.yaml")
Gemeinsame Tracker-Argumente#
Die folgenden Parameter kommen in den meisten Tracker-YAML-Dateien vor; nicht jeder Parameter ist in jeder Konfiguration enthalten:
Erkennungen ab track_high_thresh gelangen in die erste Zuordnungsstufe. Erkennungen zwischen track_low_thresh und track_high_thresh können bestehende Tracks wiederaufnehmen, wenn der ausgewählte Tracker die Zuordnung von Erkennungen mit niedriger Konfidenz unterstützt; neue Tracks starten sie jedoch nicht. Erkennungen bei oder unter track_low_thresh werden ignoriert.
| Parameter | Gültige Werte oder Bereiche | Beschreibung |
|---|---|---|
tracker_type | botsort, bytetrack, ocsort, deepocsort, fasttrack, tracktrack | Gibt den Trackertyp an. |
track_high_thresh | 0.0-1.0 | Schwellenwert für die erste Zuordnung. Beeinflusst, wie sicher eine Erkennung einem bestehenden Track zugeordnet wird. |
track_low_thresh | 0.0-1.0 | Untergrenze für Erkennungen mit geringer Konfidenz zur Wiederherstellung. OC-SORT und Deep OC-SORT verwenden diese nur, wenn use_byte: True; TrackTrack bezieht sie in seinen Zuordnungspool mit Strafkosten ein. |
new_track_thresh | 0.0-1.0 | Schwellenwert zum Initialisieren eines neuen Tracks, wenn die Erkennung keinem bestehenden Track zugeordnet werden kann. |
track_buffer | >=0 | Anzahl der Frames, für die verlorene Tracks vor ihrer Entfernung erhalten bleiben. Ein höherer Wert bedeutet mehr Toleranz gegenüber Verdeckungen. |
match_thresh | 0.0-1.0 | Schwellenwert für die Zuordnung von Tracks. Höhere Werte machen die Zuordnung großzügiger. |
fuse_score | True, False | Gibt an, ob Konfidenzwerte vor der Zuordnung mit IoU-Abständen zusammengeführt werden. |
gmc_method | sparseOptFlow, orb, sift, ecc, none | Methode zum Ausgleich globaler Bewegungen. Hilft dabei, Kamerabewegungen auszugleichen. |
proximity_thresh | 0.0-1.0 | Mindest-IoU für eine gültige ReID-Zuordnung. Stellt räumliche Nähe sicher, bevor Erscheinungsmerkmale verwendet werden. |
appearance_thresh | 0.0-1.0 | Mindestens erforderliche normalisierte Ähnlichkeit des Erscheinungsbilds für ReID. |
with_reid | True, False | Aktiviert die Zuordnung anhand des Erscheinungsbilds für ein besseres Tracking bei Verdeckungen. Unterstützt von BoT-SORT, Deep OC-SORT und TrackTrack. |
model | auto oder kompatibler Pfad zu einem ReID-Modell | ReID-Modell. auto verwendet, sofern verfügbar, native YOLO-Backbone-Merkmale; andernfalls wird auf yolo26n-cls.pt zurückgegriffen. Ein benutzerdefinierter Encoder kann ein .pt-Checkpoint oder ein exportiertes Modell wie .torchscript, .onnx, .engine oder ein OpenVINO-Modellverzeichnis sein. |
Trackerspezifische Argumente#
Jeder Algorithmus bietet zusätzlich zu den gemeinsamen Parametern weitere Einstellmöglichkeiten. Beschreibungen und Hinweise zur Abstimmung findest du in den folgenden Abschnitten zu den einzelnen Trackern oder direkt in den Konfigurationsdateien:
Re-Identifikation (ReID) aktivieren#
ReID ist standardmäßig deaktiviert, um den Rechenaufwand möglichst gering zu halten. Aktiviere ReID, indem du with_reid: True in einer Tracker-Konfigurationsdatei setzt.
ReID-Modelloptionen:
model: auto— Verwendet native Merkmale des YOLO-Detektors und verursacht nur minimalen Mehraufwand. Ideal, wenn du ReID nutzen möchtest, ohne die Leistung stark zu beeinträchtigen. Wird aufyolo26n-cls.ptzurückgegriffen, wenn der Detektor keine kompatiblen Merkmale bereitstellt.- Benutzerdefiniertes ReID-Modell — Verweise mit
model:auf einen.pt-Checkpoint oder ein kompatibles exportiertes Einbettungsmodell, z. B..torchscript,.onnx,.engineoder ein OpenVINO-Modellverzeichnis. Exportierte Modelle werden überAutoBackendgeladen und müssen direkt einen Einbettungstensor ausgeben.
Für jede Modellgröße werden sofort einsetzbare ONNX-Encoder veröffentlicht. Setze model: auf einen dieser Namen. Die Datei wird dann beim ersten Start des Trackers automatisch heruntergeladen (genauso wie YOLO-Gewichte) — ein manueller Export oder Download ist nicht erforderlich:
# In your tracker config (e.g. tracktrack.yaml)
with_reid: True
model: yolo26n-reid.onnx # downloaded on first use; swap n→s/m/l/x for a larger encoder| Modell | Größe (Pixel) | Parameter (M) | FLOPs (B) |
|---|---|---|---|
| YOLO26n-reid.onnx | 448 | 2.8 | 2.0 |
| YOLO26s-reid.onnx | 448 | 7.5 | 6.6 |
| YOLO26m-reid.onnx | 448 | 12.4 | 20.1 |
| YOLO26l-reid.onnx | 448 | 15.3 | 25.2 |
| YOLO26x-reid.onnx | 448 | 32.7 | 55.9 |
Derzeit sind nur ONNX-ReID-Encoder für den Erscheinungsbild-Zweig des Trackers verfügbar. Die ReID-Modi train, val und predict sowie spezielle Anleitungen zum ReID-Export befinden sich noch in der Entwicklung.
Für eine bessere Leistung mit einem separaten Klassifizierungsmodell kannst du es in ein schnelleres Backend wie TensorRT exportieren:
from torch import nn

from ultralytics import YOLO

# Das Klassifizierungsmodell laden
model = YOLO("yolo26n-cls.pt")

# Eine Average-Pooling-Schicht hinzufügen
head = model.model.model[-1]
pool = nn.Sequential(nn.AdaptiveAvgPool2d((1, 1)), nn.Flatten(start_dim=1))
pool.f, pool.i = head.f, head.i
model.model.model[-1] = pool

# Nach TensorRT exportieren
model.export(format="engine", quantize=16, dynamic=True, batch=32)
Verweise nach dem Export in deiner Tracker-Konfiguration auf den Pfad zum TensorRT-Modell.
Details zu den Trackern#
In den folgenden Abschnitten werden das Design, die spezifischen Parameter und Hinweise zur Abstimmung der einzelnen Tracker beschrieben.
Ansehen: Welcher Objekt-Tracker ist besser? | Geschwindigkeit, FPS und ID-Stabilität | Ultralytics YOLO26 📊
BoT-SORT#
BoT-SORT (Aharon et al., 2022) erweitert ByteTrack um den Ausgleich von Kamerabewegungen und optionales ReID:
- Ausgleich von Kamerabewegungen (CMC): Auf die Kalman-Zustände vor dem IoU-Abgleich wird in jedem Frame eine geschätzte affine Transformation angewendet (standardmäßig mit spärlichem optischem Fluss; ORB / ECC sind ebenfalls verfügbar).
- Optionales ReID: Einbettungen des Erscheinungsbilds können in die Kostenmatrix einfließen. Standardmäßig deaktiviert; aktiviere die Funktion mit
with_reid: True.
Am besten geeignet für: allgemeines Tracking, insbesondere bei bewegten Kameras. Füge ReID nur hinzu, wenn Verwechslungen ähnlicher Objekte zu ID-Wechseln führen.
BoT-SORT-spezifische Argumente:
| Parameter | Gültige Werte oder Bereiche | Beschreibung |
|---|---|---|
gmc_method | sparseOptFlow, orb, sift, ecc, none | Backend zum Ausgleich von Kamerabewegungen. sparseOptFlow ist die Standardeinstellung. none deaktiviert CMC. |
with_reid | True, False | Zuordnung anhand des Erscheinungsbilds aktivieren. Standardmäßig deaktiviert. |
model | auto oder kompatibler Pfad zu einem ReID-Modell | auto verwendet, sofern verfügbar, native YOLO-Merkmale; benutzerdefinierte Modelle können .pt-Checkpoints oder kompatible Exporte sein. |
proximity_thresh | 0.0-1.0 | Mindest-IoU, bevor Merkmale des Erscheinungsbilds berücksichtigt werden. |
appearance_thresh | 0.0-1.0 | Mindestens erforderliche normalisierte Ähnlichkeit des Erscheinungsbilds für eine ReID-Zuordnung. Erhöhe den Wert, um die Zuordnung strenger zu machen. |
Hinweise zur Abstimmung:
- Statische Kamera: Setze
gmc_method: none, um einige ms/Frame einzusparen. - Starke Kamerabewegungen: Behalte
sparseOptFlowbei;eccist genauer, aber langsamer. - Menschenmengen mit ähnlichem Erscheinungsbild: Aktiviere
with_reid: Trueund erhöheappearance_thresh(z. B.0.85+).
ByteTrack#
ByteTrack (Zhang et al., ECCV 2022) ist die ressourcenschonende Baseline. Der Tracker kombiniert einen linearen Kalman-Filter mit IoU und verwendet eine zweistufige Zuordnung:
- Stufe 1: Ordnet Erkennungen mit hohen Konfidenzwerten aktiven Tracks zu.
- Stufe 2: Gleicht nicht zugeordnete Tracks erneut mit Erkennungen mit niedrigen Konfidenzwerten ab, um sie nach kurzen teilweisen Verdeckungen wiederzufinden.
Es gibt weder ein Modell für das Erscheinungsbild noch einen Ausgleich von Kamerabewegungen.
Am besten geeignet für: statische oder nahezu statische Kameras, bei denen der Aufwand des Detektors ausschlaggebend ist und der Tracker möglichst wenig zusätzliche Ressourcen beanspruchen soll.
ByteTrack-spezifische Argumente: Keine über die gemeinsamen Tracker-Argumente hinaus.
Hinweise zur Abstimmung:
- Rauschen im Detektor: Senke
track_low_thresh, damit in der zweiten Stufe mehr Kandidaten zur Verfügung stehen. - Detektor mit hoher Trefferquote: Erhöhe
track_high_thresh, um fragmentierte IDs zu reduzieren. - Häufiges Flackern von IDs: Erhöhe
track_buffer, damit kurzzeitig übersehene Tracks erhalten bleiben.
OC-SORT#
OC-SORT (Cao et al., CVPR 2023) ist eine beobachtungszentrierte Erweiterung von SORT. Sie behält das ressourcenschonende Design von SORT bei (ohne Merkmale des Erscheinungsbilds) und ergänzt drei Korrekturen:
- Beobachtungszentrierte Aktualisierung (ORU): Berechnet eine virtuelle Trajektorie zwischen der letzten Beobachtung und der aktuellen Erkennung erneut und führt die Kalman-Aktualisierung nochmals aus, um abgedriftete Geschwindigkeiten zu korrigieren.
- Beobachtungszentrierter Impuls (OCM): Bestraft Erkennungen, die sich in die falsche Richtung bewegen, mithilfe eines Terms für die Geschwindigkeitskonsistenz.
- Beobachtungszentrierte Wiederherstellung (OCR): Prüft nicht zugeordnete Erkennungen erneut anhand kürzlich verlorener Tracks. Dabei wird deren letzte Beobachtung statt des vorhergesagten Zustands verwendet.
Am besten geeignet für: nichtlineare Bewegungen ohne den zusätzlichen Aufwand eines ReID-Modells.
OC-SORT-spezifische Argumente:
| Parameter | Gültige Werte oder Bereiche | Beschreibung |
|---|---|---|
delta_t | >=1 | Zeitfenster (in Frames) für die Berechnung der Bewegungsrichtung in OCM. Größere Werte glätten stärker. |
inertia | 0.0-1.0 | Gewichtung der Kosten für die Geschwindigkeitskonsistenz. Höhere Werte bestrafen abrupte Richtungsänderungen stärker. |
use_byte | True, False | Aktiviert einen zweiten Zuordnungsdurchlauf nach Art von ByteTrack für Erkennungen mit niedriger Konfidenz. |
Hinweise zur Abstimmung:
- Nichtlineare Bewegungen: Erhöhe
inertia(z. B.0.3-0.4). - Spärliche Erkennungen: Aktiviere
use_byte: True. - Lange Verdeckungen: Erhöhe
track_buffer, damit OCR mehr verlorene Tracks erneut zuordnen kann.
Bei OBB-Modellen verwendet OCR die vom Kalman-Filter vorhergesagte orientierte Box, da der Verlauf der letzten orientierten Beobachtung nicht gespeichert wird.
Deep OC-SORT#
Deep OC-SORT ergänzt OC-SORT um Informationen zum Erscheinungsbild und den Ausgleich von Kamerabewegungen:
- Zuordnung anhand des Erscheinungsbilds: Der Kosinusabstand zwischen Einbettungen wird durch die Überlappung begrenzt und mit den Bewegungskosten zusammengeführt.
- Dynamische EMA für das Erscheinungsbild: Einbettungen der Tracks werden mit einer EMA aktualisiert, deren Glättungsfaktor sich an die Konfidenz der Erkennung anpasst.
- Ausgleich von Kamerabewegungen: Kalman-Zustände werden zwischen Frames mithilfe von spärlichem optischem Fluss, ORB oder ECC transformiert.
Am besten geeignet für: überfüllte Szenen oder Szenen mit bewegter Kamera, in denen IDs häufig zwischen visuell unterschiedlichen, aber räumlich nahen Objekten wechseln.
Deep-OC-SORT-spezifische Argumente:
| Parameter | Gültige Werte oder Bereiche | Beschreibung |
|---|---|---|
with_reid | True, False | Zuordnung anhand des Erscheinungsbilds aktivieren. Standardmäßig deaktiviert. |
model | auto oder kompatibler Pfad zu einem ReID-Modell | auto verwendet, sofern verfügbar, native YOLO-Merkmale; benutzerdefinierte Modelle können .pt-Checkpoints oder kompatible Exporte sein. |
proximity_thresh | 0.0-1.0 | Mindest-IoU, bevor Merkmale des Erscheinungsbilds berücksichtigt werden. |
appearance_thresh | 0.0-1.0 | Mindestens erforderliche normalisierte Ähnlichkeit des Erscheinungsbilds für eine ReID-Zuordnung. |
alpha_fixed_emb | 0.0-1.0 | Basisfaktor der EMA für Aktualisierungen der Track-Einbettung. Höhere Werte erhalten die ältere Einbettung länger. |
gmc_method | sparseOptFlow, orb, sift, ecc, none | Methode zum Ausgleich globaler Bewegungen. |
delta_t | >=1 | Zeitfenster (in Frames) für die Berechnung der Bewegungsrichtung in OCM (von OC-SORT übernommen). |
inertia | 0.0-1.0 | Gewichtung der Kosten für die Geschwindigkeitskonsistenz (von OC-SORT übernommen). |
use_byte | True, False | Aktiviert eine zweite Zuordnung nach Art von ByteTrack für Erkennungen mit niedriger Konfidenz (von OC-SORT übernommen). |
Hinweise zur Abstimmung:
- ID-Wechsel in Menschenmengen: Erhöhe
appearance_thresh(z. B.0.92-0.95) und erhöhealpha_fixed_emb, damit sich Einbettungen langsamer anpassen. - Bewegte Kamera: Setze
gmc_method: sparseOptFlow(Deep OC-SORT verwendet standardmäßignone). - Geringere Latenz: Behalte
with_reid: False(Standard) bei, um nur Bewegung und CMC zu berücksichtigen; aktiviere ReID nur, wenn ID-Wechsel die Fehlerursache Nummer eins sind.
FastTracker#
FastTracker ist eine verdeckungsbewusste Variante von ByteTrack ohne Modell für das Erscheinungsbild:
- Verdeckungserkennung: Kennzeichnet Tracks als verdeckt, wenn ihre Abdeckung durch andere aktive Tracks den Wert
occ_cover_threshüberschreitet. - Kalman-Rücksetzung bei Verdeckung: Setzt den Kalman-Zustand mithilfe eines im Ringpuffer gespeicherten Verlaufs auf einen Frame vor der Verdeckung zurück.
- Dämpfung der Bewegung und Erweiterung des Suchbereichs: Die Geschwindigkeit wird gedämpft und die vorhergesagte BBox während der Verdeckung vergrößert.
- Unterdrückung bei der Initialisierung anhand von IoU: Verhindert, dass neue Tracks direkt auf aktiven Tracks beginnen.
Am besten geeignet für: Echtzeit-Pipelines, die nur Erkennungen verwenden und bei denen Ziele häufig einander überdecken (Menschenmengen, Warteschlangen, Sport).
FastTracker-spezifische Argumente:
| Parameter | Gültige Werte oder Bereiche | Beschreibung |
|---|---|---|
reset_velocity_offset_occ | >=0 | Anzahl der Verlaufsbilder, auf die zurückgegriffen wird, um die Kalman-Geschwindigkeit bei Beginn einer Verdeckung wiederherzustellen. |
reset_pos_offset_occ | >=0 | Anzahl der Verlaufsbilder, auf die zurückgegriffen wird, um die Kalman-Position bei Beginn einer Verdeckung wiederherzustellen. |
enlarge_bbox_occ | >=1.0 | Skalierung der Höhe der vorhergesagten BBox während einer Verdeckung (die Breite wird anhand des XYAH-Seitenverhältnisses skaliert). |
dampen_motion_occ | 0.0-1.0 | Multiplikator für die Geschwindigkeit während einer Verdeckung. Niedrigere Werte lassen die Spur während der Verdeckung „langsamer werden“. |
active_occ_to_lost_thresh | >=1 | Maximale Anzahl aufeinanderfolgender verdeckter Bilder, bevor eine aktive Spur in den Status „verloren“ wechselt. |
occ_cover_thresh | 0.0-1.0 | Anteil der Fläche einer Spur, die von einer anderen aktiven Spur bedeckt wird, ab dem eine Verdeckung angenommen wird. |
occ_reappear_window | >=0 | Anzahl der Bilder, während derer eine kürzlich verdeckte, verlorene Spur bevorzugt wiedergefunden werden kann. |
init_iou_suppress | 0.0-1.0 | Unterdrückt die Initialisierung einer neuen Spur, wenn ihre IoU mit einer beliebigen aktiven Spur diesen Wert überschreitet. Auf 1.0 setzen, um die Funktion zu deaktivieren. |
Hinweise zur Abstimmung:
- Häufige teilweise Verdeckungen:
occ_cover_threshsenken (z. B. auf0.5-0.6). - Doppelte IDs bei Überschneidungen:
init_iou_suppresssenken (z. B. auf0.5). - Lange Verdeckungen:
occ_reappear_windowundtrack_buffergemeinsam erhöhen. - Sich schnell bewegende Ziele:
dampen_motion_occerhöhen (näher an1.0);enlarge_bbox_occnur erhöhen, wenn ein größerer Suchbereich die Wiedererkennung verbessert.
TrackTrack#
TrackTrack (Shim et al., CVPR 2025) ist der Standard-Tracker. Er bewertet Zuordnungen aus der Perspektive jeder einzelnen Spur anhand mehrerer Kriterien und iterativer Zuordnung:
- Zuordnung aus der Spurperspektive (TPA): kombiniert HMIoU, optional den Kosinusabstand für ReID, den Konfidenzprojektionsabstand und den Eckwinkelabstand. Die Zuordnung wird iterativ mit einem schrittweise gelockerten Schwellenwert berechnet.
- Spurbewusste Initialisierung (TAI): unterdrückt doppelte neue Spuren, bevor eine neue ID erstellt wird.
Am besten geeignet für: überfüllte Szenen mit häufigen Verdeckungen, in denen doppelte IDs ein Problem darstellen.
TrackTrack-spezifische Argumente:
| Parameter | Gültige Werte oder Bereiche | Beschreibung |
|---|---|---|
iou_weight | 0.0-1.0 | Gewichtung des HMIoU-Abstands, wenn ReID aktiviert ist; andernfalls wird HMIoU direkt verwendet. |
reid_weight | 0.0-1.0 | Gewichtung des Kosinusabstands für ReID, wenn ReID aktiviert ist; andernfalls wird er ignoriert. |
conf_weight | 0.0-1.0 | Gewichtung des Konfidenzprojektionsabstands. |
angle_weight | 0.0-1.0 | Gewichtung des Eckwinkelabstands. |
penalty_p | 0.0-1.0 | Kostenstrafe für Erkennungen mit geringer Konfidenz. |
penalty_q | 0.0-1.0 | Kostenstrafe für Erkennungen, die durch sekundäres NMS wiederhergestellt wurden. |
reduce_step | 0.0-1.0 | Lockerung des Zuordnungsschwellenwerts pro Iteration. |
tai_thr | 0.0-1.0 | IoU-Schwellenwert für das NMS der spurbewussten Initialisierung. |
min_track_len | >=0 | Mindestlänge des Verlaufs, bevor eine neue Spur bestätigt wird. |
lost_match_thr | 0.0-1.0 | Weniger strenge Kostenschranke für den gelockerten Durchlauf zur erneuten Zuordnung verlorener Spuren; 0 deaktiviert diese Funktion. |
with_reid | True, False | Aktiviert den Abgleich des Erscheinungsbilds anhand des Kosinusabstands für ReID (verwendet native YOLO-Merkmale). Standardmäßig deaktiviert. |
model | auto oder kompatibler Pfad zu einem ReID-Modell | auto verwendet, sofern verfügbar, native YOLO-Merkmale; benutzerdefinierte Modelle können .pt-Checkpoints oder kompatible Exporte sein. |
gmc_method | sparseOptFlow, orb, sift, ecc, none | Methode zum Ausgleich globaler Bewegungen. |
Hinweise zur Abstimmung:
- Viele Fußgänger:
tai_thrsenken (z. B. auf0.45), um mehr doppelte neue Spuren zu unterdrücken;track_bufferfür längere Verdeckungen erhöhen. - Schnelle Kamerabewegungen:
gmc_method: sparseOptFlowaktiviert lassen. - Kleine/schnelle Objekte:
angle_weightleicht erhöhen undmin_track_lensenken. - ReID nur bei Bedarf aktivieren: Es erhöht den Inferenzaufwand; bei kurzen Verdeckungen reichen die standardmäßigen Kosten für mehrere Kriterien normalerweise aus.
Bei Segmentierungs- und Pose-Modellen überspringt TrackTrack die Erkennungswiederherstellung mit gelockertem NMS, damit Masken und Schlüsselpunkte weiterhin zu den Erkennungen passen.
Python-Beispiele#
Sieh dir an: So erstellst du interaktives Objekt-Tracking mit Ultralytics YOLO26: In wenigen Minuten umsetzen | Python!
Schleife mit persistenten Spuren#
Hier ist ein Python-Skript, das OpenCV (cv2) und YOLO26 verwendet, um Objekte in Videobildern zu verfolgen. Das Skript setzt voraus, dass die erforderlichen Pakete (opencv-python und ultralytics) bereits installiert sind. Mit dem Argument persist=True wird dem Tracker mitgeteilt, dass das aktuelle Bild bzw. Videobild das nächste in einer Sequenz ist und dass im aktuellen Bild Spuren aus dem vorherigen Bild erwartet werden sollen.
Verwende persist=True nur, wenn du aufeinanderfolgende Bilder desselben Videostreams an model.track() übergibst. So kann der Tracker den Zustand früherer Bilder wiederverwenden und die Spuren-IDs im Zeitverlauf beibehalten. Verwende persist=True nicht für voneinander unabhängige Bilder oder einen anderen Stream, da der vorherige Spurenstatus übernommen werden kann.
Du kannst auch ein Tracker-Backend auswählen, indem du eine Tracker-Konfigurationsdatei übergibst, zum Beispiel tracker="botsort.yaml", tracker="bytetrack.yaml" oder tracker="tracktrack.yaml".
import cv2

from ultralytics import YOLO

# YOLO26-Modell laden
model = YOLO("yolo26n.pt")

# Videodatei öffnen
video_path = "path/to/video.mp4"
cap = cv2.VideoCapture(video_path)

# Videobilder durchlaufen
while cap.isOpened():
    # Ein Videobild einlesen
    success, frame = cap.read()

    if success:
        # YOLO26-Tracking auf dem Bild ausführen und Spuren zwischen Bildern beibehalten
        # und das BoT-SORT-Tracker-Backend verwenden
        results = model.track(frame, persist=True, tracker="botsort.yaml")

        # Ergebnisse auf dem Bild visualisieren
        annotated_frame = results[0].plot()

        # Annotiertes Bild anzeigen
        cv2.imshow("YOLO26 Tracking", annotated_frame)

        # Schleife beenden, wenn „q“ gedrückt wird
        if cv2.waitKey(1) & 0xFF == ord("q"):
            break
    else:
        # Schleife beenden, wenn das Video zu Ende ist
        break

# Videoaufnahmeobjekt freigeben und Anzeigefenster schließen
cap.release()
cv2.destroyAllWindows()
Beachte die Änderung von model(frame) zu model.track(frame), durch die Objekt-Tracking anstelle einfacher Erkennung aktiviert wird. Dieses geänderte Skript führt den Tracker für jedes Videobild aus, visualisiert die Ergebnisse und zeigt sie in einem Fenster an. Mit der Taste 'q' kannst du die Schleife beenden.
Spuren im Zeitverlauf darstellen#
Die Visualisierung von Objektspuren über aufeinanderfolgende Videobilder hinweg kann wertvolle Einblicke in Bewegungsmuster und Verhalten erkannter Objekte geben. Mit Ultralytics YOLO26 lassen sich diese Spuren einfach darstellen.
Das folgende Beispiel verwendet YOLO26-Tracking, um die Bewegung erkannter Objekte über mehrere Videobilder hinweg darzustellen. Das Skript öffnet eine Videodatei, liest sie Bild für Bild ein und verwendet das YOLO-Modell, um Objekte zu erkennen und zu verfolgen. Es speichert die Mittelpunkte der erkannten Begrenzungsrahmen und verbindet sie miteinander, um die von den verfolgten Objekten zurückgelegten Pfade einzuzeichnen.
from collections import defaultdict

import cv2
import numpy as np

from ultralytics import YOLO

# YOLO26-Modell laden
model = YOLO("yolo26n.pt")

# Videodatei öffnen
video_path = "path/to/video.mp4"
cap = cv2.VideoCapture(video_path)

# Spurenverlauf speichern
track_history = defaultdict(list)

# Videobilder durchlaufen
while cap.isOpened():
    # Ein Videobild einlesen
    success, frame = cap.read()

    if success:
        # YOLO26-Tracking auf dem Bild ausführen und Spuren zwischen Bildern beibehalten
        result = model.track(frame, persist=True)[0]

        # Begrenzungsrahmen und Spuren-IDs abrufen
        if result.boxes and result.boxes.is_track:
            boxes = result.boxes.xywh.cpu()
            track_ids = result.boxes.id.int().cpu().tolist()

            # Ergebnis auf dem Bild visualisieren
            frame = result.plot()

            # Spuren darstellen
            for box, track_id in zip(boxes, track_ids):
                x, y, w, h = box
                track = track_history[track_id]
                track.append((float(x), float(y)))  # Mittelpunkt x, y
                if len(track) > 30:  # 30 Spuren für 30 Bilder beibehalten
                    track.pop(0)

                # Tracking-Linien zeichnen
                points = np.hstack(track).astype(np.int32).reshape((-1, 1, 2))
                cv2.polylines(frame, [points], isClosed=False, color=(230, 230, 230), thickness=10)

        # Annotiertes Bild anzeigen
        cv2.imshow("YOLO26 Tracking", frame)

        # Schleife beenden, wenn „q“ gedrückt wird
        if cv2.waitKey(1) & 0xFF == ord("q"):
            break
    else:
        # Schleife beenden, wenn das Video zu Ende ist
        break

# Videoaufnahmeobjekt freigeben und Anzeigefenster schließen
cap.release()
cv2.destroyAllWindows()
Mehrthreadiges Tracking#
Multithreaded Tracking ermöglicht es, Objekt-Tracking gleichzeitig auf mehreren Videostreams auszuführen. Das ist besonders nützlich, wenn mehrere Videoeingaben verarbeitet werden, etwa von mehreren Überwachungskameras, da die parallele Verarbeitung den Durchsatz erhöht.
Das folgende Python-Skript verwendet das Python-Modul threading, um mehrere Tracker-Instanzen gleichzeitig auszuführen. Jeder Thread führt den Tracker für eine Videoquelle aus, und alle Threads laufen gleichzeitig im Hintergrund.
Damit jeder Thread die richtigen Parameter erhält (das zu verwendende Modell und die Videoquelle), definiert das Skript eine Funktion run_tracker_in_thread, die diese Parameter entgegennimmt und die Hauptverfolgungsschleife enthält. Diese Funktion liest das Video Bild für Bild ein, führt den Tracker aus und speichert die annotierten Ergebnisse.
In diesem Beispiel werden zwei verschiedene Modelle verwendet, yolo26n.pt und yolo26n-seg.pt. Jedes verfolgt Objekte in einer anderen Quelle: einer lokalen Videodatei und einer Webcam. Die Quellen sind in SOURCES angegeben.
Der Parameter daemon=True in threading.Thread bedeutet, dass diese Threads geschlossen werden, sobald das Hauptprogramm beendet ist. Anschließend starten wir die Threads mit start() und verwenden join(), damit der Hauptthread wartet, bis beide Tracker-Threads abgeschlossen sind.
Sobald alle Threads ihre Aufgabe abgeschlossen haben, werden die Fenster mit den Ergebnissen mithilfe von cv2.destroyAllWindows() geschlossen.
import threading

import cv2

from ultralytics import YOLO

# Modellnamen und Videoquellen festlegen
MODEL_NAMES = ["yolo26n.pt", "yolo26n-seg.pt"]
SOURCES = ["path/to/video.mp4", "0"]  # lokales Video, 0 für Webcam

def run_tracker_in_thread(model_name, filename):
    """Run YOLO tracker in its own thread for concurrent processing.

    Args:
        model_name (str): Model checkpoint name or path loaded inside the thread.
        filename (str): The path to the video file or the identifier for the webcam/external camera source.
    """
    model = YOLO(model_name)
    results = model.track(filename, save=True, stream=True)
    for r in results:
        pass

# Tracker-Threads mit einer for-Schleife erstellen und starten
tracker_threads = []
for video_file, model_name in zip(SOURCES, MODEL_NAMES):
    thread = threading.Thread(target=run_tracker_in_thread, args=(model_name, video_file), daemon=True)
    tracker_threads.append(thread)
    thread.start()

# Warten, bis alle Tracker-Threads abgeschlossen sind
for thread in tracker_threads:
    thread.join()

# Aufräumen und Fenster schließen
cv2.destroyAllWindows()
Dieses Beispiel lässt sich leicht auf weitere Videodateien und Modelle erweitern, indem du zusätzliche Threads erstellst und dieselbe Methode anwendest.
Neue Tracker beitragen#
Wenn du einen Multi-Objekt-Tracking-Algorithmus für Ultralytics YOLO implementiert oder angepasst hast, kannst du ihn gerne zu ultralytics/trackers beitragen, zusammen mit einer passenden Konfiguration in ultralytics/cfg/trackers. Trage ihn bei, um die Tracking-Optionen für die gesamte Community zu erweitern.
Häufig gestellte Fragen#
Beim Multi-Objekt-Tracking in der Videoanalyse werden Objekte erkannt und jedem erkannten Objekt über mehrere Videobilder hinweg eine eindeutige ID zugeordnet. Ultralytics YOLO unterstützt dies durch Tracking in Echtzeit und Objekt-IDs, was Aufgaben wie Sicherheitsüberwachung und Sportanalysen ermöglicht. Das System verwendet Tracker wie BoT-SORT, ByteTrack, OC-SORT, Deep OC-SORT, FastTracker und TrackTrack, die sich über YAML-Dateien konfigurieren lassen.
Nein. In Standarddateien von Ultralytics mit der Endung
.ptsind die Gewichte des YOLO-Modells gespeichert, während der Tracker zur Inferenzzeit vonmodel.track()erstellt wird. Spuren-IDs hängen vom Zustand des Trackers über aufeinanderfolgende Bilder hinweg ab. Ein einzelnes Bild kann daher Erkennungen wie Begrenzungsrahmen, Klassen und Konfidenzwerte liefern, aber für sich genommen keine aussagekräftigen, persistenten Tracking-IDs erzeugen.Packe für die Bereitstellung den Detektor und den Tracker gemeinsam in deine Anwendung und rufe
model.track()für jedes Bild einzeln mitpersist=Trueauf, wenn die Bilder aus demselben Videostream stammen. Verwende für voneinander unabhängige Streams separate Modell- oder Tracker-Instanzen, damit der Zustand nicht zwischen Videos übernommen wird.Du kannst einen benutzerdefinierten Tracker konfigurieren, indem du eine vorhandene Tracker-Konfigurationsdatei (z. B.
custom_tracker.yaml) aus dem Konfigurationsverzeichnis für Ultralytics-Tracker kopierst und die Parameter nach Bedarf änderst, mit Ausnahme vontracker_type. Verwende diese Datei in deinem Tracking-Modell wie folgt:Beispielfrom ultralytics import YOLO model = YOLO("yolo26n.pt") results = model.track(source="https://youtu.be/LNwODJXcvt4", tracker="custom_tracker.yaml")Um Objekte gleichzeitig in mehreren Videostreams zu verfolgen, kannst du das Modul
threadingvon Python verwenden. Jeder Thread verarbeitet einen separaten Videostream. So kannst du vorgehen:Mehrthreadiges Trackingimport threading import cv2 from ultralytics import YOLO # Modellnamen und Videoquellen festlegen MODEL_NAMES = ["yolo26n.pt", "yolo26n-seg.pt"] SOURCES = ["path/to/video.mp4", "0"] # lokales Video, 0 für Webcam def run_tracker_in_thread(model_name, filename): """Run YOLO tracker in its own thread for concurrent processing. Args: model_name (str): Model checkpoint name or path loaded inside the thread. filename (str): The path to the video file or the identifier for the webcam/external camera source. """ model = YOLO(model_name) results = model.track(filename, save=True, stream=True) for r in results: pass # Tracker-Threads mit einer for-Schleife erstellen und starten tracker_threads = [] for video_file, model_name in zip(SOURCES, MODEL_NAMES): thread = threading.Thread(target=run_tracker_in_thread, args=(model_name, video_file), daemon=True) tracker_threads.append(thread) thread.start() # Warten, bis alle Tracker-Threads abgeschlossen sind for thread in tracker_threads: thread.join() # Aufräumen und Fenster schließen cv2.destroyAllWindows()Multi-Objekt-Tracking mit Ultralytics YOLO lässt sich vielseitig einsetzen, zum Beispiel für:
- Verkehr: Fahrzeugverfolgung für Verkehrsmanagement und autonomes Fahren.
- Einzelhandel: Personenverfolgung für Analysen im Geschäft und Sicherheitsanwendungen.
- Aquakultur: Fischverfolgung zur Überwachung aquatischer Umgebungen.
- Sportanalysen: Verfolgung von Spielern und Ausrüstung zur Leistungsanalyse.
- Sicherheitssysteme: Überwachung verdächtiger Aktivitäten und Erstellung von Sicherheitsalarmen.
Diese Anwendungen profitieren von der Fähigkeit von Ultralytics YOLO, Videos mit hoher Bildrate in Echtzeit und mit hoher Genauigkeit zu verarbeiten.
Um Objektspuren über mehrere Videobilder hinweg zu visualisieren, kannst du die Tracking-Funktionen des YOLO-Modells zusammen mit OpenCV verwenden, um die Wege erkannter Objekte einzuzeichnen. Das folgende Beispielskript zeigt, wie das geht:
Spuren über mehrere Videobilder hinweg darstellenfrom collections import defaultdict import cv2 import numpy as np from ultralytics import YOLO model = YOLO("yolo26n.pt") video_path = "path/to/video.mp4" cap = cv2.VideoCapture(video_path) track_history = defaultdict(list) while cap.isOpened(): success, frame = cap.read() if success: result = model.track(frame, persist=True)[0] annotated_frame = result.plot() if result.boxes and result.boxes.is_track: boxes = result.boxes.xywh.cpu() track_ids = result.boxes.id.int().cpu().tolist() for box, track_id in zip(boxes, track_ids): x, y, w, h = box track = track_history[track_id] track.append((float(x), float(y))) if len(track) > 30: track.pop(0) points = np.hstack(track).astype(np.int32).reshape((-1, 1, 2)) cv2.polylines(annotated_frame, [points], isClosed=False, color=(230, 230, 230), thickness=10) cv2.imshow("YOLO26 Tracking", annotated_frame) if cv2.waitKey(1) & 0xFF == ord("q"): break else: break cap.release() cv2.destroyAllWindows()Dieses Skript stellt Tracking-Linien dar, die die Bewegungswege der verfolgten Objekte im Zeitverlauf zeigen und wertvolle Einblicke in ihr Verhalten und ihre Muster liefern.


Kommentare679
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
bhaskar2443053
I’m using YOLO-Pose to detect and track people throughout ~1-hour videos and need each person to keep the same ID. I already have high-quality ground-truth tracks from a SAM-based tracker.
Do you have a script that can fine-tune YOLO-Pose (and its tracker/Re-ID parameters) against this ground truth to squeeze out the best IDF1 or HOTA scores ?
1maxexplorer
Hi!
Thank you for your great work on YOLO and tracking integration. We are using YOLO with ByteTrack/BoT-SORT for object counting and tracking and want to improve ID stability.
-
We notice that sometimes, even when the object visually looks the same and the scene and motion are stable, the track_id changes. What parameters or reasons should we check to understand why the ID changes unexpectedly?
-
Is the match_thresh parameter based on IoU, and is it possible to print or visualize the IoU used during matching for debugging?
-
Is there a way to output Kalman-predicted boxes of lost tracks so we can analyze them?
-
Could increasing the video FPS improve tracking and IoU consistency, or is this mainly related to detection stability and parameter tuning?
-
Does ByteTrack or BoT-SORT use a min_hits parameter before confirming tracks, or are tracks confirmed immediately after creation?
-
If a track is lost, can a new ID only be assigned on the second frame after reappearance if conf > new_track_thresh and then conf > track_high_thresh, or can it happen immediately on the first detection?
-
Is the track_buffer parameter the number of frames a track is kept using Kalman prediction after it is lost before being deleted?
-
Do you have any tips to improve tracking stability and avoid unnecessary ID switches?
Thank you for your support!
-
 Glenn JocherUltralytics
@bhaskar2443053 currently there isn't a built-in script for fine-tuning YOLO-Pose tracking parameters against ground truth. You would need to implement custom evaluation using libraries like TrackEval or MOTChallenge to compute IDF1/HOTA scores and optimize tracker parameters iteratively.
@maxexplorer great questions about tracking stability! Here are the key points:
-
ID changes typically occur due to low IoU between predicted and detected boxes, occlusions, or threshold mismatches. Check
track_high_threshandmatch_threshin your tracker config. -
match_threshis indeed IoU-based. For debugging, you can add logging to the tracker code, but there's no built-in visualization. -
Kalman predictions aren't directly exposed, but you can access them by modifying the tracker implementation.
-
Higher FPS generally improves tracking by reducing inter-frame motion, making associations more reliable.
-
Both trackers use confirmation logic - tracks need to meet certain criteria before being confirmed as valid tracks.
-
New tracks can be assigned immediately if detection confidence exceeds
new_track_thresh. -
Correct -
track_buffermaintains lost tracks for that many frames using prediction. -
For stability: increase
track_buffer, adjustmatch_threshbased on your scenario, and ensure consistent detection quality with appropriateconfthresholds.
For detailed parameter tuning, refer to the tracker configuration files and our tracking documentation.
-
rohith-aiunika(bearbeitet)
Hi YOLO Team, I've been using the following Python script to track objects with my YOLOv8 model: from ultralytics import YOLO
model = YOLO(r"/home/best_pt_files/v1.0.2.pt") results = model.track(r"/home/video.MP4", save=False, stream=False)
However, I noticed that my GPU memory usage gradually increases, leading to an "out of memory" error before the video finishes processing. Interestingly, when I use the following command from the terminal, the entire video tracks successfully without excessive GPU memory consumption: yolo track model=/home/best_pt_files/1.0.2.pt source=/home/video.MP4
Previously, the Python script worked without any issues. The memory issue has only recently started occurring. Could you please help me understand the possible reasons for this memory increase and how to address it?
i have experimented with persist= True and False,stream = true and false, show = true and false also but the issue is still there
1- Glenn JocherUltralytics
@rohith-aiunika thanks for reporting this. The memory buildup in Python scripts (but not CLI) typically occurs when not using streaming mode. To match the CLI's memory behavior, modify your Python script to process frames iteratively using
stream=True:from ultralytics import YOLO model = YOLO("/home/best_pt_files/v1.0.2.pt") for result in model.track("/home/video.MP4", stream=True): # Process frames iteratively pass # Add your frame processing logic hereThis streams frames sequentially like the CLI, preventing memory accumulation. For more details, see the streaming implementation in our Tracking documentation. Let us know if this resolves the issue!
i have used stream = True, then the code is just executing without showing error and without tracking also
- Glenn JocherUltralytics
@rohith-aiunika thanks for the update. Let's ensure you're properly iterating through streaming results. Try adding a processing loop like this:
for result in model.track(source=video_path, stream=True):
    annotated_frame = result[0].plot()
    cv2.imshow('Tracking', annotated_frame)
    if cv2.waitKey(1) == ord('q'):
        break
This actively processes each frame and displays tracking annotations. If issues persist, you might need to verify your video source format using our supported inference sources documentation.
mwasela
Hello, Made a custom model that i can successfully run and with a well tweaked confidence filter, am getting good results.
Now Ive wrapped the classification and tracking functionality into a flask app, that returns the count ID's when accessed by a REST call like get, meaning it can be accessed by a separate app for processing and stuff. I want to be able to reset the counting through some other request. My camera feed is always live, i need a way to reset the track id's to zero when neccessary, they just keep counting until i exit the program.
1- Glenn JocherUltralytics
@mwasela hello,
It's great to hear that your custom model is performing well. To reset the tracking IDs in your Flask app, you can implement a mechanism to reinitialize the tracker state upon receiving a specific request. This can be done by resetting the tracker object or reloading the model within your tracking function.
For more detailed guidance on configuring and using trackers, please refer to our documentation: Multi-Object Tracking with Ultralytics YOLO.
Orziqulov-Javohir
I really need help to do this programm: I wanna select region via mouse "dangerous zone" Track detected person, If person enters this zone crop and save person's photo Can you show me pls how to do it for 10 cameras, my gpu is RTX 3080TI
1It is kind a security program detecting who entered zone
1import cv2 from ultralytics import YOLO import time
Load the YOLOv8 model
model = YOLO("yolov8n.pt") # pretrained YOLOv8n model
Initialize video capture for multiple cameras
camera_ids = [
'rtsp://admin:admin12345@172.17.67.20:554',
'rtsp://admin:admin12345@172.17.67.16:554', 'rtsp://admin:admin12345@172.17.67.18:554', 'rtsp://admin:admin12345@172.17.67.19:554', 'rtsp://admin:admin12345@172.17.67.17:554', 'rtsp://admin:admin12345@172.17.67.21:554', 'rtsp://admin:admin12345@172.17.67.17:554', 'rtsp://admin:admin12345@172.17.67.21:554', 'rtsp://admin:admin12345@172.17.67.17:554',
]caps = [cv2.VideoCapture(camera_id) for camera_id in camera_ids]
Open the video file
roi_start = [(0, 0)] * len(caps) roi_end = [(0, 0)] * len(caps) drawing = [False] * len(caps)
tracked_persons = [[] for _ in range(len(caps))] # List to track persons in dangerous zones
def draw_rectangle(event, x, y, flags, param): global roi_start, roi_end, drawing idx = param # Use param to identify the camera index if event == cv2.EVENT_LBUTTONDOWN: drawing[idx] = True roi_start[idx] = (x, y) roi_end[idx] = (x, y) print(f"Camera {idx}: Started drawing rectangle at: {roi_start[idx]}") elif event == cv2.EVENT_MOUSEMOVE: if drawing[idx]: roi_end[idx] = (x, y) print(f"Camera {idx}: Updated rectangle end to: {roi_end[idx]}") elif event == cv2.EVENT_LBUTTONUP: drawing[idx] = False roi_end[idx] = (x, y) print(f"Camera {idx}: Finished drawing rectangle at: {roi_end[idx]}")
Create a window and set mouse callback for each camera
for idx in range(len(caps)): window_name = f'Video {idx}' cv2.namedWindow(window_name) cv2.setMouseCallback(window_name, draw_rectangle, idx)
def is_inside_roi(x, y, roi_start, roi_end): x1, y1 = roi_start x2, y2 = roi_end return min(x1, x2) <= x <= max(x1, x2) and min(y1, y2) <= y <= max(y1, y2)
while True: frames = [] for cap in caps: ret, frame = cap.read() if not ret: continue # frame = cv2.resize(frame, (640, 480)) frames.append(frame)
for idx, frame in enumerate(frames):
    window_name = f'Video {idx}'

    # Draw the ROI rectangle on the frame
    if drawing[idx] or roi_start[idx] != roi_end[idx]:
        cv2.rectangle(frame, roi_start[idx], roi_end[idx], (0, 255, 0), 2)
        cv2.putText(frame, "Dangerous Zone", (roi_start[idx][0], roi_start[idx][1] - 10), cv2.FONT_HERSHEY_SIMPLEX, 0.9, (0, 255, 0), 2)

    # Run YOLOv8 tracking on the frame, persisting tracks between frames
    results = model.track(frame, tracker="bytetrack.yaml", persist=True)

    for result in results:
        boxes = result.boxes

        for box in boxes:
            x1, y1, x2, y2 = box.xyxy.tolist()[0][:4]
            cls = box.cls.tolist()[0]
            if cls == 0:  # Person class in COCO dataset
                # Check if the center of the person is inside the ROI
                cx, cy = int((x1 + x2) / 2), int((y1 + y2) / 2)
                if is_inside_roi(cx, cy, roi_start[idx], roi_end[idx]):
                    # Check if this person is already tracked
                    person_id = box.id.tolist()[0] if box.id is not None else None

                    if person_id not in tracked_persons[idx]:
                        tracked_persons[idx].append(person_id)
                        # Crop and save the frame
                        crop = frame[int(y1):int(y2), int(x1):int(x2)]
                        cv2.imwrite(f"cropped_camera{idx}_person{person_id}_{int(time.time())}.jpg", crop)
                        # Draw a label on the person
                        cv2.putText(frame, "Person in Dangerous Zone", (int(x1), int(y1) - 10), cv2.FONT_HERSHEY_SIMPLEX, 0.9, (0, 0, 255), 2)
                        cv2.rectangle(frame, (int(x1), int(y1)), (int(x2), int(y2)), (0, 0, 255), 2)

    cv2.imshow(window_name, frame)

if cv2.waitKey(1) & 0xFF == ord('q'):
    break
Release all video captures
for cap in caps: cap.release() cv2.destroyAllWindows()
- Glenn JocherUltralytics
Your approach looks solid for setting up a security program to track and save images of individuals entering a designated "dangerous zone" across multiple cameras. To enhance your implementation, ensure you're using the latest versions of the Ultralytics package for optimal performance and bug fixes. For more detailed guidance on tracking configurations and additional features, you can refer to the Ultralytics tracking documentation. If you encounter any specific issues or need further assistance, feel free to ask!
mariem158
File "", line 91 results = model.track(frame, persist=True, tracker="botsort.yaml") ^ IndentationError: unexpected indent COMMENT CORRIGER CETTE ERREUR
- Glenn JocherUltralytics
The error you're encountering is due to an unexpected indent in your code. Ensure that the indentation is consistent throughout your script. If the issue persists, please verify it with the latest version of the Ultralytics package. For more details on tracking configurations, you can refer to the Ultralytics tracking documentation.
GKYoffice
How can I get the tracking metrics of a tracker such as MOTA, IDF1, etc.
1Can I set the parameter ''save_txt'' to True in the track function, and then write code to evaluate the tracking data?
 Paula DerrengerUltralytics
Currently, the Ultralytics YOLO framework doesn't provide built-in functionality for computing tracking metrics like MOTA or IDF1 directly through the API or command line. However, you can utilize external libraries such as MOTChallenge eval for calculating these metrics.
After running your tracking with YOLOv8, you'd typically export your tracking results in a format compatible with these libraries (usually a
.txtformat with frame ID, object ID, bounding boxes, etc.). Then, use the external library to compute the desired metrics by providing it with both the ground truth and your results file.Here's a generic example on how you might save tracking results (modify based on your actual use case):
from ultralytics import YOLO

# Initialize and load your model
model = YOLO("path/to/your/model.pt")

# Tracking
results = model.track(source='path/to/video.mp4', save_txt=True, project='runs/track', name='exp')

# results are saved in 'runs/track/exp' in a format that can be used with MOTChallenge eval tools
Afterwards, follow the documentation of the MOTChallenge eval toolkit to compute the metrics using the outputs stored in
'runs/track/exp'.If you encounter any specific issues while implementing this, feel free to ask!🛠️
AdadAlShabab
Can I run two models simultaneously in one video? Ex: model = YOLO('E:/Ultralytics/best.pt') model = YOLO('yolov8m-pose.pt') results = model.track(source="file.mp4", show=True, conf=0.3, save=False) results = model.track(source="file.mp4", show=True, conf=0.3, save=False)
I want that two models will works simultaneously with cumulative results? Is it possible? Please let me know. Thanks in advance!!
1- Paula DerrengerUltralytics
@AdadAlShabab yes, you can run two models simultaneously on one video, but you'll need to manage the inference in a way that allows both models to process the video frames concurrently. Here's a simplified example using threading to achieve this:
import threading
from ultralytics import YOLO

# Load the models
model1 = YOLO('E:/Ultralytics/best.pt')
model2 = YOLO('yolov8m-pose.pt')

# Function to run tracking
def track_video(model, source, conf, show, save):
    results = model.track(source=source, show=show, conf=conf, save=save)
    # Process results here or return them

# Create threads for each model
thread1 = threading.Thread(target=track_video, args=(model1, "file.mp4", 0.3, True, False))
thread2 = threading.Thread(target=track_video, args=(model2, "file.mp4", 0.3, True, False))

# Start the threads
thread1.start()
thread2.start()

# Wait for both threads to finish
thread1.join()
thread2.join()
This script will run both models in separate threads. If you want to combine the results from both models, you'll need to implement a mechanism to synchronize and merge the results from both threads. Keep in mind that displaying the results (
show=True) from two threads might not work as expected, and you might need to handle the visualization separately.Remember to handle the GPU memory usage carefully, as running two models simultaneously will require more memory. If you encounter any issues, consider running the models sequentially or on separate GPUs if available.
4
Journey2-20
Hello I'm newer to Opencv and I'm trying to run a tracking camera for airsoft. How would i select specific bounding boxes?
- Paula DerrengerUltralytics
Use
model.track(frame, persist=True)and inspectresults[0].boxes.xyxywithresults[0].boxes.id; select the box containing your OpenCV mouse-click coordinates, store its track ID, then process or draw only boxes whoseboxes.idmatches that ID. Feel free to continue posting questions here so the Ultralytics team can help.
yashpatel2010
In my jetson orin nano super developer kit with jetpack6.1 and deepstream7.1 i want to do cross camera person tracking. Is there any default way in deepstream configs to do it? Or any other lightweight thing that can be easily doable in jetson orin nano 8 gb super dev kit.
- Glenn JocherUltralytics
Ultralytics
trackis single-camera MOT, so cross-camera person IDs are not built in; on DeepStream 7.1 the practical Orin Nano path isNvDeepSORT/ReID per stream plus downstream association from the exported embeddings described in the DeepStreamgst-nvtrackerdocs, or NVIDIA’s separate Multi-Camera Tracking workflow for full MTMC. Please keep the details here in Discussions and share your current tracker config if you want a minimal setup suggestion. (docs.nvidia.com)
anvi97(bearbeitet)
Hi @glenn-jocher,
I am building a road surface detection system using YOLO segmentation.
My pipeline:
Apply bird eye view using cv2.getPerspectiveTransform()
Mask only road area
Detect potholes, zebra crossings, and speed bumps
I am facing the following issues:
1️⃣ Overlapping Potholes Not Merging Properly
I want overlapping potholes to merge into one bounding box.
In many cases it works, but sometimes:
Two boxes are still shown for the same pothole
Even when they overlap visually
I am using YOLO with:
results = model(frame, conf=0.45, iou=0.4)
Is YOLO’s internal NMS preventing full merging? Should I apply custom merging after inference? Is segmentation-based merging better than bounding box merging for potholes?
2️⃣ Object Size Changing After Bird Eye View
I calculate pothole size using:
pixels_per_foot = 220
But I selected this value randomly (no real-world measurement).
Because of this:
Object size changes depending on frame position
Same pothole appears different size
Is it correct that without real-world calibration, size cannot be accurate? What is the correct method to calculate real-world size in a monocular dashcam setup?
3️⃣ Zebra Crossing vs Black–White Speed Bump Confusion
Black–white speed bumps are getting confused with zebra crossings because both have parallel white-black stripes.
Currently I am detecting only yellow speed bumps to avoid confusion.
What is the better approach to separate them?
Use segmentation instead of boxes?
Add geometry-based filtering?
Train with more hard-negative examples?
this is my code ..... from ultralytics import YOLO import cv2 import numpy as np
model = YOLO("runs/segment/pothole_seg_model3/weights/best.pt") pixels_per_foot = 220
video_path = "sample_video.mp4" cap = cv2.VideoCapture(video_path)
if not cap.isOpened(): print(" Cannot open video") exit()
width = int(cap.get(cv2.CAP_PROP_FRAME_WIDTH)) height = int(cap.get(cv2.CAP_PROP_FRAME_HEIGHT)) fps = cap.get(cv2.CAP_PROP_FPS) or 25.0
fourcc = cv2.VideoWriter_fourcc(*'avc1') out = cv2.VideoWriter("pothole5.mp4", fourcc, fps, (width, height))
STRETCH_AMOUNT = 50
src = np.float32([ [0, height],
[width, height],
[922, 183],
[265, 183]
])dst = np.float32([ [0, height], [width, height], [width + STRETCH_AMOUNT, 0], [0 - STRETCH_AMOUNT, 0] ])
matrix = cv2.getPerspectiveTransform(src, dst) def compute_iou(box1, box2): x1 = max(box1[0], box2[0]) y1 = max(box1[1], box2[1]) x2 = min(box1[2], box2[2]) y2 = min(box1[3], box2[3])
inter_area = max(0, x2 - x1) * max(0, y2 - y1)

box1_area = (box1[2] - box1[0]) * (box1[3] - box1[1])
box2_area = (box2[2] - box2[0]) * (box2[3] - box2[1])

union = box1_area + box2_area - inter_area

if union == 0:
    return 0

return inter_area / union
def should_merge(box1, box2, iou_thresh=0.1, dist_thresh=150): # Containment check - if one box is inside the other if (box1[0] >= box2[0] and box1[1] >= box2[1] and box1[2] <= box2[2] and box1[3] <= box2[3]): return True if (box2[0] >= box1[0] and box2[1] >= box1[1] and box2[2] <= box1[2] and box2[3] <= box1[3]): return True
iou = compute_iou(box1, box2)
if iou > iou_thresh:
    return True

cx1, cy1 = (box1[0]+box1[2])/2, (box1[1]+box1[3])/2
cx2, cy2 = (box2[0]+box2[2])/2, (box2[1]+box2[3])/2

if np.sqrt((cx1-cx2)**2 + (cy1-cy2)**2) < dist_thresh:
    return True

return False
while True: ret, frame = cap.read() if not ret: break
bird_eye = cv2.warpPerspective(frame, matrix, (width, height))

results = model(bird_eye, conf=0.45, iou=0.4)[0]
annotated = results.plot()

if results.boxes is not None:
    for box in results.boxes:
        cls_id = int(box.cls.item())

        if cls_id == 0:  # pothole only
            x1, y1, x2, y2 = map(int, box.xyxy.cpu().numpy()[0])

            w_px = x2 - x1
            h_px = y2 - y1

            w_ft = w_px / pixels_per_foot
            h_ft = h_px / pixels_per_foot

            label = f"{w_ft:.2f}ft x {h_ft:.2f}ft"

            cv2.putText(
                annotated,
                label,
                (x1, y1 - 15),
                cv2.FONT_HERSHEY_SIMPLEX,
                0.6,
                (0, 255, 255),
                2
            )

cv2.imshow("Bird Eye + Pothole Detection", annotated)
out.write(annotated)

if cv2.waitKey(1) & 0xFF == 27:
    break
cap.release() out.release() cv2.destroyAllWindows()
- Glenn JocherUltralytics
For (1), YOLO’s NMS will only suppress duplicate detections based on
iou=...—it won’t “merge” two overlapping detections into a larger union box, and in your snippetcompute_iou()/should_merge()aren’t actually applied toresults.boxes, so you’re still visualizing the raw post-NMS output; since you’re using a Segment model, the most robust way to merge “split” potholes is to union the pothole masks and re-extract connected components (then box/measure those) rather than trying to union boxes.import cv2 import numpy as np r = model(bird_eye, conf=0.45, iou=0.4)[0] if r.masks is not None and r.boxes is not None: cls = r.boxes.cls.int().cpu().numpy() pothole_idx = np.where(cls == 0)[0] if pothole_idx.size: m = r.masks.data[pothole_idx].cpu().numpy() # (N,H,W), 0/1 union = (m.sum(0) > 0).astype(np.uint8) * 255 n, labels = cv2.connectedComponents(union) for k in range(1, n): ys, xs = np.where(labels == k) x1, y1, x2, y2 = xs.min(), ys.min(), xs.max(), ys.max() cv2.rectangle(bird_eye, (x1, y1), (x2, y2), (0, 255, 255), 2)For (2), yes—without real-world calibration (and a valid “road plane” assumption),
pixels_per_foot=220can’t be physically meaningful, and even with a BEV warp you only get consistent scale if your homography is tied to metric coordinates; the usual monocular approach is: calibrate camera intrinsics, estimate the road plane, build a homography to a top-down plane in real units (or derive scale from at least one known road-plane measurement like lane width/stripe spacing), then measure in the BEV plane.For (3), the best fix is usually data: train both classes explicitly with lots of “hard negatives” (zebra crossings that look like bumps and vice versa) and keep labels consistent; segmentation often helps because you can then add simple shape/location constraints on the mask (zebra = large repeated pattern region, bump = single narrow band across lane) and optionally smooth decisions over time (if you’re doing video, using
model.track(..., persist=True)from the Track mode docs can help stabilize per-frame flicker, even though it won’t merge instances within a frame).If you can paste
!yolo checksoutput and one representative frame (plus what you consider the “correct” merged result), I can suggest concrete thresholds/post-processing for your exact outputs. In the attached frame:
The large water-filled pothole on the left should be treated as a single instance.
The small region in the top-left corner (currently detected as separate) should be merged with the large region.
Essentially, all visually continuous damaged area should result in one bounding box / one connected component.
Currently:
Mask union + connected components splits them due to small segmentation gaps
Goal:
Treat visually continuous pothole surface as one instance for measurement stability.
- Glenn JocherUltralytics
That split is expected because
connectedComponents()treats any 1–2 px “mask hole” as a hard break, so add a small gap-closing step on the union mask (morphological close / dilate→erode) before components, with the kernel sized to the largest gap you still consider “visually continuous” (see Ultralytics YOLO segmentation docs for more mask/seg usage details):# union: uint8 {0,255} union = (m.sum(0) > 0).astype(np.uint8) * 255 # bridge small gaps (tune kernel size to your expected mask discontinuities) k_close = cv2.getStructuringElement(cv2.MORPH_ELLIPSE, (25, 25)) union_closed = cv2.morphologyEx(union, cv2.MORPH_CLOSE, k_close, iterations=1) # optional: remove tiny speckles after closing k_open = cv2.getStructuringElement(cv2.MORPH_ELLIPSE, (7, 7)) union_closed = cv2.morphologyEx(union_closed, cv2.MORPH_OPEN, k_open, iterations=1) n, labels = cv2.connectedComponents(union_closed)
mslabdelhak29
Reid doesn't work how can i fix it i tried to change it True in botsort.yaml but it doesn't work
@glenn_jocher
- Glenn JocherUltralytics(bearbeitet)
@mslabdelhak29 ReID is only supported by some trackers (for example BoT-SORT), not ByteTrack, and it’s enabled via the tracker YAML you pass at runtime. Copy the default config, enable ReID explicitly, and point
track()to your copy:# custom_botsort.yaml tracker_type: botsort with_reid: True model: yolo26n-cls.pt # or another YOLO classification weight you have locallyfrom ultralytics import YOLO model = YOLO("yolo26n.pt") # any YOLO detector results = model.track(source="path/to/video.mp4", tracker="custom_botsort.yaml", persist=True, show=False)If it still doesn’t work, you’re likely editing a different YAML than the one being loaded; always pass the path as above. Also share the output of
yolo checksand the exactcustom_botsort.yamlyou used so we can verify your environment and keys. See the ReID section in the tracking guide and the BoT-SORT config for details: Multi‑Object Tracking docs and botsort.yaml config.