YOLOv5 auf einer Deep-Learning-VM der Google Cloud Platform (GCP) bereitstellen#
Google Cloud Platform (GCP) ist eine Cloud-Computing-Plattform, deren Deep-Learning-VM für Aufgaben in den Bereichen Data Science und maschinelles Lernen (ML) vorkonfiguriert ist. In diesem Tutorial erfährst du, wie du Ultralytics YOLOv5 auf einer GCP-Deep-Learning-VM einrichtest. Ganz gleich, ob du gerade erst mit ML anfängst oder bereits über Erfahrung verfügst: Das Tutorial zeigt dir, wie du YOLOv5-Modelle zur Objekterkennung trainierst und ausführst.
Neue GCP-Nutzer können außerdem ein Guthaben von 300 $ kostenlos nutzen, um loszulegen.
Weitere Möglichkeiten für den Schnellstart mit YOLOv5 sind unser Google-Colab-Notebook  für die Nutzung im Browser oder die skalierbare Plattform Amazon AWS. Du kannst auch unser offizielles Docker-Image von Docker Hub

Schritt 1: Erstelle und konfiguriere deine Deep-Learning-VM#
Erstelle zunächst eine für Deep Learning optimierte virtuelle Maschine:
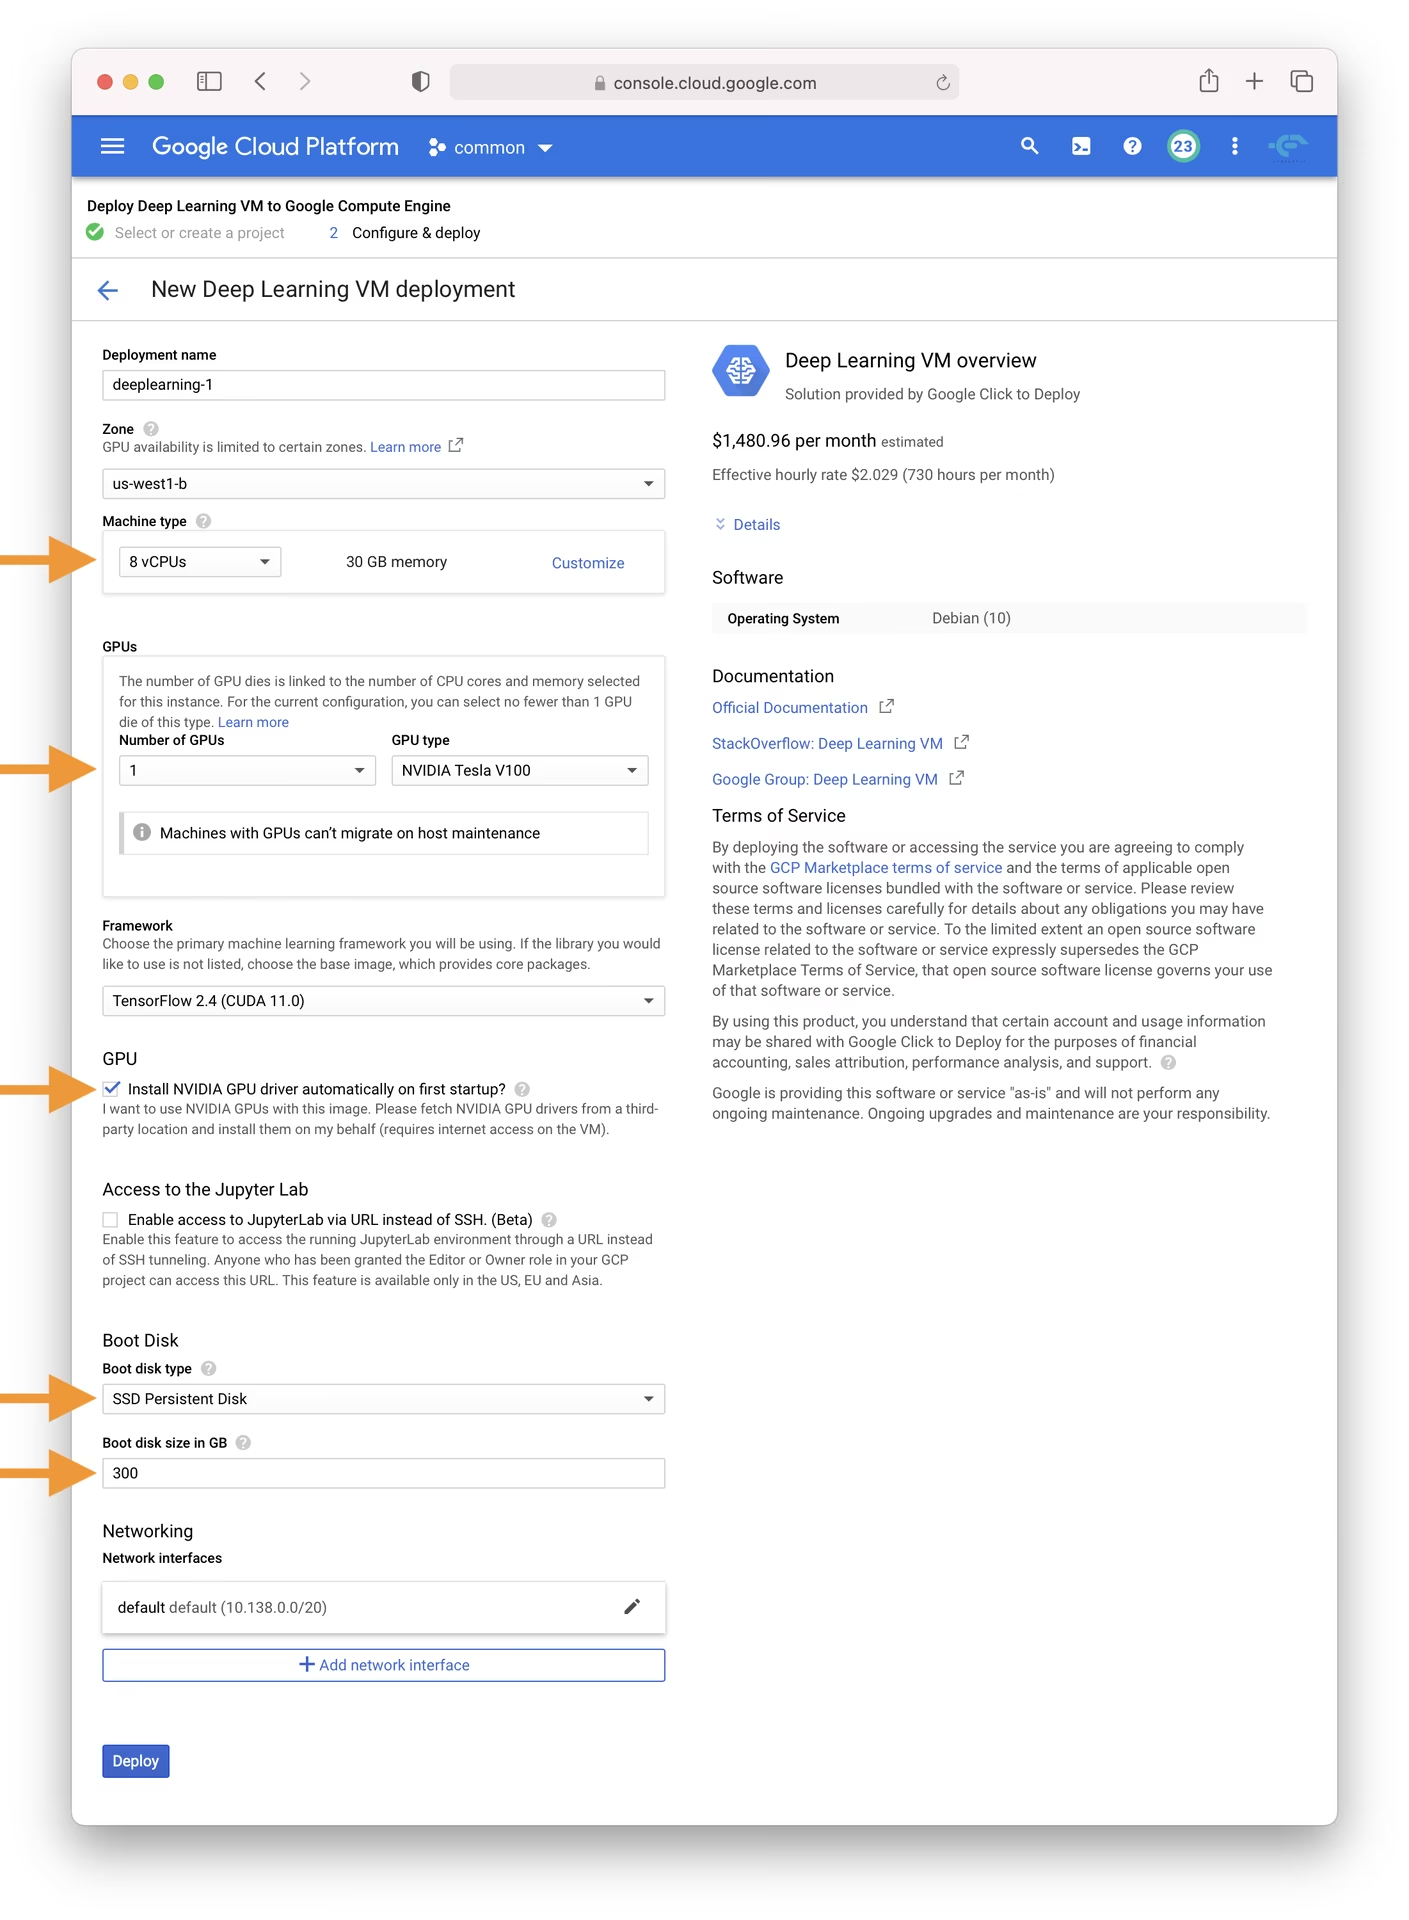
- Rufe den GCP-Marktplatz auf und wähle Deep Learning VM aus.
- Wähle eine n1-standard-8-Instanz aus. Sie bietet mit 8 vCPUs und 30 GB Arbeitsspeicher eine ausgewogene Ausstattung, die für viele ML-Aufgaben geeignet ist.
- Wähle eine GPU aus. Welche GPU du brauchst, hängt von deiner Arbeitslast ab; selbst eine einfache T4-GPU beschleunigt das Modelltraining erheblich.
- Aktiviere das Kontrollkästchen „NVIDIA-GPU-Treiber beim ersten Start automatisch installieren?“.
- Weise eine persistente SSD-Festplatte mit 300 GB zu, um E/A-Engpässe zu vermeiden.
- Klicke auf „Deploy“ und warte, bis GCP deine benutzerdefinierte Deep-Learning-VM bereitgestellt hat.
Diese VM enthält bereits wichtige Werkzeuge und Frameworks, darunter die Python-Distribution Anaconda, die viele der erforderlichen Abhängigkeiten für YOLOv5 praktischerweise bündelt.
Schritt 2: Bereite die VM für YOLOv5 vor#
Installiere anschließend YOLOv5 und seine Abhängigkeiten:
# Clone the YOLOv5 repository
git clone https://github.com/ultralytics/yolov5
cd yolov5

# Install dependencies
pip install -r requirements.txt
YOLOv5 erfordert Python 3.8.0 oder neuer und PyTorch 1.8 oder höher. Die Skripte laden Modelle und Datensätze automatisch aus der neuesten YOLOv5-Version herunter und erleichtern so den Einstieg ins Modelltraining.
Schritt 3: Trainiere deine YOLOv5-Modelle und stelle sie bereit#
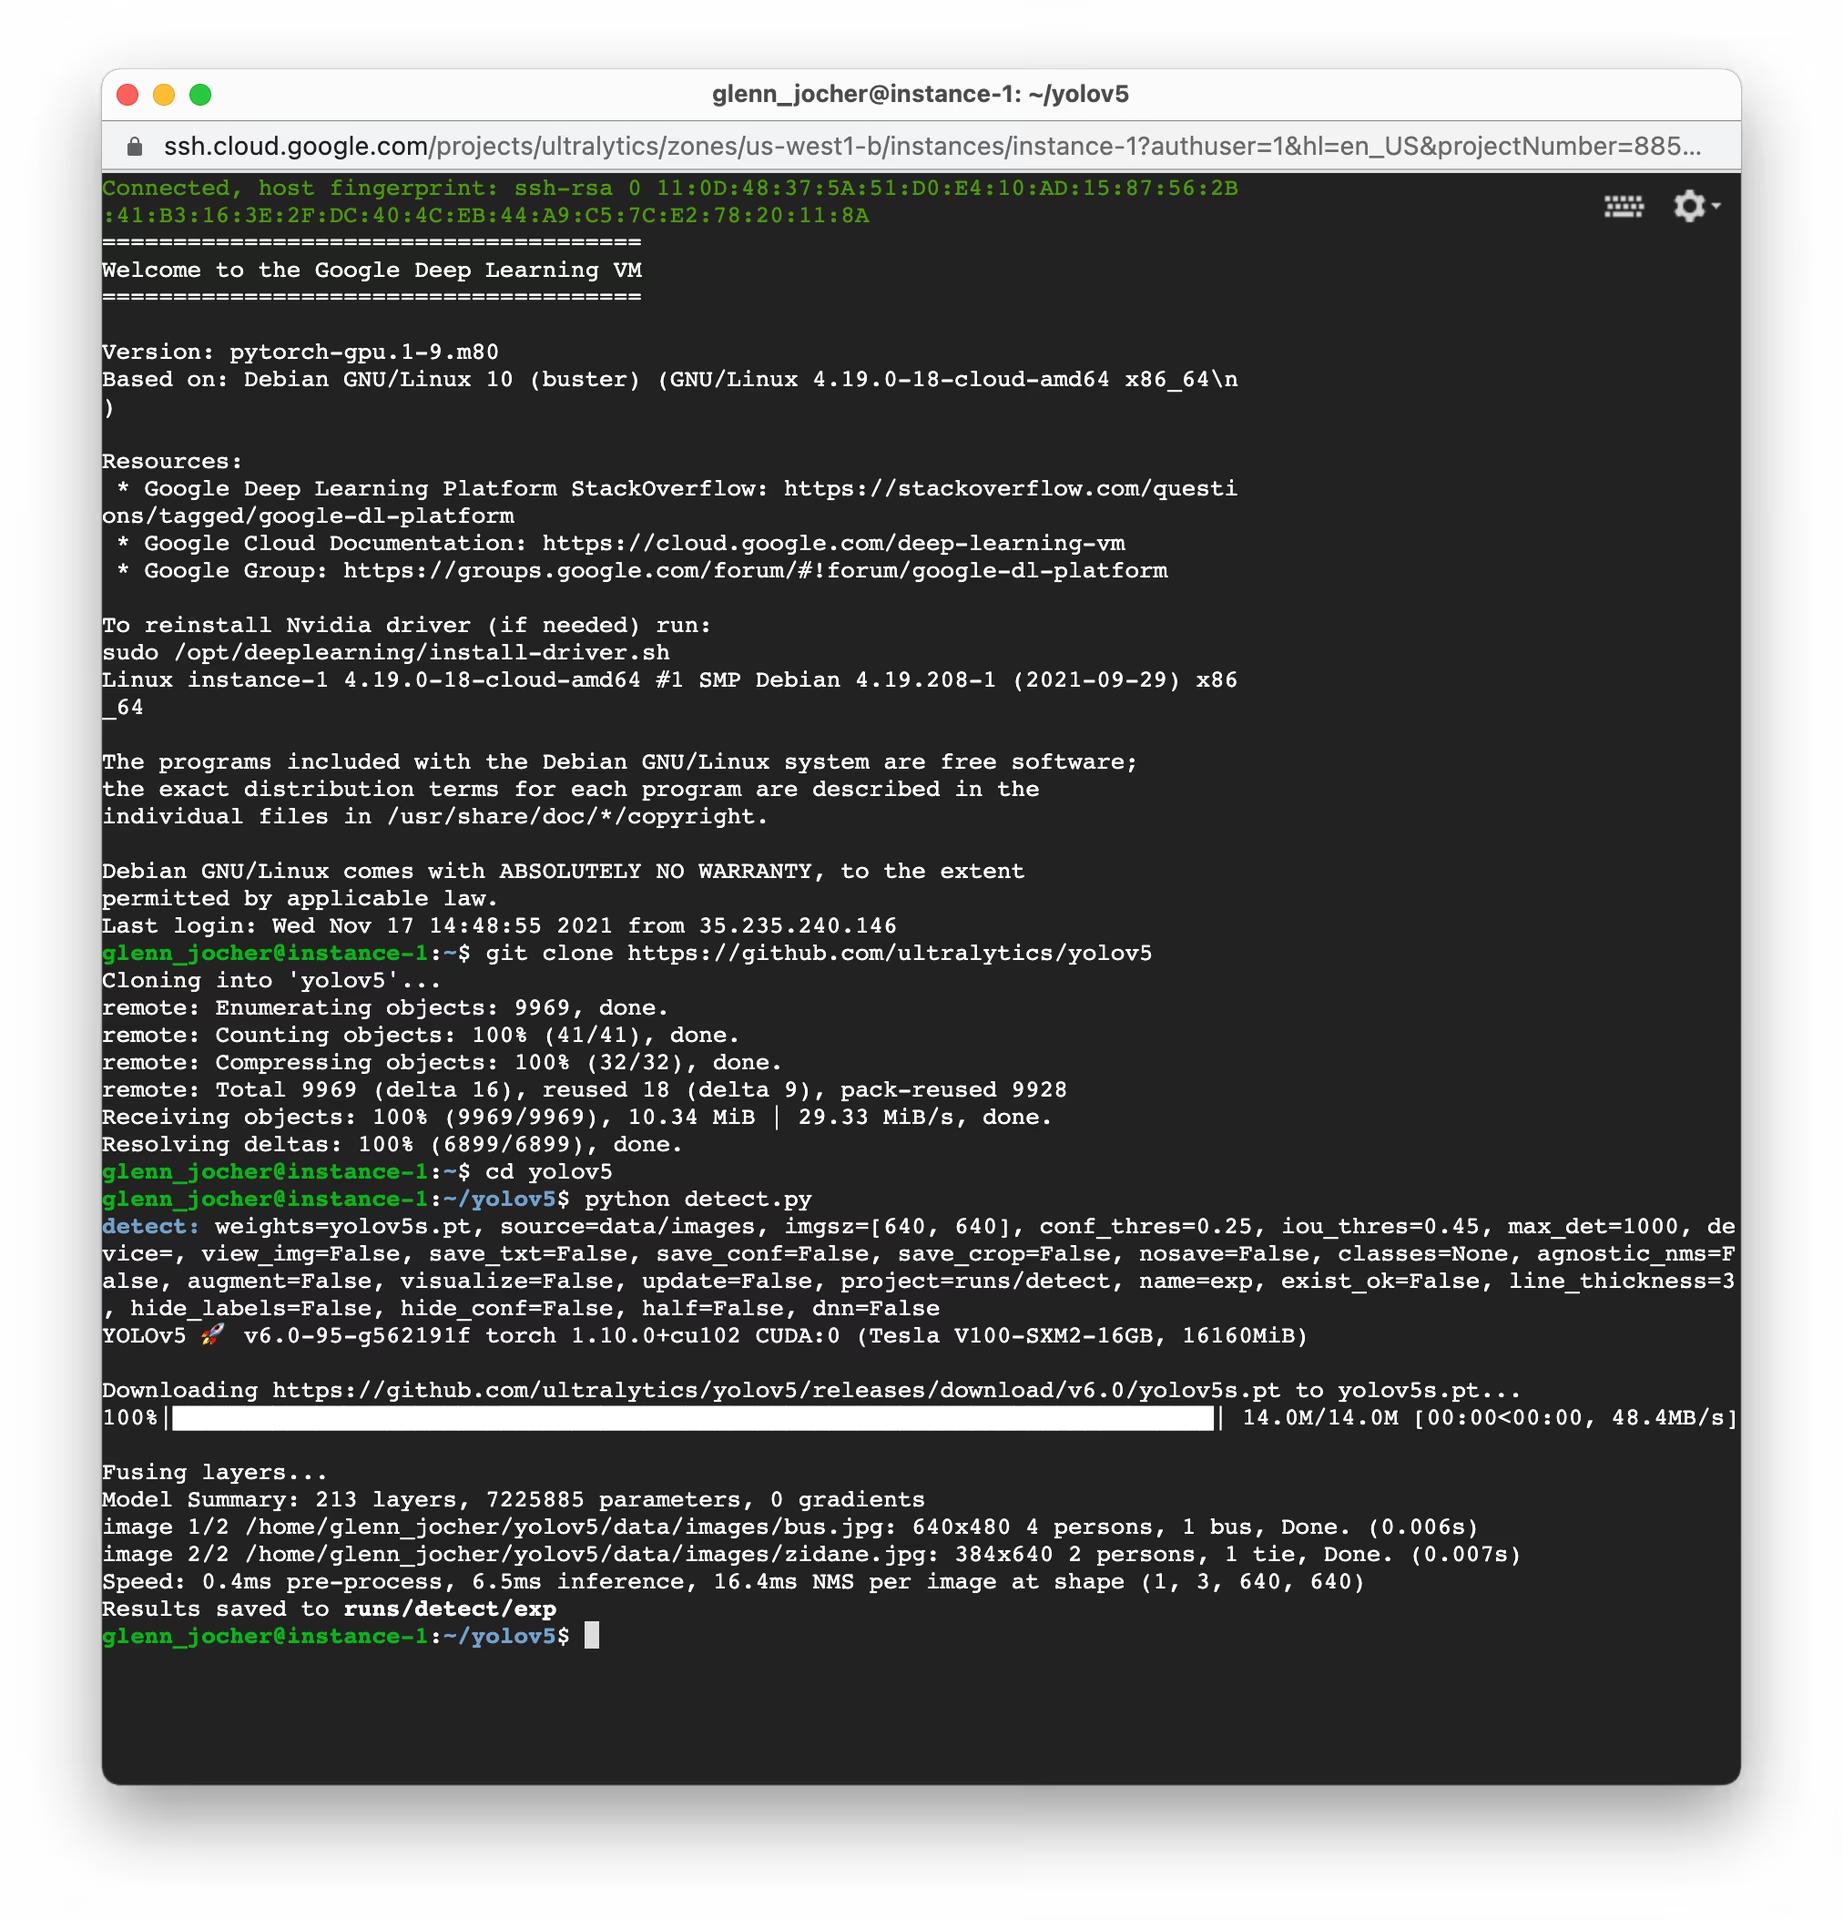
Nach abgeschlossener Einrichtung kannst du YOLOv5 auf deiner GCP-VM trainieren, validieren, Vorhersagen treffen und Modelle exportieren:
# Train a YOLOv5 model on your dataset (e.g., yolov5s)
python train.py --data coco128.yaml --weights yolov5s.pt --img 640

# Validate the trained model to check Precision, Recall, and mAP
python val.py --weights yolov5s.pt --data coco128.yaml

# Run inference using the trained model on images or videos
python detect.py --weights yolov5s.pt --source path/to/your/images_or_videos

# Export the trained model to various formats like ONNX, CoreML, TFLite for deployment
python export.py --weights yolov5s.pt --include onnx coreml tflite
Mit wenigen Befehlen kannst du benutzerdefinierte Objekterkennungsmodelle trainieren, die auf deine Anforderungen zugeschnitten sind, oder für schnelle Ergebnisse mit vortrainierten Gewichten beginnen.
Swap-Speicher zuweisen (optional)#
Wenn du mit besonders großen Datensätzen arbeitest, die den RAM deiner VM möglicherweise übersteigen, solltest du Swap-Speicher hinzufügen, um Speicherfehler zu vermeiden:
# Allocate a 64GB swap file
sudo fallocate -l 64G /swapfile

# Set the correct permissions for the swap file
sudo chmod 600 /swapfile

# Set up the Linux swap area
sudo mkswap /swapfile

# Enable the swap file
sudo swapon /swapfile

# Verify the swap space allocation (should show increased swap memory)
free -h
Benutzerdefinierte Datensätze trainieren#
Gehe wie folgt vor, um YOLOv5 auf deinem benutzerdefinierten Datensatz in GCP zu trainieren:
-
Bereite deinen Datensatz im YOLOv5-Format vor (Bilder und zugehörige Labeldateien). Hinweise findest du in unserer Übersicht zu Datensätzen.
-
Lade deinen Datensatz mit
gcloud compute scpoder über die SSH-Funktion der Webkonsole auf deine GCP-VM hoch. -
Erstelle eine YAML-Datei zur Datensatzkonfiguration (
custom_dataset.yaml). Sie gibt die Pfade zu deinen Trainings- und Validierungsdaten, die Anzahl der Klassen und die Klassennamen an. -
Starte den Trainingsvorgang mit deiner benutzerdefinierten Datensatz-YAML-Datei und gegebenenfalls vortrainierten Gewichten als Ausgangspunkt:
# Example: Train YOLOv5s on a custom dataset for 100 epochs
python train.py --img 640 --batch 16 --epochs 100 --data custom_dataset.yaml --weights yolov5s.pt
Eine umfassende Anleitung zur Datenaufbereitung und zum Training mit benutzerdefinierten Datensätzen findest du im Tutorial Benutzerdefinierte Daten trainieren.
Cloud-Speicher nutzen#
Für eine effiziente Datenverwaltung, insbesondere bei großen Datensätzen oder zahlreichen Experimenten, kannst du deinen YOLOv5-Workflow mit Google Cloud Storage verbinden:
# Ensure Google Cloud SDK is installed and initialized
# If not installed: curl https://sdk.cloud.google.com/ | bash
# Then initialize: gcloud init

# Example: Copy your dataset from a GCS bucket to your VM
gsutil cp -r gs://your-data-bucket/my_dataset ./datasets/

# Example: Copy trained model weights from your VM to a GCS bucket
gsutil cp -r ./runs/train/exp/weights gs://your-models-bucket/yolov5_custom_weights/
So kannst du große Datensätze und trainierte Modelle sicher und kostengünstig in der Cloud speichern und den benötigten Speicherplatz auf deiner VM verringern.
Abschließende Gedanken#
Ultralytics YOLOv5 läuft jetzt auf einer Google-Cloud-Platform-Deep-Learning-VM und ist bereit für Objekterkennungsprojekte – von persönlichen Experimenten und akademischer Forschung bis hin zu industriellen Lösungen.
Nutze die Ultralytics Platform, um deine Modelle ohne Code zu trainieren und zu verwalten.
Bei Fragen und für die Zusammenarbeit kannst du an den GitHub-Diskussionen teilnehmen.
Häufig gestellte Fragen#
Eine
n1-standard-8-Maschine mit einer einzelnen T4-GPU reicht für die meisten YOLOv5-Trainings- und Inferenzaufgaben aus. Wechsle bei großen Datensätzen oder größeren Modellen zu einer L4 oder A100 und aktiviere beim ersten Start immer die Option, den NVIDIA-Treiber automatisch zu installieren.Beende die VM in der Compute Engine Console, wenn sie nicht genutzt wird. Für die angehängte Festplatte fallen weiterhin Kosten an. Lösche daher die VM und die Festplatte, sobald das Projekt abgeschlossen ist und du deine Gewichte sicher in Cloud Storage kopiert hast.
Verwende für kleine Datensätze
gcloud compute scp. Lade größere Datensätze in einen Cloud-Storage-Bucket hoch und rufe sie mitgsutil cp -r gs://your-bucket/dataset ./datasets/ab. Das ist innerhalb des Google-Netzwerks deutlich schneller.Ja. Auf der Deep Learning VM ist PyTorch bereits installiert. Mit
pip install ultralyticskannst du YOLO26 trainieren und exportieren. Verwende dafür die CLIyolo.
Kommentare
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.