Ultralytics Solutions: Mit YOLO26 reale Probleme lösen
Ultralytics Solutions sind sofort einsatzbereite Anwendungen von Ultralytics-YOLO-Modellen für gängige Computer-Vision-Probleme wie Objektzählung, Heatmaps und Geschwindigkeitsschätzung, Warteschlangenverwaltung und Objektunschärfe. Die meisten Lösungen bündeln Erkennung, Tracking oder Poseschätzung in einer konfigurierbaren Klasse, die du über Python oder die yolo solutions-CLI ausführen kannst.
Ansehen: So führst du Ultralytics-Lösungen über die Befehlszeile aus (CLI) | Ultralytics YOLO26 🚀
Lösungen#
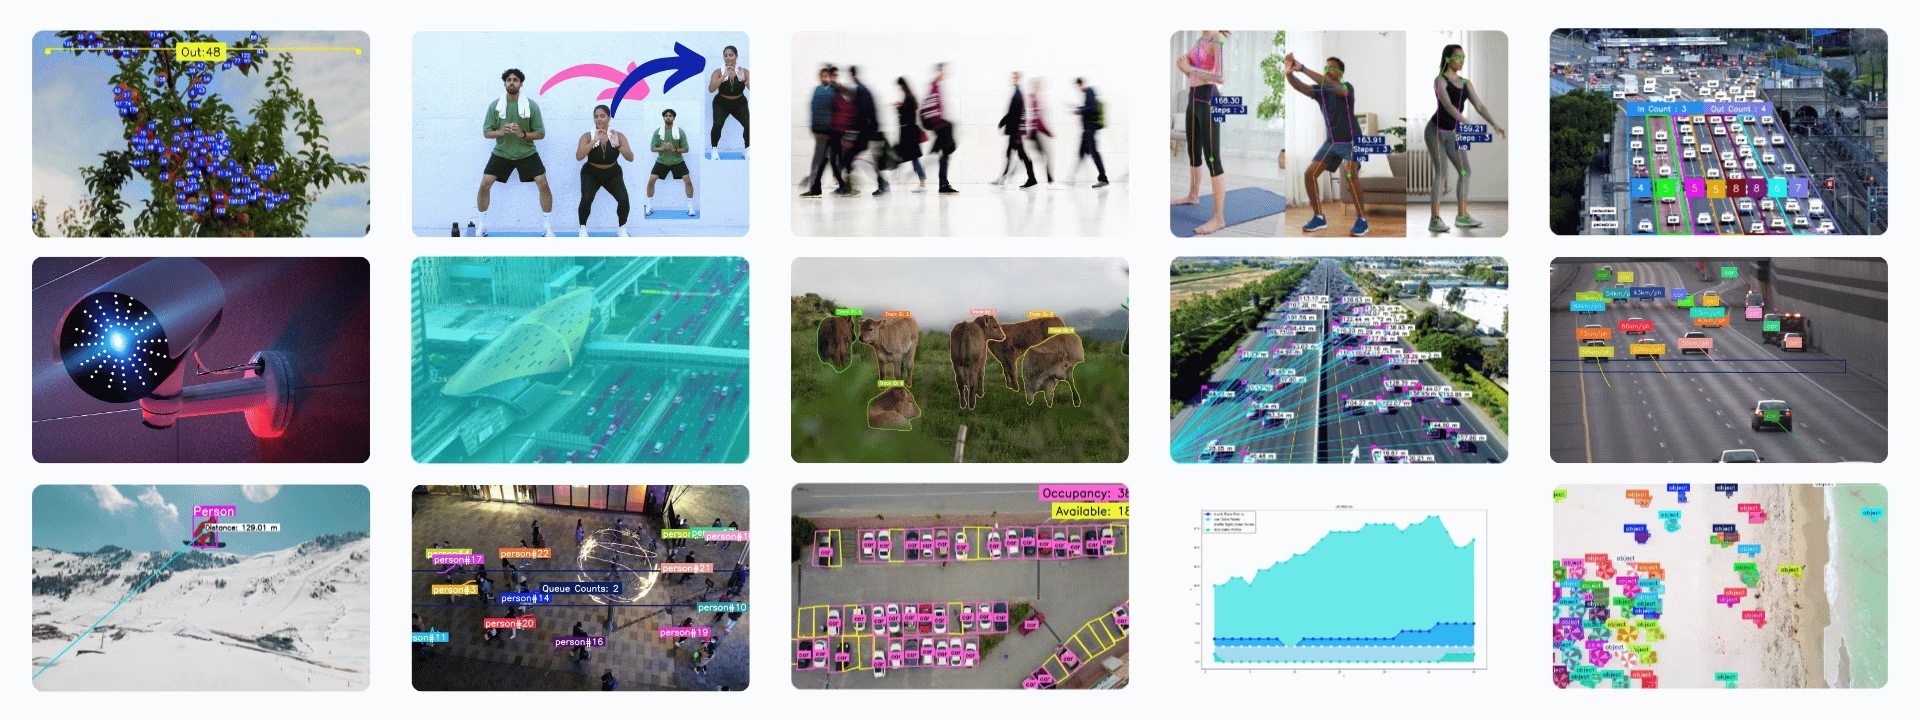
Für jede der folgenden Lösungen gibt es eine eigene Anleitung:
- Analysen: Erstelle aus YOLO26-Erkennungen Linien-, Balken-, Kreis- und Flächendiagramme, um Trends im Zeitverlauf zu analysieren.
- Entfernungsberechnung: Berechne für räumliche Analysen mit YOLO26 den Abstand zwischen Objekten anhand der Schwerpunkte ihrer Begrenzungsrahmen.
- Heatmaps: Fasse YOLO26-Erkennungen in einer Heatmap zusammen, die zeigt, wo Objekte am häufigsten erscheinen oder sich bewegen.
- Instanzsegmentierung mit Objektverfolgung: Kombiniere mit YOLO26 Instanzsegmentierung und Objektverfolgung, um Objektkonturen über Videobilder hinweg zu verfolgen.
- Echtzeit-Inferenz mit Streamlit: Führe mit YOLO26 über eine Streamlit-Oberfläche in deinem Webbrowser eine Echtzeit-Objekterkennung aus.
- Objekte unkenntlich machen: Schütze die Privatsphäre, indem du Objekte bei der Bild- und Videoverarbeitung mit YOLO26 unkenntlich machst.
- Objektzählung: Zähle mit YOLO26 Objekte, die in Videos und Live-Streams eine Linie überqueren oder in einen Bereich gelangen.
- Objektzählung in Bereichen: Zähle mit YOLO26 Objekte in mehreren benutzerdefinierten Bereichen.
- Objektausschnitt: Schneide mit YOLO26 erkannte Objekte aus Bildern und Videos aus und speichere jedes Objekt als separates Bild.
- OCR: Erkenne, lies und ordne Text in Szenen und Dokumenten bei beliebiger Drehung mit YOLO26-Textdetektoren und der Erkennung mit PP-OCRv6 oder lies Koreanisch, Kyrillisch, Arabisch und andere Schriftsysteme mit den Sprachmodellen von PP-OCRv5.
- Parkraummanagement: Überwache mit YOLO26 belegte und freie Parkplätze.
- Warteschlangenverwaltung: Zähle mit YOLO26 Personen, die in einem Warteschlangenbereich warten, um die Länge der Warteschlange zu überwachen.
- Sicherheitsalarmsystem: Erstelle mit YOLO26 ein Sicherheitsalarmsystem, das eine E-Mail-Benachrichtigung sendet, sobald die Zahl der erkannten Objekte einen Schwellenwert erreicht.
- Ähnlichkeitssuche: Rufe mithilfe natürlichsprachlicher Abfragen wie „Person mit einer Tasche“ oder „fahrende Fahrzeuge“ passende Bilder ab, indem du OpenAI CLIP-Einbettungen mit einer Kosinus-Ähnlichkeitssuche kombinierst.
- Geschwindigkeitsschätzung: Schätze mit YOLO26 und Objektverfolgung die Geschwindigkeit von Objekten, etwa zur Verkehrsüberwachung.
- Objekte in einer Zone verfolgen: Verfolge mit YOLO26 Objekte nur innerhalb einer festgelegten Zone im Videobild.
- VisionEye-Ansicht zur Objektzuordnung: Ordne erkannte Objekte einem festen Beobachtungspunkt zu und bilde so nach, wie das menschliche Auge bestimmte Objekte fokussiert.
- Trainingsüberwachung: Zähle Wiederholungen und verfolge Trainingsphasen mit YOLO26-Poseschätzung in Echtzeit.
Argumente für Solutions#
| Argument | Typ | Standard | Beschreibung |
|---|---|---|---|
model | str | None | Pfad zu einer Ultralytics-YOLO-Modelldatei. |
region | list oder dict | None | Punkte, die den Interessenbereich festlegen: entweder eine Liste von (x, y)-Tupeln oder ein Wörterbuch, das bei mehreren Bereichen deren Namen den jeweiligen Punktelisten zuordnet (nur RegionCounter). Bei None verwenden Lösungen, die einen Bereich benötigen, einen vordefinierten Standardbereich. |
show_in | bool | True | Steuert, ob die Eingangsanzahl im Videostream angezeigt wird. |
show_out | bool | True | Steuert, ob die Ausgangsanzahl im Videostream angezeigt wird. |
analytics_type | str | 'line' | Diagrammtyp, z. B. line, bar, area oder pie. |
colormap | int | cv2.COLORMAP_DEEPGREEN | Für die Heatmap zu verwendende Farbpalette. |
line_width | int | 2 | Linienstärke für die Boxen, Keypoints und Zählwerte, die von der Lösung eingezeichnet werden. |
verbose | bool | True | Aktiviert das Protokoll der Lösung für jedes Bild, das Eingabeform, Klassenanzahlen und Verarbeitungsgeschwindigkeit enthält. Der Tracking-Aufruf selbst gibt grundsätzlich keine Meldungen aus. |
json_file | str | None | Pfad zur JSON-Datei mit allen Koordinatendaten für Parkplätze. |
up_angle | float | 145.0 | Winkelschwellenwert für die „obere“ Pose. |
kpts | list[int] | [6, 8, 10] | Liste mit drei Keypoint-Indizes zur Überwachung von Trainingseinheiten. Diese Keypoints entsprechen Körpergelenken oder -teilen wie Schultern, Ellbogen und Handgelenken und werden für Übungen wie Liegestütze, Klimmzüge, Kniebeugen und Bauchmuskeltraining verwendet. |
down_angle | float | 90.0 | Winkelschwellenwert für die „untere“ Pose. |
blur_ratio | float | 0.5 | Passt den prozentualen Unschärfegrad an; Werte liegen im Bereich 0.1 - 1.0. |
crop_dir | str | 'cropped-detections' | Verzeichnisname zum Speichern zugeschnittener Erkennungen. |
records | int | 5 | Gesamtzahl der Erkennungen, ab der eine E-Mail mit einem Sicherheitsalarm ausgelöst wird. |
vision_point | tuple[int, int] | (20, 20) | Der Punkt, an dem VisionEye Objekte verfolgt und mithilfe der VisionEye-Lösung Pfade zeichnet. |
source | str | None | Pfad zur Eingabequelle (Video, RTSP usw.). Nur mit der Befehlszeilenschnittstelle (CLI) für Solutions verwendbar. |
figsize | tuple[float, float] | (12.8, 7.2) | Abbildungsgröße in Zoll für Analytics-Diagramme; (12.8, 7.2) rendert ein Bild mit 1280×720 Pixeln. |
fps | float | 30.0 | Für Geschwindigkeitsberechnungen verwendete Bilder pro Sekunde. |
max_hist | int | 5 | Maximale Anzahl historischer Punkte, die pro Objekt für Geschwindigkeits- und Richtungsberechnungen verfolgt werden. |
meter_per_pixel | float | 0.05 | Skalierungsfaktor zur Umrechnung von Pixelabständen in reale Maßeinheiten. |
max_speed | int | 120 | Maximale Geschwindigkeit in km/h; höhere geschätzte Geschwindigkeiten werden auf diesen Wert begrenzt. |
data | str | 'images' | Pfad zum Bildverzeichnis für die Ähnlichkeitssuche. |
imgsz | int | 640 | Eingabebildgröße für die Modellinferenz. |
recognizer | str oder Callable | 'paddleocr' | Texterkennungs-Backend: 'paddleocr' (PP-OCRv6 mit ONNX Runtime), 'tensorrt' (PP-OCRv6 als FP16-TensorRT-Engine auf NVIDIA-GPUs), ein PaddleOCR-Sprachmodellname wie 'korean_PP-OCRv5_mobile_rec' oder ein aufrufbares Objekt, das einen BGR-Ausschnitt entgegennimmt und (text, confidence) zurückgibt. |
Solutions übergeben die folgenden Inferenz- und Verfolgungsargumente an model.track().
| Argument | Typ | Standard | Beschreibung |
|---|---|---|---|
tracker | str | 'tracktrack.yaml' | Legt den zu verwendenden Verfolgungsalgorithmus fest. Integrierte Optionen: botsort.yaml, bytetrack.yaml, ocsort.yaml, deepocsort.yaml, fasttrack.yaml, tracktrack.yaml. |
conf | float | 0.25 | Legt den Konfidenzschwellenwert für Erkennungen fest. Niedrigere Werte ermöglichen die Verfolgung weiterer Objekte, können aber auch falsch positive Ergebnisse einschließen. |
iou | float | 0.5 | Legt den Schwellenwert für die Schnittmenge über Vereinigung (IoU) fest, um überlappende Erkennungen herauszufiltern. |
classes | list | None | Filtert die Ergebnisse nach Klassenindex. Beispielsweise verfolgt classes=[0, 2, 3] nur die angegebenen Klassen. |
device | str | None | Legt das Gerät für die Inferenz fest (z. B. cpu, cuda:0 oder 0). So kannst du für die Modellausführung zwischen CPU, einer bestimmten GPU oder anderen Rechengeräten wählen. |
imgsz | int or tuple | 640 | Zielbildgröße für die Inferenz: eine Ganzzahl für ein quadratisches Bild oder ein (height, width)-Paar. Die Formen werden an den Modellschritt angepasst. |
max_det | int | 300 | Maximale Anzahl der Erkennungen, die pro Bild vor der Verfolgung beibehalten werden. Dadurch wird die Anzahl der Objekte begrenzt, die eine Lösung in dichten Szenen verarbeitet. |
quantize | int or str | None | Inferenzpräzision: 16 (FP16) oder 32/unset (FP32) für PyTorch- und TorchScript-Modelle außerhalb der CPU; andere Formate verwenden die Präzision, die ihr Artefakt und ihre Laufzeitumgebung vorgeben. Ersetzt das veraltete Argument half. |
Du kannst show_conf, show_labels und die weiteren genannten Argumente verwenden, um die Visualisierung anzupassen.
| Argument | Typ | Standard | Beschreibung |
|---|---|---|---|
show | bool | False | Wenn True aktiviert ist, werden die annotierten Bilder oder Videos in einem Fenster angezeigt. Nützlich für unmittelbares visuelles Feedback während der Entwicklung oder beim Testen. |
show_conf | bool | True | Zeigt neben der Bezeichnung den Konfidenzwert jeder Erkennung an. Gibt Aufschluss darüber, wie sicher sich das Modell bei der jeweiligen Erkennung ist. |
show_labels | bool | True | Zeigt für jede Erkennung eine Bezeichnung in der visuellen Ausgabe an. So lassen sich erkannte Objekte sofort erkennen. |
SolutionAnnotator verwenden#
Alle Ultralytics Solutions verwenden die Klasse SolutionAnnotator, die von der Hauptklasse Annotator abgeleitet ist und die folgenden Methoden bereitstellt:
| Methode | Rückgabetyp | Beschreibung |
|---|---|---|
draw_region() | None | Zeichnet mit den angegebenen Punkten, Farben und der angegebenen Linienstärke einen Bereich. |
queue_counts_display() | None | Zeigt die Anzahl der Wartenden im angegebenen Bereich an. |
display_analytics() | None | Zeigt die Gesamtstatistik für die Parkraumverwaltung an. |
estimate_pose_angle() | float | Berechnet den Winkel zwischen drei Punkten in einer Objektpose. |
draw_specific_kpts() | np.ndarray | Zeichnet bestimmte Schlüsselpunkte in das Bild ein. |
plot_workout_information() | int | Zeichnet ein beschriftetes Textfeld in das Bild ein. |
plot_angle_and_count_and_stage() | None | Visualisiert Winkel, Wiederholungszahl und Trainingsphase zur Überwachung von Trainingseinheiten. |
plot_distance_and_line() | None | Zeigt den Abstand zwischen den Mittelpunkten an und verbindet sie mit einer Linie. |
display_objects_labels() | None | Beschriftet Begrenzungsrahmen mit den Klassenbezeichnungen der Objekte. |
sweep_annotator() | None | Visualisiert eine vertikale Scanlinie und optional eine Beschriftung. |
visioneye() | None | Ordnet die Objektmittelpunkte einem visuellen „Blickpunkt“ zu und verbindet sie damit. |
adaptive_label() | None | Zeichnet mittig in einem Begrenzungsrahmen eine runde oder rechteckige Hintergrundbeschriftung. |
Mit SolutionResults arbeiten#
Jede Lösung außer der Ähnlichkeitssuche gibt beim Aufruf ein SolutionResults-Objekt zurück.
- Bei der Objektzählung enthalten die Ergebnisse
in_count,out_countundclasswise_count.
import cv2

from ultralytics import solutions

im0 = cv2.imread("path/to/img")

region_points = [(20, 400), (1080, 400), (1080, 360), (20, 360)]

counter = solutions.ObjectCounter(
    show=True,  # # Ausgabe anzeigen
    region=region_points,  # # Punkte des Bereichs übergeben
    model="yolo26n.pt",  # model="yolo26n-obb.pt" zur Objektzählung mit einem OBB-Modell.
    # classes=[0, 2],  # Bestimmte Klassen zählen, z. B. Personen und Autos mit einem auf COCO vortrainierten Modell.
    # tracker="botsort.yaml"  # Tracker auswählen, z. B. "bytetrack.yaml"
)
results = counter(im0)
print(results.in_count)  # display in_counts
print(results.out_count)  # display out_counts
print(results.classwise_count) # display classwise_countSolutionResults-Objekte haben die folgenden Attribute:
| Attribut | Typ | Beschreibung |
|---|---|---|
plot_im | np.ndarray | Bild mit visuellen Überlagerungen wie Zählwerten, Unschärfeeffekten oder lösungsspezifischen Erweiterungen. |
in_count | int | Gesamtzahl der Objekte, die beim Eintritt in die festgelegte Zone im Videostream erkannt wurden. |
out_count | int | Gesamtzahl der Objekte, die beim Verlassen der festgelegten Zone im Videostream erkannt wurden. |
classwise_count | dict[str, dict[str, int] | int] | Zählungen nach Klassen: {"IN": int, "OUT": int} für ObjectCounter und Heatmap oder ein int für Analytics. |
queue_count | int | Anzahl der Objekte, die sich derzeit in einer festgelegten Warteschlange oder einem Wartebereich befinden (geeignet für das Warteschlangenmanagement). |
workout_count | list[int] | Wiederholungszahlen pro Track aus AI Gym (ein Eintrag pro aktuell verfolgter Person). |
workout_angle | list[float] | Übungswinkel pro Track aus AI Gym (ein Eintrag pro aktuell verfolgter Person). |
workout_stage | list[str] | Aktuelle Trainingsphase pro Track aus AI Gym (ein Eintrag pro aktuell verfolgter Person). |
pixels_distance | float | Abstand in Pixeln zwischen zwei Objekten oder Punkten, beispielsweise Begrenzungsrahmen (geeignet zur Entfernungsberechnung). |
available_slots | int | Anzahl der freien Plätze in einem überwachten Bereich (geeignet für die Parkraumverwaltung). |
filled_slots | int | Anzahl belegter Plätze in einem überwachten Bereich (geeignet für das Parkraummanagement). |
email_sent | bool | Gibt an, ob eine Benachrichtigung oder Alarm-E-Mail erfolgreich gesendet wurde (geeignet für Sicherheitsalarme). |
total_tracks | int | Gesamtzahl der einzelnen Objekt-Tracks, die während der Videoanalyse erfasst wurden. |
region_counts | dict[str, int] | Objektanzahlen innerhalb benutzerdefinierter Bereiche oder Zonen. |
speed_dict | dict[int, int] | Wörterbuch mit geschätzten Objektgeschwindigkeiten in km/h für jede Spur aus SpeedEstimator, nützlich für die Geschwindigkeitsanalyse. |
total_crop_objects | int | Gesamtzahl der zugeschnittenen Objektbilder, die von der ObjectCropper-Lösung erzeugt wurden. |
speed | dict[str, float] | Wörterbuch mit Leistungskennzahlen für Tracking und Lösungsverarbeitung. |
Weitere Informationen findest du in der Dokumentation zur Klasse SolutionResults.
Lösungen über die CLI verwenden#
Die meisten Lösungen lassen sich direkt über die Befehlszeile ausführen.
Syntax
yolo SOLUTIONS SOLUTION_NAME ARGS
- SOLUTIONS ist ein erforderliches Schlüsselwort.
- SOLUTION_NAME ist eines von:
['count', 'crop', 'blur', 'workout', 'heatmap', 'isegment', 'queue', 'speed', 'analytics', 'trackzone', 'inference', 'visioneye', 'region', 'security', 'parking', 'ocr']. - ARGS (optional) sind benutzerdefinierte
arg=value-Paare wieshow_in=True, mit denen du die Standardeinstellungen überschreiben kannst.
yolo solutions count show=True # for object counting

yolo solutions count source="path/to/video.mp4" # specify video file path
Trage zu unseren Lösungen bei#
Beiträge aus der Community sind willkommen. Wenn du mit Ultralytics YOLO eine hier nicht aufgeführte Lösung entwickelt hast, kannst du sie als Anleitung teilen, damit andere Nutzer davon profitieren.
Häufig gestellte Fragen#
Ultralytics YOLO26 zählt Objekte in Echtzeit, indem es Erkennung und Tracking kombiniert. So wird jedes Objekt nur einmal gezählt, wenn es eine Linie überquert oder in einen Bereich gelangt. Um YOLO26 für die Analyse eines Live-Videostreams einzurichten, installiere
ultralytics, lade ein Modell und übergib Videobilder ansolutions.ObjectCounter.Ultralytics YOLO26 ergänzt kamerabasierte Sicherheitssysteme um Echtzeit-Objekterkennung und Alarmmeldungen. Mit der Lösung Sicherheitsalarmsystem sendet YOLO26 eine E-Mail-Benachrichtigung, sobald die Zahl der erkannten Objekte im Überwachungsbereich einen Schwellenwert erreicht.
Ultralytics YOLO26 zählt und verfolgt Personen in einem Warteschlangenbereich und zeigt dir so die aktuelle Warteschlangenlänge an. Dadurch lassen sich Wartezeiten verkürzen und Personal besser einteilen.
Ja. Die Pose-Modelle von Ultralytics YOLO26 verfolgen Körper-Schlüsselpunkte in Echtzeit. So kann die Trainingsüberwachungslösung Gelenkwinkel messen, Wiederholungen zählen und die aktuelle Trainingsphase melden.
Ultralytics YOLO26 kann Heatmaps erstellen, die zeigen, wo Objekte in einer Szene am häufigsten erscheinen oder sich bewegen, und Bereiche mit hoher Aktivität hervorheben. Diese Datenvisualisierungen helfen dir, Verkehrsmuster und Trends im Zeitverlauf zu verstehen.


Kommentare23
Stell eine Frage, teile deine Ergebnisse oder hilf jemand anderem.
ZHIYUAN816(bearbeitet)
But acturally I don't konw how to set plots_max
 Glenn JocherUltralytics(bearbeitet)
@ZHIYUAN816 you don't need to set anything: the warning has no effect on training or metrics, only on how many items are drawn on the plotted validation images (optional, for visual review). In current versions that limit follows the
max_detargument (default 300).
WARNING ⚠️ Limiting validation plots to first 50 items per image for speed... WARNING ⚠️ Limiting validation plots to first 50 items per image for speed... how to solve this problem bro?
- Glenn JocherUltralytics(bearbeitet)
@ZHIYUAN816 this is not an error but a warning that the plotted prediction images are limited to a maximum number of items per image. It does not affect training. In current versions the limit follows
max_det(default 300).
smc0927
If I want a target to be detected only once, is it possible? If so, how can I do it?
RizwanMunawar
@smc0927 Hi! I’m not entirely sure I understand your question. Could you please clarify a bit?
Generally, the counting process is designed to occur only once for each track ID. Once an object is counted, it won't be counted again, even if it crosses the same
regionorlinemultiple times.ok,I want to print out the coordinates of the target, but that's not what I want because it's going to be printed multiple times over a period of time. I want it to be output only once, is there a way to achieve this?
@smc0927 Yes it's possible. You can simply iterate over the detection results. BTW, this discussion is more related to Ultralytics solutions, while your question is related to prediction :)
Sample Code
from ultralytics import YOLO
model = YOLO("yolo11n.pt")
results = model.predict("path/to/im0")

if results[0].boxes.id is not None:
      boxes = results[0].boxes.xyxy.cpu()
      track_ids = results[0].boxes.id.int().cpu().tolist()
      clss = results[0].boxes.cls.cpu().tolist()

      for box, cls in enumerate(boxes, clss):
          # Here you can add the logic to display single-time details of the object
Thanks :)
sorry
hodat2608
Hi everyone, hi @glenn-jocher, I want to install pycuda on my windows 10 using python 3.12, but I still can't do it. It's hard to find any documentation or tutorials like that, @glenn-jocher or anyone can send me a link or tutorial to install pycuda? Please help me. Thanks first
MuhammedEnesGurkan
hey how can ı find yolo v8 solutions source codes.
- Glenn JocherUltralytics
@MuhammedEnesGurkan you can find the source codes for YOLOv8 solutions on the Ultralytics GitHub repository. For more detailed guides and examples, please visit the Ultralytics Solutions page at https://docs.ultralytics.com/solutions/.
maxexplorer
Hi there,
After updating Ultralytics and using YOLO11, will the YOLOv8 models still work in this virtual environment?
Thank you in advance for your help and the great work you’re doing!
- Glenn JocherUltralytics
@maxexplorer yes, YOLOv8 models will continue to work in your virtual environment after updating to YOLO11. If you have further questions, feel free to ask!
yosifsaab
hi i have error during using the google colab for classification two classes images by yolov8n
results = model.train(data=DATA_DIR, epochs=1, imgsz=64)- Glenn JocherUltralytics
@yosifsaab it seems you're encountering an error with YOLOv8n in Google Colab. Please ensure your
DATA_DIRis correctly set and that your dataset is properly formatted. If the issue persists, check the Colab notebook for any specific error messages that might provide more details. For further assistance, you can refer to the Ultralytics documentation.
Nkosiyazimelani
Hi guys, how do i update the nc that my model can detect without having to train with old and new objects. i have updated my .YAML file but the model is still detecting the old number of objects(20 instead of 46). i have been told to look on the model itself and change the output number of class to the new updated on but there is nothing of that sort in the model file( best.pt). please help.
- Glenn JocherUltralytics(bearbeitet)
@Nkosiyazimelani the number of classes (
nc) is part of the trained model's detection head, so editing the.yamlfile after training doesn't change whatbest.ptpredicts. You need to train again with a dataset YAML that has all 46 classes. You don't have to start from scratch, you can fine-tune from your existing weights, and the layers whose shapes depend on the class count are reinitialized automatically:from ultralytics import YOLO model = YOLO("best.pt") model.train(data="your_46_class_dataset.yaml", epochs=100)Make sure your dataset contains labeled examples of both the old and the new classes, otherwise the model will forget the old ones.
nounotabe
How to specify the device to be used (e.g. cuda:1)?
- Glenn JocherUltralytics
@nounotabe to specify the device for running YOLOv8, you can use the
deviceargument. For example, to use the second GPU (cuda:1), you can setdevice='cuda:1'. This can be done in both the CLI and Python API. If you encounter any issues, please ensure you are using the latest version of the package. For more detailed guidance, you can refer to our documentation at https://docs.ultralytics.com. cobaltautomationdev
lasted version of ultralytics. solutions not works in Windows10, but works in Google Colab. What's wrong with it? How to settle it? from ultralytics import solutions,YOLO , Couldn't import solutions in my windows10.
- Glenn JocherUltralytics
It seems like there might be an issue with the
solutionsmodule on Windows 10. Please ensure you are using the latest version of the Ultralytics package. If the issue persists, try reinstalling the package or running the code in a different environment. For further assistance, you can refer to our documentation at https://docs.ultralytics.com/solutions/. Just updated to v8.2.78 today ,uninstall and reinstall the latest version. and now it works on Windows10 . it seems there something changed in solutions init.py . this file caused import error in previous version. I noticed that in version 8.2.0, file init.py is blank. now add some code in it.