Conjunto de datos Caltech-101#
El conjunto de datos Caltech-101 es una referencia clásica de clasificación de imágenes, con 9144 imágenes que abarcan 101 categorías de objetos, además de una clase de fondo. Cada categoría contiene entre 40 y 800 imágenes de objetos del mundo real —animales, vehículos, artículos del hogar y personas—, lo que lo convierte en una referencia compacta pero exigente para modelos de reconocimiento de objetos.
Explora Caltech-101 en Ultralytics Platform para previsualizar muestras, consultar estadísticas del conjunto de datos y clonarlo para entrenar.
Ver: Cómo entrenar un modelo de clasificación de imágenes con el conjunto de datos Caltech-101 mediante Ultralytics Platform
Caltech-101 se distribuye sin una división predefinida entre entrenamiento y validación. Los comandos de entrenamiento que aparecen a continuación lo dividen automáticamente en un 80 % para entrenamiento y un 20 % para validación, así que no hace falta prepararlo manualmente.
Características principales#
- Caltech-101 contiene 9144 imágenes en color distribuidas en 101 categorías de objetos, además de una clase
BACKGROUND_Google(102 carpetas de clases en total). - Las categorías abarcan una amplia variedad de objetos del mundo real, como animales, vehículos, artículos del hogar y personas.
- Cada categoría contiene entre 40 y 800 imágenes, por lo que el número de imágenes por clase está desequilibrado.
- Las imágenes tienen tamaños variables, aunque la mayoría mide aproximadamente 300 × 200 píxeles (resolución media).
- Caltech-101 se utiliza ampliamente como referencia para algoritmos de clasificación de imágenes y reconocimiento de objetos.
Estructura del conjunto de datos#
Caltech-101 se distribuye en 102 carpetas —una por clase, que abarcan 101 categorías de objetos y una clase BACKGROUND_Google—, sin una división predefinida entre entrenamiento y validación. Al iniciar el entrenamiento, Ultralytics divide automáticamente las imágenes para que los modelos se entrenen con las 102 clases sin necesidad de configuración manual:
- Clases: 102 (101 categorías de objetos + 1 de fondo)
- Imágenes totales: 9144
- División entre entrenamiento y validación: automática, 80 % / 20 % (≈7280 para entrenamiento, ≈1864 para validación)
- Imágenes por clase: entre unas 40 y 800 (desequilibradas)
Aplicaciones#
Caltech-101 se utiliza ampliamente para entrenar y evaluar modelos de clasificación de imágenes y reconocimiento de objetos, incluidas las redes neuronales convolucionales (CNNs) y las máquinas de vectores de soporte (SVMs). Su amplia variedad de categorías e imágenes limpias y etiquetadas lo convierten en un conjunto de referencia popular para la investigación y la creación de prototipos en aprendizaje automático y visión artificial.
Uso#
Entrena un modelo YOLO con Caltech-101 durante 100 épocas y con un tamaño de imagen de 416. Para consultar la lista completa de argumentos disponibles, visita la página de entrenamiento y la guía de la tarea de clasificación de imágenes.
from ultralytics import YOLO

# Cargar un modelo
model = YOLO("yolo26n-cls.pt")  # Carga un modelo preentrenado (recomendado para el entrenamiento)

# Entrenar el modelo
results = model.train(data="caltech101", epochs=100, imgsz=416)
Imágenes de muestra y anotaciones#
El conjunto de datos Caltech-101 contiene imágenes en color de gran calidad de diversos objetos, lo que proporciona un conjunto de datos bien estructurado para tareas de clasificación de imágenes. Estos son algunos ejemplos de imágenes del conjunto de datos:
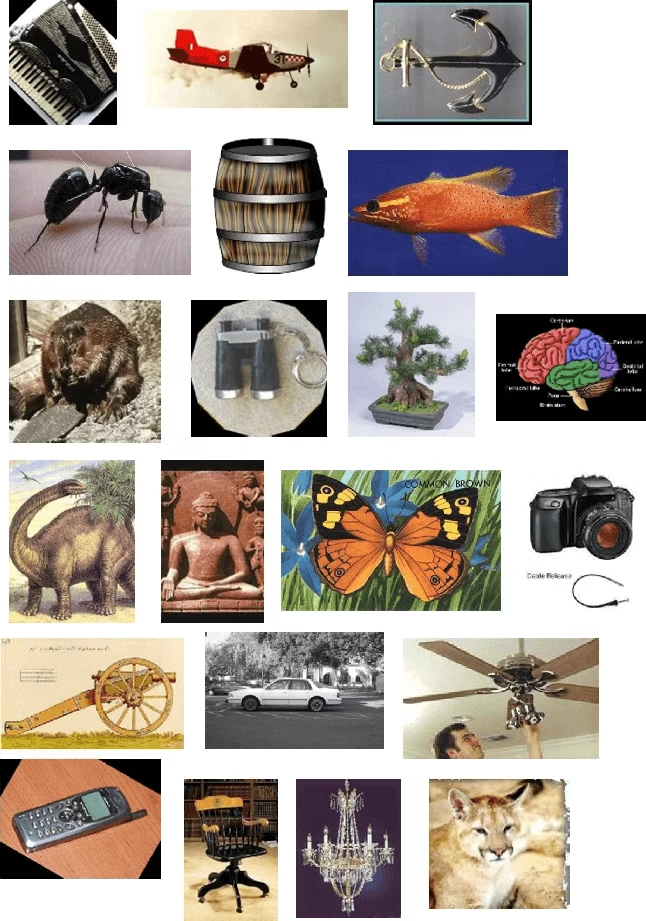
Las muestras muestran la variedad de categorías y el encuadre natural y centrado típico de Caltech-101, lo que lo convierte en un punto de partida adecuado para entrenar modelos robustos de reconocimiento de objetos.
Citas y agradecimientos#
Si utilizas el conjunto de datos Caltech-101 en tu trabajo de investigación o desarrollo, cita el siguiente artículo:
@article{fei2007learning,
  title={Learning generative visual models from few training examples: An incremental Bayesian approach tested on 101 object categories},
  author={Fei-Fei, Li and Fergus, Rob and Perona, Pietro},
  journal={Computer vision and Image understanding},
  volume={106},
  number={1},
  pages={59--70},
  year={2007},
  publisher={Elsevier}
}
Queremos reconocer la labor de Li Fei-Fei, Rob Fergus y Pietro Perona por crear y mantener el conjunto de datos Caltech-101 como un recurso valioso para la comunidad investigadora de aprendizaje automático y visión artificial. Para obtener más información sobre el conjunto de datos Caltech-101 y sus creadores, visita el sitio web del conjunto de datos Caltech-101.
Preguntas frecuentes#
El conjunto de datos Caltech-101 se utiliza ampliamente para entrenar y evaluar modelos de clasificación de imágenes y reconocimiento de objetos. Contiene 9.144 imágenes de 101 categorías de objetos, además de una clase de fondo, y ofrece un conjunto de referencia exigente para evaluar algoritmos como las redes neuronales convolucionales (CNNs) y las máquinas de vectores de soporte (SVMs).
Para entrenar un modelo Ultralytics YOLO con Caltech-101, utiliza los fragmentos de código siguientes. El conjunto de datos se descarga automáticamente la primera vez que se utiliza. Para ver la lista completa de argumentos, visita la página de entrenamiento del modelo.
Ejemplo de entrenamientofrom ultralytics import YOLO # Cargar un modelo model = YOLO("yolo26n-cls.pt") # Carga un modelo preentrenado (recomendado para el entrenamiento) # Entrenar el modelo results = model.train(data="caltech101", epochs=100, imgsz=416)Caltech-101 contiene 101 categorías de objetos y una clase de fondo
BACKGROUND_Google, es decir, 102 carpetas de clases y 9.144 imágenes en total. Al entrenar con Ultralytics, el modelo aprende las 102 clases. El número de imágenes por categoría está desequilibrado y oscila entre unas 40 y 800.Caltech-101 no tiene una división predefinida. La primera vez que entrenes, Ultralytics lo divide automáticamente en un 80 % para entrenamiento y un 20 % para validación —unas 7.280 imágenes de entrenamiento y 1.864 de validación—, así que no tienes que crear las divisiones manualmente. Para controlar tú la división, organiza las imágenes en carpetas
train/yval/antes de entrenar.Sí. Ultralytics Platform te permite gestionar conjuntos de datos, entrenar modelos de clasificación de imágenes y desplegarlos sin necesidad de escribir mucho código. Es una forma práctica de realizar experimentos con Caltech-101 en la nube; además, puedes consultar más opciones en nuestra descripción general de los conjuntos de datos de clasificación.