Conjunto de datos Caltech-256#
El conjunto de datos Caltech-256 es un referente clásico de clasificación de imágenes con 30.607 imágenes que abarcan 256 categorías de objetos y una clase de fondo. Cada categoría contiene al menos 80 imágenes de objetos del mundo real —animales, vehículos, artículos domésticos y personas—, lo que lo convierte en un sucesor más grande y exigente de Caltech-101 para modelos de reconocimiento de objetos.
Explora Caltech-256 en Ultralytics Platform para previsualizar muestras, consultar las estadísticas del conjunto de datos y clonarlo para el entrenamiento.
Caltech-256 se distribuye sin una división predefinida entre entrenamiento y validación. Los comandos de entrenamiento siguientes lo dividen automáticamente en un 80 % para entrenamiento y un 20 % para validación, por lo que no es necesaria ninguna preparación manual.
Características principales#
- Caltech-256 contiene 30.607 imágenes en color repartidas entre 256 categorías de objetos y una clase de fondo
257.clutter(257 carpetas de clases en total). - Las categorías abarcan una gran variedad de objetos del mundo real, incluidos animales, vehículos, artículos domésticos y personas.
- Cada categoría contiene al menos 80 imágenes, mientras que la más grande contiene hasta unas 800, por lo que el tamaño de las clases está desequilibrado.
- Las imágenes tienen tamaños y resoluciones variables.
- Caltech-256 se utiliza ampliamente para evaluar algoritmos de clasificación de imágenes y reconocimiento de objetos.
Estructura del dataset#
Caltech-256 se distribuye como 257 carpetas —una por clase, que cubren 256 categorías de objetos y una clase de fondo 257.clutter— sin una división predefinida entre entrenamiento y validación. Cuando inicias el entrenamiento, Ultralytics particiona automáticamente las imágenes para que los modelos se entrenen con las 257 clases sin ninguna configuración manual:
- Clases: 257 (256 categorías de objetos + 1 de fondo)
- Imágenes totales: 30.607
- División entre entrenamiento y validación: automática, 80 % / 20 % (≈24.385 para entrenamiento, ≈6.222 para validación)
- Imágenes por clase: al menos 80 (desequilibradas, hasta unas 800)
Aplicaciones#
El conjunto de datos Caltech-256 se utiliza ampliamente para entrenar y evaluar modelos de clasificación de imágenes y reconocimiento de objetos, incluidas las redes neuronales convolucionales (CNNs) y las máquinas de vectores de soporte (SVMs). Su gran número de categorías y sus imágenes de alta calidad lo convierten en un referente popular para la investigación y la creación de prototipos de aprendizaje automático y visión artificial.
Uso#
Entrena un modelo YOLO con Caltech-256 durante 100 épocas y con un tamaño de imagen de 416. Para consultar la lista completa de argumentos disponibles, visita la página de entrenamiento y la guía de la tarea de clasificación de imágenes.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-cls.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="caltech256", epochs=100, imgsz=416)
Imágenes de ejemplo y anotaciones#
El conjunto de datos Caltech-256 contiene imágenes en color de alta calidad de diversos objetos, lo que proporciona un conjunto de datos bien estructurado para tareas de clasificación de imágenes. Estos son algunos ejemplos de imágenes del conjunto de datos (crédito):
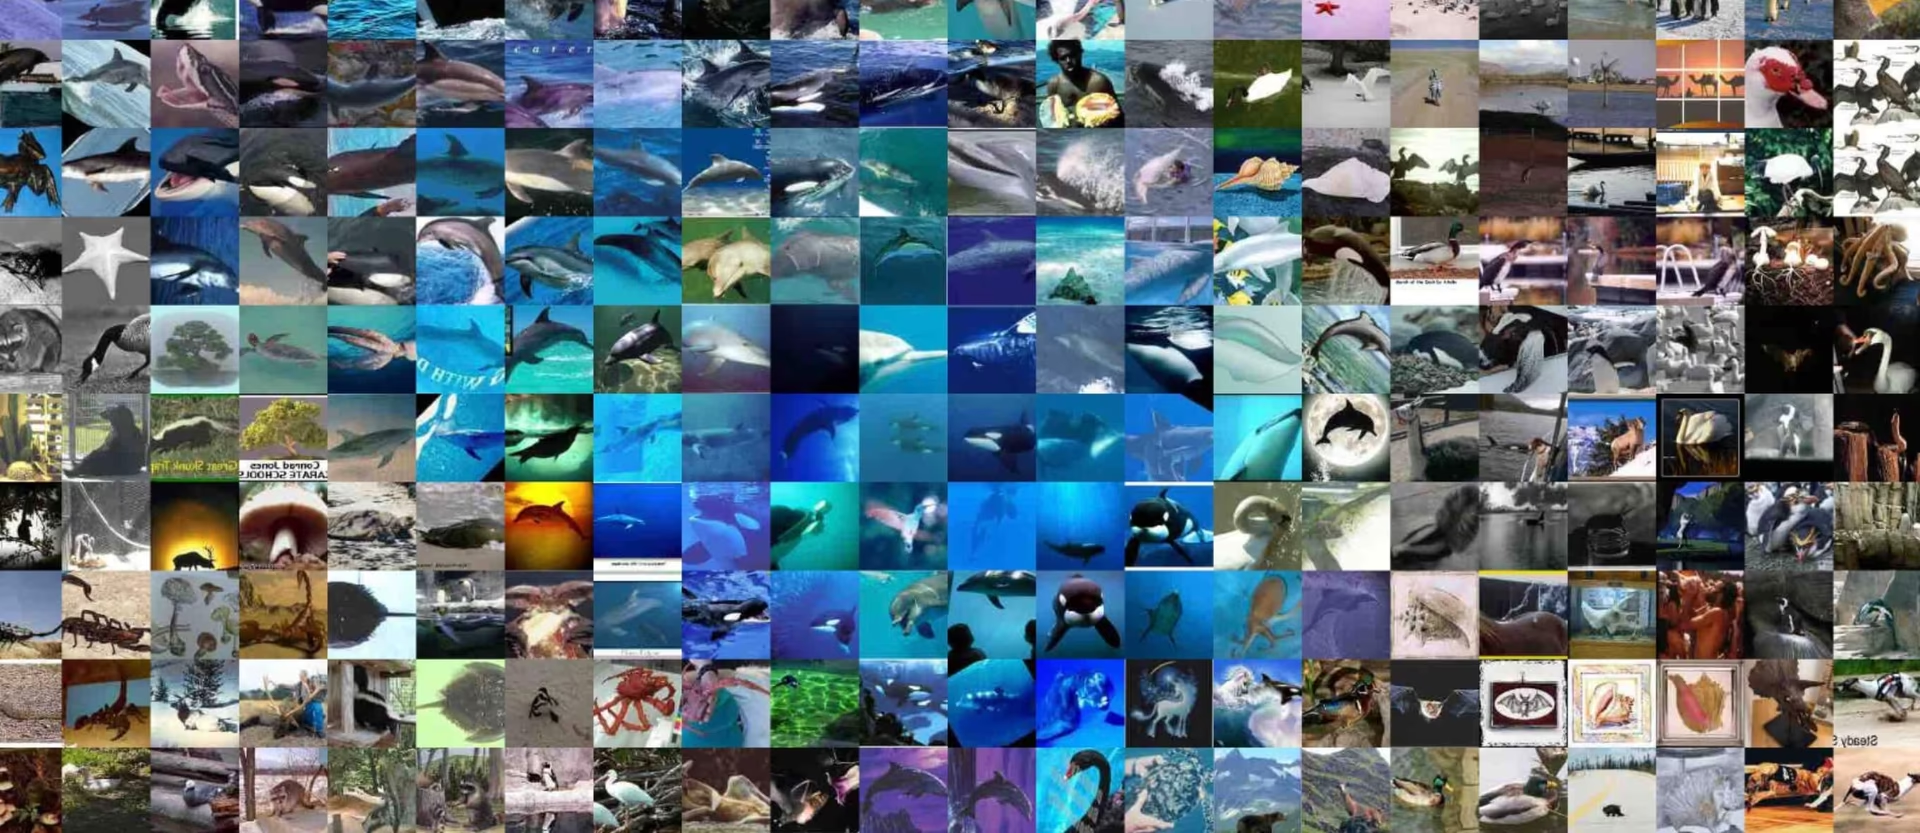
Las muestras muestran la diversidad y complejidad de los objetos del conjunto de datos Caltech-256, y ponen de manifiesto el valor de un conjunto de datos variado para entrenar modelos sólidos de reconocimiento de objetos.
Citas y agradecimientos#
Si utilizas el conjunto de datos Caltech-256 en tu investigación o trabajo de desarrollo, cita el siguiente artículo:
@article{griffin2007caltech,
         title={Caltech-256 object category dataset},
         author={Griffin, Gregory and Holub, Alex and Perona, Pietro},
         year={2007}
}
Nos gustaría reconocer la labor de Gregory Griffin, Alex Holub y Pietro Perona por crear y mantener el conjunto de datos Caltech-256 como un recurso valioso para la comunidad investigadora de aprendizaje automático y visión artificial. Para obtener más información sobre el conjunto de datos Caltech-256 y sus creadores, visita el sitio web del conjunto de datos Caltech-256.
Preguntas frecuentes#
El conjunto de datos Caltech-256 se utiliza ampliamente para entrenar y evaluar modelos de clasificación de imágenes y reconocimiento de objetos. Contiene 30.607 imágenes distribuidas entre 256 categorías de objetos y una clase de fondo, lo que proporciona un referente más grande y exigente que Caltech-101 para algoritmos como las redes neuronales convolucionales (CNNs) y las máquinas de vectores de soporte (SVMs).
Para entrenar un modelo Ultralytics YOLO con Caltech-256, utiliza los fragmentos de código siguientes. El conjunto de datos se descarga automáticamente la primera vez que se utiliza. Para consultar la lista completa de argumentos, visita la página de entrenamiento del modelo.
Ejemplo de entrenamientofrom ultralytics import YOLO # Load a model model = YOLO("yolo26n-cls.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="caltech256", epochs=100, imgsz=416)Caltech-256 contiene 256 categorías de objetos y una clase de fondo
257.clutter, lo que suma 257 carpetas de clases y 30.607 imágenes en total. Cuando entrenas con Ultralytics, el modelo aprende las 257 clases. Cada categoría contiene al menos 80 imágenes, pero el tamaño de las clases está desequilibrado: la más grande contiene hasta unas 800 imágenes.Caltech-256 no tiene una división predefinida. La primera vez que entrenas, Ultralytics lo divide automáticamente en un 80 % para entrenamiento y un 20 % para validación —aproximadamente 24.385 imágenes de entrenamiento y 6.222 de validación—, por lo que no necesitas crear las divisiones manualmente. Para controlar tú mismo la división, organiza las imágenes en las carpetas
train/yval/antes del entrenamiento.Sí. Ultralytics Platform te permite gestionar conjuntos de datos, entrenar modelos de clasificación de imágenes y desplegarlos sin necesidad de programar mucho. Es una forma práctica de ejecutar experimentos con Caltech-256 en la nube, y puedes consultar más opciones en nuestra guía general de conjuntos de datos de clasificación.