Conjunto de datos TT100K#
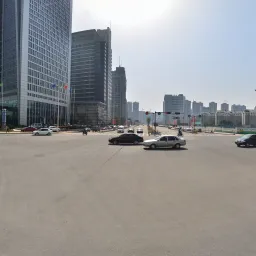
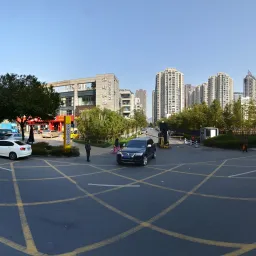
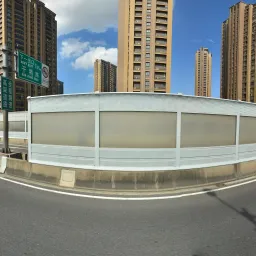
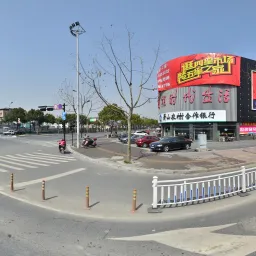
El conjunto de datos Tsinghua-Tencent 100K (TT100K) es un conjunto de evaluación de señales de tráfico para la detección de objetos, creado por Zhu et al. para el artículo de CVPR 2016 Traffic-Sign Detection and Classification in the Wild. La configuración TT100K de Ultralytics proporciona 16.817 imágenes (6.105 de entrenamiento / 7.641 de validación / 3.071 de prueba) distribuidas en 221 categorías de señales de tráfico, mientras que el conjunto de evaluación original registra más de 30.000 instancias de señales. El «100K» del nombre hace referencia a las aproximadamente 100.000 imágenes de Tencent Street View a partir de las cuales se creó el conjunto de evaluación, no al número de imágenes que descargas y utilizas para entrenar. Como el artículo original conserva únicamente las categorías con al menos 100 instancias de entrenamiento, existe un subconjunto habitual de 45 clases, pero la configuración de Ultralytics conserva las 221 categorías anotadas, muchas de ellas escasas.
Las imágenes de Street View de alta resolución capturan grandes variaciones de iluminación, condiciones meteorológicas, ángulo de visión y distancia, lo que convierte TT100K en un conjunto de evaluación exigente para la detección de objetos pequeños en escenas de conducción reales.
Características principales#
- Detección multiclase: 221 categorías de señales de tráfico que abarcan señales chinas de limitación de velocidad, prohibición, advertencia, limitación de altura/anchura e informativas.
- Alta resolución: imágenes de 2048×2048 píxeles, por lo que las señales van desde primeros planos grandes hasta indicadores diminutos y lejanos que ponen a prueba la detección detallada.
- Condiciones reales: grandes variaciones de condiciones meteorológicas, iluminación, ángulo de visión y oclusión.
- Anotaciones de cuadros delimitadores: cada señal está etiquetada con una clase y un cuadro delimitador en formato YOLO tras la conversión automática.
- Divisiones predefinidas: divisiones fijas de entrenamiento / validación / prueba (6.105 / 7.641 / 3.071 imágenes) para una evaluación coherente.
Estructura del dataset#
La configuración TT100K de Ultralytics se divide en tres subconjuntos, todos ellos con las mismas 221 categorías:
| Subconjunto | Imágenes | Descripción |
|---|---|---|
| Entrenar | 6,105 | Imágenes etiquetadas de escenas de tráfico utilizadas para entrenar el detector |
| Validación | 7,641 | La división original «other» del conjunto de datos, utilizada para la evaluación |
| Prueba | 3,071 | Imágenes reservadas para la evaluación final del modelo entrenado |
Las 221 categorías se organizan en varios grupos principales:
- Señales de limitación de velocidad — límites prohibitivos
pl*(p. ej., pl5–pl120) y velocidades mínimaspm*(p. ej., pm5–pm55). - Señales prohibitivas — prohibiciones generales
p1–p29, prohibición de entrada/estacionamientopn/pney restriccionespr*(pr10–pr100). - Señales de advertencia —
w1–w67para peligros de la carretera, como cruces, curvas cerradas, calzadas resbaladizas y obras. - Señales de limitación de altura/anchura — límites de altura
ph*(p. ej., ph2–ph5.5) y límites de anchurapb/pw*. - Señales informativas — información general
i1–i15, información sobre límites de velocidadil*(il50–il110), otrasioy paneles informativosip.
Aplicaciones#
TT100K se utiliza ampliamente para desarrollar y evaluar sistemas de reconocimiento de señales de tráfico en condiciones reales. Entre las aplicaciones habituales se incluyen:
- Sistemas de percepción para conducción autónoma
- Sistemas avanzados de asistencia a la conducción (ADAS)
- Monitorización del tráfico y análisis de infraestructuras viarias
- Planificación urbana y estudios del flujo de tráfico
- Investigación en visión artificial sobre objetos pequeños en imágenes de alta resolución
YAML del dataset#
El archivo TT100K.yaml define la configuración del conjunto de datos: las rutas del conjunto de datos, los nombres de las clases y el script de descarga y conversión automáticas. Se mantiene en el repositorio de Ultralytics, en https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/TT100K.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Tsinghua-Tencent 100K (TT100K) dataset https://cg.cs.tsinghua.edu.cn/traffic-sign/ by Tsinghua University
# Documentation: https://cg.cs.tsinghua.edu.cn/traffic-sign/tutorial.html
# Paper: Traffic-Sign Detection and Classification in the Wild (CVPR 2016)
# License: CC BY-NC 2.0 license for non-commercial use only
# Example usage: yolo train data=TT100K.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── TT100K ← downloads here (~18 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: TT100K # dataset root dir
train: images/train # train images (relative to 'path') 6105 images
val: images/val # val images (relative to 'path') 7641 images (original 'other' split)
test: images/test # test images (relative to 'path') 3071 images

# Classes (221 traffic sign categories, 45 with sufficient training instances)
names:
  0: i1
  1: i10
  2: i11
  3: i12
  4: i13
  5: i14
  6: i15
  7: i2
  8: i3
  9: i4
  10: i5
  11: il100
  12: il110
  13: il50
  14: il60
  15: il70
  16: il80
  17: il90
  18: io
  19: ip
  20: p1
  21: p10
  22: p11
  23: p12
  24: p13
  25: p14
  26: p15
  27: p16
  28: p17
  29: p18
  30: p19
  31: p2
  32: p20
  33: p21
  34: p22
  35: p23
  36: p24
  37: p25
  38: p26
  39: p27
  40: p28
  41: p3
  42: p4
  43: p5
  44: p6
  45: p7
  46: p8
  47: p9
  48: pa10
  49: pa12
  50: pa13
  51: pa14
  52: pa8
  53: pb
  54: pc
  55: pg
  56: ph1.5
  57: ph2
  58: ph2.1
  59: ph2.2
  60: ph2.4
  61: ph2.5
  62: ph2.8
  63: ph2.9
  64: ph3
  65: ph3.2
  66: ph3.5
  67: ph3.8
  68: ph4
  69: ph4.2
  70: ph4.3
  71: ph4.5
  72: ph4.8
  73: ph5
  74: ph5.3
  75: ph5.5
  76: pl10
  77: pl100
  78: pl110
  79: pl120
  80: pl15
  81: pl20
  82: pl25
  83: pl30
  84: pl35
  85: pl40
  86: pl5
  87: pl50
  88: pl60
  89: pl65
  90: pl70
  91: pl80
  92: pl90
  93: pm10
  94: pm13
  95: pm15
  96: pm1.5
  97: pm2
  98: pm20
  99: pm25
  100: pm30
  101: pm35
  102: pm40
  103: pm46
  104: pm5
  105: pm50
  106: pm55
  107: pm8
  108: pn
  109: pne
  110: po
  111: pr10
  112: pr100
  113: pr20
  114: pr30
  115: pr40
  116: pr45
  117: pr50
  118: pr60
  119: pr70
  120: pr80
  121: ps
  122: pw2
  123: pw2.5
  124: pw3
  125: pw3.2
  126: pw3.5
  127: pw4
  128: pw4.2
  129: pw4.5
  130: w1
  131: w10
  132: w12
  133: w13
  134: w16
  135: w18
  136: w20
  137: w21
  138: w22
  139: w24
  140: w28
  141: w3
  142: w30
  143: w31
  144: w32
  145: w34
  146: w35
  147: w37
  148: w38
  149: w41
  150: w42
  151: w43
  152: w44
  153: w45
  154: w46
  155: w47
  156: w48
  157: w49
  158: w5
  159: w50
  160: w55
  161: w56
  162: w57
  163: w58
  164: w59
  165: w60
  166: w62
  167: w63
  168: w66
  169: w8
  170: wo
  171: i6
  172: i7
  173: i8
  174: i9
  175: ilx
  176: p29
  177: w29
  178: w33
  179: w36
  180: w39
  181: w4
  182: w40
  183: w51
  184: w52
  185: w53
  186: w54
  187: w6
  188: w61
  189: w64
  190: w65
  191: w67
  192: w7
  193: w9
  194: pax
  195: pd
  196: pe
  197: phx
  198: plx
  199: pmx
  200: pnl
  201: prx
  202: pwx
  203: w11
  204: w14
  205: w15
  206: w17
  207: w19
  208: w2
  209: w23
  210: w25
  211: w26
  212: w27
  213: pl0
  214: pl4
  215: pl3
  216: pm2.5
  217: ph4.4
  218: pn40
  219: ph3.3
  220: ph2.6

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import json
  import shutil
  from pathlib import Path

  from PIL import Image

  from ultralytics.utils import TQDM
  from ultralytics.utils.downloads import download

  def tt100k2yolo(dir):
      """Convert TT100K annotations to YOLO format with images/{split} and labels/{split} structure."""
      data_dir = dir / "data"
      anno_file = data_dir / "annotations.json"

      print("Loading annotations...")
      with open(anno_file, encoding="utf-8") as f:
          data = json.load(f)

      # Build class name to index mapping from yaml
      names = yaml["names"]
      class_to_idx = {v: k for k, v in names.items()}

      # Create directories
      for split in ["train", "val", "test"]:
          (dir / "images" / split).mkdir(parents=True, exist_ok=True)
          (dir / "labels" / split).mkdir(parents=True, exist_ok=True)

      print("Converting annotations to YOLO format...")
      skipped = 0
      for img_id, img_data in TQDM(data["imgs"].items(), desc="Processing"):
          img_path_str = img_data["path"]
          if "train" in img_path_str:
              split = "train"
          elif "test" in img_path_str:
              split = "test"
          else:
              split = "val"

          # Source and destination paths
          src_img = data_dir / img_path_str
          if not src_img.exists():
              continue

          dst_img = dir / "images" / split / src_img.name

          # Get image dimensions
          try:
              with Image.open(src_img) as img:
                  img_width, img_height = img.size
          except Exception as e:
              print(f"Error reading {src_img}: {e}")
              continue

          # Copy image to destination
          shutil.copy2(src_img, dst_img)

          # Convert annotations
          label_file = dir / "labels" / split / f"{src_img.stem}.txt"
          lines = []

          for obj in img_data.get("objects", []):
              category = obj["category"]
              if category not in class_to_idx:
                  skipped += 1
                  continue

              bbox = obj["bbox"]
              xmin, ymin = bbox["xmin"], bbox["ymin"]
              xmax, ymax = bbox["xmax"], bbox["ymax"]

              # Convert to YOLO format (normalized center coordinates and dimensions)
              x_center = ((xmin + xmax) / 2.0) / img_width
              y_center = ((ymin + ymax) / 2.0) / img_height
              width = (xmax - xmin) / img_width
              height = (ymax - ymin) / img_height

              # Clip to valid range
              x_center = max(0, min(1, x_center))
              y_center = max(0, min(1, y_center))
              width = max(0, min(1, width))
              height = max(0, min(1, height))

              cls_idx = class_to_idx[category]
              lines.append(f"{cls_idx} {x_center:.6f} {y_center:.6f} {width:.6f} {height:.6f}\n")

          # Write label file
          if lines:
              label_file.write_text("".join(lines), encoding="utf-8")

      if skipped:
          print(f"Skipped {skipped} annotations with unknown categories")
      print("Conversion complete!")

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  urls = ["https://cg.cs.tsinghua.edu.cn/traffic-sign/data_model_code/data.zip"]
  download(urls, dir=dir, curl=True, threads=1)

  # Convert
tt100k2yolo(dir)Uso#
TT100K se descarga automáticamente la primera vez que entrenas y requiere unos 18 GB de espacio libre en disco. En el primer uso, el script de descarga obtiene los datos originales y convierte las anotaciones al formato YOLO, lo que puede tardar varios minutos.
Para entrenar un modelo YOLO26n con el conjunto de datos TT100K durante 100 épocas y con un tamaño de imagen de 640, puedes utilizar los siguientes fragmentos de código. Para consultar una lista completa de los argumentos disponibles, ve a la página de entrenamiento del modelo.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n.pt")  # load a pretrained model (recommended for training)

# Train the model - dataset will auto-download on first run
results = model.train(data="TT100K.yaml", epochs=100, imgsz=640)
Para etiquetar imágenes adicionales de señales de tráfico y gestionar las ejecuciones de entrenamiento de TT100K en el navegador, utiliza Ultralytics Platform.
Datos de ejemplo y anotaciones#
Las imágenes de TT100K son escenas urbanas de 2048×2048 en las que las señales de tráfico suelen ocupar solo una pequeña parte del encuadre. Una sola imagen puede contener varias señales a diferentes escalas y distancias; algunas pueden estar parcialmente ocultas por vehículos, vegetación o estructuras, y haberse capturado de día o de noche, con condiciones despejadas o lluviosas. Esta combinación de objetos pequeños y condiciones difíciles es lo que convierte el conjunto de datos en una prueba exigente de la robustez del detector.
Citas y agradecimientos#
Si utilizas el conjunto de datos TT100K en tu trabajo de investigación o desarrollo, cita el siguiente artículo:
@InProceedings{Zhu_2016_CVPR,
    author = {Zhu, Zhe and Liang, Dun and Zhang, Songhai and Huang, Xiaolei and Li, Baoli and Hu, Shimin},
    title = {Traffic-Sign Detection and Classification in the Wild},
    booktitle = {The IEEE Conference on Computer Vision and Pattern Recognition (CVPR)},
    month = {June},
    year = {2016}
}
Nos gustaría reconocer la colaboración entre la Universidad de Tsinghua y Tencent por crear y mantener este valioso recurso para las comunidades de visión artificial y conducción autónoma. Para obtener más información sobre el conjunto de datos TT100K, visita el sitio web oficial del conjunto de datos.
Preguntas frecuentes#
El conjunto de datos Tsinghua-Tencent 100K (TT100K) se utiliza para la detección y clasificación de señales de tráfico en condiciones reales. Sus 221 categorías y sus imágenes de Street View de alta resolución lo convierten en un conjunto de evaluación habitual para la percepción en conducción autónoma, los sistemas avanzados de asistencia a la conducción (ADAS) y la investigación sobre detección de objetos pequeños.
La configuración TT100K de Ultralytics contiene 16.817 imágenes: 6.105 para entrenamiento, 7.641 para validación (la división original «other» del conjunto de datos) y 3.071 para pruebas. Consulta la sección Estructura del conjunto de datos para ver el desglose completo.
El «100K» hace referencia a las aproximadamente 100.000 imágenes de Tencent Street View a partir de las cuales se creó el conjunto de evaluación original. La configuración de detección de Ultralytics proporciona 16.817 de esas imágenes con etiquetas en formato YOLO; el nombre refleja la colección de origen, no el tamaño del conjunto de entrenamiento.
TT100K define 221 categorías que abarcan señales de limitación de velocidad, prohibitivas, de advertencia, de limitación de altura/anchura e informativas. El artículo original conserva únicamente las 45 categorías con al menos 100 instancias de entrenamiento, pero la configuración de Ultralytics mantiene las 221. Consulta Estructura del conjunto de datos para ver el desglose por grupos.
TT100K ocupa unos 18 GB y se descarga automáticamente la primera vez que entrenas con
data="TT100K.yaml", por lo que no es necesario descargarlo manualmente. El script también convierte las anotaciones originales al formato YOLO durante la primera ejecución.Entrena un modelo YOLO26n con TT100K durante 100 épocas y con un tamaño de imagen de 640:
Ejemplo de entrenamientofrom ultralytics import YOLO # Load a model model = YOLO("yolo26n.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="TT100K.yaml", epochs=100, imgsz=640)Para consultar configuraciones detalladas, ve a la página de entrenamiento y a los consejos para entrenar modelos.
Empieza con
imgsz=640para los experimentos iniciales y, después, aumenta aimgsz=1280(con un valor menor debatch) si tienes suficiente memoria de GPU, ya que la mayor resolución ayuda a recuperar señales pequeñas y lejanas:model.train(data="TT100K.yaml", imgsz=1280, batch=4) # higher resolution for small signsTambién puedes ajustar el aumento de datos y considerar estrategias de división en teselas para objetos muy pequeños. Consulta Consejos para entrenar modelos para obtener más información.