Conjunto de datos COCO128-Seg#
Introducción#
COCO128-Seg de Ultralytics es un conjunto de datos de segmentación de instancias pequeño pero versátil, compuesto por las 128 primeras imágenes del conjunto COCO train 2017. Es ideal para probar y depurar modelos de segmentación o experimentar con nuevos enfoques de segmentación. Con 128 imágenes, es fácil de manejar, pero lo bastante diverso como para probar si las canalizaciones de entrenamiento tienen errores y comprobar que todo funciona correctamente antes de entrenar con conjuntos de datos más grandes.
Estructura del conjunto de datos#
- Imágenes: 128 en total, con los conjuntos de entrenamiento y validación divididos de forma idéntica (consulta la nota siguiente).
- Clases: las mismas 80 categorías de objetos que COCO.
- Etiquetas: polígonos en formato YOLO almacenados en
labels/train2017para el directorio compartido de imágenes de entrenamiento y validación. - Tamaño de la descarga: ~7 MB.
El archivo YAML predeterminado asigna las mismas 128 imágenes a entrenamiento y validación, por lo que las métricas de validación miden el ajuste al conjunto de entrenamiento, no la generalización a datos reservados. Si necesitas un conjunto de datos reservado para una evaluación real, duplica o personaliza la división.
Este conjunto de datos está pensado para utilizarse con Ultralytics Platform y YOLO26.
YAML del conjunto de datos#
Se utiliza un archivo YAML para definir la configuración del conjunto de datos. Contiene información sobre las rutas, las clases y otros datos relevantes del conjunto. En el caso del conjunto de datos COCO128-Seg, el archivo coco128-seg.yaml se mantiene en https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco128-seg.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO128-seg dataset https://www.kaggle.com/datasets/ultralytics/coco128 (first 128 images from COCO train2017) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/segment/coco128-seg
# Example usage: yolo train data=coco128-seg.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco128-seg ← downloads here (7 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco128-seg # dataset root dir
train: images/train2017 # train images (relative to 'path') 128 images
val: images/train2017 # val images (relative to 'path') 128 images
test: # test images (optional)

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/coco128-seg.zipUso#
Para entrenar un modelo YOLO26n-seg con el conjunto de datos COCO128-Seg durante 100 épocas y con un tamaño de imagen de 640, puedes utilizar los siguientes fragmentos de código. Consulta la página de entrenamiento del modelo para ver una lista completa de los argumentos disponibles.
from ultralytics import YOLO

# Cargar un modelo
model = YOLO("yolo26n-seg.pt")  # Carga un modelo preentrenado (recomendado para el entrenamiento)

# Entrenar el modelo
results = model.train(data="coco128-seg.yaml", epochs=100, imgsz=640)
Imágenes de muestra y anotaciones#
Aquí tienes algunos ejemplos de imágenes del conjunto de datos COCO128-Seg junto con sus anotaciones correspondientes:
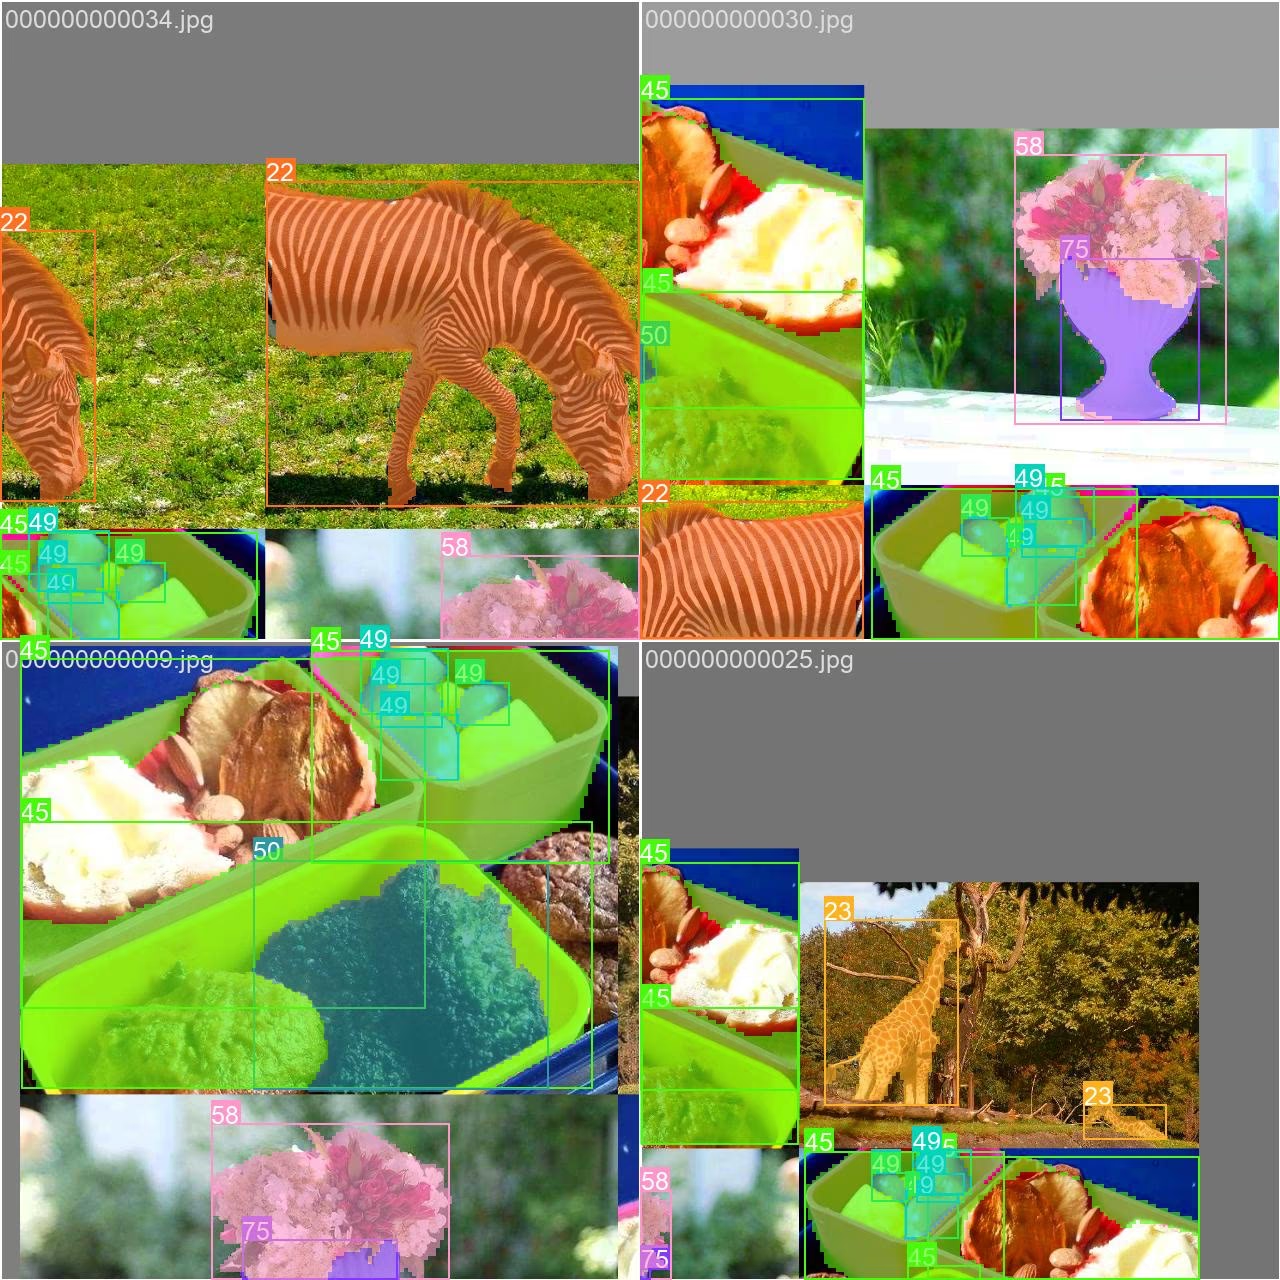
- Imagen en mosaico: Esta imagen muestra un lote de entrenamiento compuesto por imágenes del conjunto de datos dispuestas en mosaico. El mosaico es una técnica que se utiliza durante el entrenamiento para combinar varias imágenes en una sola y aumentar la variedad de objetos y escenas de cada lote de entrenamiento. Esto ayuda a mejorar la capacidad del modelo para generalizar a distintos tamaños de objetos, relaciones de aspecto y contextos.
Citas y agradecimientos#
Si utilizas el conjunto de datos COCO en tu trabajo de investigación o desarrollo, cita el siguiente artículo:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Queremos dar las gracias al Consorcio COCO por crear y mantener este valioso recurso para la comunidad de visión artificial. Para obtener más información sobre el conjunto de datos COCO y sus creadores, visita el sitio web del conjunto de datos COCO.
Preguntas frecuentes#
El conjunto de datos COCO128-Seg es un conjunto compacto de segmentación de instancias de Ultralytics, compuesto por las 128 primeras imágenes del conjunto COCO train 2017. Está diseñado para probar y depurar modelos de segmentación o experimentar con nuevos métodos de segmentación. Es especialmente útil con YOLO26 y Platform de Ultralytics para iterar rápidamente y detectar errores en la canalización antes de ampliarla a conjuntos de datos más grandes. Consulta la página de entrenamiento del modelo para obtener información detallada sobre su uso.
Para entrenar un modelo YOLO26n-seg con el conjunto de datos COCO128-Seg durante 100 épocas y con un tamaño de imagen de 640, puedes utilizar Python o comandos de CLI. Aquí tienes un ejemplo rápido:
Ejemplo de entrenamientofrom ultralytics import YOLO # Cargar un modelo model = YOLO("yolo26n-seg.pt") # Carga un modelo preentrenado (recomendado para el entrenamiento) # Entrenar el modelo results = model.train(data="coco128-seg.yaml", epochs=100, imgsz=640)Para obtener una explicación detallada de los argumentos y las opciones de configuración disponibles, consulta la documentación de entrenamiento.
Como la descarga y el ciclo de entrenamiento/validación son mucho más pequeños que con COCO completo, COCO128-Seg te permite realizar una comprobación de una época en una canalización nueva —verificando que el modelo se entrena y valida, y que guarda correctamente los puntos de control— antes de ampliarla al conjunto de datos COCO-Seg completo. Obtén más información sobre los formatos de conjuntos de datos compatibles en la guía de conjuntos de datos de segmentación de Ultralytics.
El archivo de configuración YAML del conjunto de datos COCO128-Seg está disponible en el repositorio de Ultralytics. Puedes acceder directamente al archivo en https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/coco128-seg.yaml. El archivo YAML incluye información esencial sobre las rutas y las clases del conjunto de datos, así como los ajustes de configuración necesarios para entrenar y validar el modelo.
COCO128-Seg (128 imágenes) tiene un tamaño intermedio entre COCO8-Seg (8 imágenes) y el conjunto de datos COCO-Seg completo (118.287 imágenes de entrenamiento):
- COCO8-Seg: 8 imágenes (4 de entrenamiento, 4 de validación); ideal para comprobaciones rápidas y depuración.
- COCO128-Seg: 128 imágenes; un equilibrio entre tamaño y diversidad, con los conjuntos de entrenamiento y validación en el mismo directorio.
- COCO-Seg completo: 118.287 imágenes de entrenamiento; completo, pero requiere muchos recursos y ocupa ~20 GB en la primera descarga.
COCO128-Seg ofrece más diversidad que COCO8-Seg y sigue siendo mucho más manejable que el conjunto de datos COCO-Seg completo para experimentar y desarrollar modelos inicialmente.