Guía para usar Kaggle y entrenar tus modelos YOLO26
Si estás aprendiendo sobre IA y trabajando en proyectos pequeños, puede que aún no tengas acceso a recursos informáticos potentes, y el hardware de gama alta puede ser caro. Kaggle, una plataforma propiedad de Google, ofrece un entorno gratuito en la nube donde puedes acceder a recursos de GPU, gestionar grandes conjuntos de datos y colaborar con una comunidad diversa de científicos de datos y entusiastas del aprendizaje automático.
Kaggle es una opción práctica para entrenar y experimentar con los modelos Ultralytics YOLO26. Kaggle Notebooks incluye preinstaladas las bibliotecas y los marcos de aprendizaje automático más populares. Esta guía explora las principales funciones de Kaggle y muestra cómo entrenar modelos YOLO26 en la plataforma.
¿Qué es Kaggle?#
Kaggle es una plataforma que reúne a científicos de datos de todo el mundo para colaborar, aprender y competir en la resolución de problemas reales de ciencia de datos. Anthony Goldbloom y Jeremy Howard la lanzaron en 2010 y Google la adquirió en 2017. Kaggle permite a los usuarios conectar, descubrir y compartir conjuntos de datos, usar notebooks con GPU y participar en competiciones de ciencia de datos. La plataforma está dirigida tanto a profesionales con experiencia como a personas que están aprendiendo.
Con más de 10 millones de usuarios en 2022, Kaggle ofrece un entorno completo para desarrollar y experimentar con modelos de aprendizaje automático. No tienes que preocuparte por las especificaciones ni la configuración de tu equipo local; solo necesitas una cuenta de Kaggle y un navegador web.
Instalación#
Antes de empezar a entrenar modelos YOLO26 en Kaggle, tienes que asegurarte de que el entorno de notebooks esté bien configurado. Sigue estos pasos:
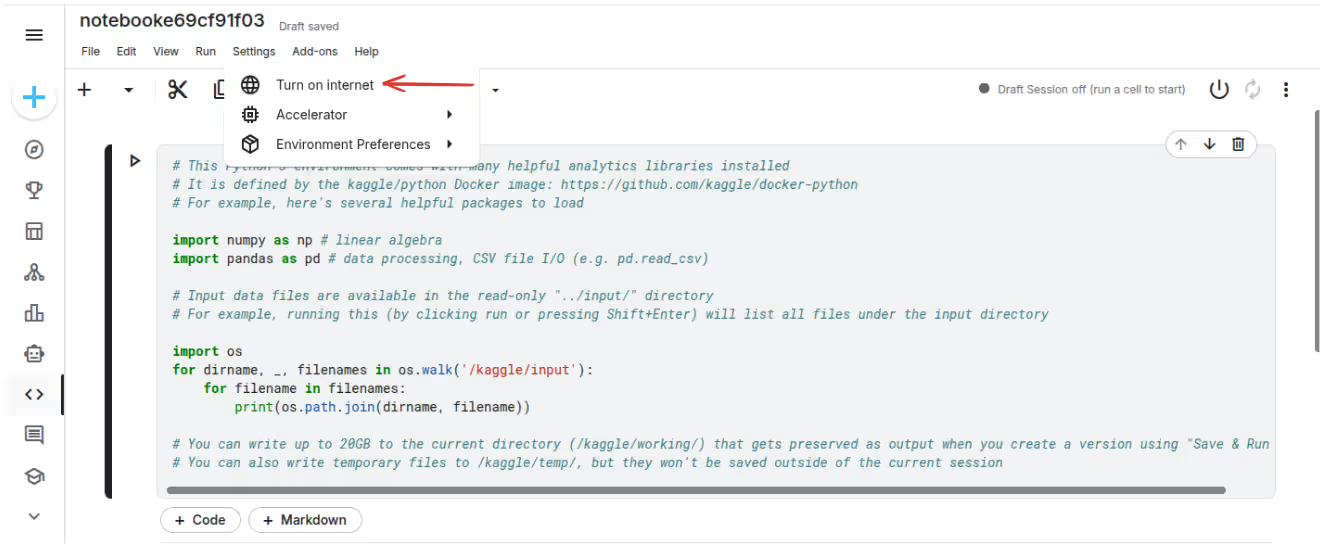
Activa el acceso a Internet#
Los cuadernos de Kaggle necesitan acceso a Internet para descargar paquetes y dependencias. Para activar Internet en tu cuaderno de Kaggle:
- Abre tu cuaderno de Kaggle
- Haz clic en el panel Settings, situado a la derecha de la interfaz del cuaderno
- Desplázate hacia abajo hasta la sección Internet
- Activa el interruptor para ponerlo en ON y habilitar la conexión a Internet
Nota: Necesitas acceso a Internet para instalar el paquete Ultralytics y descargar modelos o conjuntos de datos preentrenados. Si no tienes conexión a Internet, la instalación de paquetes fallará.
Instalación de Ultralytics#
Cuando hayas activado el acceso a Internet, instala el paquete de Ultralytics ejecutando el siguiente comando en una celda del cuaderno:
!pip install ultralyticsPara instalar la versión de desarrollo más reciente, puedes hacerlo directamente desde GitHub:
!pip install git+https://github.com/ultralytics/ultralytics.gitResolución de conflictos entre dependencias#
Durante la instalación, puede que encuentres conflictos entre dependencias, especialmente con paquetes como opencv-python, numpy o torch. Estas son algunas soluciones habituales:
Método 1: Reinstalación forzada con --upgrade#
Si tienes conflictos con paquetes ya instalados, fuerza una actualización:
!pip install --upgrade --force-reinstall ultralyticsMétodo 2: reiniciar el kernel después de la instalación#
A veces, tienes que reiniciar el kernel después de la instalación para resolver problemas de importación:
!pip install ultralytics
# Then click "Restart Kernel" from the notebook menu
Soluciones a errores habituales#
Error: "No module named 'ultralytics'"
- Solución: Asegúrate de que Internet esté activado y vuelve a ejecutar el comando de instalación
- Reinicia el kernel después de la instalación
Error: "ERROR: pip's dependency resolver does not currently take into account..."
- Solución: Suele ser un aviso que puedes ignorar sin problema. Por lo general, la instalación se completa correctamente a pesar del mensaje
Error: "ModuleNotFoundError" después de la instalación
- Solución: Reinicia el kernel con el botón de reinicio de la interfaz del cuaderno
- Vuelve a ejecutar las instrucciones de importación en una celda nueva
Verificación de la instalación#
Después de la instalación, comprueba que Ultralytics se haya instalado correctamente ejecutando:
import ultralytics

ultralytics.checks()
Se mostrarán los datos del sistema y se comprobará que todas las dependencias estén instaladas correctamente.
Entrenamiento de YOLO26 con Kaggle#
Las GPU gratuitas de Kaggle facilitan el entrenamiento de modelos YOLO26.
Para empezar, abre el notebook del tutorial de Ultralytics YOLO26 en Kaggle. El entorno de Kaggle incluye bibliotecas preinstaladas como TensorFlow y PyTorch, lo que simplifica la configuración.
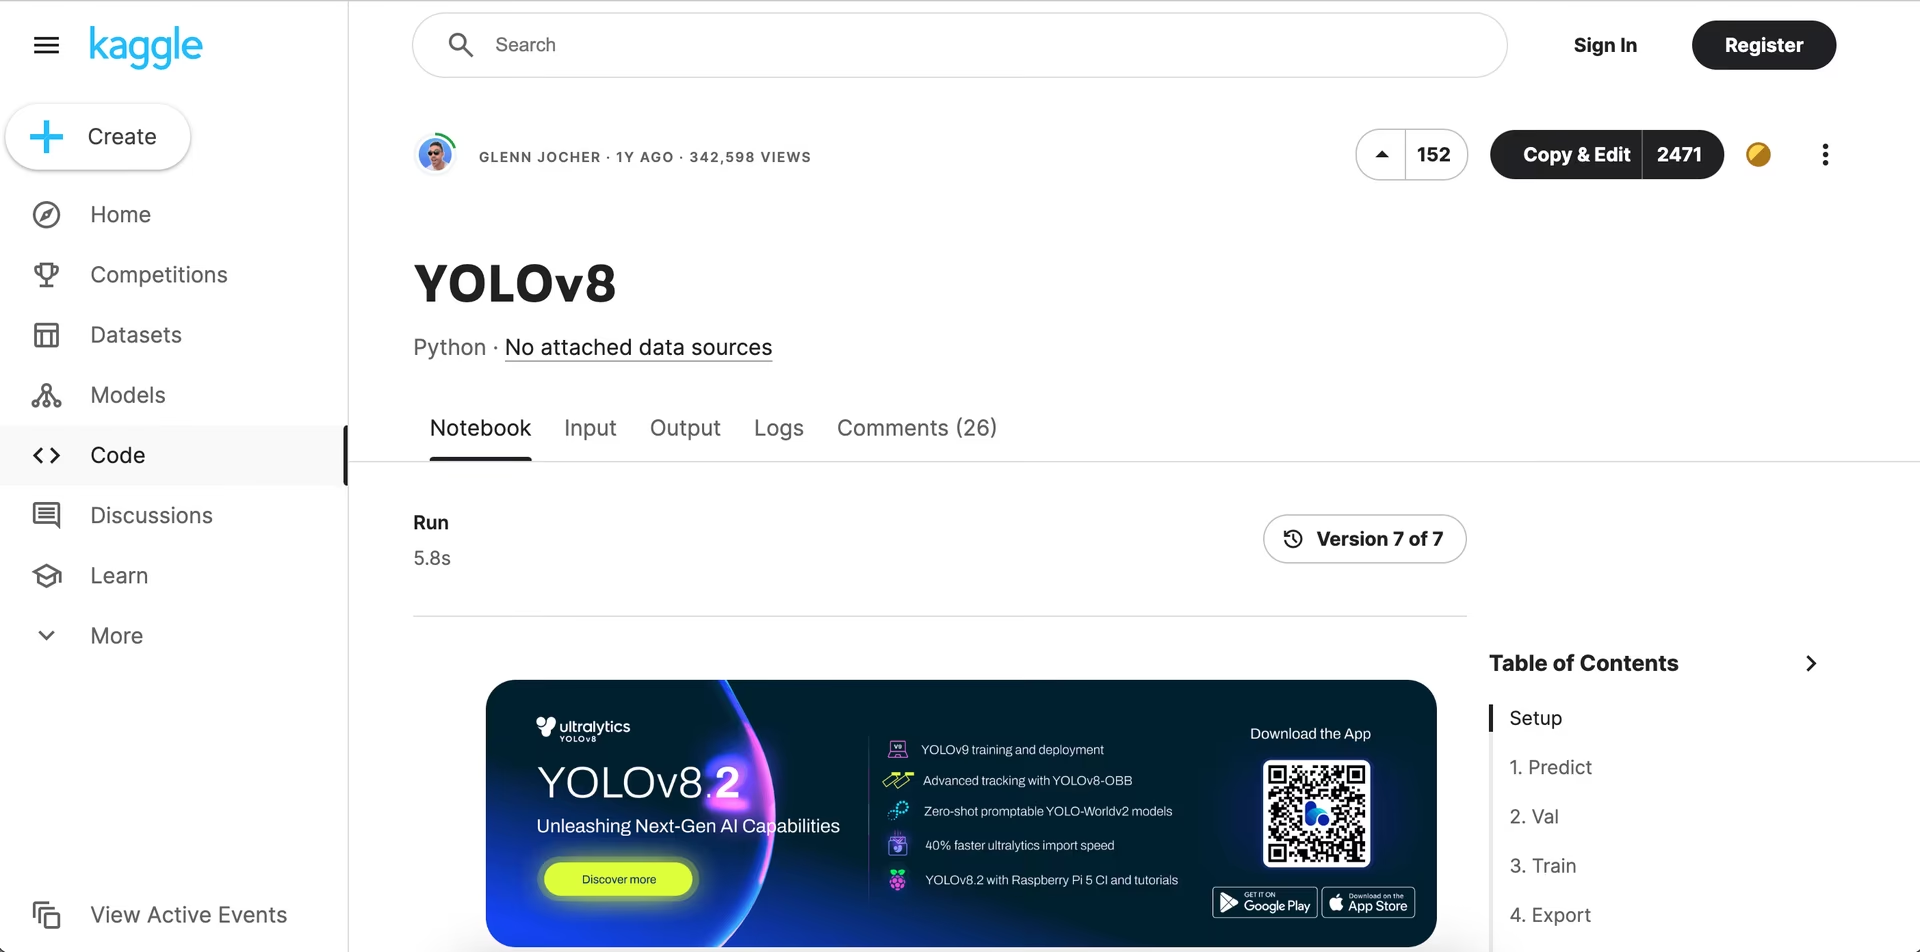
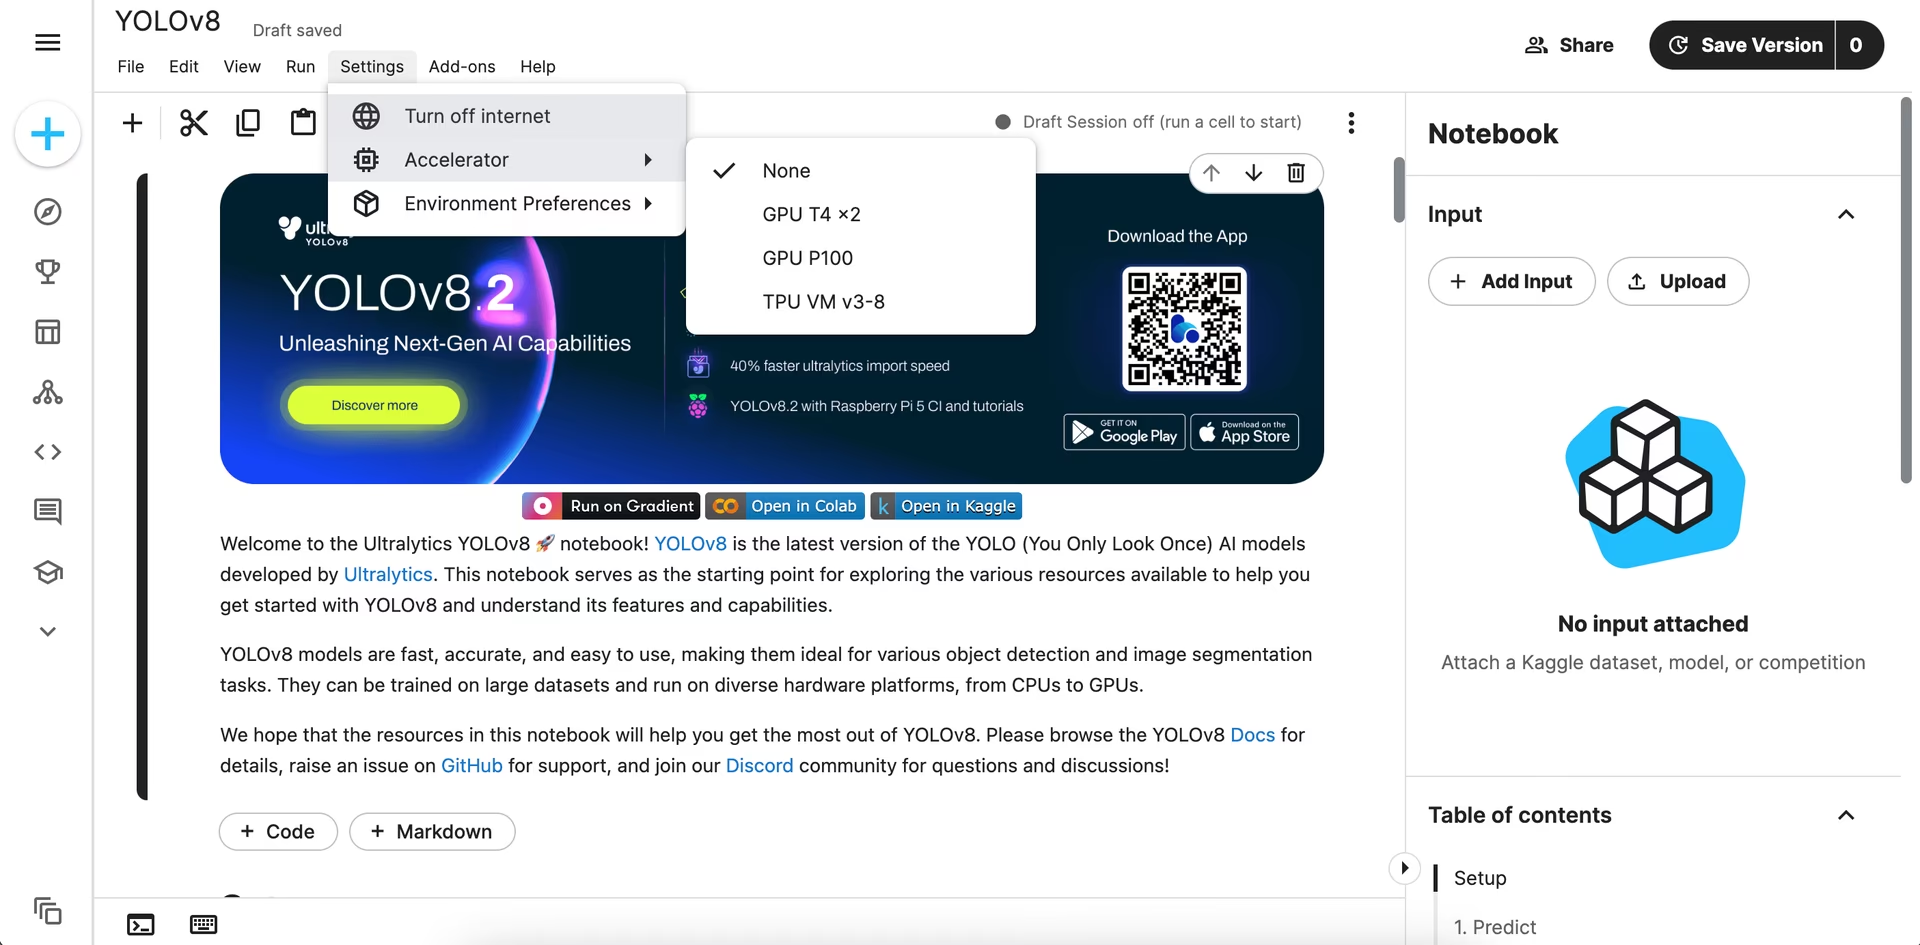
Cuando inicies sesión en tu cuenta de Kaggle, el cuaderno se abrirá como una copia propia que podrás editar: selecciona una GPU en la configuración del acelerador y ejecuta las celdas del cuaderno para empezar a entrenar el modelo. Para comprender en detalle el proceso de entrenamiento del modelo y las prácticas recomendadas, consulta nuestra guía de entrenamiento de modelos YOLO26.
Problemas habituales al trabajar con Kaggle#
Al trabajar con Kaggle, puedes encontrarte con algunos problemas habituales. Estos son algunos puntos clave que te ayudarán a desenvolverte en la plataforma:
- Acceso a GPU: En tus notebooks de Kaggle puedes activar una GPU en cualquier momento y usarla hasta 30 horas a la semana. Kaggle proporciona una GPU NVIDIA Tesla P100 con 16 GB de memoria y también ofrece una opción NVIDIA T4 x2. La aceleración por GPU hace que el entrenamiento y la inferencia de modelos sean mucho más rápidos.
- Kaggle Kernels: Kaggle Kernels son servidores gratuitos de cuadernos Jupyter que pueden integrar GPU y permiten realizar operaciones de aprendizaje automático en ordenadores en la nube. No tienes que depender de la CPU de tu propio ordenador, así evitas sobrecargarlo y liberas recursos locales.
- Conjuntos de datos de Kaggle: Los conjuntos de datos de Kaggle se pueden descargar gratis. Sin embargo, es importante comprobar la licencia de cada conjunto de datos para conocer las restricciones de uso. Algunos pueden tener limitaciones para publicaciones académicas o usos comerciales. Puedes descargar conjuntos de datos directamente en tu cuaderno de Kaggle o en cualquier otro lugar mediante la API de Kaggle.
- Guardar y confirmar cuadernos: Para guardar y confirmar un cuaderno en Kaggle, haz clic en «Save Version». Así se guarda el estado actual del cuaderno. Cuando el kernel en segundo plano termine de generar los archivos de salida, podrás acceder a ellos desde la pestaña Output de la página principal del cuaderno.
- Colaboración: Kaggle permite colaborar, pero varios usuarios no pueden editar un cuaderno al mismo tiempo. La colaboración en Kaggle es asíncrona, por lo que los usuarios pueden compartir y editar el mismo cuaderno en distintos momentos.
- Volver a una versión anterior: Si necesitas volver a una versión anterior de tu cuaderno, ábrelo y haz clic en los tres puntos verticales de la esquina superior derecha para seleccionar «View Versions». Busca la versión a la que quieras volver, haz clic en el menú «...» situado a su lado y selecciona «Revert to Version». Cuando el cuaderno vuelva a esa versión, haz clic en «Save Version» para confirmar los cambios.
Funciones clave de Kaggle#
Estas son algunas de las principales funciones que ofrece Kaggle para la ciencia de datos y el aprendizaje automático:
- Conjuntos de datos: Kaggle aloja una amplia colección de conjuntos de datos sobre diversos temas. Puedes buscar y usar estos conjuntos de datos en tus proyectos, lo que resulta especialmente útil para entrenar y probar tus modelos YOLO26.
- Competiciones: Las competiciones de Kaggle permiten a científicos de datos y profesionales del aprendizaje automático resolver problemas reales. Competir te ayuda a mejorar tus habilidades, aprender técnicas nuevas y obtener reconocimiento en la comunidad.
- Acceso gratuito a TPU: Kaggle ofrece acceso gratuito a TPU para los marcos que las admiten. El entrenamiento de Ultralytics YOLO26 se ejecuta en las GPU o la CPU de Kaggle, no en TPU.
- Integración con GitHub: Kaggle te permite conectar tu repositorio de GitHub para subir notebooks y guardar tu trabajo. Esta integración facilita la gestión y el acceso a tus archivos.
- Comunidad y debates: Kaggle cuenta con una amplia comunidad de científicos de datos y profesionales del aprendizaje automático. Los foros de debate y los notebooks compartidos son recursos útiles para aprender y resolver problemas. Puedes pedir ayuda, compartir tus conocimientos y colaborar con otras personas.
¿Por qué deberías usar Kaggle para tus proyectos YOLO26?#
Hay varias plataformas para entrenar y evaluar modelos de aprendizaje automático. Estas son algunas ventajas de usar Kaggle en tus proyectos de aprendizaje automático:
- Cuadernos públicos: Puedes hacer públicos tus cuadernos de Kaggle para que otros usuarios vean, voten, creen bifurcaciones y debatan sobre tu trabajo. Kaggle fomenta la colaboración, los comentarios y el intercambio de ideas, lo que te ayuda a mejorar tus modelos YOLO26.
- Historial completo de confirmaciones de los cuadernos: Kaggle crea un historial detallado de las confirmaciones de tus cuadernos. Así puedes revisar y seguir los cambios a lo largo del tiempo, entender mejor la evolución de tu proyecto y volver a versiones anteriores si lo necesitas.
- Acceso a la consola: Kaggle proporciona una consola que te da más control sobre tu entorno. Esta función te permite realizar varias tareas directamente desde la línea de comandos.
- Disponibilidad de recursos: Cada sesión de edición de cuadernos en Kaggle incluye recursos considerables: 12 horas de ejecución para las sesiones con CPU y GPU, 9 horas para las sesiones con TPU y 20 gigabytes de espacio en disco con guardado automático.
- Programación de cuadernos: Kaggle te permite programar tus cuadernos para que se ejecuten a horas concretas. Puedes automatizar tareas repetitivas sin intervención manual, como entrenar tu modelo a intervalos regulares.
Sigue aprendiendo sobre Kaggle#
Si quieres aprender más sobre Kaggle, aquí tienes algunos recursos útiles que te servirán de guía:
- Kaggle Learn: Descubre una variedad de tutoriales interactivos gratuitos en Kaggle Learn. Estos cursos cubren temas esenciales de ciencia de datos con ejercicios prácticos.
- Primeros pasos con Kaggle: Esta guía te explica los conceptos básicos de Kaggle, desde participar en competiciones hasta crear tu primer notebook.
- Página de Kaggle en Medium: Explora tutoriales, novedades y aportaciones de la comunidad en la página de Kaggle en Medium.
- Entrena modelos Ultralytics YOLO con la integración de Kaggle: Esta entrada del blog muestra cómo usar Kaggle específicamente con los modelos Ultralytics YOLO.
Resumen#
Kaggle ofrece a tus proyectos YOLO26 acceso gratuito a GPU para entrenar y evaluar modelos, además de bibliotecas preinstaladas para que puedas empezar rápidamente. Ultralytics YOLO26 y Kaggle te permiten desarrollar, entrenar y desplegar modelos de visión artificial sin necesidad de hardware caro.
Para obtener más información, visita la documentación de Kaggle.
Preguntas frecuentes#
Para instalar Ultralytics YOLO26 en Kaggle:
- Activar Internet: Ve al panel Settings y activa el interruptor Internet.
- Instalar el paquete: Ejecuta
!pip install ultralyticsen una celda del cuaderno. - Verificar la instalación: Ejecuta
import ultralytics; ultralytics.checks()para confirmarla.
Si encuentras conflictos entre dependencias, prueba
!pip install --upgrade --force-reinstall ultralyticso reinicia el kernel después de la instalación. Para obtener instrucciones detalladas de solución de problemas, consulta la sección de instalación anterior.Entrenar un modelo YOLO26 en Kaggle es sencillo. Primero, abre el cuaderno del tutorial de Ultralytics YOLO26 en Kaggle. Inicia sesión en tu cuenta de Kaggle y selecciona una GPU en la configuración del acelerador. Ejecuta las celdas del cuaderno para empezar el entrenamiento. Para consultar instrucciones más detalladas, consulta nuestra guía de entrenamiento de modelos YOLO26.
Kaggle ofrece varias ventajas para entrenar modelos YOLO26:
- Acceso gratuito a GPU: Usa GPU como la NVIDIA Tesla P100 o la T4 x2 hasta 30 horas a la semana.
- Bibliotecas preinstaladas: Bibliotecas como TensorFlow y PyTorch vienen preinstaladas, lo que simplifica la configuración.
- Colaboración comunitaria: Participa en una amplia comunidad de científicos de datos y entusiastas del aprendizaje automático.
- Control de versiones: Gestiona distintas versiones de tus notebooks y vuelve a versiones anteriores si lo necesitas.
Entre los problemas habituales se incluyen:
- Acceso a GPU: Asegúrate de activar una GPU en la configuración del cuaderno. Kaggle permite usar GPU hasta 30 horas por semana.
- Internet no activado: Asegúrate de activar Internet en el panel Settings antes de instalar paquetes.
- Conflictos de dependencias: usa
!pip install --upgrade --force-reinstall ultralytics. - Licencias de los conjuntos de datos: Comprueba la licencia de cada conjunto de datos para conocer las restricciones de uso.
- Guardar y confirmar cuadernos: Haz clic en «Save Version» para guardar el estado del cuaderno y acceder a los archivos de salida desde la pestaña Output.
- Colaboración: Kaggle permite la colaboración asíncrona; varios usuarios no pueden editar un cuaderno al mismo tiempo.
Para obtener más consejos sobre la solución de problemas, consulta la sección de instalación y nuestra guía de problemas habituales.
Kaggle ofrece varias funciones que la diferencian de Google Colab:
- Cuadernos públicos: Comparte tu trabajo con la comunidad para recibir comentarios y colaborar.
- Historial completo: Sigue los cambios a lo largo del tiempo gracias al historial detallado de confirmaciones de los cuadernos.
- Disponibilidad de recursos: Cada sesión de cuaderno cuenta con recursos considerables, incluidas 12 horas de ejecución para las sesiones con CPU y GPU.
Para volver a una versión anterior:
- Abre el cuaderno y haz clic en los tres puntos verticales de la esquina superior derecha.
- Selecciona «View Versions».
- Busca la versión a la que quieras volver, haz clic en el menú «...» situado a su lado y selecciona «Revert to Version».
- Haz clic en «Save Version» para confirmar los cambios.


Comentarios3
Haz una pregunta, comparte tus resultados o ayuda a otra persona.
md-jawad-117
Hello, I was using the GPU T4 x2 for training my custom RT-DETR model which is infact was twice as fast compared to P100 GPU with just one of them running.🚀🚀 While the second one was idle. Now when I tried to utilize both GPUs using device=[0, 1] & device=[-1, -1], i received an error which persisted as long as I did not restart the kernel. ⛓️💥⛓️💥
from ultralytics import RTDETR
model = RTDETR('/kaggle/working/rtdr.yaml').load('rtdetr-l.pt')
model.info()
results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=32, lr0=0.0001, device=[0,1])
Error Msg: Transferred 725/725 items from pretrained weights DDP: debug command /usr/bin/python3 -m torch.distributed.run --nproc_per_node 2 --master_port 52415 /root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py Traceback (most recent call last): File "/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py", line 6, in from ultralytics.models.rtdetr.train import RTDETRTrainer ModuleNotFoundError: No module named 'ultralytics' Traceback (most recent call last): File "/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py", line 6, in from ultralytics.models.rtdetr.train import RTDETRTrainer ModuleNotFoundError: No module named 'ultralytics' E0601 09:54:34.472000 132 torch/distributed/elastic/multiprocessing/api.py:869] failed (exitcode: 1) local_rank: 0 (pid: 134) of binary: /usr/bin/python3 Traceback (most recent call last): File "", line 198, in _run_module_as_main File "", line 88, in _run_code File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 922, in main() File "/usr/local/lib/python3.11/dist-packages/torch/distributed/elastic/multiprocessing/errors/init.py", line 355, in wrapper return f(*args, **kwargs) ^^^^^^^^^^^^^^^^^^ File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 918, in main run(args) File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 909, in run elastic_launch( File "/usr/local/lib/python3.11/dist-packages/torch/distributed/launcher/api.py", line 138, in call return launch_agent(self._config, self._entrypoint, list(args)) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "/usr/local/lib/python3.11/dist-packages/torch/distributed/launcher/api.py", line 269, in launch_agent raise ChildFailedError( torch.distributed.elastic.multiprocessing.errors.ChildFailedError:
/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py FAILED
Failures: [1]: time : 2025-06-01_09:54:34 host : 9bca5bb85783 rank : 1 (local_rank: 1) exitcode : 1 (pid: 135) error_file: <N/A> traceback : To enable traceback see: https://pytorch.org/docs/stable/elastic/errors.html
Root Cause (first observed failure): [0]: time : 2025-06-01_09:54:34 host : 9bca5bb85783 rank : 0 (local_rank: 0) exitcode : 1 (pid: 134) error_file: <N/A> traceback : To enable traceback see: https://pytorch.org/docs/stable/elastic/errors.html
CalledProcessError Traceback (most recent call last) /tmp/ipykernel_35/2411087223.py in <cell line: 0>() ----> 1 results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=16, lr0=0.0001, device=[0,-1])
/kaggle/working/ultralytics/engine/model.py in train(self, trainer, **kwargs) 795 796 self.trainer.hub_session = self.session # attach optional HUB session --> 797 self.trainer.train() 798 # Update model and cfg after training 799 if RANK in {-1, 0}:
/kaggle/working/ultralytics/engine/trainer.py in train(self) 220 subprocess.run(cmd, check=True) 221 except Exception as e: --> 222 raise e 223 finally: 224 ddp_cleanup(self, str(file))
/kaggle/working/ultralytics/engine/trainer.py in train(self) 218 try: 219 LOGGER.info(f"{colorstr('DDP:')} debug command {' '.join(cmd)}") --> 220 subprocess.run(cmd, check=True) 221 except Exception as e: 222 raise e
/usr/lib/python3.11/subprocess.py in run(input, capture_output, timeout, check, *popenargs, **kwargs) 569 retcode = process.poll() 570 if check and retcode: --> 571 raise CalledProcessError(retcode, process.args, 572 output=stdout, stderr=stderr) 573 return CompletedProcess(process.args, retcode, stdout, stderr)
CalledProcessError: Command '['/usr/bin/python3', '-m', 'torch.distributed.run', '--nproc_per_node', '2', '--master_port', '52415', '/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py']' returned non-zero exit status 1.
 Glenn JocherUltralytics
Thanks for sharing your multi-GPU training issue with RT-DETR on Kaggle! The error you're encountering is related to DDP (Distributed Data Parallel) not being able to find the Ultralytics module in the spawned processes.
This is a known issue on Kaggle when using multi-GPU training with DDP. The spawned processes don't inherit the current environment properly. Here are a few solutions to try:
- Install Ultralytics system-wide before training:
import subprocess subprocess.run(['pip', 'install', '-U', 'ultralytics'], check=True)- Use single GPU with larger batch size instead:
results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=64, lr0=0.0001, device=0)- Try using device='cpu' to verify your setup works, then switch back to single GPU.
Unfortunately, Kaggle's multi-GPU DDP setup can be unreliable due to environment isolation issues. Since you mentioned T4 x2 was already twice as fast as P100 with just one GPU active, you might get better results focusing on optimizing single-GPU training with larger batch sizes or mixed precision training.
Have you tried increasing the batch size on a single T4 GPU to maximize utilization?