Jeu de données Caltech-101#
Le jeu de données Caltech-101 est un benchmark classique de classification d'images composé de 9 144 images couvrant 101 catégories d'objets, auxquelles s'ajoute une classe d'arrière-plan. Chaque catégorie contient environ 40 à 800 images d'objets du monde réel — animaux, véhicules, objets ménagers et personnes — ce qui en fait un benchmark compact mais exigeant pour les modèles de reconnaissance d'objets.
Explore Caltech-101 sur Ultralytics Platform pour prévisualiser des échantillons, examiner les statistiques du jeu de données et le cloner pour l'entraînement.
Caltech-101 est fourni sans division prédéfinie entre entraînement et validation. Les commandes d'entraînement ci-dessous le divisent automatiquement selon une proportion de 80 % pour l'entraînement et 20 % pour la validation, aucune préparation manuelle n'est donc nécessaire.
Fonctionnalités clés#
- Caltech-101 contient 9 144 images couleur réparties sur 101 catégories d'objets, auxquelles s'ajoute une classe
BACKGROUND_Google(102 dossiers de classes au total). - Les catégories couvrent une grande variété d'objets du monde réel, notamment des animaux, des véhicules, des objets ménagers et des personnes.
- Chaque catégorie contient environ 40 à 800 images, les tailles de classes sont donc déséquilibrées.
- Les images ont des dimensions variables, la plupart mesurant approximativement 300x200 pixels (résolution moyenne).
- Caltech-101 est largement utilisé pour évaluer les algorithmes de classification d'images et de reconnaissance d'objets.
Structure du jeu de données#
Caltech-101 est distribué sous la forme de 102 dossiers — un par classe, couvrant 101 catégories d'objets auxquelles s'ajoute une classe BACKGROUND_Google — sans division prédéfinie entre entraînement et validation. Lorsque tu lances l'entraînement, Ultralytics partitionne automatiquement les images afin que les modèles soient entraînés sur l'ensemble des 102 classes, sans configuration manuelle :
- Classes : 102 (101 catégories d'objets + 1 arrière-plan)
- Nombre total d'images : 9 144
- Division entraînement/validation : automatique, 80 % / 20 % (≈7 280 pour l'entraînement, ≈1 864 pour la validation)
- Images par classe : environ 40 à 800 (déséquilibré)
Applications#
Caltech-101 est largement utilisé pour entraîner et évaluer des modèles de classification d'images et de reconnaissance d'objets, notamment les réseaux neuronaux convolutifs (CNNs) et les machines à vecteurs de support (SVMs). L'étendue de ses catégories et ses images propres et annotées en font un benchmark populaire pour la recherche et le prototypage en apprentissage automatique et en vision par ordinateur.
Utilisation#
Entraîne un modèle YOLO sur Caltech-101 pendant 100 époques, avec une taille d'image de 416. Pour consulter la liste complète des arguments disponibles, voir la page Entraînement et le guide de la tâche de classification d'images.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-cls.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="caltech101", epochs=100, imgsz=416)
Exemples d’images et d’annotations#
Le jeu de données Caltech-101 contient des images couleur de haute qualité représentant divers objets, ce qui en fait un jeu de données bien structuré pour les tâches de classification d'images. Voici quelques exemples d'images du jeu de données :
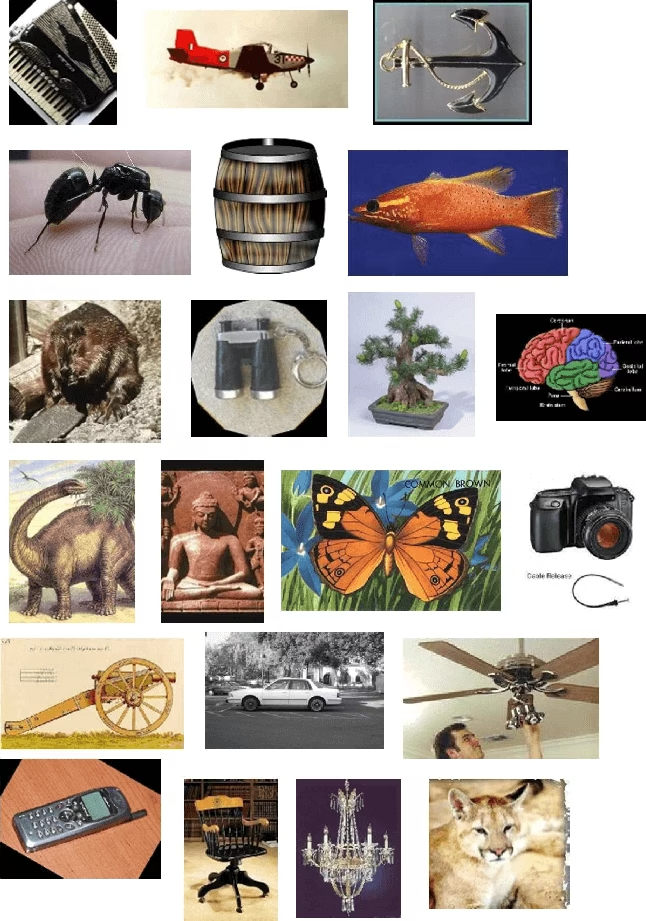
Les échantillons illustrent la variété des catégories ainsi que le cadrage naturel et centré typique de Caltech-101, ce qui en fait un point de départ propre pour entraîner des modèles robustes de reconnaissance d'objets.
Citations et remerciements#
Si tu utilises le jeu de données Caltech-101 dans le cadre de tes travaux de recherche ou de développement, merci de citer l'article suivant :
@article{fei2007learning,
  title={Learning generative visual models from few training examples: An incremental Bayesian approach tested on 101 object categories},
  author={Fei-Fei, Li and Fergus, Rob and Perona, Pietro},
  journal={Computer vision and Image understanding},
  volume={106},
  number={1},
  pages={59--70},
  year={2007},
  publisher={Elsevier}
}
Nous souhaitons remercier Li Fei-Fei, Rob Fergus et Pietro Perona pour avoir créé et assuré la maintenance du jeu de données Caltech-101 en tant que ressource précieuse pour la communauté de recherche en apprentissage automatique et en vision par ordinateur. Pour plus d'informations sur le jeu de données Caltech-101 et ses créateurs, consulte le site web du jeu de données Caltech-101.
FAQ#
Le jeu de données Caltech-101 est largement utilisé pour entraîner et évaluer les modèles de classification d'images et de reconnaissance d'objets. Il contient 9 144 images réparties sur 101 catégories d'objets, auxquelles s'ajoute une classe d'arrière-plan, offrant ainsi un benchmark exigeant pour évaluer des algorithmes tels que les réseaux neuronaux convolutifs (CNNs) et les machines à vecteurs de support (SVMs).
Caltech-101 contient 101 catégories d'objets auxquelles s'ajoute une classe
BACKGROUND_Google, soit 102 dossiers de classes et 9 144 images au total. Lorsque tu entraînes un modèle avec Ultralytics, celui-ci apprend les 102 classes. Les tailles des catégories sont déséquilibrées et vont d'environ 40 à 800 images chacune.Caltech-101 ne possède aucune division prédéfinie. Lors du premier entraînement, Ultralytics le divise automatiquement selon une proportion de 80 % pour l'entraînement et 20 % pour la validation — environ 7 280 images d'entraînement et 1 864 images de validation — tu n'as donc pas besoin de créer les divisions manuellement. Pour contrôler toi-même cette division, organise les images dans les dossiers
train/etval/avant l'entraînement.Oui. Ultralytics Platform te permet de gérer des jeux de données, d'entraîner des modèles de classification d'images et de les déployer sans devoir coder de manière intensive. C'est un moyen pratique d'exécuter des expériences avec Caltech-101 dans le cloud, et tu peux découvrir davantage d'options dans notre présentation des jeux de données de classification.
Pour entraîner un modèle Ultralytics YOLO sur Caltech-101, utilise les extraits de code ci-dessous. Le jeu de données est téléchargé automatiquement lors de la première utilisation. Pour consulter la liste complète des arguments, voir la page Entraînement des modèles.