Jeu de données sur les tumeurs cérébrales
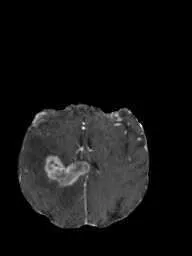
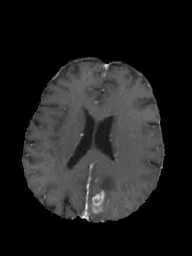
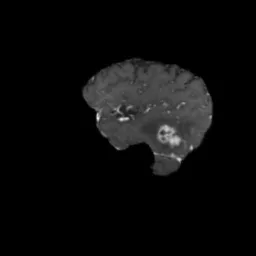

Le jeu de données sur les tumeurs cérébrales d’Ultralytics est un jeu de données de détection d’objets composé de 1 115 images d’IRM cérébrale (994 pour l’entraînement et 121 pour la validation), avec 1 180 boîtes englobantes dans une seule classe, tumor. Chaque image contient de 1 à 3 boîtes de tumeur. L’ensemble de validation contient les images de 25 patients identifiés, et aucun patient identifié n’apparaît dans les deux ensembles. Avec ses 4,06 Mo, ce jeu de données compact convient à l’apprentissage et au prototypage de modèles de vision par ordinateur pour des applications de santé ; il ne s’agit pas d’une ressource diagnostique validée cliniquement.
Regarder : Détection de tumeurs cérébrales avec la plateforme Ultralytics et Ultralytics YOLO26 | Détection d’objets 🚀
Structure du jeu de données#
Le jeu de données sur les tumeurs cérébrales d’Ultralytics contient 1 115 images d’IRM cérébrale et 1 180 boîtes englobantes réparties en deux ensembles définis par la configuration brain-tumor.yaml :
| Partition | Images | Boîtes englobantes | Patients |
|---|---|---|---|
| Entraînement | 994 | 1,057 | 95 avec un identifiant, auxquels s’ajoutent 541 images sans identifiant de patient |
| Validation | 121 | 123 | 25 |
| Total | 1,115 | 1,180 |
Chaque image contient de 1 à 3 boîtes englobantes de la classe unique tumor, et la taille des images varie de 192x256 à 512x512 pixels. La configuration ne définit aucun ensemble de test distinct.
L’ensemble de validation est constitué en fonction des patients. Certains noms de fichiers commencent par un identifiant de patient à cinq chiffres : par exemple, 00097_77.jpg correspond au patient 00097. Les images portant les identifiants de 25 de ces patients constituent l’ensemble de validation, tandis que les images des 95 autres patients identifiés sont incluses dans l’ensemble d’entraînement ; aucun patient identifié n’apparaît donc dans les deux ensembles. Les 541 images restantes n’ont pas d’identifiant de patient dans leur nom de fichier et sont toutes incluses dans l’ensemble d’entraînement.
Le jeu de données est téléchargé automatiquement (4,06 Mo) depuis les ressources GitHub d’Ultralytics lors du premier entraînement ; aucun téléchargement ou préparation manuels ne sont donc nécessaires.
Le jeu de données est passé à une classe unique tumor en novembre 2026. Si ton dossier local brain-tumor/images/train contient 893 images au lieu de 994, supprime le dossier brain-tumor dans ton répertoire de jeux de données (voir datasets_dir dans yolo settings) et mets à jour le paquet avec pip install -U ultralytics. La version actuelle sera alors téléchargée lors du prochain entraînement.
Explore Brain Tumor sur Ultralytics Platform pour parcourir les images avec leurs superpositions d’annotations, consulter la répartition des classes et les cartes thermiques des boîtes englobantes dans l’onglet Charts, puis le cloner afin d’entraîner ton propre modèle dans le cloud.
Applications#
Les modèles de détection des tumeurs cérébrales localisent les tumeurs dans des images d’IRM cérébrale. Avec ses 1 115 images et son téléchargement de 4,06 Mo, le jeu de données sur les tumeurs cérébrales d’Ultralytics convient pour :
- Apprentissage du flux de travail : exécuter le cycle complet d’entraînement, de validation et de prédiction sur des images médicales avec un petit jeu de données.
- Prototypage : créer et tester un pipeline de localisation des tumeurs avant de passer à un jeu de données clinique plus important.
- Évaluation sur des patients identifiés : mesurer la détection sur les 25 patients de validation. Comme 541 images d’entraînement ne portent aucun identifiant de patient, il est impossible d’exclure tout chevauchement avec ces patients.
- Recherche et enseignement : comparer des modèles de détection et étudier l’analyse d’images médicales et l’IA en radiologie.
Les modèles entraînés sur ce jeu de données sont destinés à la recherche et à l’enseignement et ne sont pas validés pour le diagnostic clinique.
Fichier YAML du jeu de données#
La configuration brain-tumor.yaml définit le chemin du jeu de données, les dossiers d’images d’entraînement et de validation, la classe unique tumor et l’URL de téléchargement. Les étiquettes utilisent le format Ultralytics YOLO.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Brain-tumor dataset by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/brain-tumor
# Example usage: yolo train data=brain-tumor.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── brain-tumor ← downloads here (4.06 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: brain-tumor # dataset root dir
train: images/train # train images (relative to 'path') 994 images
val: images/val # val images (relative to 'path') 121 images

# Classes
names:
  0: tumor

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/brain-tumor.zipUtilisation#
Pour entraîner un modèle YOLO26n sur le jeu de données de tumeurs cérébrales pendant 100 époques, avec une taille d’image de 640, utilise les extraits de code ci-dessous.
from ultralytics import YOLO

# Charger un modèle
model = YOLO("yolo26n.pt")  # charger un modèle préentraîné (recommandé pour l’entraînement)

# Entraîner le modèle
results = model.train(data="brain-tumor.yaml", epochs=100, imgsz=640)from ultralytics import YOLO
# Charger un modèle
model = YOLO("path/to/best.pt") # charger un modèle affiné sur les tumeurs cérébrales
# Inférence avec le modèle
results = model.predict("https://ultralytics.com/assets/brain-tumor-sample.jpg")Exemples d’images et annotations#
Voici des exemples d’images du jeu de données sur les tumeurs cérébrales d’Ultralytics, accompagnées de leurs annotations :
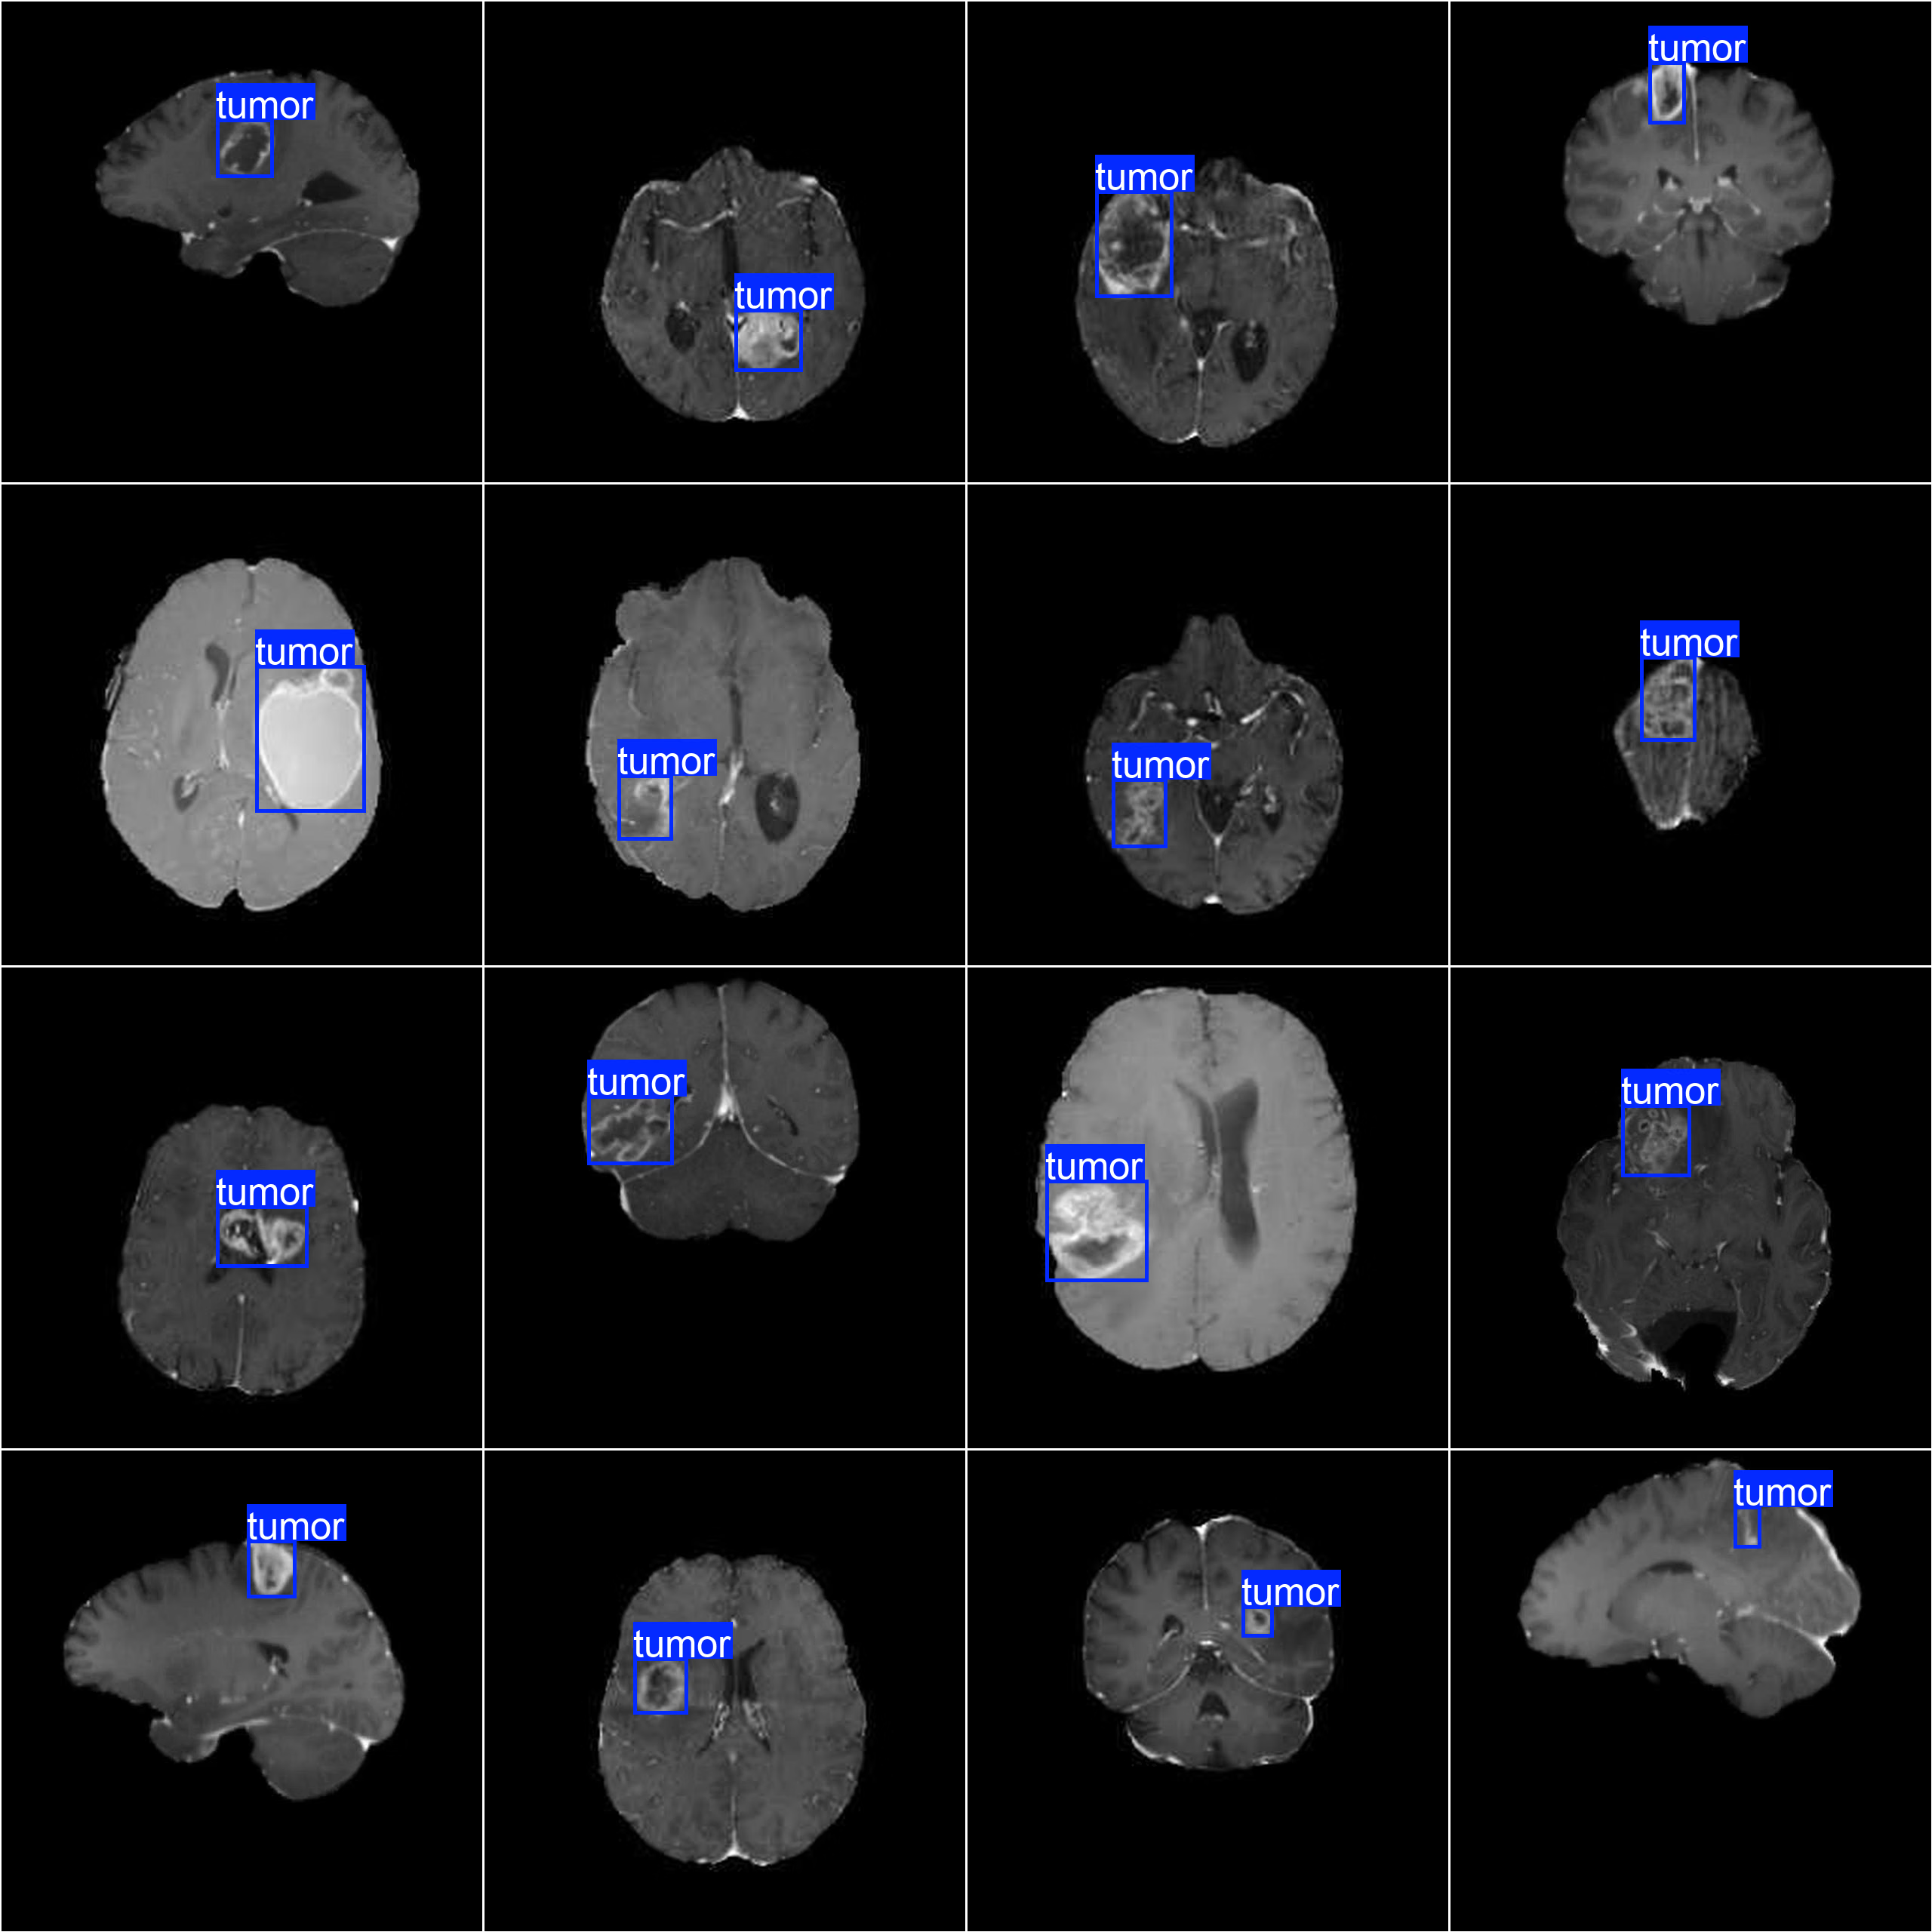
- Images annotées : la grille montre 16 images d’entraînement, chacune avec une boîte englobante
tumorautour de la lésion. La taille, la forme et l’emplacement des tumeurs varient dans le jeu de données, ce qui aide un modèle de détection à généraliser.
Citations et remerciements#
Le jeu de données est disponible sous la licence AGPL-3.0.
Si tu utilises le jeu de données sur les tumeurs cérébrales dans tes travaux de recherche ou de développement, cite-le :
@dataset{Ultralytics_Brain_Tumor_Dataset_2023,
    author = {Ultralytics},
    title = {Brain Tumor Detection Dataset},
    year = {2023},
    publisher = {Ultralytics},
    url = {https://docs.ultralytics.com/datasets/detect/brain-tumor}
}FAQ#
Le jeu de données sur les tumeurs cérébrales d’Ultralytics comprend 1 115 images d’IRM cérébrale et 1 classe,
tumor: 994 images d’entraînement avec 1 057 boîtes englobantes et 121 images de validation avec 123 boîtes englobantes. Chaque image contient de 1 à 3 boîtes, et il n’y a pas d’ensemble de test distinct. Consulte la page Structure du jeu de données pour en savoir plus sur la répartition.Le jeu de données sur les tumeurs cérébrales d’Ultralytics contient des images d’IRM cérébrale et aucune image de tomodensitométrie. La taille des images varie de 192x256 à 512x512 pixels, et chaque image est annotée avec de 1 à 3 boîtes englobantes
tumorau format Ultralytics YOLO.Non, le jeu de données sur les tumeurs cérébrales d’Ultralytics ne contient aucune image sans tumeur ni classe négative. Les 1 115 images comportent toutes de 1 à 3 boîtes englobantes
tumor; un modèle entraîné sur ce jeu de données apprend donc où se trouve une tumeur, et non si un examen est sain. Les modèles entraînés sur ce jeu de données sont destinés à la recherche et à l’enseignement, et non au diagnostic clinique.Le jeu de données sur les tumeurs cérébrales d’Ultralytics est réparti par patient : les 121 images de validation portent les identifiants de 25 patients, et aucun patient identifié n’apparaît dans les deux ensembles. Les patients sont identifiés par le préfixe à cinq chiffres du nom de fichier, par exemple
00097_77.jpg. L’ensemble d’entraînement contient les 95 autres patients identifiés, ainsi que 541 images dont les noms de fichier ne comportent aucun identifiant de patient.Le jeu de données sur les tumeurs cérébrales d’Ultralytics (4,06 Mo) est téléchargé automatiquement depuis les ressources GitHub d’Ultralytics lors du premier entraînement avec
data="brain-tumor.yaml"; aucun téléchargement manuel n’est donc nécessaire. Si une ancienne copie comprenant 893 images d’entraînement est déjà enregistrée sur le disque, supprime son dossierbrain-tumoret mets d’abord à jour le paquetultralyticspour télécharger la version actuelle à classe unique. Pour découvrir un autre petit jeu de données d’imagerie médicale, consulte le jeu de données de détection de pilules médicales.Pour entraîner YOLO26 sur le jeu de données sur les tumeurs cérébrales d’Ultralytics, passe
data="brain-tumor.yaml"à la commande d’entraînement ; le jeu de données sera téléchargé automatiquement. Les exemples ci-dessous entraînent YOLO26n pendant 100 époques avec une taille d’image de 640 :Exemple d’entraînementfrom ultralytics import YOLO # Charger un modèle model = YOLO("yolo26n.pt") # charger un modèle préentraîné (recommandé pour l’entraînement) # Entraîner le modèle results = model.train(data="brain-tumor.yaml", epochs=100, imgsz=640)Pour obtenir la liste détaillée des arguments disponibles, consulte la page Entraînement.
Pour effectuer une inférence avec un modèle YOLO26 affiné sur le jeu de données sur les tumeurs cérébrales d’Ultralytics, charge tes poids
best.ptet appelle predict sur une image d’IRM cérébrale. Chaque résultat contient les boîtes englobantestumoret leurs scores de confiance :Exemple d’inférencefrom ultralytics import YOLO # Charger un modèle model = YOLO("path/to/best.pt") # charger un modèle affiné sur les tumeurs cérébrales # Inférence avec le modèle results = model.predict("https://ultralytics.com/assets/brain-tumor-sample.jpg")Le jeu de données sur les tumeurs cérébrales d’Ultralytics a été créé par Ultralytics et est publié sous la licence AGPL-3.0.


Commentaires11
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
ZoltinZyc
how can i download this datasett??
1 Paula DerrengerUltralytics(modifié)
Hey there! 😊 The easiest way is to train with
data=brain-tumor.yaml, which downloads the dataset automatically the first time. To download it manually, use:wget https://github.com/ultralytics/assets/releases/download/v0.0.0/brain-tumor.zip unzip brain-tumor.zip -d path/to/destinationReplace
path/to/destinationwith the directory where you'd like the dataset stored. Once you have the dataset, you're all set to start training or inferencing with YOLO models on brain tumor images!Should you need further guidance, feel free to ask. Happy coding! 🚀
G-qingqian
Thank you for your reply. I noticed that in the original dataset, the images in the train folder do have ID prefixes, but the images in the val folder are all prefixed with val1_, making it impossible to distinguish which patient the data belongs to. Therefore, I cannot redivide the dataset. Could you please provide data with complete identifiers? ---- Replied Message ---- FromGlenn @.>Date1/18/2026 @.>@.>, @.>SubjectRe: [ultralytics/ultralytics] zh/datasets/detect/brain-tumor/ (Discussion #9988) The packaged brain-tumor dataset split is provided at the image-folder level and doesn’t ship patient IDs/metadata, so we can’t guarantee a patient-disjoint (no same patient in both train/val) split; if you need patient-wise separation, you’ll need to rebuild the split from patient identifiers and point a custom YAML to *.txt image lists (supported by Ultralytics YOLO), e.g. see the provided config in the Brain Tumor dataset docs and the brain-tumor.yaml in the repo.
my-brain-tumor.yaml path: /data/brain-tumor train: splits/train.txt # one image path per line (ideally grouped by patient ID when you create it) val: splits/val.txt names: 0: negative 1: positive
— Reply to this email directly, view it on GitHub, or unsubscribe. You are receiving this because you commented.Message ID: @.***>
 Glenn JocherUltralytics
The packaged
brain-tumorzip only includes image-level labels with anonymized filenames (no patient IDs/metadata), so we can’t provide “complete identifiers” or guarantee a patient-disjoint re-split; for patient-wise splitting you’ll need to rebuild from a source that includes patient IDs (e.g., your DICOM/NIfTI originals) and then generatetrain.txt/val.txt, and if you just need stronger evaluation without IDs you can use our K-Fold Cross Validation guide—please keep follow-ups here in the GitHub discussion (we can’t provide support over email/DM).
Can your dataset ensure that the data are independently and identically distributed by patient? That is, there will be no data from the same patient in both the training set and the validation set.
- Glenn JocherUltralytics
The packaged
brain-tumordataset split is provided at the image-folder level and doesn’t ship patient IDs/metadata, so we can’t guarantee a patient-disjoint (no same patient in both train/val) split; if you need patient-wise separation, you’ll need to rebuild the split from patient identifiers and point a custom YAML to*.txtimage lists (supported by Ultralytics YOLO), e.g. see the provided config in the Brain Tumor dataset docs and the brain-tumor.yaml in the repo.# my-brain-tumor.yaml path: /data/brain-tumor train: splits/train.txt # one image path per line (ideally grouped by patient ID when you create it) val: splits/val.txt names: 0: negative 1: positive
pizzas17
How could I download this dataset on COCO format or how could I convert it? (Since I wish to have an EDA on it
xySun17
How can i train the yoloV8 using this dataset without loading the pre-trained weights?
- Paula DerrengerUltralytics(modifié)
@xySun17 hello!
To train YOLO26 without loading the pre-trained weights, you can initialize the model from scratch by specifying the model architecture file (e.g.,
yolo26n.yaml) instead of the pre-trained weights file. Here’s how you can do it:Python
from ultralytics import YOLO

# Load a model architecture without pre-trained weights
model = YOLO("yolo26n.yaml")  # build a new model from YAML

# Train the model
results = model.train(data="brain-tumor.yaml", epochs=100, imgsz=640)
CLI
# Train from scratch using the model architecture file
yolo detect train data=brain-tumor.yaml model=yolo26n.yaml epochs=100 imgsz=640
This approach ensures that the model starts training with random weights rather than pre-trained ones. If you encounter any issues, please ensure you are using the latest version of the Ultralytics package and provide a minimum reproducible example if the problem persists. You can find more details on creating a reproducible example here.
Feel free to reach out if you have any further questions. Happy training! 🚀
1 Thank you!! However, there is another problem, that is, why it says the path of dataset is not found? I already downloaded the dataset files and changed the path in "brain-tumor.yaml" file.
The threw error was follows: "Dataset 'brain-tumor.yaml' images not found ⚠️, missing path '/valid/images' Note dataset download directory is '/home/ros/datasets'. You can update this in '/home/ros/.config/Ultralytics/settings.yaml'"
- Paula DerrengerUltralytics(modifié)
Hello @xySun17,
Thank you for reaching out! It looks like the issue might be related to the dataset path configuration in your
brain-tumor.yamlfile. Here are a few steps to troubleshoot and resolve this:-
Verify Dataset Path: Ensure that the paths specified in your
brain-tumor.yamlfile correctly point to the locations of your dataset images. For example:path: /home/ros/datasets/brain-tumor train: images/train val: images/val -
Check Directory Structure: Confirm that the directory structure matches what is specified in the YAML file. The
images/trainandimages/valdirectories should exist within/home/ros/datasets/brain-tumor. -
Update Configuration: If the dataset is located in a different directory, update the
pathin the YAML file accordingly. For instance, if your dataset is in/home/ros/my-datasets/brain-tumor, update thepathto:path: /home/ros/my-datasets/brain-tumor -
Reproducible Example: If the issue persists, providing a minimum reproducible example can greatly help in diagnosing the problem. You can find guidance on creating a reproducible example here.
-
Latest Version: Ensure you are using the latest version of the Ultralytics package. You can update it using:
pip install --upgrade ultralytics
Here’s an example of how your
brain-tumor.yamlshould look:# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license # Brain-tumor dataset by Ultralytics # Documentation: https://docs.ultralytics.com/datasets/detect/brain-tumor/ # Example usage: yolo train data=brain-tumor.yaml path: /home/ros/datasets/brain-tumor # dataset root dir train: images/train # train images (relative to 'path') val: images/val # val images (relative to 'path') # Classes names: 0: negative 1: positive # Download script/URL (optional) download: https://github.com/ultralytics/assets/releases/download/v0.0.0/brain-tumor.zipIf you follow these steps and still encounter issues, please share more details or any error messages you receive. This will help us assist you better.
Best regards and happy coding! 🚀
-