Optimisation de l’inférence avec OpenVINO pour YOLO#
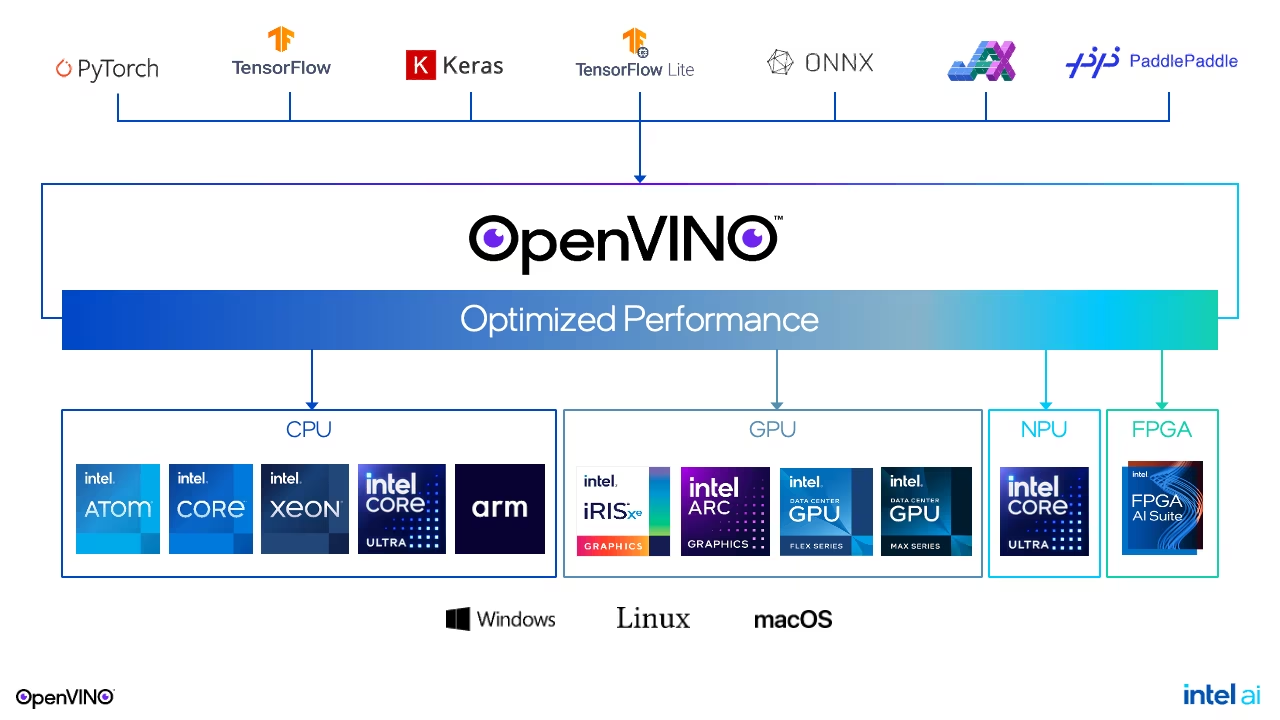
Introduction#
Lors du déploiement de modèles de deep learning, en particulier ceux de détection d’objets comme les modèles Ultralytics YOLO, il est essentiel d’obtenir des performances optimales. Ce guide explique comment tirer parti de la boîte à outils OpenVINO d’Intel pour optimiser l’inférence, en mettant l’accent sur la latence et le débit. Que tu travailles sur des applications grand public ou des déploiements à grande échelle, comprendre et appliquer ces stratégies d’optimisation permettra à tes modèles de fonctionner efficacement sur différents appareils.
Optimisation de la latence#
L’optimisation de la latence est essentielle pour les applications qui exigent une réponse immédiate d’un modèle unique à partir d’une seule entrée, comme c’est généralement le cas dans les scénarios grand public. L’objectif est de minimiser le délai entre l’entrée et le résultat de l’inférence. Toutefois, obtenir une faible latence nécessite une attention particulière, notamment lors de l’exécution d’inférences simultanées ou de la gestion de plusieurs modèles.
Principales stratégies d’optimisation de la latence#
- Une seule inférence par appareil : le moyen le plus simple d’obtenir une faible latence consiste à limiter chaque appareil à une inférence à la fois. Une concurrence accrue entraîne souvent une latence plus élevée.
- Tirer parti des sous-appareils : les appareils comme les processeurs à plusieurs sockets ou les GPU à plusieurs tuiles peuvent exécuter plusieurs requêtes avec une hausse minimale de la latence en utilisant leurs sous-appareils internes.
- Conseils de performance d’OpenVINO : l’utilisation de
ov::LATENCYd’OpenVINO pour la propriétéov::performance_modelors de la compilation du modèle simplifie le réglage des performances et offre une approche indépendante de l’appareil et pérenne.
Gestion de la latence de la première inférence#
- Mise en cache des modèles : pour éviter que le chargement et la compilation des modèles n’augmentent la latence, utilise la mise en cache des modèles dans la mesure du possible. Lorsque la mise en cache n’est pas envisageable, les processeurs offrent généralement les temps de chargement des modèles les plus courts.
- Mappage des modèles ou lecture : pour réduire les temps de chargement, OpenVINO a remplacé la lecture des modèles par leur mappage. Toutefois, si le modèle se trouve sur un lecteur amovible ou réseau, envisage d’utiliser
ov::enable_mmap(false)pour revenir à la lecture. - Sélection automatique de l’appareil (AUTO) : ce mode démarre l’inférence sur le CPU, puis passe à un accélérateur dès que celui-ci est prêt, ce qui réduit de façon transparente la latence de la première inférence.
Optimisation du débit#
L’optimisation du débit est essentielle dans les scénarios où de nombreuses requêtes d’inférence sont traitées simultanément, afin de maximiser l’utilisation des ressources sans réduire sensiblement les performances de chaque requête.
Méthodes d’optimisation du débit#
-
Conseils de performance d’OpenVINO : une méthode de haut niveau et pérenne pour améliorer le débit sur différents appareils à l’aide de conseils de performance.
import openvino as ov import openvino.properties.hint as hints core = ov.Core() model = core.read_model("yolo26n_openvino_model/yolo26n.xml") config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT} compiled_model = core.compile_model(model, "GPU", config) -
Traitement par lots explicite et flux : une approche plus granulaire qui fait appel au traitement par lots explicite et aux flux pour un réglage avancé des performances.
Conception d’applications optimisées pour le débit#
Pour maximiser le débit, les applications doivent :
- Traiter les entrées en parallèle afin d’exploiter pleinement les capacités de l’appareil.
- Décomposer le flux de données en requêtes d’inférence simultanées, planifiées pour une exécution parallèle.
- Utiliser l’API asynchrone avec des rappels pour préserver l’efficacité et éviter que l’appareil reste inactif.
Exécution sur plusieurs appareils#
Le mode multi-appareil d’OpenVINO simplifie l’augmentation du débit en répartissant automatiquement les requêtes d’inférence entre les appareils, sans nécessiter de gestion des appareils au niveau de l’application.
Gains de performance en conditions réelles#
La mise en œuvre d’optimisations OpenVINO avec les modèles Ultralytics YOLO peut générer des améliorations significatives des performances. Comme le montrent les évaluations comparatives, les utilisateurs peuvent obtenir une inférence jusqu’à 3 fois plus rapide sur les processeurs Intel, avec des accélérations encore plus importantes possibles sur toute la gamme de matériel Intel, notamment les GPU intégrés, les GPU dédiés et les NPU.
Par exemple, lors de l’exécution de modèles YOLO26 sur des processeurs Intel Xeon, les versions optimisées avec OpenVINO surpassent systématiquement leurs équivalents PyTorch en temps d’inférence par image, sans compromettre la précision.
Mise en œuvre pratique#
Pour exporter et optimiser ton modèle Ultralytics YOLO pour OpenVINO, tu peux utiliser la fonctionnalité d’exportation :
from ultralytics import YOLO

# Charger un modèle
model = YOLO("yolo26n.pt")

# Exporter le modèle au format OpenVINO
model.export(format="openvino", quantize=16)  # Exporter avec une précision FP16
Après l’exportation, tu peux exécuter l’inférence avec le modèle optimisé :
# Charger le modèle OpenVINO
ov_model = YOLO("yolo26n_openvino_model/")

# Exécuter l’inférence (Ultralytics compile les modèles OpenVINO avec l’indication de performance LATENCY)
results = ov_model("https://ultralytics.com/images/bus.jpg", verbose=True)Conclusion#
L’optimisation des modèles Ultralytics YOLO pour la latence et le débit avec OpenVINO peut améliorer considérablement les performances de ton application. En appliquant soigneusement les stratégies présentées dans ce guide, les développeurs peuvent s’assurer que leurs modèles fonctionnent efficacement et répondent aux exigences de divers scénarios de déploiement. N’oublie pas que le choix entre l’optimisation de la latence et celle du débit dépend des besoins propres à ton application et des caractéristiques de l’environnement de déploiement.
Pour obtenir des informations techniques plus détaillées et les dernières mises à jour, consulte la documentation OpenVINO et le dépôt Ultralytics YOLO. Ces ressources proposent des guides détaillés, des tutoriels et une assistance communautaire pour t’aider à tirer le meilleur parti de tes modèles de deep learning.
Pour garantir des performances optimales à tes modèles, il ne suffit pas d’ajuster les configurations : il faut comprendre les besoins de ton application et prendre des décisions éclairées. Que tu optimises les réponses en temps réel ou que tu maximises le débit pour un traitement à grande échelle, l’association des modèles Ultralytics YOLO et d’OpenVINO fournit aux développeurs une boîte à outils puissante pour déployer des solutions d’IA performantes.
FAQ#
L’optimisation des modèles Ultralytics YOLO pour obtenir une faible latence repose sur plusieurs stratégies clés :
- Une seule inférence par appareil : limite les inférences à une seule à la fois par appareil afin de minimiser les délais.
- Tirer parti des sous-appareils : utilise des appareils comme les processeurs à plusieurs sockets ou les GPU à plusieurs tuiles, qui peuvent traiter plusieurs requêtes avec une hausse minimale de la latence.
- Conseils de performance d’OpenVINO : utilise
ov::LATENCYd’OpenVINO lors de la compilation du modèle pour simplifier le réglage et le rendre indépendant de l’appareil.
Pour obtenir davantage de conseils pratiques sur l’optimisation de la latence, consulte la section Optimisation de la latence de notre guide.
OpenVINO améliore le débit des modèles Ultralytics YOLO en maximisant l’utilisation des ressources de l’appareil sans sacrifier les performances. Voici quelques avantages clés :
- Conseils de performance : réglage des performances simple et de haut niveau sur différents appareils.
- Traitement par lots explicite et flux : réglage précis pour des performances avancées.
- Exécution sur plusieurs appareils : équilibrage automatique de la charge d’inférence, qui facilite la gestion au niveau de l’application.
Exemple de configuration :
import openvino as ov
import openvino.properties.hint as hints

core = ov.Core()
model = core.read_model("yolo26n_openvino_model/yolo26n.xml")
config = {hints.performance_mode: hints.PerformanceMode.THROUGHPUT}
compiled_model = core.compile_model(model, "GPU", config)
Pour en savoir plus sur l’optimisation du débit, consulte la section Optimisation du débit de notre guide détaillé.
Pour réduire la latence de la première inférence, adopte les pratiques suivantes :
- Mise en cache des modèles : utilise la mise en cache des modèles pour réduire les temps de chargement et de compilation.
- Mappage des modèles ou lecture : utilise le mappage (
ov::enable_mmap(true)) par défaut, mais passe à la lecture (ov::enable_mmap(false)) si le modèle se trouve sur un lecteur amovible ou réseau. - Sélection automatique de l’appareil (AUTO) : utilise le mode AUTO pour démarrer l’inférence sur le CPU, puis passer à un accélérateur de manière transparente.
Pour connaître les stratégies détaillées de gestion de la latence de la première inférence, consulte la section Gestion de la latence de la première inférence.
Pour trouver le bon équilibre entre l’optimisation de la latence et celle du débit, tu dois comprendre les besoins de ton application :
- Optimisation de la latence : idéale pour les applications en temps réel qui exigent des réponses immédiates (par exemple, les applications grand public).
- Optimisation du débit : idéale pour les scénarios comportant de nombreuses inférences simultanées et nécessitant de maximiser l’utilisation des ressources (par exemple, les déploiements à grande échelle).
L’utilisation des conseils de performance de haut niveau et des modes multi-appareils d’OpenVINO peut t’aider à trouver le bon équilibre. Choisis les conseils de performance OpenVINO adaptés à tes besoins.
Oui, les modèles Ultralytics YOLO sont très polyvalents et peuvent être intégrés à divers frameworks d’IA. Voici quelques options :
- TensorRT : pour optimiser les GPU NVIDIA, suis le guide d’intégration de TensorRT.
- CoreML : pour les appareils Apple, consulte nos instructions d’exportation vers CoreML.
- LiteRT.js : pour les applications Web et Node.js, consulte le guide d’intégration LiteRT et l’environnement d’exécution Web LiteRT.js.
Découvre d’autres intégrations sur la page des intégrations Ultralytics.