Guide d’utilisation de Kaggle pour entraîner tes modèles YOLO26
Si tu te formes à l’IA et travailles sur de petits projets, tu n’as peut-être pas encore accès à de puissantes ressources informatiques, et le matériel haut de gamme peut coûter cher. Kaggle, une plateforme appartenant à Google, propose un environnement cloud gratuit qui te donne accès à des ressources GPU, te permet de traiter de grands jeux de données et de collaborer avec une communauté diversifiée de spécialistes des données et de passionnés de machine learning.
Kaggle est une solution pratique pour entraîner et expérimenter avec les modèles Ultralytics YOLO26. Les notebooks Kaggle incluent des bibliothèques et des frameworks populaires de machine learning préinstallés. Ce guide présente les principales fonctionnalités de Kaggle et explique comment y entraîner des modèles YOLO26.
Qu’est-ce que Kaggle ?#
Kaggle est une plateforme qui rassemble des spécialistes des données du monde entier afin qu’ils collaborent, apprennent et s’affrontent pour résoudre des problèmes réels de science des données. Lancée en 2010 par Anthony Goldbloom et Jeremy Howard, puis rachetée par Google en 2017, Kaggle permet aux utilisateurs d’échanger, de découvrir et de partager des jeux de données, d’utiliser des notebooks accélérés par GPU et de participer à des compétitions de science des données. La plateforme s’adresse aussi bien aux professionnels expérimentés qu’aux personnes en formation.
Avec plus de 10 millions d’utilisateurs en 2022, Kaggle offre un environnement riche pour développer et expérimenter avec des modèles de machine learning. Tu n’as pas à te soucier des caractéristiques techniques ou de la configuration de ta machine locale : un compte Kaggle et un navigateur Web suffisent.
Installation#
Avant de commencer à entraîner des modèles YOLO26 sur Kaggle, assure-toi que ton environnement de notebook est correctement configuré. Suis ces étapes :
Activer l’accès à Internet#
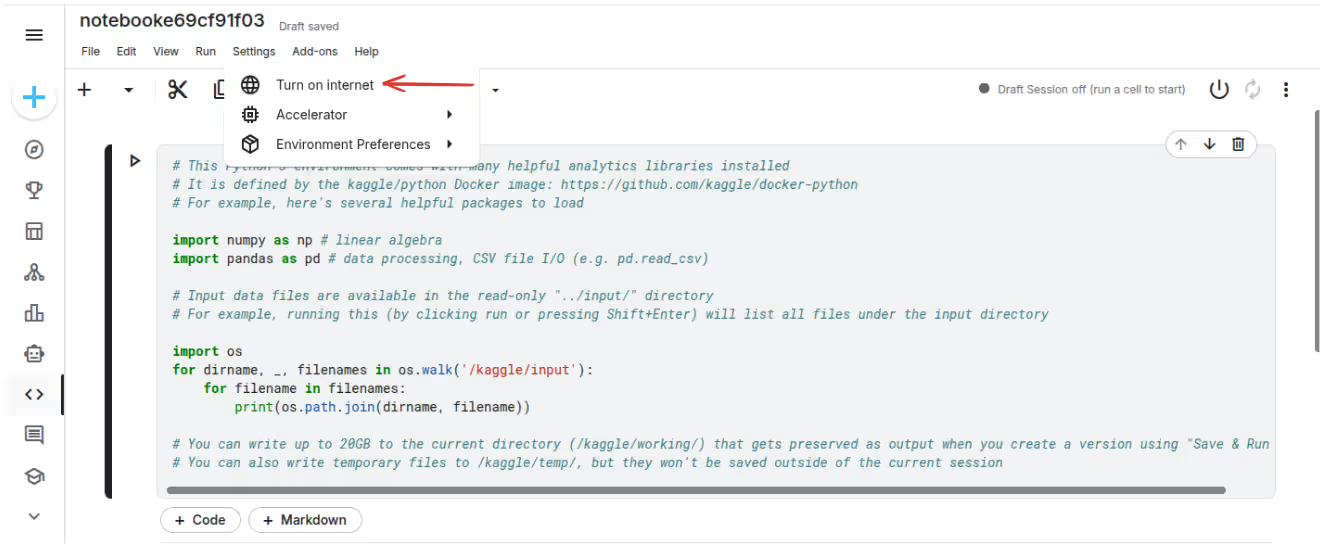
Les notebooks Kaggle nécessitent un accès à Internet pour télécharger les packages et leurs dépendances. Pour activer Internet dans ton notebook Kaggle :
- Ouvre ton notebook Kaggle.
- Clique sur le panneau Settings à droite de l’interface du notebook.
- Fais défiler la page jusqu’à la section Internet.
- Bascule l’interrupteur sur ON pour activer la connexion Internet.
Remarque : une connexion Internet est nécessaire pour installer le package Ultralytics et télécharger des modèles ou des jeux de données préentraînés. Sans accès à Internet, l’installation des packages échouera.
Installer Ultralytics#
Une fois l’accès à Internet activé, installe le package Ultralytics en exécutant la commande suivante dans une cellule du notebook :
!pip install ultralyticsPour installer la dernière version de développement, tu peux l’installer directement depuis GitHub :
!pip install git+https://github.com/ultralytics/ultralytics.gitRésoudre les conflits de dépendances#
Lors de l’installation, tu peux rencontrer des conflits de dépendances, notamment avec des packages comme opencv-python, numpy ou torch. Voici quelques solutions courantes :
Méthode 1 : forcer la réinstallation avec --upgrade#
Si tu rencontres des conflits avec des packages déjà installés, force leur mise à niveau :
!pip install --upgrade --force-reinstall ultralyticsMéthode 2 : redémarrer le noyau après l’installation#
Il est parfois nécessaire de redémarrer le noyau après l’installation pour résoudre les problèmes d’importation :
!pip install ultralytics
# Then click "Restart Kernel" from the notebook menu
Solutions aux erreurs courantes#
Erreur : "No module named 'ultralytics'"
- Solution : vérifie que l’accès à Internet est activé, puis relance la commande d’installation.
- Redémarre le noyau après l’installation.
Erreur : "ERROR: pip's dependency resolver does not currently take into account..."
- Solution : il s’agit généralement d’un avertissement que tu peux ignorer sans risque. L’installation réussit généralement malgré ce message.
Erreur : "ModuleNotFoundError" après l’installation
- Solution : redémarre le noyau à l’aide du bouton de redémarrage dans l’interface du notebook.
- Relance les instructions d’importation dans une nouvelle cellule.
Vérifier l’installation#
Après l’installation, vérifie que le package Ultralytics est correctement installé en exécutant :
import ultralytics

ultralytics.checks()
Cette commande affiche les informations système et vérifie que toutes les dépendances sont correctement installées.
Entraîner YOLO26 avec Kaggle#
Les GPU gratuits de Kaggle facilitent l’entraînement de modèles YOLO26.
Pour commencer, ouvre le notebook du tutoriel Ultralytics YOLO26 sur Kaggle. L’environnement Kaggle inclut des bibliothèques préinstallées comme TensorFlow et PyTorch, ce qui simplifie la configuration.
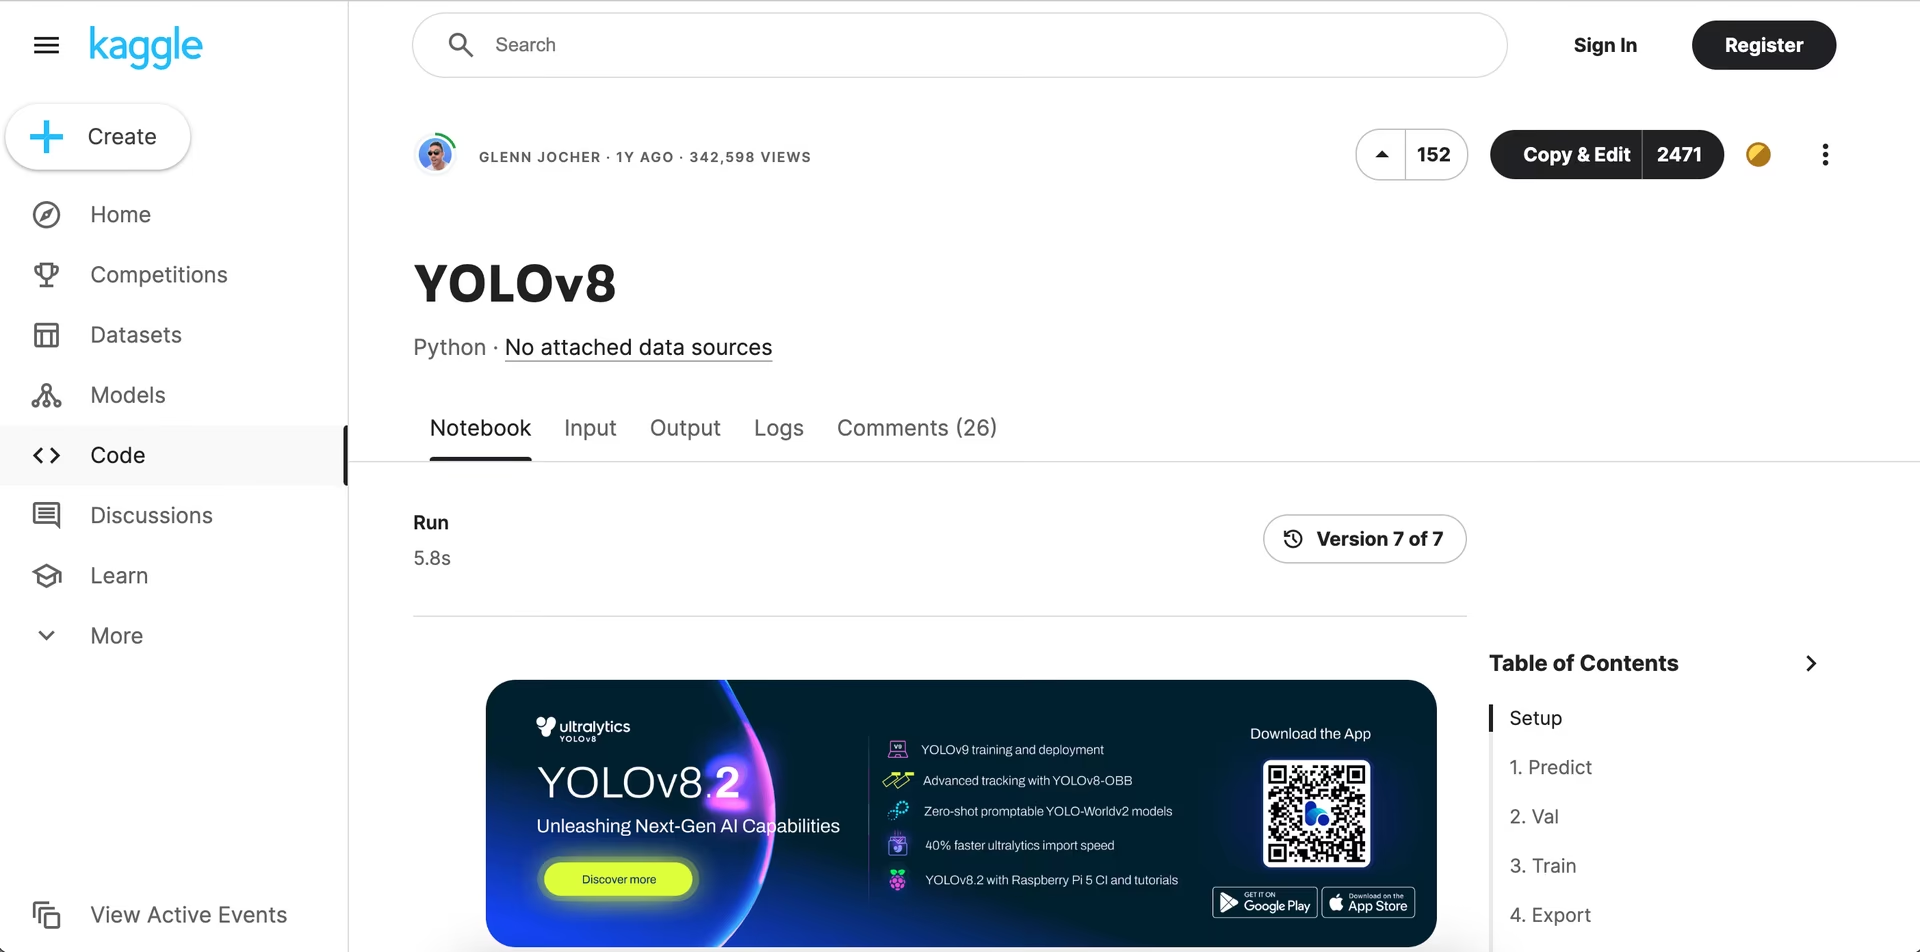
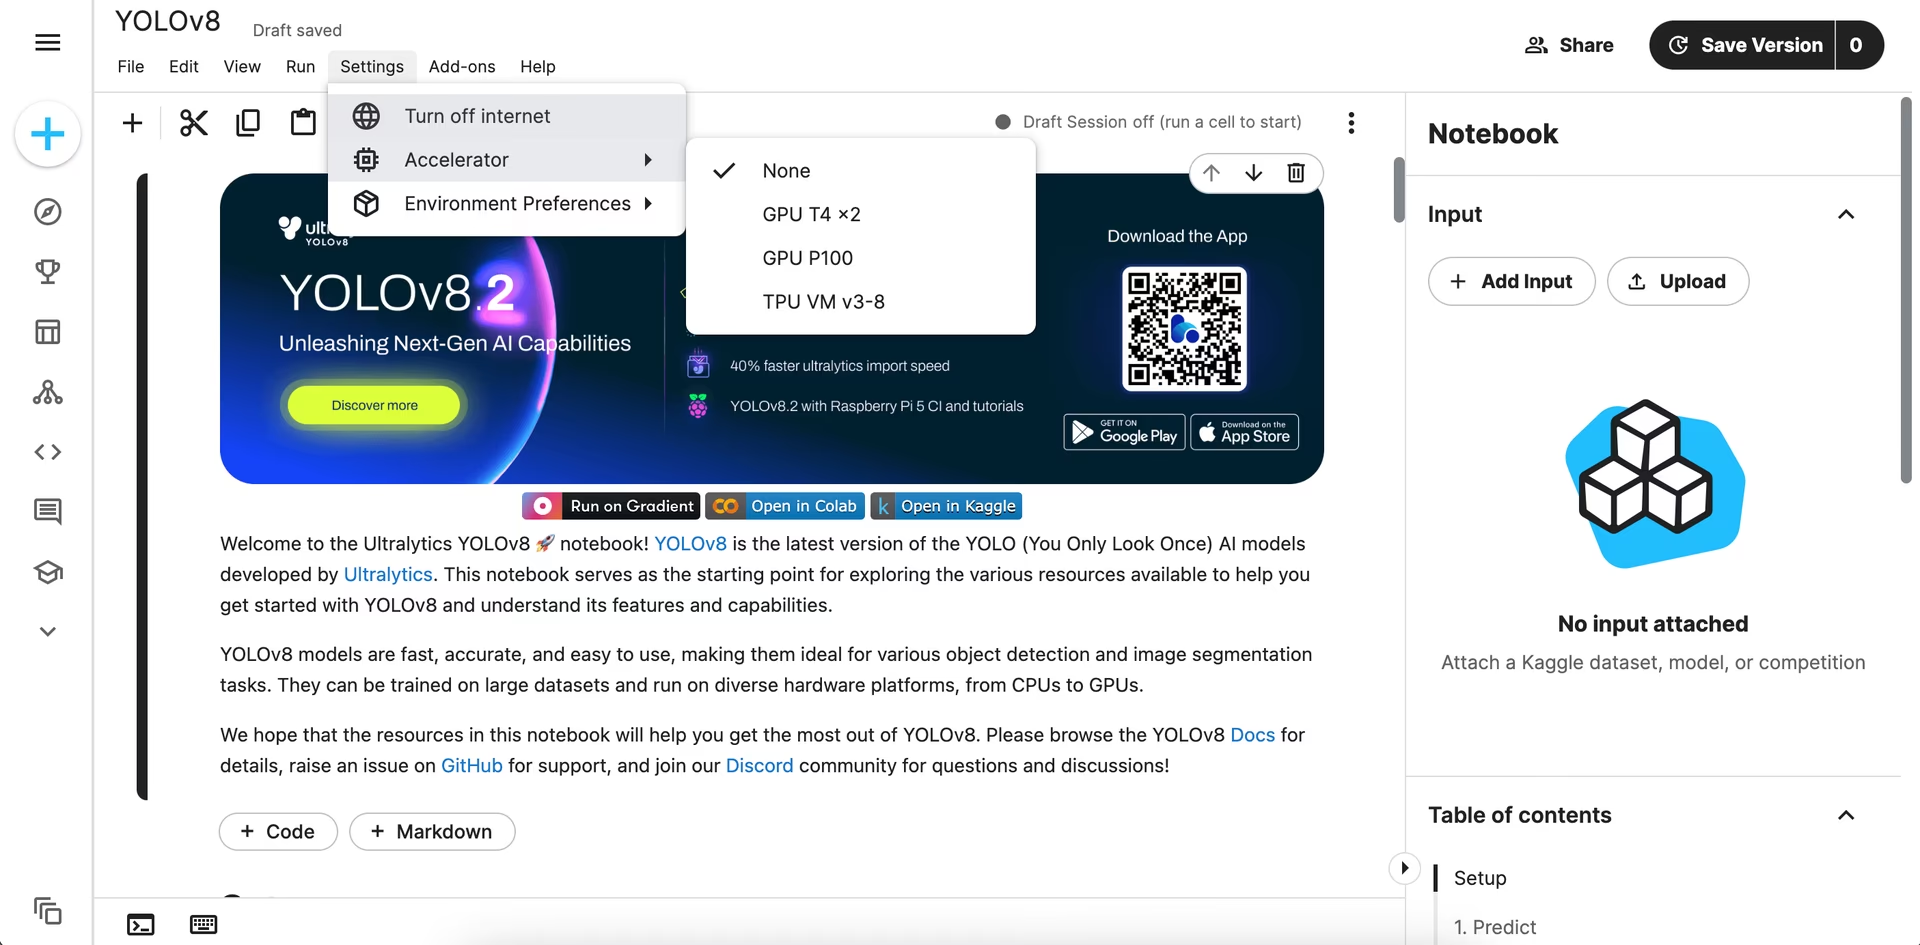
Une fois connecté à ton compte Kaggle, le carnet s’ouvre sous la forme de ta propre copie modifiable : sélectionne un GPU dans les paramètres de l’accélérateur, puis exécute les cellules du carnet pour commencer à entraîner ton modèle. Pour comprendre en détail le processus d’entraînement du modèle et les bonnes pratiques, consulte notre guide d’entraînement des modèles YOLO26.
Problèmes courants lors de l’utilisation de Kaggle#
Lorsque tu utilises Kaggle, tu peux rencontrer des problèmes courants. Voici quelques points clés pour t’aider à utiliser la plateforme :
- Accès aux GPU : dans tes notebooks Kaggle, tu peux activer un GPU à tout moment et l’utiliser jusqu’à 30 heures par semaine. Kaggle fournit le GPU NVIDIA Tesla P100 avec 16 Go de mémoire et propose également une option NVIDIA T4 x2. L’accélération GPU rend l’entraînement et l’inférence des modèles beaucoup plus rapides.
- Kaggle Kernels : les Kaggle Kernels sont des serveurs de notebooks Jupyter gratuits auxquels il est possible d’intégrer des GPU, ce qui te permet d’effectuer des opérations de machine learning sur des ordinateurs dans le cloud. Tu n’as pas besoin de compter sur le CPU de ton propre ordinateur, ce qui évite de le surcharger et libère tes ressources locales.
- Jeux de données Kaggle : les jeux de données Kaggle sont gratuits à télécharger. Cependant, il est important de vérifier la licence de chaque jeu de données pour connaître les éventuelles restrictions d’utilisation. Certains jeux de données peuvent être soumis à des restrictions concernant les publications universitaires ou l’usage commercial. Tu peux télécharger des jeux de données directement dans ton notebook Kaggle ou ailleurs à l’aide de l’API Kaggle.
- Enregistrer et valider des notebooks : pour enregistrer et valider un notebook sur Kaggle, clique sur « Save Version ». Cette action enregistre l’état actuel de ton notebook. Une fois que le kernel en arrière-plan a fini de générer les fichiers de sortie, tu peux y accéder depuis l’onglet Output de la page principale du notebook.
- Collaboration : Kaggle prend en charge la collaboration, mais plusieurs utilisateurs ne peuvent pas modifier un notebook simultanément. La collaboration sur Kaggle est asynchrone : les utilisateurs peuvent partager et utiliser le même notebook à des moments différents.
- Revenir à une version antérieure : si tu dois revenir à une version antérieure de ton notebook, ouvre le notebook et clique sur les trois points verticaux dans le coin supérieur droit, puis sélectionne « View Versions ». Trouve la version à laquelle tu veux revenir, clique sur le menu « ... » à côté, puis sélectionne « Revert to Version ». Une fois le notebook revenu à cette version, clique sur « Save Version » pour valider les modifications.
Fonctionnalités clés de Kaggle#
Voici quelques-unes des principales fonctionnalités que Kaggle propose pour la science des données et le machine learning :
- Jeux de données : Kaggle héberge une grande collection de jeux de données sur divers sujets. Tu peux rechercher ces jeux de données et les utiliser dans tes projets, ce qui est particulièrement pratique pour entraîner et tester tes modèles YOLO26.
- Compétitions : les compétitions Kaggle invitent les spécialistes des données et les professionnels du machine learning à résoudre des problèmes concrets. Participer te permet d’améliorer tes compétences, d’apprendre de nouvelles techniques et de te faire connaître au sein de la communauté.
- Accès gratuit aux TPU : Kaggle donne gratuitement accès aux TPU pour les frameworks qui les prennent en charge. L’entraînement d’Ultralytics YOLO26 s’exécute sur les GPU ou le CPU de Kaggle, et non sur les TPU.
- Intégration avec GitHub : Kaggle te permet de connecter ton dépôt GitHub pour importer des notebooks et enregistrer ton travail. Cette intégration facilite la gestion et l’accès à tes fichiers.
- Communauté et discussions : Kaggle rassemble une grande communauté de spécialistes des données et de professionnels du machine learning. Les forums de discussion et les notebooks partagés sont des ressources utiles pour apprendre et résoudre des problèmes. Tu peux y trouver de l’aide, partager tes connaissances et collaborer avec d’autres personnes.
Pourquoi utiliser Kaggle pour tes projets YOLO26 ?#
Il existe plusieurs plateformes pour entraîner et évaluer des modèles de machine learning. Voici quelques avantages de Kaggle pour tes projets de machine learning :
- Notebooks publics : tu peux rendre tes notebooks Kaggle publics afin que d’autres utilisateurs puissent consulter ton travail, voter, le forker et en discuter. Kaggle encourage la collaboration, les retours et le partage d’idées, ce qui t’aide à améliorer tes modèles YOLO26.
- Historique complet des validations de notebooks : Kaggle conserve un historique détaillé des validations de tes notebooks. Tu peux ainsi examiner et suivre les modifications au fil du temps, mieux comprendre l’évolution de ton projet et revenir à une version antérieure si nécessaire.
- Accès à la console : Kaggle fournit une console qui te donne davantage de contrôle sur ton environnement. Cette fonctionnalité te permet d’effectuer différentes tâches directement depuis la ligne de commande.
- Ressources disponibles : chaque session de modification de notebook sur Kaggle dispose de ressources importantes : 12 heures d’exécution pour les sessions CPU et GPU, 9 heures pour les sessions TPU et 20 gigaoctets d’espace disque avec sauvegarde automatique.
- Planification des notebooks : Kaggle te permet de programmer l’exécution de tes notebooks à des heures précises. Tu peux automatiser des tâches répétitives sans intervention manuelle, par exemple entraîner ton modèle à intervalles réguliers.
Continue à découvrir Kaggle#
Si tu veux en savoir plus sur Kaggle, voici quelques ressources utiles pour te guider :
- Kaggle Learn : découvre de nombreux tutoriels interactifs gratuits sur Kaggle Learn. Ces cours abordent des sujets essentiels de la science des données avec des exercices pratiques.
- Bien démarrer avec Kaggle : ce guide te présente les bases de Kaggle, de la participation aux compétitions à la création de ton premier notebook.
- Page Medium de Kaggle : découvre des tutoriels, des actualités et des contributions de la communauté sur la page Medium de Kaggle.
- Entraîner des modèles Ultralytics YOLO avec l’intégration Kaggle : cet article de blog explique comment utiliser Kaggle spécifiquement avec les modèles Ultralytics YOLO.
Résumé#
Kaggle donne à tes projets YOLO26 un accès gratuit aux GPU pour l’entraînement et l’évaluation des modèles, ainsi qu’à des bibliothèques préinstallées pour une configuration rapide. Ensemble, Ultralytics YOLO26 et Kaggle te permettent de développer, d’entraîner et de déployer des modèles de vision par ordinateur sans matériel coûteux.
Pour en savoir plus, consulte la documentation de Kaggle.
FAQ#
Pour installer Ultralytics YOLO26 sur Kaggle :
- Activer Internet : ouvre le panneau Settings et active le bouton Internet
- Installer le package : exécute
!pip install ultralyticsdans une cellule du notebook - Vérifier l’installation : exécute
import ultralytics; ultralytics.checks()pour confirmer l’installation
Si tu rencontres des conflits de dépendances, essaie
!pip install --upgrade --force-reinstall ultralyticsou redémarre le kernel après l’installation. Pour résoudre les problèmes en détail, consulte la section Installation ci-dessus.L’entraînement d’un modèle YOLO26 sur Kaggle est simple. Commence par ouvrir le carnet de tutoriel Ultralytics YOLO26 dans Kaggle. Connecte-toi à ton compte Kaggle et sélectionne un GPU dans les paramètres de l’accélérateur. Exécute les cellules du carnet pour lancer l’entraînement. Pour obtenir des étapes plus détaillées, consulte notre guide d’entraînement des modèles YOLO26.
Kaggle offre plusieurs avantages pour entraîner des modèles YOLO26 :
- Accès gratuit aux GPU : utilise des GPU comme le NVIDIA Tesla P100 ou le T4 x2 jusqu’à 30 heures par semaine.
- Bibliothèques préinstallées : des bibliothèques comme TensorFlow et PyTorch sont préinstallées, ce qui simplifie la configuration.
- Collaboration communautaire : échange avec une vaste communauté de spécialistes des données et de passionnés de machine learning.
- Contrôle des versions : gère différentes versions de tes notebooks et reviens aux versions précédentes si nécessaire.
Les problèmes courants comprennent :
- Accès aux GPU : veille à activer un GPU dans les paramètres de ton notebook. Kaggle autorise jusqu’à 30 heures d’utilisation d’un GPU par semaine.
- Internet désactivé : veille à activer Internet dans le panneau Settings avant d’installer des packages.
- Conflits de dépendances : utilise
!pip install --upgrade --force-reinstall ultralytics. - Licences des jeux de données : vérifie la licence de chaque jeu de données pour connaître les restrictions d’utilisation.
- Enregistrer et valider des notebooks : clique sur « Save Version » pour enregistrer l’état de ton notebook et accéder aux fichiers de sortie depuis l’onglet Output.
- Collaboration : Kaggle prend en charge la collaboration asynchrone ; plusieurs utilisateurs ne peuvent pas modifier un notebook simultanément.
Pour obtenir d’autres conseils de dépannage, consulte la section Installation et notre guide des problèmes courants.
Kaggle offre plusieurs fonctionnalités qui le distinguent de Google Colab :
- Notebooks publics : partage ton travail avec la communauté pour obtenir des retours et collaborer.
- Historique complet : suis les modifications au fil du temps grâce à l’historique détaillé des validations des notebooks.
- Ressources disponibles : chaque session de notebook dispose de ressources importantes, notamment 12 heures d’exécution pour les sessions CPU et GPU.
Pour revenir à une version antérieure :
- Ouvre le notebook et clique sur les trois points verticaux dans le coin supérieur droit.
- Sélectionne « View Versions ».
- Trouve la version à laquelle tu veux revenir, clique sur le menu « ... » à côté, puis sélectionne « Revert to Version ».
- Clique sur « Save Version » pour valider les modifications.


Commentaires3
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
md-jawad-117
Hello, I was using the GPU T4 x2 for training my custom RT-DETR model which is infact was twice as fast compared to P100 GPU with just one of them running.🚀🚀 While the second one was idle. Now when I tried to utilize both GPUs using device=[0, 1] & device=[-1, -1], i received an error which persisted as long as I did not restart the kernel. ⛓️💥⛓️💥
from ultralytics import RTDETR
model = RTDETR('/kaggle/working/rtdr.yaml').load('rtdetr-l.pt')
model.info()
results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=32, lr0=0.0001, device=[0,1])
Error Msg: Transferred 725/725 items from pretrained weights DDP: debug command /usr/bin/python3 -m torch.distributed.run --nproc_per_node 2 --master_port 52415 /root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py Traceback (most recent call last): File "/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py", line 6, in from ultralytics.models.rtdetr.train import RTDETRTrainer ModuleNotFoundError: No module named 'ultralytics' Traceback (most recent call last): File "/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py", line 6, in from ultralytics.models.rtdetr.train import RTDETRTrainer ModuleNotFoundError: No module named 'ultralytics' E0601 09:54:34.472000 132 torch/distributed/elastic/multiprocessing/api.py:869] failed (exitcode: 1) local_rank: 0 (pid: 134) of binary: /usr/bin/python3 Traceback (most recent call last): File "", line 198, in _run_module_as_main File "", line 88, in _run_code File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 922, in main() File "/usr/local/lib/python3.11/dist-packages/torch/distributed/elastic/multiprocessing/errors/init.py", line 355, in wrapper return f(*args, **kwargs) ^^^^^^^^^^^^^^^^^^ File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 918, in main run(args) File "/usr/local/lib/python3.11/dist-packages/torch/distributed/run.py", line 909, in run elastic_launch( File "/usr/local/lib/python3.11/dist-packages/torch/distributed/launcher/api.py", line 138, in call return launch_agent(self._config, self._entrypoint, list(args)) ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ File "/usr/local/lib/python3.11/dist-packages/torch/distributed/launcher/api.py", line 269, in launch_agent raise ChildFailedError( torch.distributed.elastic.multiprocessing.errors.ChildFailedError:
/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py FAILED
Failures: [1]: time : 2025-06-01_09:54:34 host : 9bca5bb85783 rank : 1 (local_rank: 1) exitcode : 1 (pid: 135) error_file: <N/A> traceback : To enable traceback see: https://pytorch.org/docs/stable/elastic/errors.html
Root Cause (first observed failure): [0]: time : 2025-06-01_09:54:34 host : 9bca5bb85783 rank : 0 (local_rank: 0) exitcode : 1 (pid: 134) error_file: <N/A> traceback : To enable traceback see: https://pytorch.org/docs/stable/elastic/errors.html
CalledProcessError Traceback (most recent call last) /tmp/ipykernel_35/2411087223.py in <cell line: 0>() ----> 1 results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=16, lr0=0.0001, device=[0,-1])
/kaggle/working/ultralytics/engine/model.py in train(self, trainer, **kwargs) 795 796 self.trainer.hub_session = self.session # attach optional HUB session --> 797 self.trainer.train() 798 # Update model and cfg after training 799 if RANK in {-1, 0}:
/kaggle/working/ultralytics/engine/trainer.py in train(self) 220 subprocess.run(cmd, check=True) 221 except Exception as e: --> 222 raise e 223 finally: 224 ddp_cleanup(self, str(file))
/kaggle/working/ultralytics/engine/trainer.py in train(self) 218 try: 219 LOGGER.info(f"{colorstr('DDP:')} debug command {' '.join(cmd)}") --> 220 subprocess.run(cmd, check=True) 221 except Exception as e: 222 raise e
/usr/lib/python3.11/subprocess.py in run(input, capture_output, timeout, check, *popenargs, **kwargs) 569 retcode = process.poll() 570 if check and retcode: --> 571 raise CalledProcessError(retcode, process.args, 572 output=stdout, stderr=stderr) 573 return CompletedProcess(process.args, retcode, stdout, stderr)
CalledProcessError: Command '['/usr/bin/python3', '-m', 'torch.distributed.run', '--nproc_per_node', '2', '--master_port', '52415', '/root/.config/Ultralytics/DDP/_temp_xi8731gh140405119848080.py']' returned non-zero exit status 1.
 Glenn JocherUltralytics
Thanks for sharing your multi-GPU training issue with RT-DETR on Kaggle! The error you're encountering is related to DDP (Distributed Data Parallel) not being able to find the Ultralytics module in the spawned processes.
This is a known issue on Kaggle when using multi-GPU training with DDP. The spawned processes don't inherit the current environment properly. Here are a few solutions to try:
- Install Ultralytics system-wide before training:
import subprocess subprocess.run(['pip', 'install', '-U', 'ultralytics'], check=True)- Use single GPU with larger batch size instead:
results = model.train(data="/kaggle/working/data.yaml", epochs=30, imgsz=512, optimizer='AdamW', plots=True, batch=64, lr0=0.0001, device=0)- Try using device='cpu' to verify your setup works, then switch back to single GPU.
Unfortunately, Kaggle's multi-GPU DDP setup can be unreliable due to environment isolation issues. Since you mentioned T4 x2 was already twice as fast as P100 with just one GPU active, you might get better results focusing on optimizing single-GPU training with larger batch sizes or mixed precision training.
Have you tried increasing the batch size on a single T4 GPU to maximize utilization?