Exportation Rockchip RKNN
RKNN est le format de modèle des NPU des processeurs Rockchip, comme le RK3588 et le RK3566. L’exportation d’un modèle Ultralytics YOLO26 avec format="rknn" crée un répertoire yolo26n_rknn_model/ contenant un fichier .rknn conçu pour une puce Rockchip, sélectionnée à l’aide de l’argument name, avec une précision FP16 ou INT8.
En bref#
| Propriété | Détails |
|---|---|
Argument format | rknn |
| Sortie | yolo26n_rknn_model/, un répertoire contenant yolo26n-rk3588.rknn et metadata.yaml ; les exportations INT8 des modèles de détection, de segmentation, de pose et OBB ajoutent tail.onnx |
| Fonctionne sur | Le NPU d’une puce Rockchip par exportation : RK3588, RK3576, RK3566, RK3568, RK3562, RK2118, RV1126B, RV1103, RV1106, RV1103B ou RV1106B ; voir Puces cibles |
| Environnement d’exécution | RKNN Toolkit Lite2 (le package Python rknn-toolkit-lite2) sur l’appareil Rockchip |
| Précision | FP16 (par défaut) et INT8 ; INT8 uniquement sur RV1103, RV1106, RV1103B et RV1106B. Il n’y a pas d’exportation FP32. YOLO26n pour le RK3588 fait 7,4 Mo en FP16 et 4,3 Mo en INT8 |
| Machine d’exportation | Linux x86-64 avec Python 3.12 ou une version antérieure. Effectue l’exportation sur un PC, puis copie le répertoire exporté sur l’appareil Rockchip |
Ultralytics Platform peut exporter un modèle entraîné au format RKNN pour la puce Rockchip de ton choix ; tu n’as donc pas besoin d’un environnement d’exportation local.
Démarrage rapide#
Installe le package Ultralytics dans un environnement virtuel distinct sur une machine Linux x86-64, avec les versions protobuf et numpy requises par RKNN Toolkit :
pip install ultralytics "protobuf<7" "numpy<2.4"La première exportation installe onnx, onnxslim, onnxruntime et rknn-toolkit2, ainsi que leurs dépendances si elles sont absentes. Avec un simple pip install ultralytics, la première exportation remplace également numpy, protobuf et setuptools si leurs versions ne respectent pas les plages ci-dessous ; utilise donc un environnement distinct. Si elle doit remplacer protobuf ou numpy, l’exportation échoue, et la suivante réussit dans un nouveau processus. L’exportation requiert les versions suivantes :
| Paquet | Version requise |
|---|---|
| Python | 3.12 ou une version antérieure, la version la plus récente pour laquelle rknn-toolkit2 2.3.2 propose des compilations |
rknn-toolkit2 | 2.3.2, la seule version disponible sur PyPI dans la plage requise (2.3.2 ou plus récente, et antérieure à 2.5) |
onnx | 1.16.1 ou une version plus récente, et antérieure à 1.19.0 |
numpy | antérieure à 2.4 |
protobuf | antérieure à 7 |
setuptools | inférieure à 82 |
Pour les autres méthodes d’installation, consulte le guide d’installation. Exporte ensuite ton modèle sur le PC, copie le répertoire exporté sur l’appareil Rockchip, puis charge-le sur cet appareil pour effectuer l’inférence ou valider sa précision.
from ultralytics import YOLO

# Charger un modèle YOLO26
model = YOLO("yolo26n.pt")

# # Exporte le modèle au format RKNN pour le RK3588 en FP16
model.export(format="rknn", name="rk3588")  # creates 'yolo26n_rknn_model/'

# # Ou exporte plutôt un modèle RKNN quantifié en INT8 avec des données d’étalonnage
model.export(format="rknn", name="rk3588", quantize=8, data="coco8.yaml")  # creates 'yolo26n_rknn_model/'
Les deux exportations écrivent dans le même répertoire yolo26n_rknn_model/ ; la seconde remplace donc la première. Predict et Validate s’exécutent uniquement sur un appareil Rockchip :
from ultralytics import YOLO

# # Charge le modèle RKNN exporté sur l’appareil Rockchip
model = YOLO("yolo26n_rknn_model")

# Exécuter l’inférence
results = model("https://ultralytics.com/images/bus.jpg")from ultralytics import YOLO
# # Charge le modèle RKNN exporté sur l’appareil Rockchip
model = YOLO("yolo26n_rknn_model")
# Valider la précision sur le jeu de données COCO8
metrics = model.val(data="coco8.yaml")Tâches prises en charge#
L’exportation RKNN prend en charge les sept tâches Ultralytics avec les modèles YOLOv8, YOLO11 et YOLO26 : détection, segmentation, segmentation sémantique, estimation de profondeur, classification, estimation de pose et OBB. La segmentation sémantique et l’estimation de profondeur sont disponibles uniquement avec YOLO26, la seule famille qui propose ces têtes.
Arguments d’exportation#
| Argument | Type | Valeur par défaut | Description |
|---|---|---|---|
format | str | 'rknn' | Format cible du modèle exporté, qui définit sa compatibilité avec différents environnements de déploiement. |
name | str | 'rk3588' | Puce Rockchip pour laquelle le modèle est conçu, en majuscules ou en minuscules. Voir Puces cibles. |
imgsz | int ou tuple | 640 | Taille d’image de l’entrée du modèle : un entier pour les images carrées ou un tuple (height, width). Si elle n’est pas précisée, l’exportation utilise la taille à laquelle le point de contrôle a été entraîné. Les points de contrôle YOLO26 officiels utilisent 640 pour les modèles de détection, de segmentation et de pose, ainsi que pour les modèles sémantiques préentraînés sur ADE20K ; 1024 pour les modèles OBB et les modèles sémantiques préentraînés sur Cityscapes ; 768 pour la profondeur ; et 224 pour la classification. |
quantize | int ou str | None | Précision : 16 ou une valeur non définie produit du FP16, et 8 produit de l’INT8 étalonné sur data. Pour les puces compatibles uniquement avec INT8, une valeur non définie produit de l’INT8 et 16 déclenche une erreur. 32 déclenche une erreur, et un point de contrôle entraîné avec quantize=8 ne peut pas être exporté au format RKNN ; voir Limites et dépannage. Remplace les indicateurs obsolètes half/int8. |
data | str | None | Fichier YAML du jeu de données utilisé pour l’étalonnage INT8 ; pour la classification, indique plutôt un répertoire de jeu de données ou le nom d’un jeu de données intégré. L’étalonnage utilise la partition val, sauf si split est défini. Si cette valeur est omise avec quantize=8, Ultralytics utilise le petit jeu de données par défaut pour la tâche du modèle, par exemple coco8.yaml pour la détection. |
fraction | float, int ou list | 1.0 | Sous-ensemble d’étalonnage : un ratio, un nombre d’images (entiers supérieurs à 1) ou une liste [train, val, test], dont l’entrée correspondant à la partition d’étalonnage est utilisée. |
batch | int | 1 | Taille de lot du modèle exporté, fixée dans la forme d’entrée. |
simplify | bool | True | Simplifie le graphe ONNX intermédiaire avec onnxslim. |
opset | int | None | Version de l’opset ONNX du graphe ONNX intermédiaire. Utilise 19 si aucune valeur n’est définie, et ramène les valeurs supérieures à 19. |
nms | bool, facultatif | None | Les modèles RKNN renvoient toujours des prédictions brutes pour une NMS externe. La tête sans NMS (False) et la NMS intégrée (True) ne sont pas disponibles ; voir Limites et dépannage. |
device | str | None | Appareil utilisé pour tracer le graphe ONNX intermédiaire : cpu (par défaut) ou 0 pour un GPU CUDA. |
Pour les arguments communs à tous les formats, consulte la documentation du mode Export.
Puces cibles#
Un fichier .rknn est conçu pour une seule puce, sélectionnée avec name. Les tailles indiquées correspondent à un modèle de détection YOLO26n exporté avec imgsz=640 et sans définir quantize :
name | Précisions | Si quantize n’est pas défini, produit | Fichier YOLO26n | Taille |
|---|---|---|---|---|
rk3588 | FP16, INT8 | FP16 | yolo26n-rk3588.rknn | 7.4 MB |
rk3576 | FP16, INT8 | FP16 | yolo26n-rk3576.rknn | 10.5 MB |
rk3566 | FP16, INT8 | FP16 | yolo26n-rk3566.rknn | 6.8 MB |
rk3568 | FP16, INT8 | FP16 | yolo26n-rk3568.rknn | 6.8 MB |
rk3562 | FP16, INT8 | FP16 | yolo26n-rk3562.rknn | 6.8 MB |
rk2118 | FP16, INT8 | FP16 | yolo26n-rk2118.rknn | 6.8 MB |
rv1126b | FP16, INT8 | FP16 | yolo26n-rv1126b.rknn | 7.1 MB |
rv1103 | INT8 | INT8 | yolo26n-rv1103.rknn | 4.2 MB |
rv1106 | INT8 | INT8 | yolo26n-rv1106.rknn | 4.2 MB |
rv1103b | INT8 | INT8 | yolo26n-rv1103b.rknn | 4.2 MB |
rv1106b | INT8 | INT8 | yolo26n-rv1106b.rknn | 4.2 MB |
Les quatre puces compatibles uniquement avec INT8 sont étalonnées sur le coco8.yaml par défaut de ce tableau, et leurs exportations écrivent également tail.onnx.
Quantification#
quantize définit la précision du fichier .rknn. Les tailles correspondent à une exportation avec imgsz=640 et batch=1 :
quantize | Précision | Données d’étalonnage | Fichiers pour YOLO26n et rk3588 | Taille |
|---|---|---|---|---|
non défini ou 16 | FP16 | Non | yolo26n-rk3588.rknn | 7.4 MB |
8 | INT8 | Oui | yolo26n-rk3588.rknn et tail.onnx | 4,3 Mo et 0,2 Mo |
- FP16 : valeur par défaut pour les sept puces qui le prennent en charge. Aucune donnée d’étalonnage n’est requise.
- INT8 :
quantize=8fait passer les images d’étalonnage dans le modèle et stocke les poids et les activations sous forme d’entiers 8 bits. L’exportation utilise la partitionvaldedatapour l’étalonnage, ou la partition définie parsplit, et émet un avertissement si elle contient moins de 300 images. Utilisefractionpour limiter le nombre d’images. - Précision mixte : sur les sept puces compatibles avec FP16, lors d’une exportation INT8, RKNN Toolkit conserve certaines couches en FP16 lorsque la quantification modifie trop leur sortie (
auto_hybrid). Les quatre puces compatibles uniquement avec INT8 ignorent cette étape. - Tête de détection : pour les modèles de détection, de segmentation, de pose et OBB, le fichier INT8
.rknnse termine aux convolutions de sortie de la tête. Les opérations qui décodent ces sorties en boîtes sont enregistrées danstail.onnxet s’exécutent en virgule flottante sur le CPU de l’appareil, car l’INT8 par tenseur ne peut pas représenter les valeurs de plage de pixels utilisées par le décodage des boîtes. - Modèles de profondeur : les exportations INT8 de profondeur sont étalonnées sur les images d’un jeu de données de profondeur associées à des cartes de profondeur. Choisis des images d’étalonnage couvrant la plage de profondeur proche et lointaine de la scène de déploiement. Avec
depth8.yamlpar défaut, qui contient 4 images de validation, un modèle YOLO26n-depth INT8 dans le simulateur rknn-toolkit2 a renvoyé des profondeurs allant jusqu’à 3,9 pour une image de rue, alors que le modèle FP16 allait jusqu’à 13,9. - État sur l’appareil : les exportations INT8 de toutes les tâches ont été exécutées dans le simulateur rknn-toolkit2 et comparées au modèle ONNX sur une seule image. Leur précision n’a pas été mesurée sur un jeu de données ni sur du matériel Rockchip ; valide donc un modèle INT8 sur ton appareil et avec tes propres données avant de le déployer.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# Étalonne sur 10 % des images de validation COCO (500 images) ; remplace coco.yaml par ton propre jeu de données
model.export(format="rknn", name="rk3588", quantize=8, data="coco.yaml", fraction=0.1)
Format de sortie#
L’exportation écrit un répertoire :
| Fichier | Contenu |
|---|---|
yolo26n-rk3588.rknn | Le modèle, dont le nom de fichier indique la puce définie par name |
tail.onnx | Uniquement pour les modèles INT8 de détection, de segmentation, de pose et OBB : les opérations qui décodent les sorties de la tête en prédictions brutes, à exécuter sur le CPU |
metadata.yaml | Les noms de classes, la tâche, la taille d’image, la taille de lot, le stride et les arguments d’exportation, qu’Ultralytics lit lors du chargement du modèle |
Le fichier intermédiaire yolo26n.onnx reste à côté du répertoire. Le modèle .rknn prend une entrée de forme (batch, height, width, 3) : RGB, canaux en dernier (NHWC), uint8 avec des valeurs de 0 à 255. La division par 255 est intégrée au modèle ; ne redimensionne donc pas toi-même l’image. Cela diffère de l’exportation ONNX, qui prend des images float32 avec les canaux en premier, normalisées entre 0 et 1.
Les sorties dépendent de la tâche et de la précision. Les formes ci-dessous correspondent aux points de contrôle YOLO26n officiels avec leur taille d’exportation par défaut, et au point de contrôle Cityscapes yolo26n-sem.pt pour la segmentation sémantique :
| Tâche | imgsz par défaut | Sortie FP16 et sortie tail.onnx en INT8 | Sortie INT8 .rknn |
|---|---|---|---|
| Détection | 640 | (1, 84, 8400) | 6 tenseurs de tête, décodés par tail.onnx |
| Segmentation | 640 | (1, 116, 8400) et (1, 32, 160, 160) | 9 tenseurs de tête et (1, 32, 160, 160), décodés par tail.onnx |
| Sémantique | 1024 | (1, 19, 1024, 1024), un score pour chaque classe et chaque pixel | Identique au FP16 |
| Profondeur | 768 | (1, 1, 768, 768), carte de profondeur | Identique au FP16 |
| Classification | 224 | (1, 1000), probabilités des classes | Identique au FP16 |
| Pose | 640 | (1, 56, 8400) | 9 tenseurs de tête, décodés par tail.onnx |
| OBB | 1024 | (1, 20, 21504) | 9 tenseurs de tête, décodés par tail.onnx |
- Prédictions brutes : les modèles FP16 et
tail.onnxpour les modèles INT8 renvoient les mêmes prédictions brutes qu’une exportation ONNX par défaut : pour chaque ancre, le centre x de la boîte, son centre y, sa largeur et sa hauteur en pixels d’entrée, puis les scores des classes et les valeurs propres à la tâche (32 coefficients de masque, 17 x 3 valeurs de points clés ou l’angle OBB en radians). Applique toi-même la NMS. Consulte le format de sortie ONNX pour connaître la disposition de chaque tâche. - Tenseurs de tête INT8 : un modèle de détection INT8 renvoie deux tenseurs pour chacune des trois échelles de détection, l’un contenant les valeurs des boîtes et l’autre les scores des classes ; les modèles de segmentation, de pose et OBB renvoient un tenseur supplémentaire par échelle contenant leurs valeurs additionnelles. Transmets-les à
tail.onnxdans l’ordre de retour du modèle ; un modèle de segmentation transmet également ses prototypes de masque viatail.onnxsans les modifier. - Segmentation sémantique : la sortie contient un score pour chaque classe et chaque pixel, et non la carte des classes de l’exportation ONNX ; calcule donc l’argmax sur l’axe des classes dans ton propre code.
- NMS : aucune sortie sans NMS ni avec NMS intégrée n’est disponible ; voir Limites et dépannage.
YOLO("yolo26n_rknn_model") lit la disposition à partir de metadata.yaml, exécute tail.onnx et applique la NMS ; tu n’as donc besoin de ces détails que si tu exécutes le modèle dans ton propre code. Les clés de metadata.yaml comprennent names, task, imgsz, stride, batch, end2end, args et, pour les modèles de pose, kpt_shape.
Exécution avec RKNN Toolkit Lite2#
Pour exécuter le modèle sur l’appareil sans utiliser le package Ultralytics, charge-le avec le package rknn-toolkit-lite2 et, pour un modèle INT8 de détection, de segmentation, de pose ou OBB, transmets ses sorties à tail.onnx avec ONNX Runtime :
# # Exporte d’abord : yolo export model=yolo26n.pt format=rknn name=rk3588 quantize=8 data=coco8.yaml
import numpy as np
import onnxruntime as ort
from rknnlite.api import RKNNLite

rknn = RKNNLite()
assert rknn.load_rknn("yolo26n_rknn_model/yolo26n-rk3588.rknn") == 0
assert rknn.init_runtime() == 0

image = np.zeros((1, 640, 640, 3), dtype=np.uint8)  # # ton image avec letterboxing : RGB, NHWC, 0-255
outputs = rknn.inference(inputs=[image])  # # six tenseurs de tête pour un modèle de détection INT8

tail = ort.InferenceSession("yolo26n_rknn_model/tail.onnx", providers=["CPUExecutionProvider"])
feed = {t.name: x.astype(np.float32) for t, x in zip(tail.get_inputs(), outputs)}
predictions = tail.run(None, feed)[0]  # # forme (1, 84, 8400), prédictions brutes nécessitant une NMS
assert predictions.shape == (1, 84, 8400), "export a detection model at imgsz=640 with quantize=8"
tail.onnx utilise une taille de lot de 1, quelle que soit la taille de lot batch de l’exportation ; exécute-le donc une fois par image pour un modèle exporté avec une taille de lot supérieure. Un modèle FP16 n’a pas de tail.onnx, et outputs[0] contient déjà les prédictions brutes.
Déployer#
Sur l’appareil Rockchip, installe le package avec pip install ultralytics et copie le répertoire yolo26n_rknn_model/ sur l’appareil ; les versions protobuf et numpy du guide de démarrage rapide ne sont nécessaires que pour l’exportation. YOLO("yolo26n_rknn_model") exécute ensuite le modèle sur le NPU avec le package Python rknn-toolkit-lite2, installé par Ultralytics à la première utilisation avec onnxruntime si le répertoire contient un tail.onnx. L’appareil nécessite Python 3.12 ou une version antérieure, la version la plus récente pour laquelle rknn-toolkit-lite2 propose des compilations.
- Appareil Rockchip requis : Ultralytics charge un modèle RKNN uniquement sur les systèmes Linux ARM 64 bits dont la chaîne
compatiblede l’arbre des périphériques se termine par l’un des noms de puces pris en charge. Le chargement échoue partout ailleurs ; voir Limites et dépannage.rknn-toolkit-lite2propose également des compilations uniquement pour Linux ARM 64 bits ; sur une cible qui ne répond pas à ces conditions, exécute le fichier.rknnavec l’API C de Rockchip et exécutetail.onnxou implémente le même décodage dans ton propre code. - Puce correspondante : exporte avec le
namede la puce de ta carte. - Forme d’entrée fixe : le modèle s’exécute toujours avec
imgszetbatchde l’exportation, que Ultralytics lit à partir demetadata.yaml. Unimgsztransmis àpredictouvalest ignoré. Les lots plus grands sont divisés en lots de la taille du lot d’exportation, et les plus petits sont complétés ; tout nombre d’images fonctionne donc. device: aucun appareil ne peut être sélectionné. Le modèle.rknns’exécute via l’environnement d’exécution RKNN, ettail.onnxs’exécute avec ONNX Runtime sur le CPU.
Une version antérieure de ce flux de travail a été testée sur un Radxa Rock 5B (RK3588) et un Radxa Zero 3W (RK3566). L’exportation INT8 actuelle n’a pas encore été exécutée sur du matériel.
Guides de déploiement#
- Configuration de la carte : commence par flasher un système d’exploitation, comme indiqué dans les guides de démarrage de la Radxa Rock 5B et de la Radxa Zero 3W.
- RKNN Toolkit2 sur GitHub : la boîte à outils de conversion, l’environnement d’exécution RKNN Toolkit Lite2 et la bibliothèque d’exécution
librknnrt.soavec son API C. - Zoo de modèles RKNN : exemples de déploiement C et Python de Rockchip.
- Déployer Ultralytics YOLO sur Rockchip : présentation du flux de travail sur le blog Ultralytics.
- Options de déploiement des modèles : compare RKNN aux autres formats d’exportation.
Limites et dépannage#
-
Machine d’exportation : effectue l’exportation sur une machine Linux x86-64. Sur macOS, l’exportation ne peut pas installer
rknn-toolkit2et échoue avecNo module named 'rknn'; le package n’a pas de compilation pour macOS ni Windows. L’exportation sur Linux ARM64, y compris sur les cartes Rockchip, n’a pas été testée et n’est pas prise en charge : Ultralytics teste l’exportation RKNN uniquement sur Linux x86-64. -
Version de Python :
rknn-toolkit22.3.2 propose des compilations pour Python 3.12 et les versions antérieures. Avec une version plus récente de Python, crée l’environnement avec Python 3.12. -
Première exportation dans un nouvel environnement : dans un environnement dépourvu des versions
protobufetnumpyindiquées dans le guide de démarrage rapide, la première exportation remplace ces packages pendant son exécution et échoue. Lorsqu’elle remplaceprotobuf7, que pip installe aveconnx, l’erreur estAttributeError: 'google._upb._message.FieldDescriptor' object has no attribute 'label'; lorsqu’elle ne remplace quenumpy, l’erreur estTypeError: only 0-dimensional arrays can be converted to Python scalars. Relance l’exportation dans un nouveau processus — redémarre le noyau dans un notebook — ou installe"protobuf<7" "numpy<2.4"avant la première exportation, comme indiqué dans le guide de démarrage rapide. -
Les modèles RKNN ne s’exécutent pas sur un PC : la prédiction ou la validation avec
YOLO("yolo26n_rknn_model")échoue avecRKNN inference is only supported on Rockchip devices.sur un PC, ainsi que sur une carte dont la chaîne/proc/device-tree/compatiblene se termine pas par l’un des noms de puces pris en charge. Affiche cette chaîne aveccat /proc/device-tree/compatible. -
FP32 :
quantize=32échoue avecquantize=32 (FP32) is not supported; format='rknn' supports quantize=16 (FP16), 8 (INT8). -
Puces compatibles uniquement avec INT8 : pour
rv1103,rv1106,rv1103betrv1106b, une exportation sansquantizeafficheRockchip target 'rv1106' requires INT8 quantization, enabling it.et produit un modèle INT8 ;quantize=16échoue avecRockchip target 'rv1106' only supports INT8, but got quantize=16. -
namemanquant ou incorrect : sansname, l’exportation afficheRockchip RKNN export requires a missing 'name' arg for processor type. Using default name='rk3588'.. Une valeur inconnue échoue avecInvalid processor name 'rk9999' for Rockchip RKNN export., suivie des noms valides. -
Tête sans NMS : les modèles RKNN renvoient toujours des prédictions brutes nécessitant une NMS. Avec
nms=False, l’exportation d’un modèle YOLO26 ou YOLOv10 afficheThis export format does not support end2end models, disabling the end2end branch.et utilise la tête un-à-plusieurs ; pour les autres modèles de détection, de segmentation, de pose et OBB, comme YOLO11, elle afficheThis model has no one-to-one head; using one-to-many outputs.. Les modèles de classification, de segmentation sémantique et de profondeur ignorentnms=False. -
NMS intégrée :
nms=Trueafficheformat=rknn does not support embedded NMS; exporting native outputs for external NMS.et écrit la sortie brute. -
Points de contrôle entraînés avec
quantize=8: un point de contrôle affiné par entraînement sensible à la quantification échoue avecformat='rknn' cannot export a QAT model: its Q/DQ ranges are only read by the 'onnx' and 'engine' backends. Exporte plutôt le point de contrôle utilisé au début de l’affinage avecquantize=8. -
RT-DETR : avec
rknn-toolkit22.3.2, l’exportation d’un modèle RT-DETR échoue dans la boîte à outils en FP16 comme en INT8, pourrtdetr-l.ptàimgsz=640avecValueError: operands could not be broadcast together with shapes (256,256) (8400,1). -
Forme d’entrée fixe :
dynamic=Trueéchoue avecargument 'dynamic' is not supported for format='rknn'. Effectue une nouvelle exportation pour modifier la taille de l’image ou la taille du lot. -
Étalonnage sans
data: une exportation de détectionquantize=8afficheINT8 export requires a missing 'data' arg for calibration. Using default 'data=coco8.yaml'.et utilise ce petit jeu de données pour l’étalonnage ; les autres tâches indiquent leur propre jeu de données par défaut. Fournisdataavec des images représentatives de tes données de déploiement. -
Taille de l’étalonnage : l’exportation affiche
>300 images recommended for INT8 calibration, found 4 images.si la partition d’étalonnage contient moins de 300 images.coco8.yamlne contient que 4 images de validation, ce qui suffit pour tester l’exportation, mais pas pour étalonner un modèle destiné au déploiement. -
Répertoire de sortie : chaque exportation d’un même point de contrôle écrit dans le même répertoire
yolo26n_rknn_model/, quels que soientname,quantize,imgszoubatch; elle supprime d’abord son contenu précédent. Renomme le répertoire avant d’exporter pour une deuxième puce ou précision, et conserve_rknn_modeldans son nom, par exempleyolo26n_rk3566_rknn_model/, car Ultralytics reconnaît le format grâce à celui-ci. -
Opérations ONNX : un
opsetsupérieur à 19 consignerknn-toolkit2 requires opset<=19, setting opset=19. -
Modèles INT8 des versions antérieures : réexporte les modèles de détection, de segmentation, de pose et OBB en INT8 qui ont été exportés avant
ultralytics8.4.191, la version qui a ajoutétail.onnx. Ces modèles renvoient des coordonnées de boîtes et de points clés relatives à la taille d’entrée, que les versions actuelles ne remettent plus à l’échelle ; ils se chargent donc sans erreur, mais renvoient des boîtes incorrectes. -
Incompatibilité de version du runtime : si le journal sur l’appareil indique que la version du runtime RKNN ne correspond pas à celle de RKNN Toolkit et que l’inférence échoue, remplace
/usr/lib/librknnrt.sopar le fichier officiellibrknnrt.so.
Pour les autres erreurs, consulte le guide des problèmes courants.
Benchmarks#
Les benchmarks YOLO26 ci-dessous ont été réalisés par l'équipe Ultralytics sur un Radxa Rock 5B basé sur le Rockchip RK3588, en utilisant le format de modèle rknn pour mesurer la vitesse et la précision.
| Modèle | Format | Précision | Statut | Taille (Mo) | mAP50-95(B) | Temps d’inférence (ms/im) |
|---|---|---|---|---|---|---|
| YOLO26n | rknn | FP16 | ✅ | 7.2 | 0.477 | 58.5 |
| YOLO26n | rknn | INT8 | ✅ | 4.1 | 0.463 | 41.2 |
| YOLO26s | rknn | FP16 | ✅ | 21.0 | 0.569 | 93.8 |
| YOLO26s | rknn | INT8 | ✅ | 12.0 | 0.554 | 61.9 |
| YOLO26m | rknn | FP16 | ✅ | 43.0 | 0.608 | 226.3 |
| YOLO26m | rknn | INT8 | ✅ | 22.0 | 0.603 | 122.0 |
| YOLO26l | rknn | FP16 | ✅ | 53.0 | 0.628 | 264.7 |
| YOLO26l | rknn | INT8 | ✅ | 28.0 | 0.617 | 145.3 |
| YOLO26x | rknn | FP16 | ✅ | 113.0 | 0.664 | 655.4 |
| YOLO26x | rknn | INT8 | ✅ | 58.0 | 0.649 | 287.4 |
Évalué avec ultralytics 8.4.60
La validation des benchmarks ci-dessus a été effectuée avec le jeu de données COCO128. Le temps d’inférence n’inclut pas le prétraitement ni le post-traitement. Les lignes INT8 seront actualisées lorsque le chemin d’export INT8 actuel (décodage côté hôte et auto_hybrid) aura été validé sur du matériel Rockchip.
Les tailles du tableau ont été relevées avec cette version antérieure ; les tailles indiquées ailleurs sur cette page correspondent au fichier .rknn d’un export actuel, en Mo (10^6 octets). La page des modèles YOLO26 indique la précision des points de contrôle PyTorch sur l’ensemble complet de validation COCO.
À propos de RKNN#
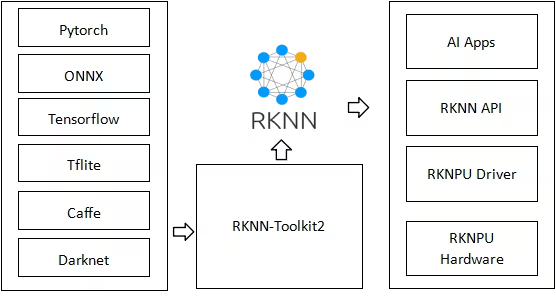
Rockchip conçoit des systèmes sur puce basés sur ARM avec des NPU intégrés, utilisés dans des ordinateurs monocartes et des produits embarqués d’entreprises telles que Radxa, ASUS, Pine64, Orange Pi, Odroid, Khadas et Banana Pi. RKNN, abréviation de Rockchip Neural Network, est le format de modèle de ces NPU, et le RKNN Toolkit convertit les modèles dans ce format sur un PC et les exécute sur l’appareil.
FAQ#
Utilise le nom du processeur de la carte, et non celui de la carte :
rk3588pour une Radxa Rock 5B, par exemple, ourk3566pour une Radxa Zero 3W. Sur la carte,cat /proc/device-tree/compatibleaffiche la chaîne qui permet à Ultralytics de détecter la puce. Un modèle exporté pour une puce n’est pas conçu pour une autre ; effectue donc un export par puce. Consulte Puces cibles pour connaître les noms acceptés.Commence par FP16, la valeur par défaut. Il ne nécessite pas de données d’étalonnage et renvoie ses prédictions brutes sans second modèle sur le CPU. Choisis INT8 (
quantize=8) si tu as besoin d’un modèle plus petit et plus rapide, ou si la puce ne prend en charge que INT8 : YOLO26n pour le RK3588 pèse 4,3 Mo en INT8 contre 7,4 Mo en FP16 et, dans les benchmarks, mesurés avec un export antérieur, INT8 exécutait YOLO26n en 41,2 ms par image contre 58,5 ms en FP16. INT8 nécessite des données d’étalonnage représentatives et, pour les modèles de détection, de segmentation, de pose et OBB, effectue le décodage des boîtes sur le CPU avectail.onnx. Mesure la latence et la précision sur ton appareil avant de faire ton choix.Pas avec
YOLO(), qui charge les modèles RKNN uniquement sur les appareils Rockchip. Pour vérifier le modèle lui-même sur le PC, valide le point de contrôle PyTorch ou le fichier intermédiaireyolo26n.onnxque l’export laisse à côté du répertoire, avec ONNX Runtime : le modèle RKNN est converti à partir de ce graphe. Cela ne remplace pas une validation sur l’appareil, en particulier pour INT8, car la quantification modifie les sorties.Oui, en utilisant le format d’export propre à chaque accélérateur : un modèle RKNN s’exécute uniquement sur les NPU Rockchip. Consulte TensorRT pour NVIDIA Jetson, Hailo, Axelera, DeepX et Coral Edge TPU, ou consulte le guide des options de déploiement des modèles pour un aperçu.


Commentaires45
Pose une question, partage tes résultats ou aide quelqu’un d’autre.
as-jackson
We are pleased to confirm that the following ArmSoM boards based on Rockchip RK3576 have been successfully tested with Ultralytics projects (e.g., YOLO11n):
Validation Scope:
Model training/inference pipeline
1yizi72
I tried to convert the yolo11n.pt into a rknn model through codes below: from ultralytics import YOLO model = YOLO("yolo11n.pt") model.export(format="rknn", name="rk3588") and everything went correct. A rknn model named yolo11n-rk3588.rknn was build and used to infer a very traditional yolo demo image "bus"(a blue bus with several people in front of it), but no detection result was obtained.
I tried to convert the yolol11n.pt into onnx model through above codes firstly, and then used a convert.py offered by rknn_model_zoo/examples/yolo11/python,
import sys from rknn.api import RKNN
DATASET_PATH = '../../../datasets/COCO/coco_subset_20.txt' DEFAULT_RKNN_PATH = '/home/yizi/model/yolo11/yolodet.rknn' DEFAULT_QUANT = False
def parse_arg(): if len(sys.argv) < 3: print("Usage: python3 {} onnx_model_path [platform] [dtype(optional)] [output_rknn_path(optional)]".format(sys.argv[0])) print(" platform choose from [rk3562,rk3566,rk3568,rk3588,rk3576,rk1808,rv1109,rv1126]") print(" dtype choose from [i8, fp] for [rk3562,rk3566,rk3568,rk3588,rk3576]") print(" dtype choose from [u8, fp] for [rk1808,rv1109,rv1126]") exit(1)
model_path = sys.argv[1]
platform = sys.argv[2]

do_quant = DEFAULT_QUANT
if len(sys.argv) > 3:
    model_type = sys.argv[3]
    if model_type not in ['i8', 'u8', 'fp']:
        print("ERROR: Invalid model type: {}".format(model_type))
        exit(1)
    elif model_type in ['i8', 'u8']:
        do_quant = True
    else:
        do_quant = False

if len(sys.argv) > 4:
    output_path = sys.argv[4]
else:
    output_path = DEFAULT_RKNN_PATH

return model_path, platform, do_quant, output_path
if name == 'main': model_path, platform, do_quant, output_path = parse_arg()
# Create RKNN object
rknn = RKNN(verbose=False)

# Pre-process config
print('--> Config model')
rknn.config(mean_values=[[0, 0, 0]], std_values=[[255, 255, 255]], target_platform=platform)
print('done')

# Load model
print('--> Loading model')
ret = rknn.load_onnx(model=model_path)
if ret != 0:
    print('Load model failed!')
    exit(ret)
print('done')

# Build model
print('--> Building model')
ret = rknn.build(do_quantization=do_quant, dataset=DATASET_PATH)
if ret != 0:
    print('Build model failed!')
    exit(ret)
print('done')

# Export rknn model
print('--> Export rknn model')
ret = rknn.export_rknn(output_path)
if ret != 0:
    print('Export rknn model failed!')
    exit(ret)
print('done')

# Release
rknn.release()
Still everything went correct. A rknn model was created and applied to "bus.jpg", and there was no detection at all. I wonder what's wrong in the whole process?
1 Glenn JocherUltralytics
@yizi72 thanks for the detailed report. For RKNN inference issues with YOLO11, please ensure:
- You're using matching RKNN Toolkit and runtime versions (update both if needed)
- Input images are 640x640 with pixel values normalized 0-255
- You load models via
YOLO('./yolo11n_rknn_model')as shown in our RKNN deployment docs
If issues persist, please share your full environment details and validation results from both export methods.
1、I used rknn-toolkit2-2.3.0 which is the latest version ,bu I still did "pip install rknn-toolkit2 --upgrade" again. 2、The input image is 640*640, uchar, 0-255. 3. I used the following setting to transfer yolo11n.pt to onnx, from ultralytics import YOLO
加载一个模型,路径为 YOLO 模型的 .pt 文件
model = YOLO("yolo11n.pt")
导出模型,设置多种参数
model.export( format="onnx", imgsz=(640, 640),
keras=False,
optimize=True,
half=False,
int8=False,
dynamic=False,
simplify=True,
opset=12,
#workspace=4.0,
nms=False,
batch=1
) and applied the following codes to verify yolo11n.onnx model:from ultralytics import YOLO from PIL import Image
Load a model
model = YOLO("/home/yizi/models/yolo11/yolo11n.onnx") # load an official model
Predict with the model
results = model("bus.jpg") # predict on an image #results = rknn_model("bus.jpg")
Access the results
for result in results: xywh = result.boxes.xywh # center-x, center-y, width, height xywhn = result.boxes.xywhn # normalized xyxy = result.boxes.xyxy # top-left-x, top-left-y, bottom-right-x, bottom-right-y xyxyn = result.boxes.xyxyn # normalized names = [result.names[cls.item()] for cls in result.boxes.cls.int()] # class name of each box confs = result.boxes.conf # confidence score of each box
The results are good. All objects in bus.jpg were detected. Then I run the following code to transfer onnx to rknn:
from rknn.api import RKNN import cv2 import numpy as np
if name == 'main': rknn = RKNN(verbose=True,verbose_file="log.txt") rknn.config( mean_values=[[0, 0, 0]], std_values=[[255, 255, 255]], target_platform="rk3588", optimization_level=3 )
rknn.load_onnx(
    model="/home/yizi/models/yolo11/yolo11n.onnx",
    input_size_list=[[1,3,640,640]],
)
rknn.build(
    do_quantization=False
)

rknn.export_rknn(
    export_path="/home/yizi/models/yolo11/yolo11n.rknn"
)

rknn.release()
The transferring process went smooth, two problems appeared.
Firstly,when this rknn model was pushed into a rk3588 tablet, and run with a binary executable file generated by cross-compilation, no result was detected.
Secondly, I tried to run the following codes:
from ultralytics import YOLO from PIL import Image
rknn_model = YOLO("/home/yizi/models/yolo11/yolo11n.rknn", task=detect)
results = model("bus.jpg")
An error message, "model='/home/yizi/models/yolo11/yolo11n.rknn' is not a supported model format. Ultralytics supports: ('PyTorch', 'TorchScript', 'ONNX', 'OpenVINO', 'TensorRT', 'CoreML', 'TensorFlow SavedModel', 'TensorFlow GraphDef', 'TensorFlow Lite', 'TensorFlow Edge TPU', 'TensorFlow.js', 'PaddlePaddle', 'MNN', 'NCNN', 'IMX', 'RKNN') See https://docs.ultralytics.com/modes/predict for help. " appeared.
Last question, how many outputs does yolo11 yield? one or six?
- Glenn JocherUltralytics
@yizi72 thank you for the detailed report. For RKNN deployment issues:
- When using Ultralytics RKNN export, load models via the exported directory (not .rknn file), as shown in our RKNN deployment docs:
model = YOLO('./yolo11n_rknn_model') # directory path-
Ensure your RK3588 runtime uses matching librknnrt.so versions with your RKNN Toolkit 2.3.0 installation
-
YOLO11 detection models output 3 tensors by default (different from older YOLO versions). For conversion issues, we recommend using our native
model.export(format='rknn')rather than manual ONNX conversion.
Let me know if you still face issues after verifying these points.
Thanks for replies. I did verify all points you've mentioned above. When running model("bus.jpg"), error messages show:
File "/home/yizi/anaconda3/envs/rknn/lib/python3.9/site-packages/ultralytics/engine/model.py", line 182, in call return self.predict(source, stream, **kwargs) File "/home/yizi/anaconda3/envs/rknn/lib/python3.9/site-packages/ultralytics/engine/model.py", line 543, in predict self.predictor.setup_model(model=self.model, verbose=is_cli) File "/home/yizi/anaconda3/envs/rknn/lib/python3.9/site-packages/ultralytics/engine/predictor.py", line 378, in setup_model self.model = AutoBackend( File "/home/yizi/anaconda3/envs/rknn/lib/python3.9/site-packages/torch/utils/_contextlib.py", line 116, in decorate_context return func(*args, **kwargs) File "/home/yizi/anaconda3/envs/rknn/lib/python3.9/site-packages/ultralytics/nn/autobackend.py", line 495, in init raise OSError("RKNN inference is only supported on Rockchip devices.") OSError: RKNN inference is only supported on Rockchip devices.
It's very strange because I did connect a RK3588 tablet with my virtual machine.
I still have a quesiton on yolo11n output: yolo11n.pt has one output with shape (1, 84, 8400), and yolo11n-rk3588.rknn has one output with shape (1,84, 8400, 0). Are they correct? If so, can I use the similar codes to analyze rknn output, such as :
for result in results: xywh = result.boxes.xywh # center-x, center-y, width, height xywhn = result.boxes.xywhn # normalized xyxy = result.boxes.xyxy # top-left-x, top-left-y, bottom-right-x, bottom-right-y xyxyn = result.boxes.xyxyn # normalized names = [result.names[cls.item()] for cls in result.boxes.cls.int()] # class name of each box confs = result.boxes.conf
- Glenn JocherUltralytics
@yizi72 thanks for the details. For the RKNN inference error: ensure your Python script is running directly on the RK3588 hardware (not through a VM) as RKNN models require native Rockchip NPU access. Regarding outputs, YOLO11 detection models produce 3 output tensors by default (see our RKNN deployment docs), but your code should work if using the exported RKNN directory with the included postprocessing. Let me know if you still face issues after verifying native hardware execution.
 Yufeng Wu
Hello, Ultralytics team. I wonder if it's possible to port yolo26n-pose to rknn? I'm not sure if it's difficult to work out on my own? Is there any model architecture problems that prevent porting the pose models to rknn?
- Glenn JocherUltralytics
@kamosmkey exports fine. See https://platform.ultralytics.com/glenn-jocher/example-project/exp-24?tab=export
2
montemadjo
It appears it does not support rv1106 platform yet
When I try to export the model using this command
model.export(format="rknn", name="rv1106", imgsz=320)It gives the following error
E build: Current target_platform(rv1106) not support do_quantization = False!
E export_rknn: RKNN model does not exist, please load & build model first!
🤔
- Glenn JocherUltralytics(modifié)
rv1106is an INT8-only target, so it needs a quantized RKNN build. Older Ultralytics releases always built withdo_quantization=False, which fails with the message you saw. Current releases support it: upgrade withpip install -U ultralyticsand export withquantize=8plus calibration data:model.export(format="rknn", name="rv1106", imgsz=320, quantize=8, data="coco8.yaml")See the Rockchip RKNN export guide. If it still fails, share your
!yolo checksoutput andrknn-toolkit2version here and we can sanity-check the environment.1 Here's the quick workaround for those who want to work with yolo26 on RV1106 chip (like Luckfox pico etc). I ran into a couple of issues there, including quantization erasing my confidence results.
Long story short - first you need to monkey-patch head.Detect.forward function in order to get two tensors - one for bboxes and one for scores. That way you escape all the heavy non-supported tensor functions. Then you export your yolo26 model to onnx format and finally to rknn like this
import torch
from ultralytics.nn.modules import head

# 1. First we monkey-patch the forward function
def patched_forward(self, x):
    if self.end2end:
        h = self.one2one
    else:
        h = self.one2many

    box_head = h["box_head"]
    cls_head = h["cls_head"]

    if box_head is None or cls_head is None:
        raise RuntimeError("Head moduls are None")

    bs = x[0].shape[0]
    boxes = torch.cat([box_head[i](x[i]).view(bs, 4 * self.reg_max, -1) for i in range(self.nl)], dim=-1)
    scores = torch.cat([cls_head[i](x[i]).view(bs, self.nc, -1) for i in range(self.nl)], dim=-1)

    preds = {"boxes": boxes, "scores": scores, "feats": x}
    y = self._inference(preds)

    # We are splitting into 2 tensors - both gets its own scale/zp at INT8 quantization
    bboxes = y[:, :4, :]   # [1, 4, 2100] — range 0-640
    scores = y[:, 4:, :]   # [1, 1, 2100] — range 0-1 (already sigmoid-ed)
    score_max_idx = scores[0, 0, :].argmax()
    return bboxes, scores

head.Detect.forward = patched_forward

# 2. Then we export to onnx model (we got best.pt model from ultralytics platform)
from ultralytics import YOLO
model = YOLO("best.pt")
model.export(format="onnx", dynamic=False, opset=12, imgsz=320)

# 3. Then we export to RKNN format
from rknn.api import RKNN

rknn = RKNN()

# 3.1. Konfiguracija specifična za RV1106
rknn.config(
    mean_values=[[0, 0, 0]],
    std_values=[[255, 255, 255]],
    target_platform='rv1106',
    quantized_algorithm='normal', # Ili 'mmse' za bolju preciznost
    quantized_dtype='asymmetric_quantized-8'
)

# 3.2. Load the ONNX model
print("Loading ONNX model...")
rknn.load_onnx(model='best.onnx')

# 3.3. Build modela sa INT8 kvantizacijom
# calib.txt should contain paths to calibration images
print("Building RKNN model with quantization...")
rknn.build(do_quantization=True, dataset='./calib.txt')

# 3.4. Exporting final .rknn file
print("Exporting RKNN model...")
rknn.export_rknn('./yolo26_rv1106_model_optimized.rknn')

rknn.release()
After this you need to postprocess those two outputs like this
yolo26_postprocess.h
/**
 * YOLO26 Post-processing header for Fish Counter
 *
 * Supports YOLO26 2-output format: boxes [1, 4, N] + scores [1, nc, N]
 *
 * Based on the working rknn_minimal_test example.
 */

#ifndef _YOLO26_POSTPROCESS_H_
#define _YOLO26_POSTPROCESS_H_

#include <stdint.h>
#include <vector>
#include "rknn_api.h"
#include "rknn_detector.h"

// YOLO26 model configuration defaults
#define YOLO26_CONF_THRESHOLD 0.25f
#define YOLO26_NMS_THRESHOLD 0.45f

// Detection result (same structure as postprocess.h for compatibility)
typedef struct
{
    float x1, y1, x2, y2; // Bounding box (in model coordinates)
    float confidence;
    int class_id;
} yolo26_detection_t;

// YOLO26 context for format detection and caching
typedef struct
{
    int num_predictions;
    int num_classes;
    bool boxes_transposed; // true = [1, 4, N], false = [1, N, 4]
} yolo26_context_t;

/**
 * Initialize YOLO26 post-processing
 * Detects the output format from model attributes
 *
 * @param app_ctx The RKNN app context with model info
 * @param yolo26_ctx Output: YOLO26 context for format info
 * @return 0 on success, -1 on error
 */
int yolo26_init_postprocess(rknn_app_context_t *app_ctx, yolo26_context_t *yolo26_ctx);

/**
 * Deinitialize YOLO26 post-processing
 */
void yolo26_deinit_postprocess();

/**
 * YOLO26 post_process: processes model outputs and returns detections
 * Uses 2-output format: boxes [1, 4, N] + scores [1, nc, N]
 *
 * @param app_ctx The RKNN app context
 * @param yolo26_ctx YOLO26 context from init
 * @param outputs Pointer to output tensor memory array
 * @param letter_box Letterbox transform info for coordinate mapping
 * @param conf_threshold Confidence threshold
 * @param nms_threshold NMS threshold
 * @param od_results Output: detection results (compatible with existing code)
 * @return 0 on success, -1 on error
 */
int yolo26_post_process(rknn_app_context_t *app_ctx, yolo26_context_t *yolo26_ctx,
                        void *outputs, letterbox_t *letter_box,
                        float conf_threshold, float nms_threshold,
                        object_detect_result_list *od_results);

#endif // _YOLO26_POSTPROCESS_H_
yolo26_postprocess.cc
/**
 * YOLO26 Post-processing for Fish Counter on RV1106
 *
 * Supports YOLO26 2-output format: boxes [1, 4, N] + scores [1, nc, N]
 *
 * Based on the working rknn_minimal_test example.
 */

#include "yolo26_postprocess.h"

#include <math.h>
#include <stdint.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <algorithm>
#include <vector>

// Clamp value to range
inline static int clamp(float val, int min, int max)
{
    return val > min ? (val < max ? val : max) : min;
}

// Dequantize INT8 to float
static inline float dequantize(int8_t qnt, int32_t zp, float scale)
{
    return ((float)qnt - (float)zp) * scale;
}

// Sigmoid function
static inline float sigmoid(float x)
{
    return 1.0f / (1.0f + expf(-x));
}

// Calculate IoU between two boxes
static float calculate_iou(float x1_a, float y1_a, float x2_a, float y2_a,
                           float x1_b, float y1_b, float x2_b, float y2_b)
{
    float x1 = std::max(x1_a, x1_b);
    float y1 = std::max(y1_a, y1_b);
    float x2 = std::min(x2_a, x2_b);
    float y2 = std::min(y2_a, y2_b);

    float inter_w = std::max(0.0f, x2 - x1);
    float inter_h = std::max(0.0f, y2 - y1);
    float inter_area = inter_w * inter_h;

    float area_a = (x2_a - x1_a) * (y2_a - y1_a);
    float area_b = (x2_b - x1_b) * (y2_b - y1_b);
    float union_area = area_a + area_b - inter_area;

    return union_area > 0 ? inter_area / union_area : 0;
}

// Non-Maximum Suppression for YOLO26 detections
static std::vector<yolo26_detection_t> yolo26_nms(std::vector<yolo26_detection_t> &detections, float nms_threshold)
{
    // Sort by confidence (descending)
    std::sort(detections.begin(), detections.end(),
              [](const yolo26_detection_t &a, const yolo26_detection_t &b)
              { return a.confidence > b.confidence; });

    std::vector<yolo26_detection_t> result;
    std::vector<bool> suppressed(detections.size(), false);

    for (size_t i = 0; i < detections.size(); i++)
    {
        if (suppressed[i])
            continue;

        result.push_back(detections[i]);

        for (size_t j = i + 1; j < detections.size(); j++)
        {
            if (suppressed[j])
                continue;

            // Only suppress same class
            if (detections[i].class_id != detections[j].class_id)
                continue;

            float iou = calculate_iou(
                detections[i].x1, detections[i].y1, detections[i].x2, detections[i].y2,
                detections[j].x1, detections[j].y1, detections[j].x2, detections[j].y2);

            if (iou > nms_threshold)
            {
                suppressed[j] = true;
            }
        }
    }

    return result;
}

// Parse YOLO26 2-output format: boxes [1, 4, N] + scores [1, nc, N]
static std::vector<yolo26_detection_t> parse_yolo26_2output(
    rknn_tensor_mem **output_mems,
    rknn_tensor_attr *output_attrs,
    int model_width, int model_height,
    float conf_threshold, int num_classes,
    bool boxes_transposed)
{
    std::vector<yolo26_detection_t> detections;

    int8_t *boxes_data = (int8_t *)output_mems[0]->virt_addr;
    int32_t boxes_zp = output_attrs[0].zp;
    float boxes_scale = output_attrs[0].scale;

    int8_t *scores_data = (int8_t *)output_mems[1]->virt_addr;
    int32_t scores_zp = output_attrs[1].zp;
    float scores_scale = output_attrs[1].scale;

    // Determine number of anchors
    int num_anchors;
    if (boxes_transposed)
    {
        num_anchors = output_attrs[0].dims[2];
    }
    else
    {
        num_anchors = output_attrs[0].dims[1];
    }

    // Check if scores are already sigmoid or logits
    float scores_min = 9999, scores_max = -9999;
    for (int i = 0; i < (int)output_attrs[1].n_elems; i++)
    {
        float val = dequantize(scores_data[i], scores_zp, scores_scale);
        if (val < scores_min)
            scores_min = val;
        if (val > scores_max)
            scores_max = val;
    }
    bool scores_are_sigmoid = (scores_min >= -0.1f && scores_max <= 1.1f);

    for (int i = 0; i < num_anchors; i++)
    {
        // Get box coordinates
        float x1, y1, x2, y2;
        if (boxes_transposed)
        {
            // [1, 4, N] - channel first
            x1 = dequantize(boxes_data[0 * num_anchors + i], boxes_zp, boxes_scale);
            y1 = dequantize(boxes_data[1 * num_anchors + i], boxes_zp, boxes_scale);
            x2 = dequantize(boxes_data[2 * num_anchors + i], boxes_zp, boxes_scale);
            y2 = dequantize(boxes_data[3 * num_anchors + i], boxes_zp, boxes_scale);
        }
        else
        {
            // [1, N, 4] - anchor first
            x1 = dequantize(boxes_data[i * 4 + 0], boxes_zp, boxes_scale);
            y1 = dequantize(boxes_data[i * 4 + 1], boxes_zp, boxes_scale);
            x2 = dequantize(boxes_data[i * 4 + 2], boxes_zp, boxes_scale);
            y2 = dequantize(boxes_data[i * 4 + 3], boxes_zp, boxes_scale);
        }

        // Check if format is xywh instead of xyxy
        if (x2 < x1 || y2 < y1)
        {
            // Assume xywh format: convert to xyxy
            float cx = x1, cy = y1, w = x2, h = y2;
            x1 = cx - w / 2.0f;
            y1 = cy - h / 2.0f;
            x2 = cx + w / 2.0f;
            y2 = cy + h / 2.0f;
        }

        // Find max class score
        float max_score = -9999;
        int max_class = 0;
        for (int c = 0; c < num_classes; c++)
        {
            float score;
            if (boxes_transposed)
            {
                // [1, nc, N]
                score = dequantize(scores_data[c * num_anchors + i], scores_zp, scores_scale);
            }
            else
            {
                // [1, N, nc]
                score = dequantize(scores_data[i * num_classes + c], scores_zp, scores_scale);
            }

            if (!scores_are_sigmoid)
            {
                score = sigmoid(score);
            }

            if (score > max_score)
            {
                max_score = score;
                max_class = c;
            }
        }

        if (max_score < conf_threshold)
            continue;

        // Clamp to model bounds
        x1 = std::max(0.0f, std::min(x1, (float)model_width));
        y1 = std::max(0.0f, std::min(y1, (float)model_height));
        x2 = std::max(0.0f, std::min(x2, (float)model_width));
        y2 = std::max(0.0f, std::min(y2, (float)model_height));

        // Skip invalid boxes
        if (x2 <= x1 || y2 <= y1)
            continue;

        yolo26_detection_t det;
        det.x1 = x1;
        det.y1 = y1;
        det.x2 = x2;
        det.y2 = y2;
        det.confidence = max_score;
        det.class_id = max_class;

        detections.push_back(det);
    }

    return detections;
}

int yolo26_init_postprocess(rknn_app_context_t *app_ctx, yolo26_context_t *yolo26_ctx)
{
    if (!app_ctx || !yolo26_ctx)
    {
        printf("[YOLO26] ERROR: Invalid parameters\n");
        return -1;
    }

    memset(yolo26_ctx, 0, sizeof(yolo26_context_t));

    int n_output = app_ctx->io_num.n_output;

    printf("[YOLO26] Initializing 2-output format (%d outputs)...\n", n_output);

    // Print output tensor info
    for (int i = 0; i < n_output; i++)
    {
        printf("  Output %d: dims=[%d,%d,%d,%d], size=%d\n", i,
               app_ctx->output_attrs[i].dims[0],
               app_ctx->output_attrs[i].dims[1],
               app_ctx->output_attrs[i].dims[2],
               app_ctx->output_attrs[i].dims[3],
               app_ctx->output_attrs[i].size);
    }

    if (n_output != 2)
    {
        printf("[YOLO26] ERROR: Expected 2 outputs (boxes + scores), got %d\n", n_output);
        return -1;
    }

    // Parse 2-output format: boxes + scores
    int boxes_dim1 = app_ctx->output_attrs[0].dims[1];
    int boxes_dim2 = app_ctx->output_attrs[0].dims[2];
    int scores_dim1 = app_ctx->output_attrs[1].dims[1];
    int scores_dim2 = app_ctx->output_attrs[1].dims[2];

    if (boxes_dim1 == 4)
    {
        // [1, 4, N] boxes format
        yolo26_ctx->num_predictions = boxes_dim2;
        yolo26_ctx->boxes_transposed = true;
        yolo26_ctx->num_classes = scores_dim1;
        printf("[YOLO26] Format: boxes [1,4,%d], scores [1,%d,%d]\n",
               boxes_dim2, scores_dim1, scores_dim2);
    }
    else if (boxes_dim2 == 4)
    {
        // [1, N, 4] boxes format
        yolo26_ctx->num_predictions = boxes_dim1;
        yolo26_ctx->boxes_transposed = false;
        yolo26_ctx->num_classes = scores_dim2;
        printf("[YOLO26] Format: boxes [1,%d,4], scores [1,%d,%d]\n",
               boxes_dim1, scores_dim1, scores_dim2);
    }
    else
    {
        printf("[YOLO26] ERROR: Invalid boxes dimensions [1,%d,%d], expected [1,4,N] or [1,N,4]\n",
               boxes_dim1, boxes_dim2);
        return -1;
    }

    printf("[YOLO26] Predictions: %d, Classes: %d\n",
           yolo26_ctx->num_predictions, yolo26_ctx->num_classes);

    return 0;
}

void yolo26_deinit_postprocess()
{
    // Nothing to cleanup currently
}

int yolo26_post_process(rknn_app_context_t *app_ctx, yolo26_context_t *yolo26_ctx,
                        void *outputs, letterbox_t *letter_box,
                        float conf_threshold, float nms_threshold,
                        object_detect_result_list *od_results)
{
    if (!app_ctx || !yolo26_ctx || !outputs || !letter_box || !od_results)
    {
        return -1;
    }

    rknn_tensor_mem **output_mems = (rknn_tensor_mem **)outputs;

    int model_width = app_ctx->model_width;
    int model_height = app_ctx->model_height;

    // Parse 2-output format
    std::vector<yolo26_detection_t> raw_detections = parse_yolo26_2output(
        output_mems,
        app_ctx->output_attrs,
        model_width, model_height,
        conf_threshold,
        yolo26_ctx->num_classes > 0 ? yolo26_ctx->num_classes : 1,
        yolo26_ctx->boxes_transposed);

    // Apply NMS
    std::vector<yolo26_detection_t> final_detections = yolo26_nms(raw_detections, nms_threshold);

    // Convert to output format with letterbox coordinate mapping
    memset(od_results, 0, sizeof(object_detect_result_list));
    int count = 0;

    for (const auto &det : final_detections)
    {
        if (count >= OBJ_NUMB_MAX_SIZE)
            break;

        // Map coordinates back to original image space
        float x1 = det.x1 - letter_box->x_pad;
        float y1 = det.y1 - letter_box->y_pad;
        float x2 = det.x2 - letter_box->x_pad;
        float y2 = det.y2 - letter_box->y_pad;

        // Scale back to original coordinates
        od_results->results[count].box.left = (int)(clamp(x1, 0, model_width) / letter_box->scale);
        od_results->results[count].box.top = (int)(clamp(y1, 0, model_height) / letter_box->scale);
        od_results->results[count].box.right = (int)(clamp(x2, 0, model_width) / letter_box->scale);
        od_results->results[count].box.bottom = (int)(clamp(y2, 0, model_height) / letter_box->scale);
        od_results->results[count].prop = det.confidence;
        od_results->results[count].cls_id = det.class_id;

        count++;
    }

    od_results->count = count;

    return 0;
}
And you're good to go! 🚀
- Glenn JocherUltralytics(modifié)
Thanks for sharing this—splitting the head into 2 outputs (boxes + scores) is a sensible RV1106 workaround to keep RKNN-friendly ops and avoid INT8 scale/zero-point coupling issues; just note that monkey-patching
head.Detect.forwardis inherently version-fragile. Current Ultralytics already provides an INT8 flow for RV1106 viaquantize=8withdata=calibration images (see the Rockchip RKNN export guide), so please try that first. If you still need your custom split, open a GitHub issue linking back to this thread and include!yolo checks, yourrknn-toolkit2version, and a minimal calibration set description so we can evaluate it.
dttvn0010
99ms per image is too bad. Using rknn native with 3 npu cores, I can achieve ~11ms per image
NikolayKash
Hi, what did you done to achieve this performance?
- Glenn JocherUltralytics
@Arshapjoy thanks for the detailed info; for YOLO11 detection heads the export output shape is
(1, nc + 4, 8400)(4 box coords plusncclass scores), so with 2 classes(1, 6, 8400)is expected and both classes are present, whereas a postprocessor assuming5 + nc(old YOLO layout with an extra objectness channel) will effectively drop one class. I’d suggest updating your RKNN-side decoder to treat channels[0:4]as[x, y, w, h]and[4:]as class logits for allncclasses; if you still see a true(1, 7, 8400)PyTorch output on the same checkpoint, please share yourultralyticsversion andyolo checksoutput so we can dig deeper. The overall YOLO11 head behaviour is also outlined in the YOLO11 model documentation.@BakhtiariB the high-level
YOLO("./yolo11n_rknn_model")interface is designed to keep preprocessing, NPU inference and postprocessing together, so if you need to run only the core RKNN inference on the NPU while fully controlling pre/post on the CPU you’ll need to load the exported.rknnwith Rockchip’sRKNNAPI directly and implement your own preprocessing and YOLO11 postprocessing around it.@dttvn0010 the ~99 ms figure is a conservative end-to-end pipeline measurement on our RK3588 test setup, so seeing ~11 ms from a highly tuned RKNN deployment using all three NPU cores is quite reasonable; if you are open to sharing your exact model variant, quantization mode, input size and NPU core configuration, we can use that to cross-check and better explain the gap between baseline and fully optimized numbers.
@NikolayKash in practice, large gains like that usually come from combining INT8-quantized RKNN models, all three NPU cores enabled, a suitable input resolution and very lean Python-side pre/postprocessing, so it would be great if @dttvn0010 can share their exact script and RK3588 configuration for others to replicate.
guojieli
he YOLO11 benchmark was run by the Ultralytics team on a Radxa Rock 5B based on the Rockchip RK3588, using the RKNN model format to evaluate speed and accuracy. Could you please clarify whether this was an INT8-quantized model?
- Glenn JocherUltralytics(modifié)
Those RKNN benchmarks were not INT8-quantized; they used the floating-point RKNN build. INT8 RKNN export is now available with
quantize=8anddata=for calibration; see the Rockchip RKNN export guide.
BakhtiariB
I used ultralytics for rk3588 by below code, but i want do inference in NPU and do preprocess and postprocess in CPU, how can separate them. while, in below code, line: "results = rknn_model("https://ultralytics.com/images/bus.jpg")" just all of them!
from ultralytics import YOLO
Load the exported RKNN model
rknn_model = YOLO("./yolo11n_rknn_model")
Run inference
results = rknn_model("https://ultralytics.com/images/bus.jpg")
Arshapjoy
Exported RKNN/ONNX model only has 1 output class instead of 2
Overview
I’m using Ultralytics YOLOv11s with two custom classes and exporting it to ONNX and RKNN formats. After conversion, inference on the RKNN device only detects a single class, and the output tensor shape is
(1, 6, 8400)instead of the expected(1, 7, 8400). I’ve validated that the source.ptmodel correctly reports 2 classes, but both ONNX and RKNN exports drop one class.
Model Details
- Checkpoint path:
path/to/yolo11s_custom.pt - Number of classes: 2
- Input size: 640×640
from ultralytics import YOLO
Load the YOLO11 model
model = YOLO("custom_yolo11s.pt")
Export the model to RKNN format
rknn_path = model.export(format="rknn", name="rk3588") print(f"RKNN model saved to: {rknn_path}")
Actual Behavior
- Received ONNX , RKNN and metadata.yaml after conversion
- Exported ONNX model output shape:
(1, 6, 8400) - Exported RKNN model output shape:
(1, 6, 8400) - Only one class is detected during inference on the RK3588 board.
7. Logs & Metadata
- metadata.yaml generated alongside the RKNN model:
model: name: yolo11s_custom format: rknn input_shape: [1, 3, 640, 640] output_shape: [1, 6, 8400] classes: 2 - ONNX graph info: Attached minimal
onnx.shape_inferencelog shows only 6 channels in the final layer.
8. Additional Notes
- Manual ONNX export yields the same issue, so it’s unlikely to be an Ultralytics export bug alone.
- I’ve confirmed that the PyTorch forward pass on the
.ptcheckpoint produces a shape(1, 7, 8400).
9. Request Could you please:
- Confirm whether there’s an option/flag in the YOLO-Ultralytics or RKNN export pipeline I’m missing to preserve all classes.
- Suggest any workarounds or patches to ensure correct output-channel dimensionality.
- Identify if this might be a known issue in RKNN-Toolkit 1.5.0 or Ultralytics YOLO v11.
Thank you for your assistance!
- Checkpoint path:
WeiIIzz
Hello, when I exported the rknn model, I performed int8 quantization, but I had an error like this: E build: If set do_quantization = True, dataset file need be provided. But it`s value is None! E export_rknn: RKNN model does not exist, please load build model first! My export code is: from ultralytics import YOLO
model = YOLO("/home/ky/dfxw/runs/detect/train3/weights/best.pt") model.export(format="rknn", name="rk3576", int8=True, data="/home/ky/rknn_yolo_test/data.yaml") The path pointed to by data is the same as the training dataset. How to solve it
The content of data.yaml is as follows path: /home/ky/dfxw/split_jiaqian # dataset root dir train: images/train val: images/val
names: 0: 0 1: 1
- Glenn JocherUltralytics(modifié)
@WeiIIzz INT8 export for RKNN is supported with
quantize=8(it replaces the deprecatedint8=True) together withdatapointing to a dataset YAML, which Ultralytics converts into the calibration image list that RKNN needs:from ultralytics import YOLO model = YOLO("/home/ky/dfxw/runs/detect/train3/weights/best.pt") model.export(format="rknn", name="rk3576", quantize=8, data="/home/ky/rknn_yolo_test/data.yaml")The error you saw comes from an older version that did not pass a calibration dataset to RKNN, so run
pip install -U ultralyticsand retry. Make sure the YAML points to existing images. Let us know if this resolves your issue! @glenn-jocher I followed your steps to modify the code as follows. But I still encountered the same problem.
from ultralytics import YOLO

model = YOLO("/home/ky/dfxw/runs/detect/train3/weights/best.pt")
model.export(format="rknn", name="rk3576", int8=True, data="/home/ky/rknn_yolo_test/images")
Is there only images in the data path?
- Glenn JocherUltralytics(modifié)
@WeiIIzz older releases ignored
int8=Truefor RKNN and built the model without quantization. Current Ultralytics supports INT8 RKNN export, so afterpip install -U ultralyticsyou can export with:model.export(format="rknn", name="rk3576", quantize=8, data="data.yaml")Here
datais used for the calibration images. Withoutquantize, the export builds a floating-point (FP16) model.
VictorAboba
Good day,
Is RKNN available for obb tasks? I tried to use it directly, but got an error saying that some operations (cos) are not available in RKNN. As a fix, RKNN suggested adding disable_rules = ['reduce_reshape_op_around_concat'] to my configuration. I actually did this inside the YOLO library. Model was exported first to ONNX and then from ONNX to RKNN works and returns the responses in the format (1,6,21504), which seems what I expected. However, if I use this model through YOLO ("path_to_rknn_model", task = 'obb'), will I still get the results in the standard YOLO format? I just don't want to prescribe pre - and post-processing on my own :)
Thank you!
- Glenn JocherUltralytics(modifié)
@VictorAboba thank you for your question! RKNN export now supports all seven Ultralytics tasks, including OBB, so you can export OBB models directly with
format="rknn"and load the exported_rknn_modeldirectory withYOLO(...)to get standard YOLO results without writing your own pre- and post-processing. See the Rockchip RKNN guide for details. Spidrre
Hey! Did you notice any significant decrease in quality of your model after conversion? I am also trying to find a way to convert from OBB onnx to RKNN without 'reduce_reshape_op_around_concat'.
Hey! Did you notice any significant decrease in quality of your model after conversion? I am also trying to find a way to convert from OBB onnx to RKNN without 'reduce_reshape_op_around_concat'.
Hello, after @glenn-jocher answer, I didn't attempt to convert the OBB model. We have a few other models, and all of them except YOLO were converted to the RKNN format. We will try using this stuff (YOLO without an NPU and others with it) ^_^ After conversion, the OCR model, for example, has almost the same quality, but it doesn't need 'reduce_reshape_op_around_concat' to be used.