Dataset Caltech-101#
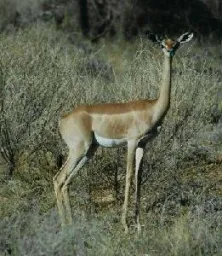
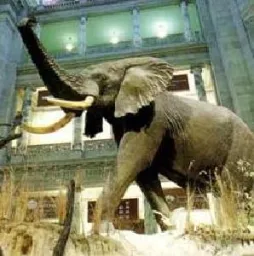
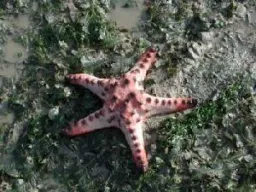
Il dataset Caltech-101 è un benchmark classico di classificazione delle immagini composto da 9.144 immagini che coprono 101 categorie di oggetti più una classe di sfondo. Ogni categoria contiene da circa 40 a 800 immagini di oggetti del mondo reale — animali, veicoli, oggetti domestici e persone — rendendolo un benchmark compatto ma impegnativo per i modelli di riconoscimento degli oggetti.
Esplora Caltech-101 su Ultralytics Platform per visualizzare in anteprima i campioni, esaminare le statistiche del dataset e clonarlo per l'addestramento.
Caltech-101 viene distribuito senza una suddivisione predefinita tra addestramento e validazione. I comandi di addestramento riportati di seguito lo suddividono automaticamente in 80% per l'addestramento e 20% per la validazione, quindi non è necessaria alcuna preparazione manuale.
Funzionalità principali#
- Caltech-101 contiene 9.144 immagini a colori distribuite in 101 categorie di oggetti più una classe
BACKGROUND_Google(102 cartelle di classi in totale). - Le categorie comprendono un'ampia varietà di oggetti del mondo reale, tra cui animali, veicoli, oggetti domestici e persone.
- Ogni categoria contiene da circa 40 a 800 immagini, quindi le dimensioni delle classi sono sbilanciate.
- Le immagini hanno dimensioni variabili, generalmente di circa 300x200 pixel (risoluzione media).
- Caltech-101 è ampiamente utilizzato per valutare algoritmi di classificazione delle immagini e riconoscimento degli oggetti.
Struttura del dataset#
Caltech-101 è distribuito in 102 cartelle — una per classe, a copertura di 101 categorie di oggetti più una classe BACKGROUND_Google — senza una suddivisione predefinita tra addestramento e validazione. Quando avvii l'addestramento, Ultralytics suddivide automaticamente le immagini, così i modelli vengono addestrati su tutte le 102 classi senza alcuna configurazione manuale:
- Classi: 102 (101 categorie di oggetti + 1 sfondo)
- Immagini totali: 9.144
- Suddivisione addestramento/validazione: automatica 80% / 20% (≈7.280 per l'addestramento, ≈1.864 per la validazione)
- Immagini per classe: da circa 40 a 800 (sbilanciate)
Applicazioni#
Caltech-101 è ampiamente utilizzato per addestrare e valutare modelli di classificazione delle immagini e riconoscimento degli oggetti, tra cui reti neurali convoluzionali (CNNs) e macchine a vettori di supporto (SVMs). L'ampia copertura delle categorie e le immagini pulite e annotate lo rendono un benchmark molto usato per la ricerca e la prototipazione nel campo del machine learning e della visione artificiale.
Utilizzo#
Addestra un modello YOLO su Caltech-101 per 100 epoche con una dimensione delle immagini di 416. Per l'elenco completo degli argomenti disponibili, consulta la pagina Addestramento e la guida all'attività di classificazione delle immagini.
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-cls.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="caltech101", epochs=100, imgsz=416)
Immagini ed esempi di annotazioni#
Il dataset Caltech-101 contiene immagini a colori di alta qualità raffiguranti vari oggetti e offre una struttura ben organizzata per le attività di classificazione delle immagini. Ecco alcuni esempi di immagini del dataset:
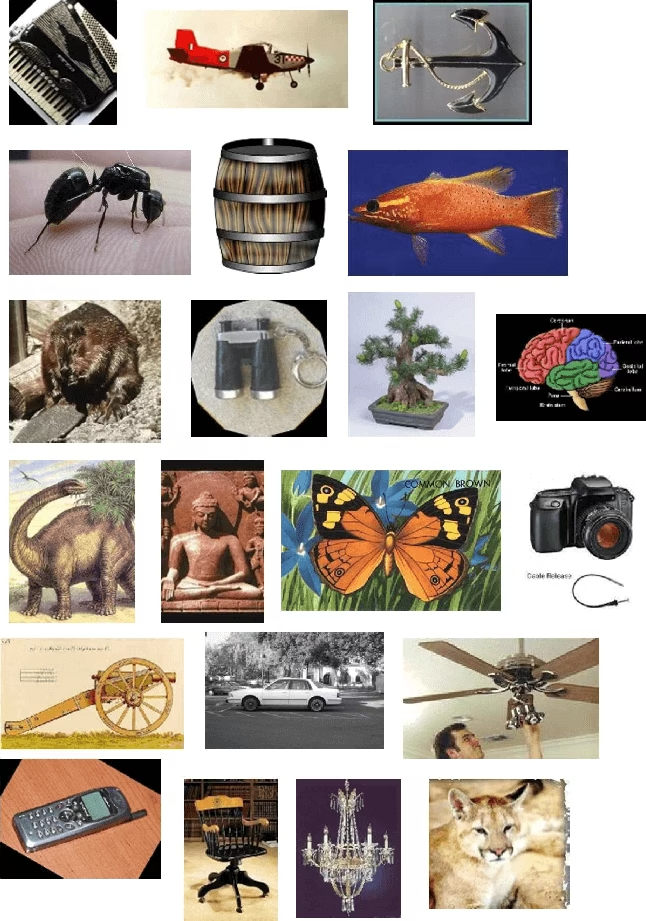
I campioni mostrano la varietà delle categorie e l'inquadratura naturale e centrata tipica di Caltech-101, che lo rende un punto di partenza ideale per addestrare modelli robusti di riconoscimento degli oggetti.
Citazioni e ringraziamenti#
Se utilizzi il dataset Caltech-101 nella tua attività di ricerca o sviluppo, cita il seguente articolo:
@article{fei2007learning,
  title={Learning generative visual models from few training examples: An incremental Bayesian approach tested on 101 object categories},
  author={Fei-Fei, Li and Fergus, Rob and Perona, Pietro},
  journal={Computer vision and Image understanding},
  volume={106},
  number={1},
  pages={59--70},
  year={2007},
  publisher={Elsevier}
}
Desideriamo ringraziare Li Fei-Fei, Rob Fergus e Pietro Perona per aver creato e mantenuto il dataset Caltech-101 come risorsa preziosa per la comunità di ricerca nel campo del machine learning e della visione artificiale. Per ulteriori informazioni sul dataset Caltech-101 e sui suoi creatori, visita il sito web del dataset Caltech-101.
FAQ#
Il dataset Caltech-101 è ampiamente utilizzato per addestrare e valutare come benchmark modelli di classificazione delle immagini e riconoscimento degli oggetti. Contiene 9.144 immagini distribuite in 101 categorie di oggetti più una classe di sfondo, offrendo un benchmark impegnativo per valutare algoritmi come le reti neurali convoluzionali (CNNs) e le macchine a vettori di supporto (SVMs).
Per addestrare un modello Ultralytics YOLO su Caltech-101, utilizza i frammenti di codice riportati di seguito. Il dataset viene scaricato automaticamente al primo utilizzo. Per l'elenco completo degli argomenti, consulta la pagina Addestramento del modello.
Esempio di addestramentofrom ultralytics import YOLO # Load a model model = YOLO("yolo26n-cls.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="caltech101", epochs=100, imgsz=416)Caltech-101 contiene 101 categorie di oggetti più una classe
BACKGROUND_Google, per un totale di 102 cartelle di classi e 9.144 immagini. Quando esegui l'addestramento con Ultralytics, il modello apprende tutte le 102 classi. Le dimensioni delle categorie sono sbilanciate e variano da circa 40 a 800 immagini ciascuna.Caltech-101 non dispone di una suddivisione predefinita. La prima volta che esegui l'addestramento, Ultralytics lo suddivide automaticamente in 80% per l'addestramento e 20% per la validazione — circa 7.280 immagini per l'addestramento e 1.864 per la validazione — quindi non devi creare manualmente le suddivisioni. Per controllare autonomamente la suddivisione, organizza le immagini nelle cartelle
train/eval/prima dell'addestramento.Sì. Ultralytics Platform ti consente di gestire i dataset, addestrare modelli di classificazione delle immagini e distribuirli senza dover scrivere molto codice. È un modo pratico per eseguire esperimenti con Caltech-101 nel cloud e puoi esplorare altre opzioni nella nostra panoramica dei dataset di classificazione.