Dataset COCO8-Multispectral
Introduzione#
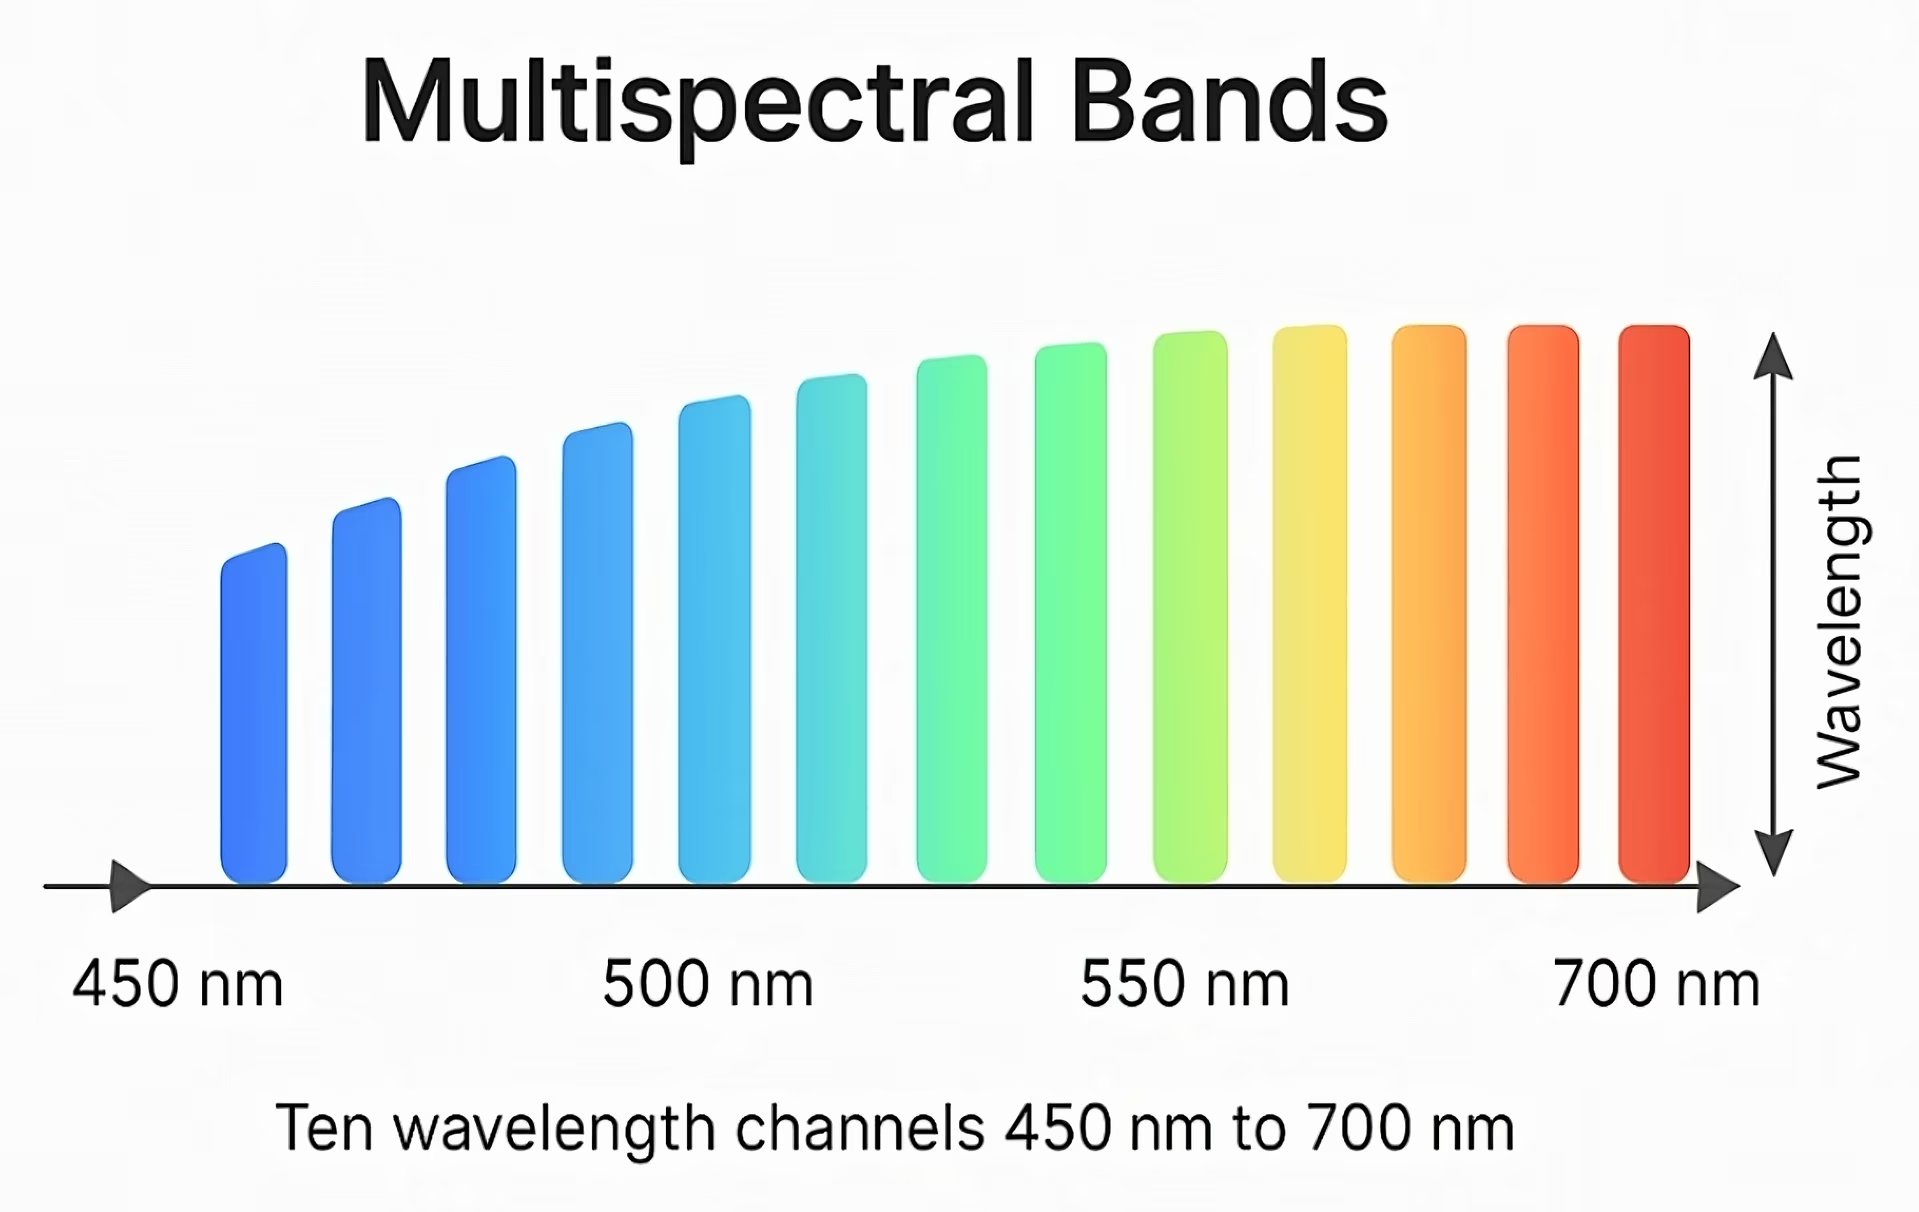
Il dataset COCO8-Multispectral di Ultralytics è una variante del dataset COCO8 originale, pensata per sperimentare con modelli di rilevamento di oggetti multispettrali. È composto dalle stesse 8 immagini del set COCO train 2017 — 4 per l'addestramento e 4 per la convalida — ma con ogni immagine trasformata in un formato multispettrale a 10 canali. Superando i tradizionali canali RGB, COCO8-Multispectral consente di sviluppare e valutare modelli che utilizzano informazioni spettrali più ricche.
COCO8-Multispectral è compatibile con Ultralytics Platform e YOLO26, quindi puoi usarlo direttamente nei tuoi flussi di lavoro di visione artificiale.
Guarda: Come addestrare Ultralytics YOLO su dataset in scala di grigi e multispettrali | VisionAI multicanale 🚀
Struttura del dataset#
COCO8-Multispectral condivide le stesse 8 immagini di COCO8 — 4 per l'addestramento e 4 per la convalida, etichettate con i nomi delle 80 classi COCO — ma ogni immagine è archiviata come immagine multispettrale a 10 canali .tiff in formato di etichettatura YOLO:
coco8-multispectral/
├── images/
│   ├── train/   # 4 images (10-channel .tiff)
│   └── val/     # 4 images (10-channel .tiff)
└── labels/
    ├── train/
    └── val/
Generazione del dataset#
Le immagini multispettrali di COCO8-Multispectral sono state create interpolando le immagini RGB originali su 10 canali spettrali equidistanti all'interno dello spettro visibile. Il processo include:
- Assegnazione delle lunghezze d'onda: assegnazione di lunghezze d'onda nominali ai canali RGB — Rosso: 650 nm, Verde: 510 nm, Blu: 475 nm.
- Interpolazione: utilizzo dell'interpolazione lineare per stimare i valori dei pixel alle lunghezze d'onda intermedie tra 450 nm e 700 nm, ottenendo 10 canali spettrali.
- Estrapolazione: applicazione dell'estrapolazione lineare per stimare i valori oltre le lunghezze d'onda RGB originali, garantendo una rappresentazione spettrale completa.
Questo approccio simula un processo di acquisizione di immagini multispettrali, fornendo dati più diversificati per l'addestramento e la valutazione dei modelli. Per ulteriori approfondimenti sull'imaging multispettrale, consulta l'articolo di Wikipedia sull'imaging multispettrale.
YAML del dataset#
Il dataset COCO8-Multispectral è configurato tramite un file YAML, che definisce i percorsi del dataset, i nomi delle classi e i metadati essenziali. Puoi consultare il file ufficiale coco8-multispectral.yaml nel repository GitHub di Ultralytics.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# COCO8-Multispectral dataset (COCO8 images interpolated across 10 channels in the visual spectrum) by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/coco8-multispectral
# Example usage: yolo train data=coco8-multispectral.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── coco8-multispectral ← downloads here (20.2 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: coco8-multispectral # dataset root dir
train: images/train # train images (relative to 'path') 4 images
val: images/val # val images (relative to 'path') 4 images
test: # test images (optional)

# Number of multispectral image channels
channels: 10

# Classes
names:
  0: person
  1: bicycle
  2: car
  3: motorcycle
  4: airplane
  5: bus
  6: train
  7: truck
  8: boat
  9: traffic light
  10: fire hydrant
  11: stop sign
  12: parking meter
  13: bench
  14: bird
  15: cat
  16: dog
  17: horse
  18: sheep
  19: cow
  20: elephant
  21: bear
  22: zebra
  23: giraffe
  24: backpack
  25: umbrella
  26: handbag
  27: tie
  28: suitcase
  29: frisbee
  30: skis
  31: snowboard
  32: sports ball
  33: kite
  34: baseball bat
  35: baseball glove
  36: skateboard
  37: surfboard
  38: tennis racket
  39: bottle
  40: wine glass
  41: cup
  42: fork
  43: knife
  44: spoon
  45: bowl
  46: banana
  47: apple
  48: sandwich
  49: orange
  50: broccoli
  51: carrot
  52: hot dog
  53: pizza
  54: donut
  55: cake
  56: chair
  57: couch
  58: potted plant
  59: bed
  60: dining table
  61: toilet
  62: tv
  63: laptop
  64: mouse
  65: remote
  66: keyboard
  67: cell phone
  68: microwave
  69: oven
  70: toaster
  71: sink
  72: refrigerator
  73: book
  74: clock
  75: vase
  76: scissors
  77: teddy bear
  78: hair drier
  79: toothbrush

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/coco8-multispectral.zipPrepara le immagini TIFF nell'ordine (channel, height, width) e salvale con l'estensione .tiff o .tif; assicurati inoltre che siano uint8 per utilizzarle con Ultralytics:
import cv2
import numpy as np

# Crea e scrivi TIFF a 10 canali
image = np.ones((10, 640, 640), dtype=np.uint8)  # Ordine CHW
cv2.imwritemulti("example.tiff", image)

# Leggi TIFF
success, frames_list = cv2.imreadmulti("example.tiff")
image = np.stack(frames_list, axis=2)
print(image.shape) # (640, 640, 10) Ordine HWC per training e inferenzaUtilizzo#
Il dataset COCO8-Multispectral (20,2 MB) viene scaricato automaticamente al primo avvio dell'addestramento. Per addestrare un modello YOLO26n su COCO8-Multispectral per 100 epoche con una dimensione delle immagini di 640, usa gli esempi seguenti.
from ultralytics import YOLO

# Carica un modello YOLO26n preaddestrato
model = YOLO("yolo26n.pt")

# Addestra il modello su COCO8-Multispectral
results = model.train(data="coco8-multispectral.yaml", epochs=100, imgsz=640)
Per ulteriori dettagli sulla selezione dei modelli e sulle best practice, consulta la documentazione sui modelli Ultralytics YOLO e la guida ai suggerimenti per il training dei modelli YOLO.
Immagini di esempio e annotazioni#
Di seguito è riportato un esempio di batch di training mosaicato dal dataset COCO8-Multispectral:
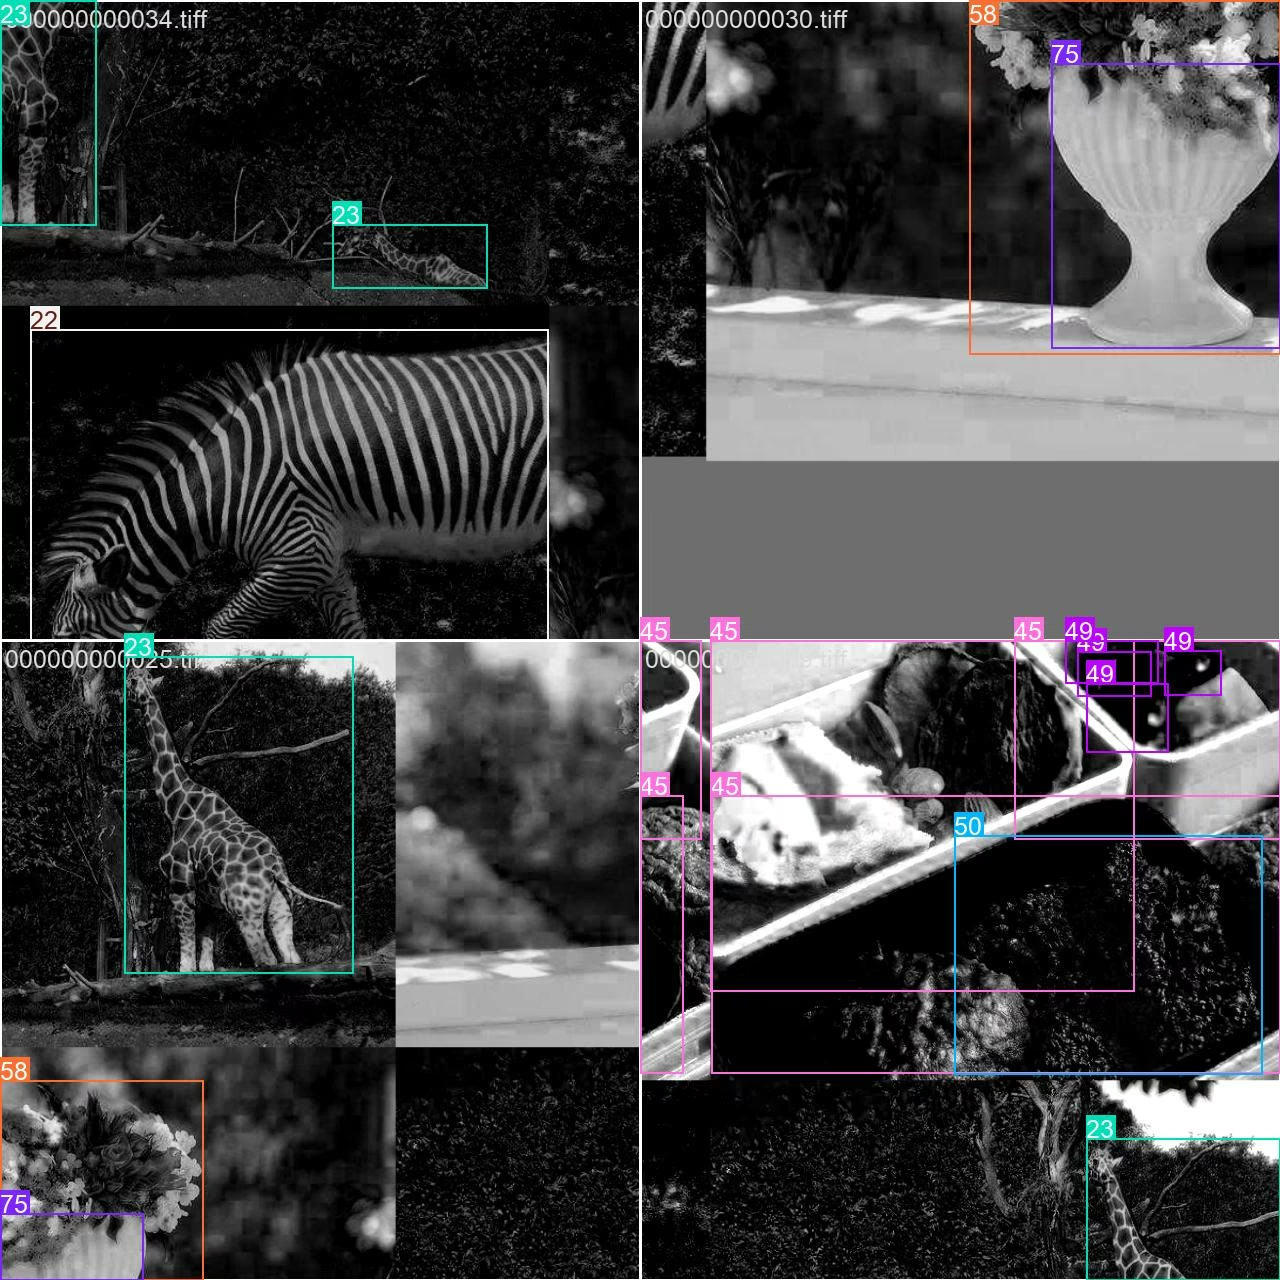
- Immagine mosaicata: questa immagine mostra un batch di training in cui più immagini del dataset vengono combinate usando l'augmentation mosaic. L'augmentation mosaic aumenta la varietà di oggetti e scene in ogni batch, aiutando il modello a generalizzare meglio a dimensioni e proporzioni diverse degli oggetti e a vari sfondi.
Questa tecnica è particolarmente utile per i dataset di piccole dimensioni come COCO8-Multispectral, perché massimizza l'utilità di ogni immagine durante il training.
Citazioni e ringraziamenti#
Se utilizzi il dataset COCO nelle tue attività di ricerca o sviluppo, cita il seguente articolo:
@misc{lin2015microsoft,
      title={Microsoft COCO: Common Objects in Context},
      author={Tsung-Yi Lin and Michael Maire and Serge Belongie and Lubomir Bourdev and Ross Girshick and James Hays and Pietro Perona and Deva Ramanan and C. Lawrence Zitnick and Piotr Dollár},
      year={2015},
      eprint={1405.0312},
      archivePrefix={arXiv},
      primaryClass={cs.CV}
}
Un ringraziamento speciale al Consorzio COCO per il suo costante contributo alla comunità della visione artificiale.
Domande frequenti#
Il dataset COCO8-Multispectral di Ultralytics è progettato per testare e correggere rapidamente i modelli multispettrali di rilevamento degli oggetti. Con sole 8 immagini (4 per l'addestramento e 4 per la convalida), è ideale per verificare le pipeline di addestramento YOLO26 e assicurarti che tutto funzioni come previsto prima di passare a dataset più grandi.
I dati multispettrali forniscono informazioni spettrali aggiuntive rispetto al tradizionale RGB, consentendo ai modelli di distinguere gli oggetti in base a sottili differenze di riflettanza tra le diverse lunghezze d'onda. Questo può migliorare la precisione del rilevamento, soprattutto in scenari difficili come la scarsa illuminazione o il camuffamento.
Sì. COCO8-Multispectral è compatibile con Ultralytics Platform e i modelli Ultralytics YOLO, incluso YOLO26, sia per l'addestramento sia per la convalida.
Per approfondire i metodi di data augmentation, come il mosaic, e il loro impatto sulle prestazioni dei modelli, consulta la guida alla data augmentation di YOLO e il blog Ultralytics sulla data augmentation.
È particolarmente adatto a dimostrazioni didattiche, alla prototipazione di nuove architetture di modelli e alla verifica di pipeline multicanale. Con appena 8 immagini è troppo piccolo per effettuare benchmark significativi, quindi usa un dataset più grande quando ti servono metriche rappresentative.


Commenti1
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
brenoslinhares
Good afternoon.
I reproduced it for detection and it worked normally. However, adapting the COCO8-Multispectral dataset for classification, as well as the .yaml file when loading the model with channels equal to 10 and the dataset root path in data, returns the following error: RuntimeError: Given groups=1, weight of size [16, 10, 3, 3], expected input [4, 3, 640, 640] to have 10 channels, but got 3 channels instead.
Is it possible to use it for classification, including with data augmentation? How would this be possible? Has there been an update for this task?
Thank you in advance.