Dataset SKU-110K
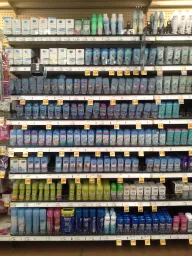
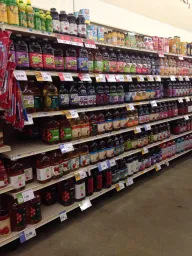
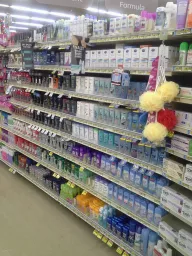
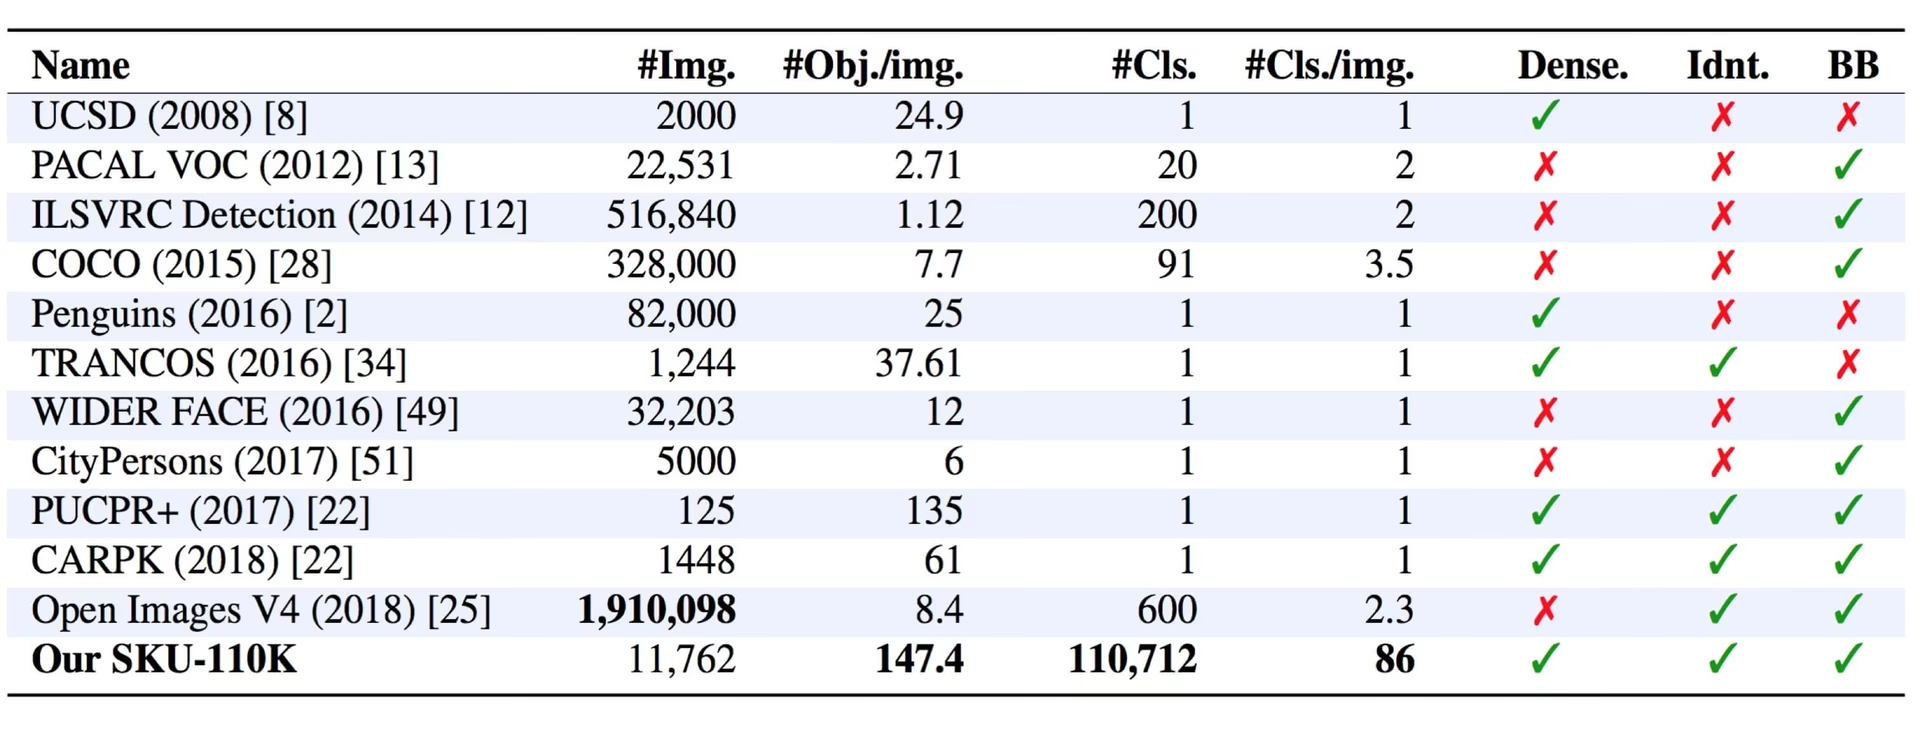
Il dataset SKU-110K è un dataset a classe singola per il rilevamento di oggetti, composto da 11.743 immagini di scaffali di negozi con prodotti disposti in modo fitto, suddivise in 8.219 immagini di training, 588 di convalida e 2.936 di test. Ogni prodotto è annotato con un riquadro delimitatore appartenente a un'unica classe, object: il nome si riferisce agli oltre 110.000 codici articolo univoci (SKUs) raffigurati nelle scene, non a 110.000 classi di rilevamento. Creato da Eran Goldman e altri per l'articolo CVPR 2019 Precise Detection in Densely Packed Scenes, contiene oltre 1,7 milioni di prodotti annotati — in media circa 147 per immagine — e rappresenta quindi un benchmark impegnativo per i modelli di computer vision in ambienti di vendita al dettaglio affollati.
Guarda: Come addestrare Ultralytics YOLO26 per rilevare ogni prodotto su uno scaffale di un negozio | SKU-110K 🛒
Funzionalità principali#
- Rilevamento a classe singola: ogni prodotto è contrassegnato con un riquadro delimitatore appartenente a un'unica classe,
object(names: {0: object}): le annotazioni non includono etichette di categoria per ogni SKU. - Densità estrema degli oggetti: le immagini degli scaffali di negozi di tutto il mondo contengono in media circa 147 prodotti ravvicinati ciascuna; spesso gli oggetti sono simili o persino identici e si trovano molto vicini tra loro.
- Ampia scala: oltre 110.000 SKU univoci e più di 1,7 milioni di riquadri delimitatori annotati distribuiti su 11.743 immagini mettono alla prova i rilevatori di oggetti allo stato dell'arte.
Struttura del dataset#
Il dataset SKU-110K è suddiviso in tre sottoinsiemi, tutti con la stessa classe object:
| Subset | Immagini | Descrizione |
|---|---|---|
| Addestra | 8,219 | Immagini e annotazioni per l'addestramento del modello |
| Validazione | 588 | Immagini messe da parte per la valutazione durante il training |
| Test | 2,936 | Immagini per la valutazione finale del modello addestrato |
Applicazioni#
Il dataset SKU-110K è ampiamente usato per addestrare e valutare modelli di deep learning nelle attività di rilevamento di oggetti, soprattutto in scene affollate come gli espositori sugli scaffali dei negozi. Tra le applicazioni ci sono:
- Gestione dell'inventario e automazione nella vendita al dettaglio
- Riconoscimento dei prodotti nelle piattaforme di e-commerce
- Verifica della conformità ai planogrammi
- Sistemi di pagamento automatico nei negozi
- Prelievo e smistamento robotizzati nei magazzini
Per annotare le tue immagini di scaffali e addestrare e gestire dataset di rilevamento per il commercio al dettaglio direttamente dal browser, esegui l'intero flusso di lavoro con Ultralytics Platform.
YAML del dataset#
Il file SKU-110K.yaml definisce la configurazione del dataset: percorsi, nomi delle classi e altri metadati. È gestito nel repository Ultralytics all'indirizzo https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/SKU-110K.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# SKU-110K retail items dataset https://github.com/eg4000/SKU110K_CVPR19 by Trax Retail
# Documentation: https://docs.ultralytics.com/datasets/detect/sku-110k
# Example usage: yolo train data=SKU-110K.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── SKU-110K ← downloads here (13.6 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: SKU-110K # dataset root dir
train: train.txt # train images (relative to 'path') 8219 images
val: val.txt # val images (relative to 'path') 588 images
test: test.txt # test images (optional) 2936 images

# Classes
names:
  0: object

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import shutil
  from pathlib import Path

  import numpy as np
  import polars as pl

  from ultralytics.utils import TQDM
  from ultralytics.utils.downloads import download
  from ultralytics.utils.ops import xyxy2xywh

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  parent = Path(dir.parent)  # download dir
  urls = ["http://trax-geometry.s3.amazonaws.com/cvpr_challenge/SKU110K_fixed.tar.gz"]
  download(urls, dir=parent)

  # Rename directories
  if dir.exists():
      shutil.rmtree(dir)
  (parent / "SKU110K_fixed").rename(dir)  # rename dir
  (dir / "labels").mkdir(parents=True, exist_ok=True)  # create labels dir

  # Convert labels
  names = "image", "x1", "y1", "x2", "y2", "class", "image_width", "image_height"  # column names
  for d in "annotations_train.csv", "annotations_val.csv", "annotations_test.csv":
      x = pl.read_csv(dir / "annotations" / d, has_header=False, new_columns=names, infer_schema_length=None).to_numpy()  # annotations
      images, unique_images = x[:, 0], np.unique(x[:, 0])
      with open((dir / d).with_suffix(".txt").__str__().replace("annotations_", ""), "w", encoding="utf-8") as f:
          f.writelines(f"./images/{s}\n" for s in unique_images)
      for im in TQDM(unique_images, desc=f"Converting {dir / d}"):
          cls = 0  # single-class dataset
          with open((dir / "labels" / im).with_suffix(".txt"), "a", encoding="utf-8") as f:
              for r in x[images == im]:
                  w, h = r[6], r[7]  # image width, height
                  xywh = xyxy2xywh(np.array([[r[1] / w, r[2] / h, r[3] / w, r[4] / h]]))[0]  # instance
f.write(f"{cls} {xywh[0]:.5f} {xywh[1]:.5f} {xywh[2]:.5f} {xywh[3]:.5f}\n") # write labelUtilizzo#
SKU-110K viene scaricato automaticamente al primo training e richiede circa 13,6 GB di spazio libero su disco per le sue 11.743 immagini. Lo script di download recupera anche le annotazioni originali e le converte nel formato YOLO; l'operazione può richiedere alcuni minuti.
Per addestrare un modello YOLO26n sul dataset SKU-110K per 100 epoche con una dimensione delle immagini di 640, puoi usare i seguenti snippet di codice.
from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n.pt")  # carica un modello preaddestrato (consigliato per l'addestramento)

# Addestra il modello
results = model.train(data="SKU-110K.yaml", epochs=100, imgsz=640)
Dati di esempio e annotazioni#
Le immagini di SKU-110K ritraggono prodotti disposti in modo fitto sugli scaffali di veri negozi, dove decine di articoli quasi identici si trovano uno accanto all'altro. Ecco un'immagine di esempio con le relative annotazioni:
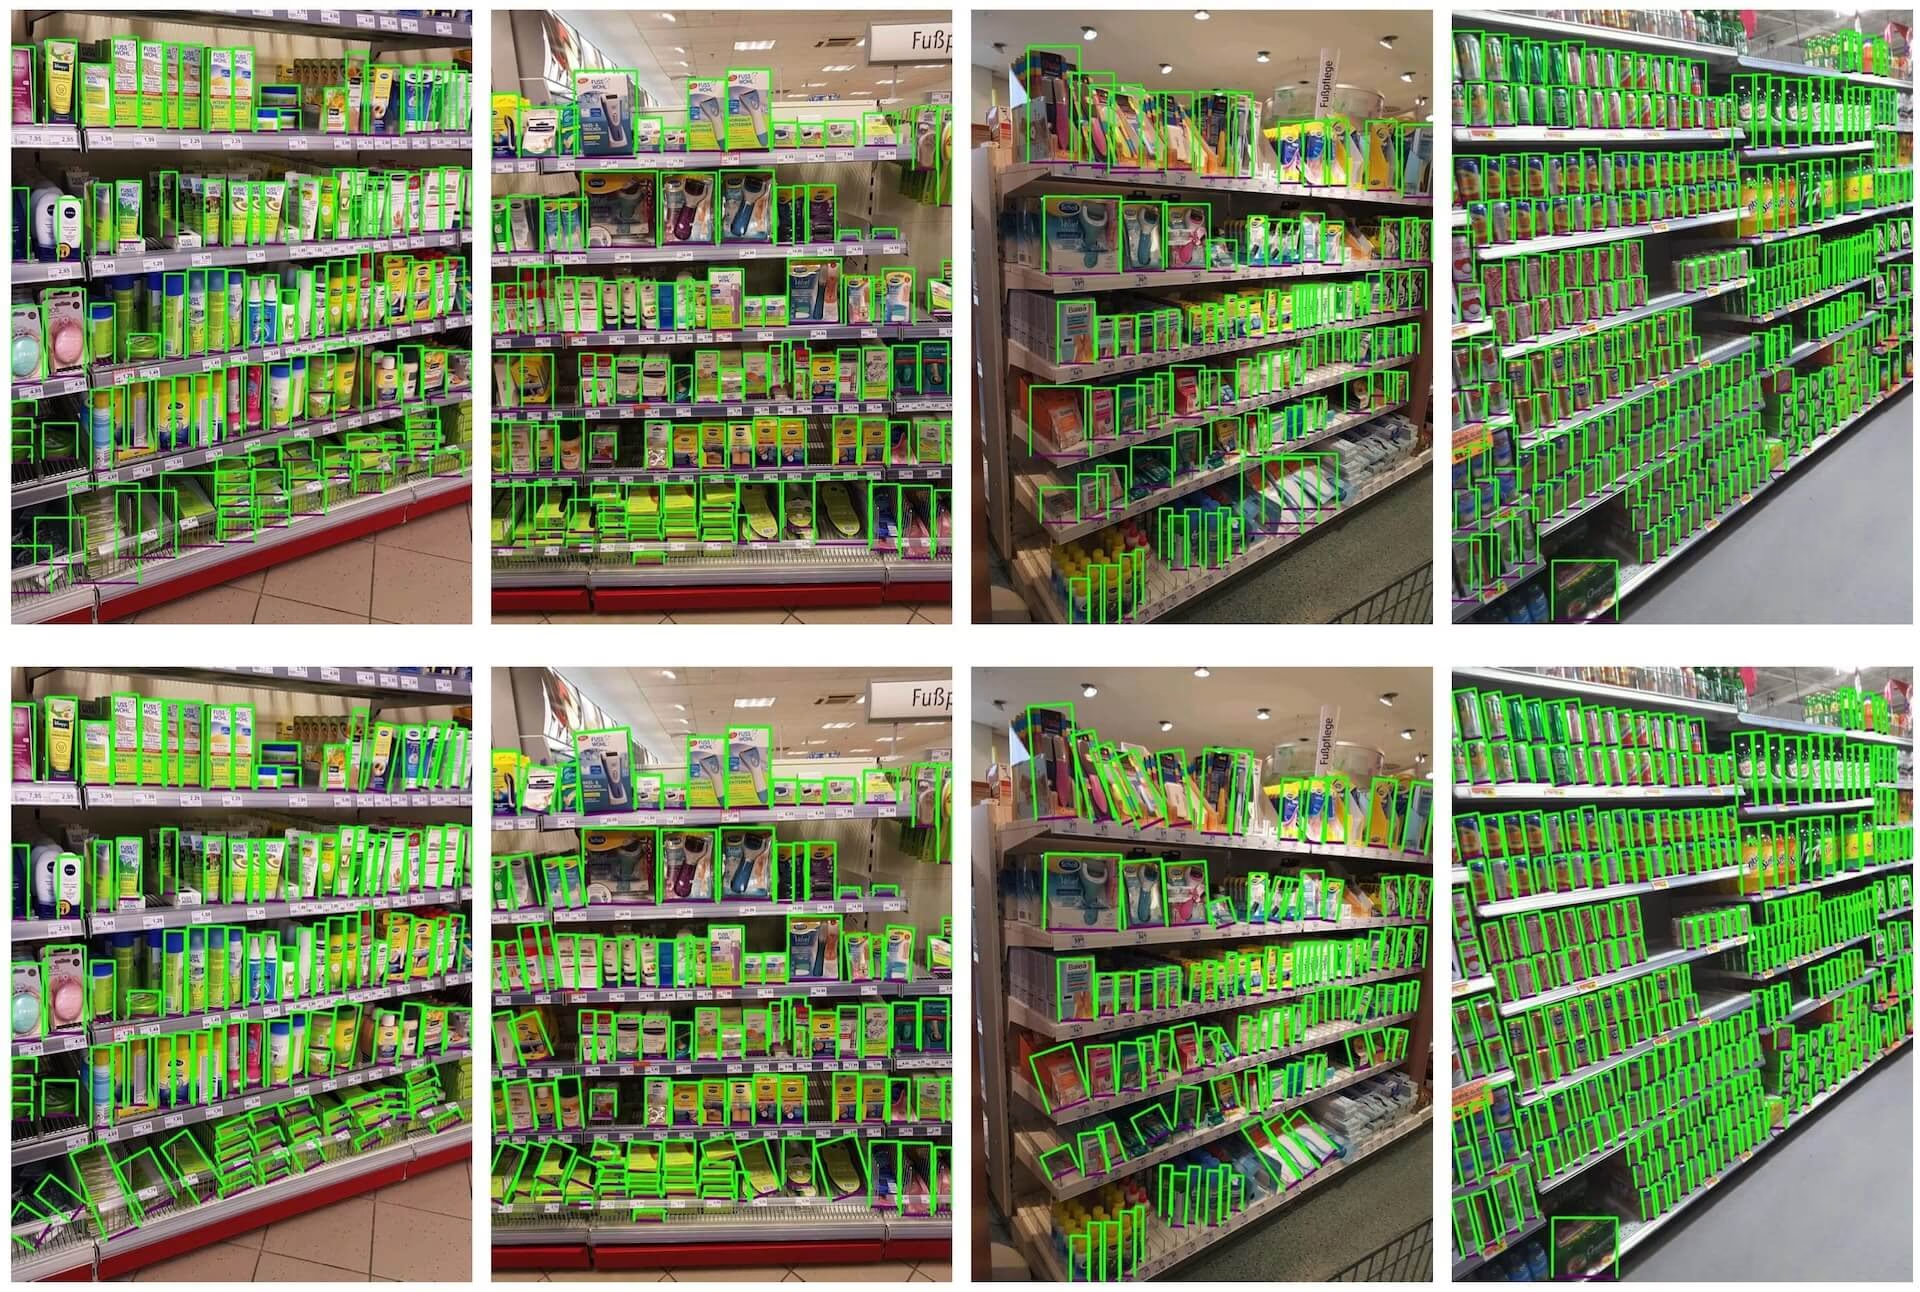
- Immagine di uno scaffale affollato: questa immagine mostra un esempio di oggetti disposti in modo fitto su uno scaffale di un negozio. Gli oggetti sono annotati con riquadri delimitatori appartenenti all'unica classe
object.
La disposizione fitta dei prodotti rende SKU-110K particolarmente utile per sviluppare soluzioni di computer vision robuste per il commercio al dettaglio, poiché l'elevato numero di oggetti per immagine mette i rilevatori alla prova ben oltre i benchmark tipici.
Citazioni e ringraziamenti#
Se usi il dataset SKU-110K per attività di ricerca o sviluppo, cita il seguente articolo:
@inproceedings{goldman2019dense,
  author    = {Eran Goldman and Roei Herzig and Aviv Eisenschtat and Jacob Goldberger and Tal Hassner},
  title     = {Precise Detection in Densely Packed Scenes},
  booktitle = {Proc. Conf. Comput. Vision Pattern Recognition (CVPR)},
  year      = {2019}
}
Desideriamo ringraziare Eran Goldman e gli altri autori per aver creato e mantenuto il dataset SKU-110K, una risorsa preziosa per la comunità di ricerca nel campo della computer vision. Per ulteriori informazioni sul dataset SKU-110K e sui suoi creatori, visita il repository GitHub del dataset SKU-110K.
Domande frequenti#
Il dataset SKU-110K è un dataset di rilevamento di oggetti a classe singola, composto da 11.743 immagini di scaffali di negozi densamente affollati, creato da Eran Goldman e colleghi per il loro articolo di CVPR 2019. Ogni prodotto è etichettato con un riquadro di delimitazione
objecte le immagini comprendono oltre 110.000 unità di gestione delle scorte (SKU) uniche, rendendolo un benchmark efficace per rilevare oggetti in scene affollate e creare sistemi di visione artificiale per la vendita al dettaglio.No. SKU-110K ha una sola classe: ogni prodotto è annotato con un riquadro delimitatore appartenente alla classe
object(names: {0: object}). «110K» nel nome si riferisce al numero di codici articolo univoci (SKUs) raffigurati nelle immagini, non al numero di classi di rilevamento.Il dataset SKU-110K contiene 11.743 immagini — 8.219 per il training, 588 per la convalida e 2.936 per il test — e una sola classe di rilevamento,
object. Per i dettagli, consulta la sezione Struttura del dataset e la configurazioneSKU-110K.yaml.SKU-110K occupa circa 13,6 GB e viene scaricato automaticamente la prima volta che esegui il training con
data="SKU-110K.yaml": non serve scaricarlo manualmente. Per esplorare opzioni più leggere, consulta la panoramica dei dataset di rilevamento.Addestrare un modello YOLO26 sul dataset SKU-110K è semplice. Ecco un esempio per addestrare un modello YOLO26n per 100 epoche con una dimensione delle immagini di 640:
Esempio di addestramentofrom ultralytics import YOLO # Carica un modello model = YOLO("yolo26n.pt") # carica un modello preaddestrato (consigliato per l'addestramento) # Addestra il modello results = model.train(data="SKU-110K.yaml", epochs=100, imgsz=640)


Commenti6
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.
syafiqmuda
Hi, newbie here, I try to use this dataset to compare and see the accuracy for this dataset with my own, but during training almost all the file were show
Corrupt JPEG data: 786 extraneous bytes before marker 0xd9and sometimesCorrupt JPEG data: premature end of data segment. can I know why? my code look like this:training.py
from ultralytics import YOLO, checks, hub checks() def main(): hub.login('something') model = YOLO('https://hub.ultralytics.com/models/ukr3hHHq88WJASNn3aUz') results = model.train(device=[0,1,2,3]) if __name__ == '__main__': main() Glenn JocherUltralytics
Those messages are PIL JPEG warnings from a handful of non-standard images in SKU-110K; Ultralytics usually auto-recovers/filters these during dataloading via
ultralytics.data.utils.verify_image()(see theverify_image()reference), so if training continues it’s safe to ignore—if it actually crashes, re-download/re-extract the dataset (or re-encode the specific bad JPGs), then delete any*.cacheunder yourlabels/folder and rerun; if you share the text output ofyolo checksplus the full traceback (not a screenshot) we can pinpoint whether it’s data corruption or an environment issue.
ApodiAlsurihi
Hi, thank you for this amazing and detailed explanation! Your work is incredibly helpful and inspiring. I would deeply appreciate it if you could share the trained model after the training process. It would make a significant difference in advancing my project and learning. Thank you so much for your generosity and support!
- Glenn JocherUltralytics
@ApodiAlsurihi thank you for your kind words! Unfortunately, we cannot share trained models directly. However, you can train your own model using the SKU-110K dataset by following the instructions provided in the documentation.
serna01
Are this warnings OK, when training? the batch=0.1 I used it to avoid a memory error. yolo detect train data=SKU-110K.yaml model=yolov8n.pt epochs=50 imgsz=640 batch=0.1
AutoBatch: Using batch-size 2 for CUDA:0 0.49G/3.81G (13%) ✅ train: Scanning /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels... 8216 train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_1797.jpg: 3 duplicate labels removed train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_4222.jpg: ignoring corrupt image/label: image file is truncated (23 bytes not processed) train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_882.jpg: ignoring corrupt image/label: image file is truncated (3 bytes not processed) train: WARNING ⚠️ /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/images/train_924.jpg: ignoring corrupt image/label: image file is truncated (10 bytes not processed)
al: Scanning /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels... 588 ima val: New cache created: /home/asm/cv_cornia/parking_mgmt/datasets/SKU-110K/labels.cache Corrupt JPEG data: 305 extraneous bytes before marker 0xd9 Corrupt JPEG data: 786 extraneous bytes before marker 0xd9 Plotting labels to runs/detect/train5/labels.jpg... optimizer: 'optimizer=auto' found, ignoring 'lr0=0.01' and 'momentum=0.937' and determining best 'optimizer', 'lr0' and 'momentum' automatically... optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups 57 weight(decay=0.0), 64 weight(decay=0.0005), 63 bias(decay=0.0) TensorBoard: model graph visualization added ✅ Image sizes 640 train, 640 val Using 8 dataloader workers Logging results to runs/detect/train5 Starting training for 50 epochs...
  Epoch    GPU_mem   box_loss   cls_loss   dfl_loss  Instances       Size
   1/50      1.14G      2.504      3.041       1.53        378        640:   5Corrupt JPEG data: premature end of data segment
   1/50      1.15G      2.382      2.658      1.454        331        640:   7Corrupt JPEG data: 562 extraneous bytes before marker 0xd9
   1/50      1.42G      2.273      2.314      1.382        314        640:  11Corrupt JPEG data: bad Huffman code
   1/50      1.42G      2.266      2.295      1.378        578        64       1/50      1.42G      2.266      2.293      1.377        678        64       1/50      1.42G      2.266      2.293      1.377        678        64       1/50      1.42G      2.265      2.292      1.377        723        64       1/50      1.42G      2.265      2.292      1.377        723        64       1/50      1.42G      2.266       2.29      1.377        695        64       1/50      1.42G      2.266          1/50      1.42G      2.255      2.2       1/50      1.42G      2.254      2.247       1.3       1/50      1       1/50              1/50                          1/50      1.42G      2.232      2.187      1.358        608        640:  13Corrupt JPEG data: bad Huffman code
   1/50      1.42G      2.216      2.138      1.347        437        640:  14Corrupt JPEG data: premature end of data segment
   1/50      1.42G      2.164      1.993      1.318        478        640:  17Corrupt JPEG data: 41 extraneous bytes before marker 0xd9
   1/50      1.42G      2.157      1.967      1.312        308        640:  17Corrupt JPEG data: premature end of data segment
   1/50      1.42G      2.011       1.61      1.239        173        640:  30Corrupt JPEG data: premature end of data segment
   1/50      1.42G      1.987      1.556      1.227        461        640:  33Corrupt JPEG data: 96 extraneous bytes before marker 0xd9
   1/50      1.42G      1.978      1.537      1.223        214        640:  34Corrupt JPEG data: bad Huffman code
   1/50      1.42G      1.959      1.497      1.215        250        640:  37Corrupt JPEG data: bad Huffman code
   1/50      1.42G      1.915      1.403      1.197        500        640:  46Corrupt JPEG data: premature end of data segment
   1/50      1.42G      1.888      1.345      1.185        616        640:  52Corrupt JPEG data: premature end of data segment
Thanks.
- Glenn JocherUltralytics
@serna01 the warnings you see are generally okay and indicate that the training process is handling issues like duplicate labels and corrupt images. Using
batch=0.1to avoid memory errors is fine, but consider adjusting your batch size to better utilize your GPU memory. If the warnings persist or cause issues, ensure you're using the latest version of the package. For more details on the SKU-110k dataset, visit SKU-110k Dataset Documentation.