Dataset TT100K#
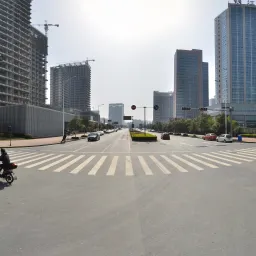
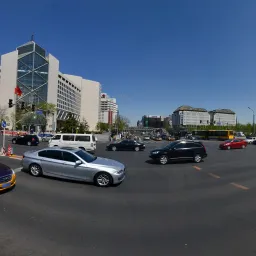
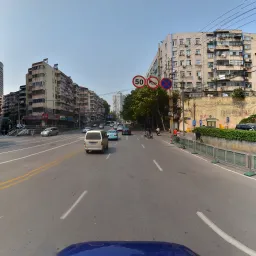
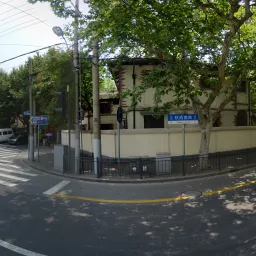
Il dataset Tsinghua-Tencent 100K (TT100K) è un benchmark per il rilevamento di oggetti nei segnali stradali, creato da Zhu e altri per l'articolo CVPR 2016 Traffic-Sign Detection and Classification in the Wild. La configurazione TT100K di Ultralytics fornisce 16.817 immagini (6.105 per il training / 7.641 per la convalida / 3.071 per il test) appartenenti a 221 categorie di segnali stradali; il benchmark originale riporta oltre 30.000 istanze di segnali. «100K» nel nome si riferisce alle circa 100.000 immagini di Tencent Street View da cui è stato creato il benchmark, non al numero di immagini che scarichi e usi per il training. Poiché l'articolo originale mantiene solo le categorie con almeno 100 istanze di training, esiste un sottoinsieme comunemente usato di 45 classi, ma la configurazione di Ultralytics conserva tutte le 221 categorie annotate, molte delle quali poco rappresentate.
Le immagini ad alta risoluzione di street view presentano ampie variazioni di illuminazione, condizioni meteorologiche, angolo di visuale e distanza, rendendo TT100K un benchmark impegnativo per il rilevamento di oggetti piccoli in scene di guida reali.
Funzionalità principali#
- Rilevamento multicategoria: 221 categorie di segnali stradali che comprendono limiti di velocità, divieti, avvisi, limiti di altezza/larghezza e segnali informativi cinesi.
- Alta risoluzione: immagini da 2048×2048 pixel, in cui i segnali variano da primi piani grandi a piccoli indicatori distanti che mettono alla prova il rilevamento fine.
- Condizioni reali: ampie variazioni di condizioni meteorologiche, illuminazione, angolo di visuale e occlusione.
- Annotazioni con riquadri delimitatori: ogni segnale è etichettato con una classe e un riquadro delimitatore in formato YOLO dopo la conversione automatica.
- Suddivisioni predefinite: suddivisioni fisse per training / convalida / test (6.105 / 7.641 / 3.071 immagini) per una valutazione coerente.
Struttura del dataset#
La configurazione TT100K di Ultralytics è suddivisa in tre sottoinsiemi, tutti con le stesse 221 categorie:
| Subset | Immagini | Descrizione |
|---|---|---|
| Addestra | 6,105 | Immagini di scene stradali etichettate usate per addestrare il rilevatore |
| Validazione | 7,641 | La suddivisione originale «other» del dataset, usata per la valutazione |
| Test | 3,071 | Immagini messe da parte per la valutazione finale del modello addestrato |
Le 221 categorie sono organizzate in diversi gruppi principali:
- Segnali di limite di velocità — limiti di velocità massima
pl*(ad es. pl5–pl120) e velocità minimepm*(ad es. pm5–pm55). - Segnali di divieto — divieti generali
p1–p29, divieto di accesso/sostapn/pnee restrizionipr*(pr10–pr100). - Segnali di pericolo —
w1–w67per pericoli stradali quali attraversamenti, curve strette, strade scivolose e lavori in corso. - Segnali di limite di altezza/larghezza — limiti di altezza
ph*(ad es. ph2–ph5.5) e limiti di larghezzapb/pw*. - Segnali informativi — informazioni generali
i1–i15, informazioni sui limiti di velocitàil*(il50–il110), altriioe pannelli informativiip.
Applicazioni#
TT100K è ampiamente usato per sviluppare e valutare sistemi di riconoscimento dei segnali stradali in condizioni reali. Tra le applicazioni più comuni ci sono:
- Sistemi di percezione per la guida autonoma
- Sistemi avanzati di assistenza alla guida (ADAS)
- Monitoraggio del traffico e analisi delle infrastrutture stradali
- Pianificazione urbana e studi sui flussi di traffico
- Ricerca sulla computer vision applicata a oggetti piccoli in immagini ad alta risoluzione
YAML del dataset#
Il file TT100K.yaml definisce la configurazione del dataset: percorsi, nomi delle classi e script per il download e la conversione automatica. È gestito nel repository Ultralytics all'indirizzo https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/TT100K.yaml.
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Tsinghua-Tencent 100K (TT100K) dataset https://cg.cs.tsinghua.edu.cn/traffic-sign/ by Tsinghua University
# Documentation: https://cg.cs.tsinghua.edu.cn/traffic-sign/tutorial.html
# Paper: Traffic-Sign Detection and Classification in the Wild (CVPR 2016)
# License: CC BY-NC 2.0 license for non-commercial use only
# Example usage: yolo train data=TT100K.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── TT100K ← downloads here (~18 GB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: TT100K # dataset root dir
train: images/train # train images (relative to 'path') 6105 images
val: images/val # val images (relative to 'path') 7641 images (original 'other' split)
test: images/test # test images (relative to 'path') 3071 images

# Classes (221 traffic sign categories, 45 with sufficient training instances)
names:
  0: i1
  1: i10
  2: i11
  3: i12
  4: i13
  5: i14
  6: i15
  7: i2
  8: i3
  9: i4
  10: i5
  11: il100
  12: il110
  13: il50
  14: il60
  15: il70
  16: il80
  17: il90
  18: io
  19: ip
  20: p1
  21: p10
  22: p11
  23: p12
  24: p13
  25: p14
  26: p15
  27: p16
  28: p17
  29: p18
  30: p19
  31: p2
  32: p20
  33: p21
  34: p22
  35: p23
  36: p24
  37: p25
  38: p26
  39: p27
  40: p28
  41: p3
  42: p4
  43: p5
  44: p6
  45: p7
  46: p8
  47: p9
  48: pa10
  49: pa12
  50: pa13
  51: pa14
  52: pa8
  53: pb
  54: pc
  55: pg
  56: ph1.5
  57: ph2
  58: ph2.1
  59: ph2.2
  60: ph2.4
  61: ph2.5
  62: ph2.8
  63: ph2.9
  64: ph3
  65: ph3.2
  66: ph3.5
  67: ph3.8
  68: ph4
  69: ph4.2
  70: ph4.3
  71: ph4.5
  72: ph4.8
  73: ph5
  74: ph5.3
  75: ph5.5
  76: pl10
  77: pl100
  78: pl110
  79: pl120
  80: pl15
  81: pl20
  82: pl25
  83: pl30
  84: pl35
  85: pl40
  86: pl5
  87: pl50
  88: pl60
  89: pl65
  90: pl70
  91: pl80
  92: pl90
  93: pm10
  94: pm13
  95: pm15
  96: pm1.5
  97: pm2
  98: pm20
  99: pm25
  100: pm30
  101: pm35
  102: pm40
  103: pm46
  104: pm5
  105: pm50
  106: pm55
  107: pm8
  108: pn
  109: pne
  110: po
  111: pr10
  112: pr100
  113: pr20
  114: pr30
  115: pr40
  116: pr45
  117: pr50
  118: pr60
  119: pr70
  120: pr80
  121: ps
  122: pw2
  123: pw2.5
  124: pw3
  125: pw3.2
  126: pw3.5
  127: pw4
  128: pw4.2
  129: pw4.5
  130: w1
  131: w10
  132: w12
  133: w13
  134: w16
  135: w18
  136: w20
  137: w21
  138: w22
  139: w24
  140: w28
  141: w3
  142: w30
  143: w31
  144: w32
  145: w34
  146: w35
  147: w37
  148: w38
  149: w41
  150: w42
  151: w43
  152: w44
  153: w45
  154: w46
  155: w47
  156: w48
  157: w49
  158: w5
  159: w50
  160: w55
  161: w56
  162: w57
  163: w58
  164: w59
  165: w60
  166: w62
  167: w63
  168: w66
  169: w8
  170: wo
  171: i6
  172: i7
  173: i8
  174: i9
  175: ilx
  176: p29
  177: w29
  178: w33
  179: w36
  180: w39
  181: w4
  182: w40
  183: w51
  184: w52
  185: w53
  186: w54
  187: w6
  188: w61
  189: w64
  190: w65
  191: w67
  192: w7
  193: w9
  194: pax
  195: pd
  196: pe
  197: phx
  198: plx
  199: pmx
  200: pnl
  201: prx
  202: pwx
  203: w11
  204: w14
  205: w15
  206: w17
  207: w19
  208: w2
  209: w23
  210: w25
  211: w26
  212: w27
  213: pl0
  214: pl4
  215: pl3
  216: pm2.5
  217: ph4.4
  218: pn40
  219: ph3.3
  220: ph2.6

# Download script/URL (optional) ---------------------------------------------------------------------------------------
download: |
  import json
  import shutil
  from pathlib import Path

  from PIL import Image

  from ultralytics.utils import TQDM
  from ultralytics.utils.downloads import download

  def tt100k2yolo(dir):
      """Convert TT100K annotations to YOLO format with images/{split} and labels/{split} structure."""
      data_dir = dir / "data"
      anno_file = data_dir / "annotations.json"

      print("Loading annotations...")
      with open(anno_file, encoding="utf-8") as f:
          data = json.load(f)

      # Build class name to index mapping from yaml
      names = yaml["names"]
      class_to_idx = {v: k for k, v in names.items()}

      # Create directories
      for split in ["train", "val", "test"]:
          (dir / "images" / split).mkdir(parents=True, exist_ok=True)
          (dir / "labels" / split).mkdir(parents=True, exist_ok=True)

      print("Converting annotations to YOLO format...")
      skipped = 0
      for img_id, img_data in TQDM(data["imgs"].items(), desc="Processing"):
          img_path_str = img_data["path"]
          if "train" in img_path_str:
              split = "train"
          elif "test" in img_path_str:
              split = "test"
          else:
              split = "val"

          # Source and destination paths
          src_img = data_dir / img_path_str
          if not src_img.exists():
              continue

          dst_img = dir / "images" / split / src_img.name

          # Get image dimensions
          try:
              with Image.open(src_img) as img:
                  img_width, img_height = img.size
          except Exception as e:
              print(f"Error reading {src_img}: {e}")
              continue

          # Copy image to destination
          shutil.copy2(src_img, dst_img)

          # Convert annotations
          label_file = dir / "labels" / split / f"{src_img.stem}.txt"
          lines = []

          for obj in img_data.get("objects", []):
              category = obj["category"]
              if category not in class_to_idx:
                  skipped += 1
                  continue

              bbox = obj["bbox"]
              xmin, ymin = bbox["xmin"], bbox["ymin"]
              xmax, ymax = bbox["xmax"], bbox["ymax"]

              # Convert to YOLO format (normalized center coordinates and dimensions)
              x_center = ((xmin + xmax) / 2.0) / img_width
              y_center = ((ymin + ymax) / 2.0) / img_height
              width = (xmax - xmin) / img_width
              height = (ymax - ymin) / img_height

              # Clip to valid range
              x_center = max(0, min(1, x_center))
              y_center = max(0, min(1, y_center))
              width = max(0, min(1, width))
              height = max(0, min(1, height))

              cls_idx = class_to_idx[category]
              lines.append(f"{cls_idx} {x_center:.6f} {y_center:.6f} {width:.6f} {height:.6f}\n")

          # Write label file
          if lines:
              label_file.write_text("".join(lines), encoding="utf-8")

      if skipped:
          print(f"Skipped {skipped} annotations with unknown categories")
      print("Conversion complete!")

  # Download
  dir = Path(yaml["path"])  # dataset root dir
  urls = ["https://cg.cs.tsinghua.edu.cn/traffic-sign/data_model_code/data.zip"]
  download(urls, dir=dir, curl=True, threads=1)

  # Convert
tt100k2yolo(dir)Utilizzo#
TT100K viene scaricato automaticamente al primo training e richiede circa 18 GB di spazio libero su disco. Al primo utilizzo, lo script di download recupera i dati originali e converte le annotazioni nel formato YOLO; l'operazione può richiedere diversi minuti.
Per addestrare un modello YOLO26n sul dataset TT100K per 100 epoche con una dimensione delle immagini di 640, puoi usare i seguenti frammenti di codice. Per un elenco completo degli argomenti disponibili, consulta la pagina Training del modello.
from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n.pt")  # carica un modello preaddestrato (consigliato per l'addestramento)

# Addestra il modello: il dataset verrà scaricato automaticamente alla prima esecuzione
results = model.train(data="TT100K.yaml", epochs=100, imgsz=640)
Per etichettare altre immagini di segnali stradali e gestire le esecuzioni di training TT100K nel browser, usa Ultralytics Platform.
Dati di esempio e annotazioni#
Le immagini TT100K sono scene stradali da 2048×2048 pixel, in cui i segnali stradali occupano spesso solo una piccola parte dell'inquadratura. Una singola immagine può contenere più segnali di dimensioni e a distanze diverse, alcuni parzialmente occlusi da veicoli, vegetazione o strutture, e acquisiti di giorno o di notte, con cielo sereno o piovoso. Questa combinazione di oggetti piccoli e condizioni difficili rende il dataset un ottimo banco di prova per la robustezza dei rilevatori.
Citazioni e ringraziamenti#
Se usi il dataset TT100K nelle tue attività di ricerca o sviluppo, cita il seguente articolo:
@InProceedings{Zhu_2016_CVPR,
    author = {Zhu, Zhe and Liang, Dun and Zhang, Songhai and Huang, Xiaolei and Li, Baoli and Hu, Shimin},
    title = {Traffic-Sign Detection and Classification in the Wild},
    booktitle = {The IEEE Conference on Computer Vision and Pattern Recognition (CVPR)},
    month = {June},
    year = {2016}
}
Desideriamo ringraziare la collaborazione tra Tsinghua University e Tencent per aver creato e mantenuto questa preziosa risorsa per le comunità della computer vision e della guida autonoma. Per ulteriori informazioni sul dataset TT100K, visita il sito ufficiale del dataset.
Domande frequenti#
Il dataset Tsinghua-Tencent 100K (TT100K) viene usato per rilevare e classificare i segnali stradali in condizioni reali. Le sue 221 categorie e le immagini stradali ad alta risoluzione lo rendono un benchmark diffuso per la percezione nella guida autonoma, i sistemi avanzati di assistenza alla guida (ADAS) e la ricerca sul rilevamento di oggetti piccoli.
La configurazione TT100K di Ultralytics contiene 16.817 immagini: 6.105 per l'addestramento, 7.641 per la convalida (lo split originale "other" del dataset) e 3.071 per il test. Consulta la sezione Struttura del dataset per la ripartizione completa.
"100K" si riferisce alle circa 100.000 immagini Tencent Street View da cui è stato creato il benchmark originale. La configurazione di rilevamento di Ultralytics fornisce 16.817 di queste immagini con etichette in formato YOLO; il nome riflette la raccolta di origine, non le dimensioni del set di addestramento.
TT100K definisce 221 categorie che comprendono segnali di limite di velocità, divieto, pericolo, limite di altezza/larghezza e informazione. L'articolo originale mantiene solo le 45 categorie con almeno 100 istanze di addestramento, mentre la configurazione di Ultralytics conserva tutte e 221 le categorie. Consulta Struttura del dataset per la ripartizione per gruppi.
TT100K occupa circa 18 GB e viene scaricato automaticamente la prima volta che esegui l'addestramento con
data="TT100K.yaml": non è necessario scaricarlo manualmente. Alla prima esecuzione, lo script converte anche le annotazioni originali nel formato YOLO.Addestra un modello YOLO26n su TT100K per 100 epoche con una dimensione immagine di 640:
Esempio di addestramentofrom ultralytics import YOLO # Carica un modello model = YOLO("yolo26n.pt") # carica un modello preaddestrato (consigliato per l'addestramento) # Addestra il modello results = model.train(data="TT100K.yaml", epochs=100, imgsz=640)Per le configurazioni dettagliate, consulta la pagina Addestramento e i suggerimenti per l'addestramento dei modelli.
Inizia con
imgsz=640per gli esperimenti iniziali, poi aumenta aimgsz=1280(con unbatchpiù piccolo) se hai memoria GPU sufficiente, poiché una risoluzione più elevata aiuta a recuperare i segnali piccoli e distanti:model.train(data="TT100K.yaml", imgsz=1280, batch=4) # risoluzione più elevata per i segnali piccoliPuoi anche regolare l'aumento dei dati e valutare strategie di suddivisione in riquadri per gli oggetti molto piccoli. Per saperne di più, consulta i Suggerimenti per l'addestramento dei modelli.