Aumento dei dati con Ultralytics YOLO#
Introduzione#
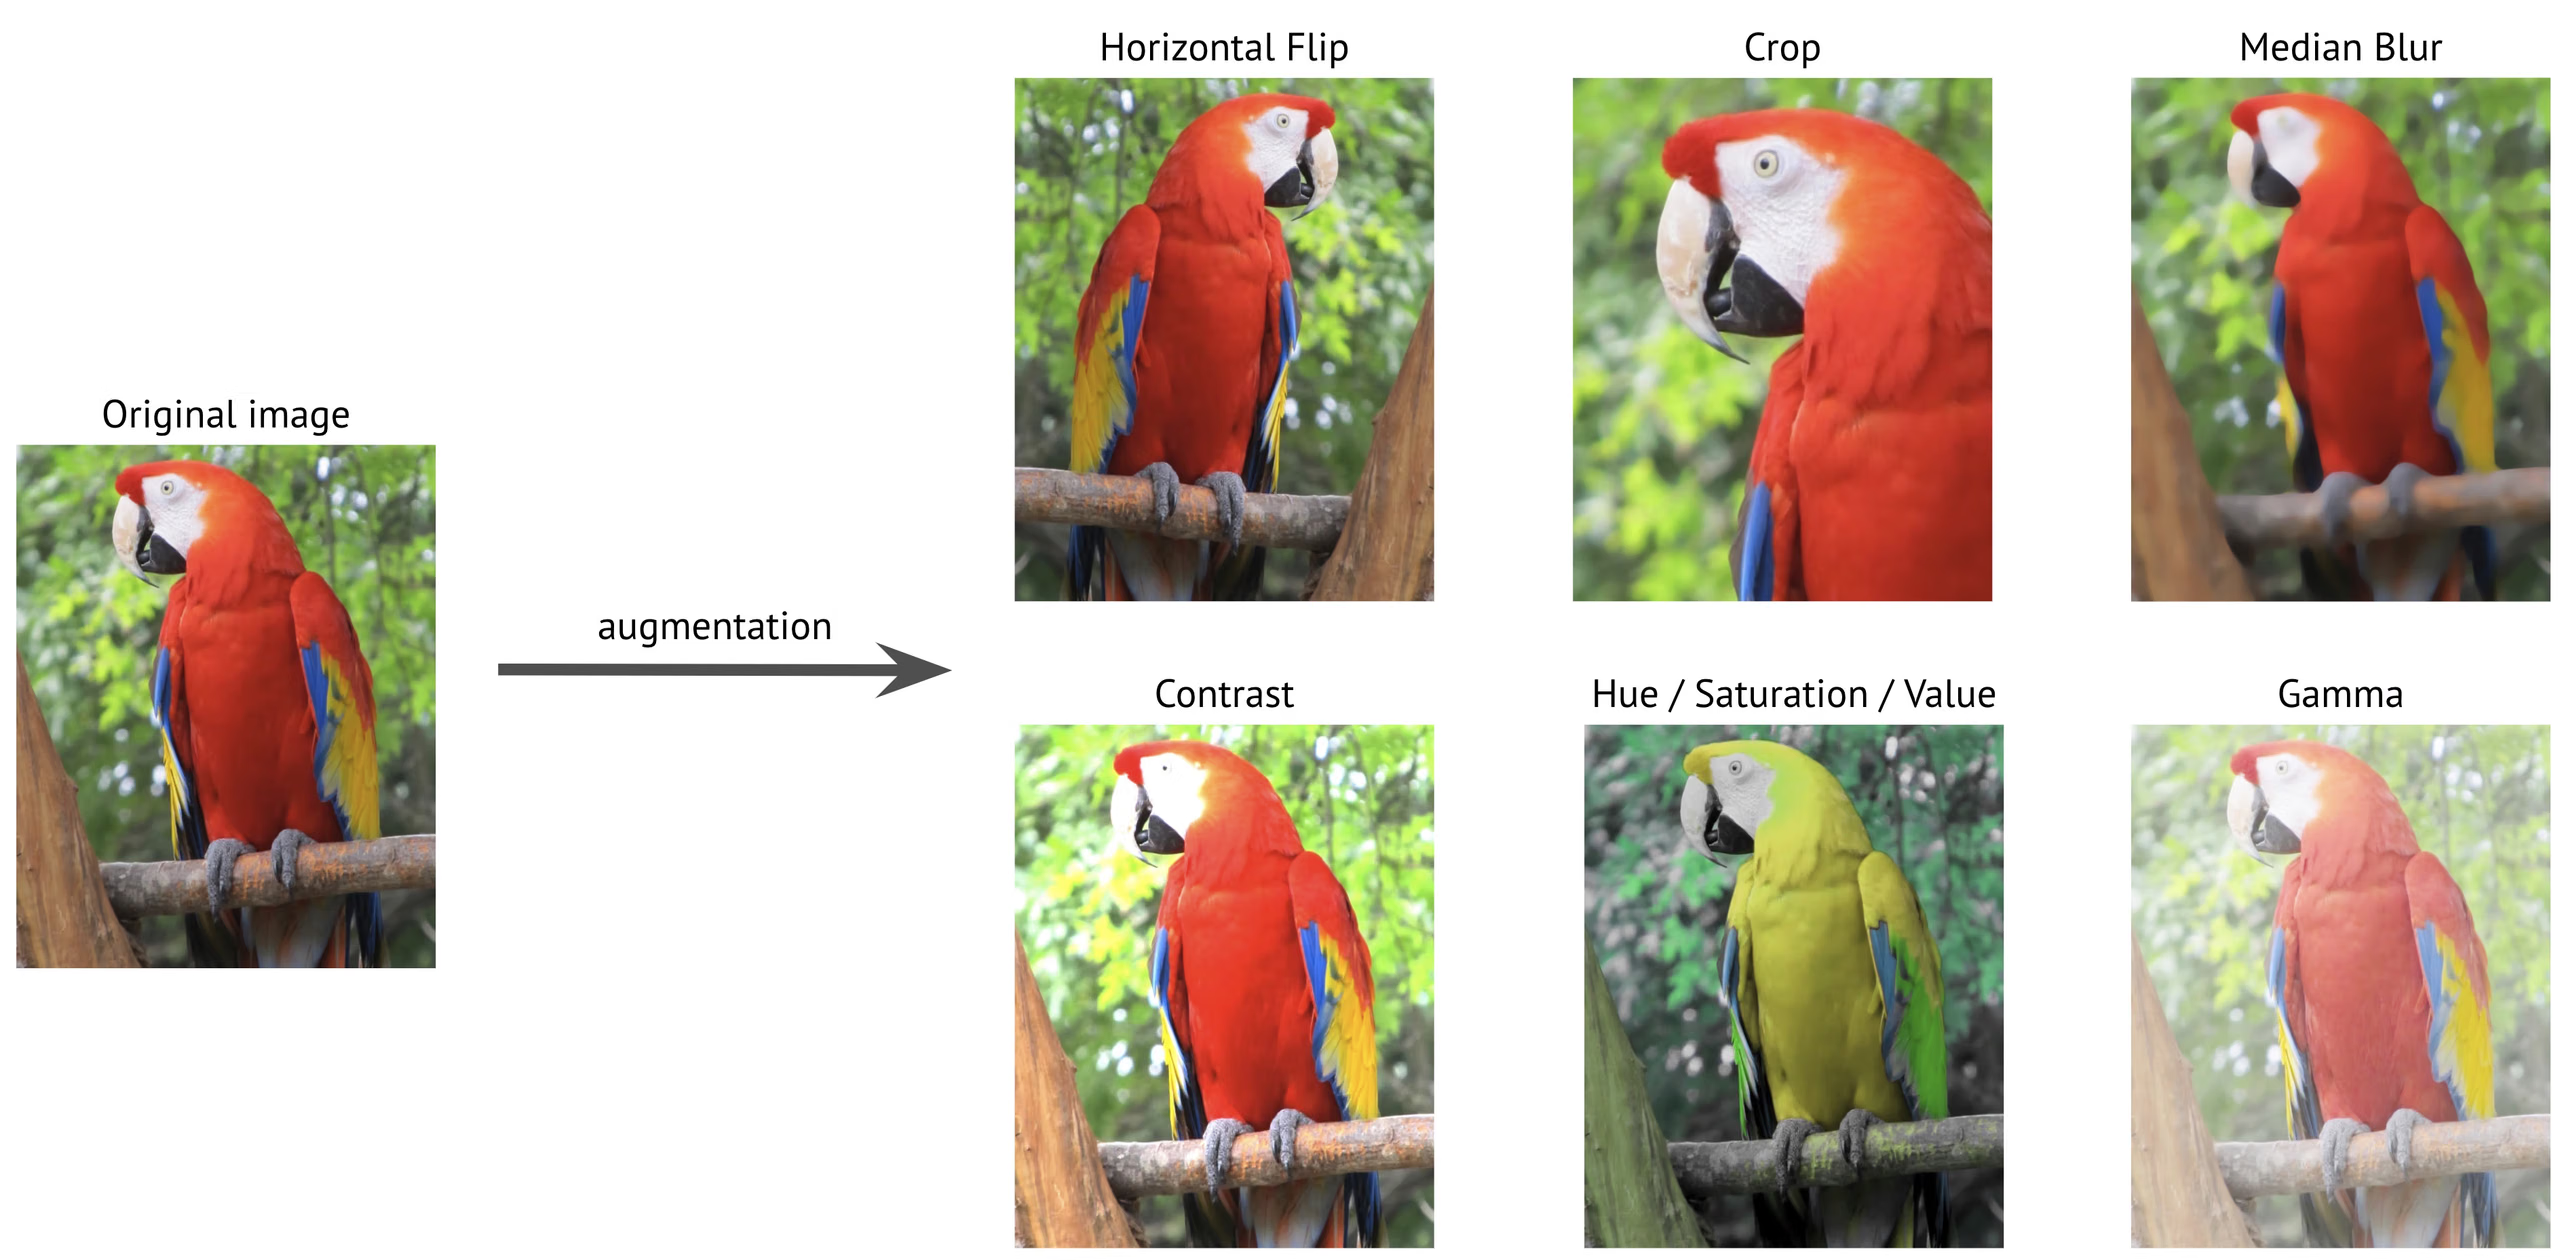
L'aumento dei dati è una tecnica fondamentale nella computer vision che amplia artificialmente il dataset di training applicando diverse trasformazioni alle immagini esistenti. Durante l'addestramento di modelli di deep learning come Ultralytics YOLO, l'aumento dei dati contribuisce a migliorare la robustezza del modello, riduce l'overfitting e migliora la generalizzazione agli scenari reali.
Guarda: Come usare Mosaic, MixUp e altre tecniche di data augmentation per migliorare la capacità di generalizzazione dei modelli Ultralytics YOLO 🚀
Perché l'aumento dei dati è importante#
L'aumento dei dati svolge diverse funzioni fondamentali nell'addestramento di modelli di computer vision:
- Dataset ampliato: creando varianti delle immagini esistenti, puoi aumentare efficacemente le dimensioni del dataset di training senza raccogliere nuovi dati.
- Migliore generalizzazione: i modelli imparano a riconoscere gli oggetti in condizioni diverse e diventano più robusti nelle applicazioni reali.
- Riduzione dell'overfitting: introducendo variabilità nei dati di training, è meno probabile che i modelli memorizzino caratteristiche specifiche delle immagini.
- Prestazioni migliori: i modelli addestrati con un aumento dei dati adeguato ottengono generalmente una precisione maggiore sui set di validation e test.
L'implementazione di Ultralytics YOLO offre una suite completa di tecniche di aumento dei dati, ciascuna con uno scopo specifico e un contributo diverso alle prestazioni del modello. Questa guida illustra le impostazioni di aumento dei dati riportate di seguito e ti aiuta a capire quando e come usarle efficacemente nei tuoi progetti.
Esempi di configurazione#
Puoi personalizzare ogni parametro usando l'API Python, l'interfaccia a riga di comando (CLI) o un file di configurazione. Di seguito trovi alcuni esempi di configurazione dell'aumento dei dati per ciascun metodo.
import albumentations as A

from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n.pt")

# Addestramento con parametri di aumento dei dati personalizzati
model.train(data="coco8.yaml", epochs=100, hsv_h=0.03, hsv_s=0.6, hsv_v=0.5)

# Addestramento con tutte le opzioni di aumento dei dati configurabili disattivate (per maggiore chiarezza, i valori disattivati sono omessi)
model.train(
    data="coco8.yaml",
    epochs=100,
    hsv_h=0.0,
    hsv_s=0.0,
    hsv_v=0.0,
    translate=0.0,
    scale=0.0,
    fliplr=0.0,
    mosaic=0.0,
    erasing=0.0,
    auto_augment=None,
)

# Addestramento con trasformazioni Albumentations personalizzate (solo API Python)
custom_transforms = [
    A.Blur(blur_limit=7, p=0.5),
    A.CLAHE(clip_limit=4.0, p=0.5),
]
model.train(data="coco8.yaml", epochs=100, augmentations=custom_transforms)Le trasformazioni elencate in questa pagina sono quelle che puoi controllare tramite gli argomenti di training. Ultralytics applica anche un piccolo insieme di trasformazioni Albumentations: blur, median blur, grayscale e CLAHE, ciascuna con probabilità p=0.01, ogni volta che il pacchetto albumentations è installato; nessun argomento in default.yaml lo disattiva. Disinstalla il pacchetto per rimuoverlo oppure passa un elenco personalizzato a augmentations per sostituirlo.
Uso di un file di configurazione#
Puoi definire tutti i parametri di training, compresi quelli per l'aumento dei dati, in un file di configurazione YAML (ad es. train_custom.yaml). Il parametro mode è necessario solo quando usi la CLI. Questo nuovo file YAML sostituirà quindi quello predefinito incluso nel pacchetto ultralytics.
# train_custom.yaml
# 'mode' is required only for CLI usage
mode: train
data: coco8.yaml
model: yolo26n.pt
epochs: 100
hsv_h: 0.03
hsv_s: 0.6
hsv_v: 0.5
Avvia quindi l'addestramento con l'API Python:
from ultralytics import YOLO

# Carica un modello YOLO26n preaddestrato su COCO
model = YOLO("yolo26n.pt")

# Addestra il modello con una configurazione personalizzata
model.train(cfg="train_custom.yaml")
Trasformazioni dello spazio colore#
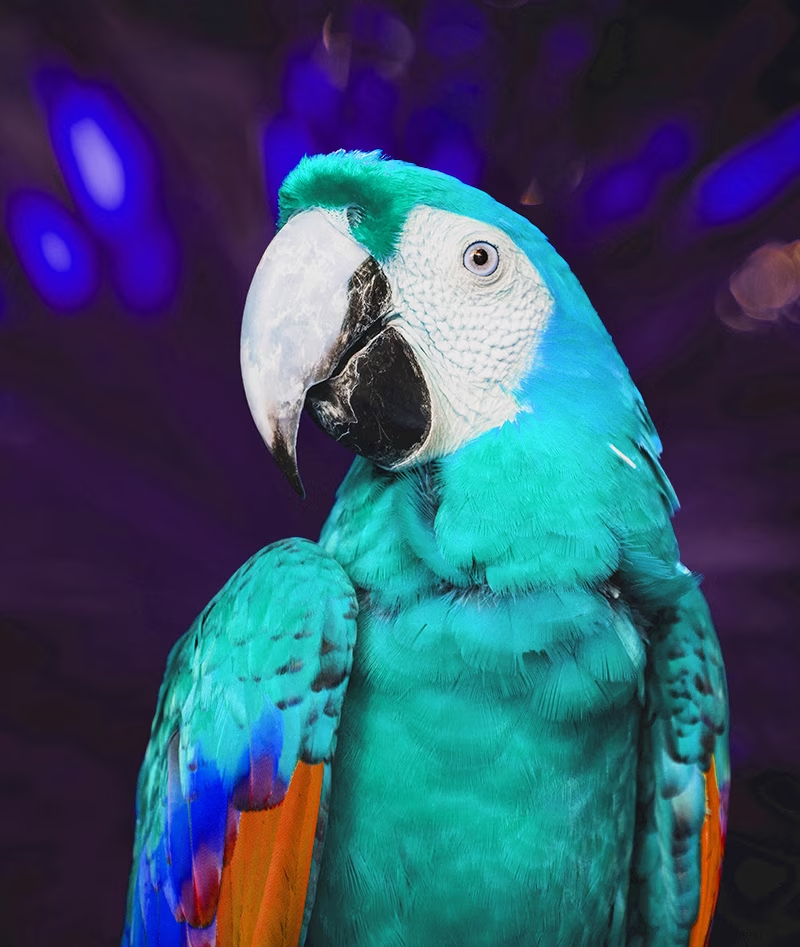
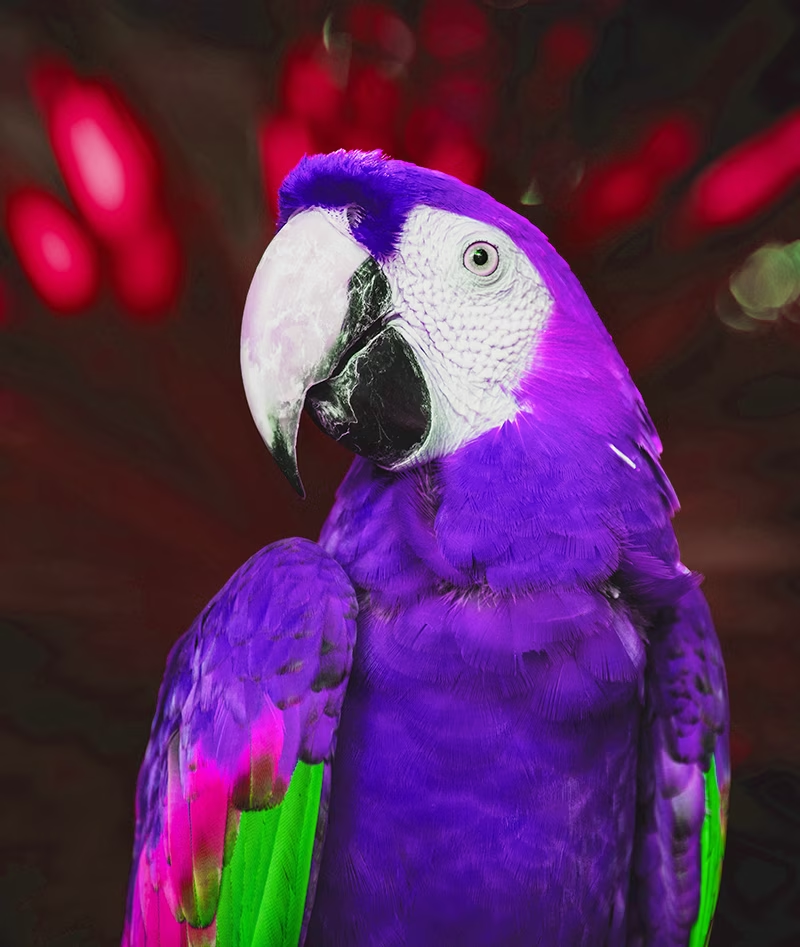
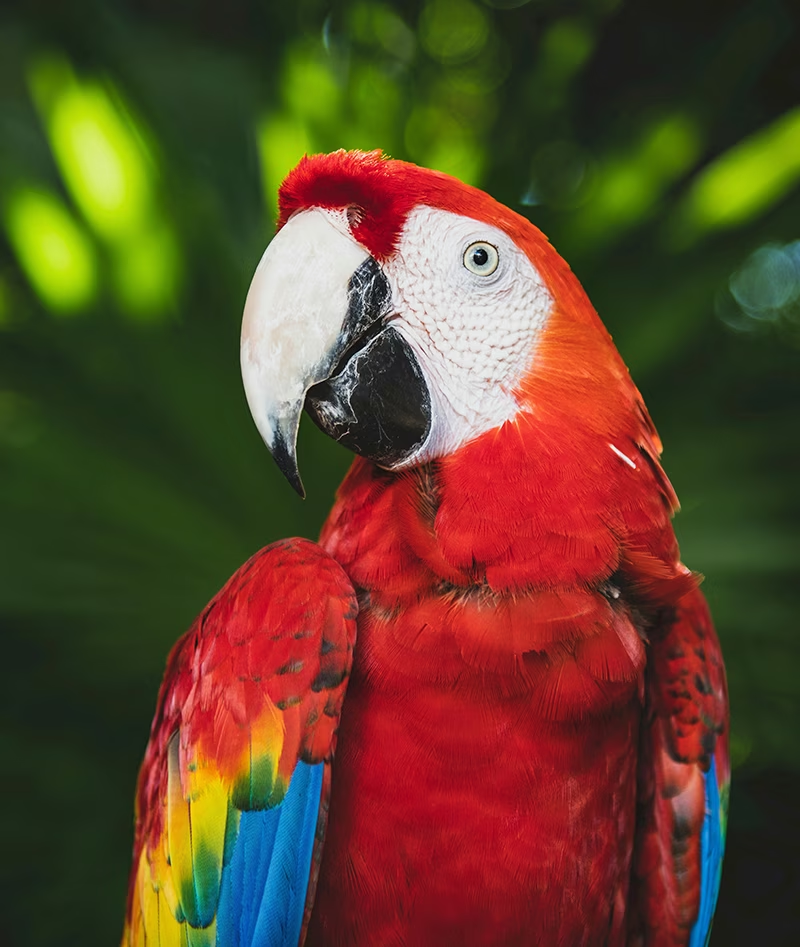
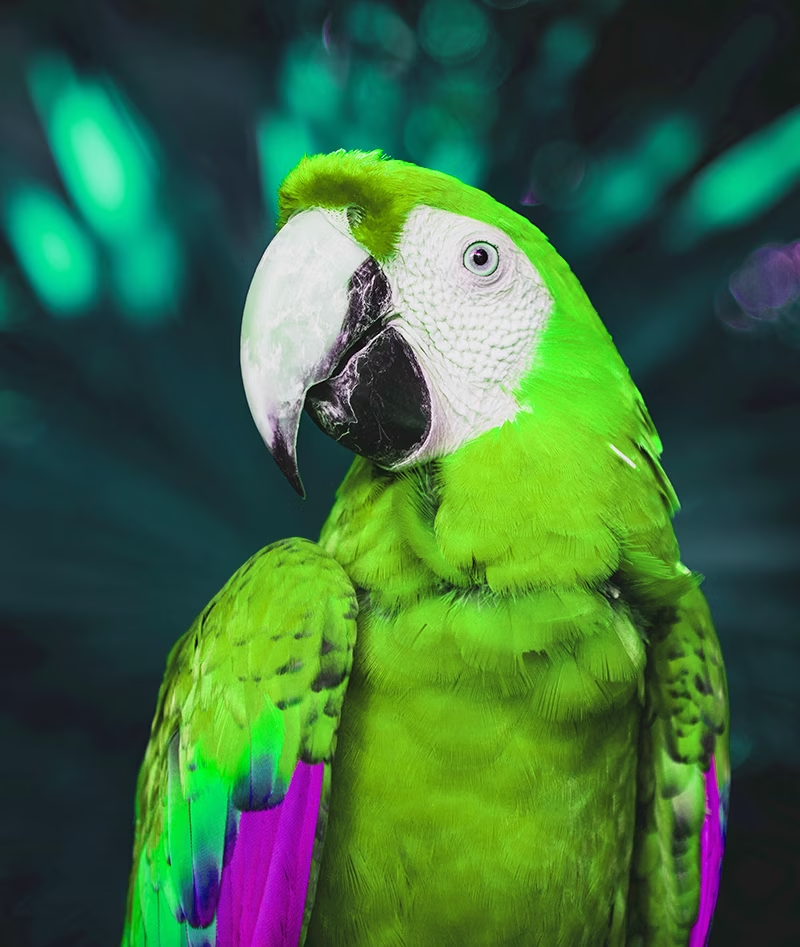
Regolazione della tonalità (hsv_h)#
- Intervallo:
0.0-1.0 - Predefinito:
0.015 - Uso: modifica i colori dell'immagine mantenendo le relazioni tra di essi. L'iperparametro
hsv_hdefinisce l'entità dello spostamento; la regolazione finale viene scelta casualmente tra-hsv_hehsv_h. Ad esempio, conhsv_h=0.3, lo spostamento viene selezionato casualmente nell'intervallo da-0.3a0.3. Per valori superiori a0.5, lo spostamento della tonalità si ripete sul cerchio cromatico; per questo le trasformazioni appaiono uguali tra0.5e-0.5. - Scopo: particolarmente utile negli scenari all'aperto, dove le condizioni di illuminazione possono influire notevolmente sull'aspetto degli oggetti. Ad esempio, una banana può apparire più gialla sotto la luce intensa del sole e più verdastra in ambienti interni.
- Implementazione di Ultralytics: RandomHSV
-0.5 | -0.25 | 0.0 | 0.25 | 0.5 |
|---|---|---|---|---|
 |  |  |  | |
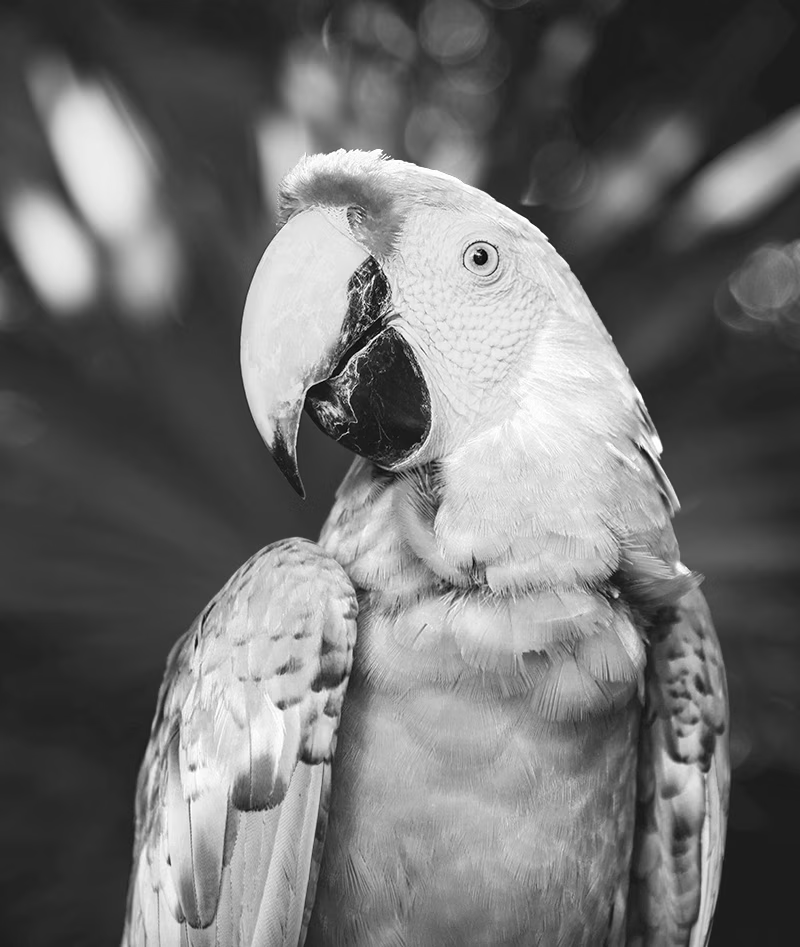
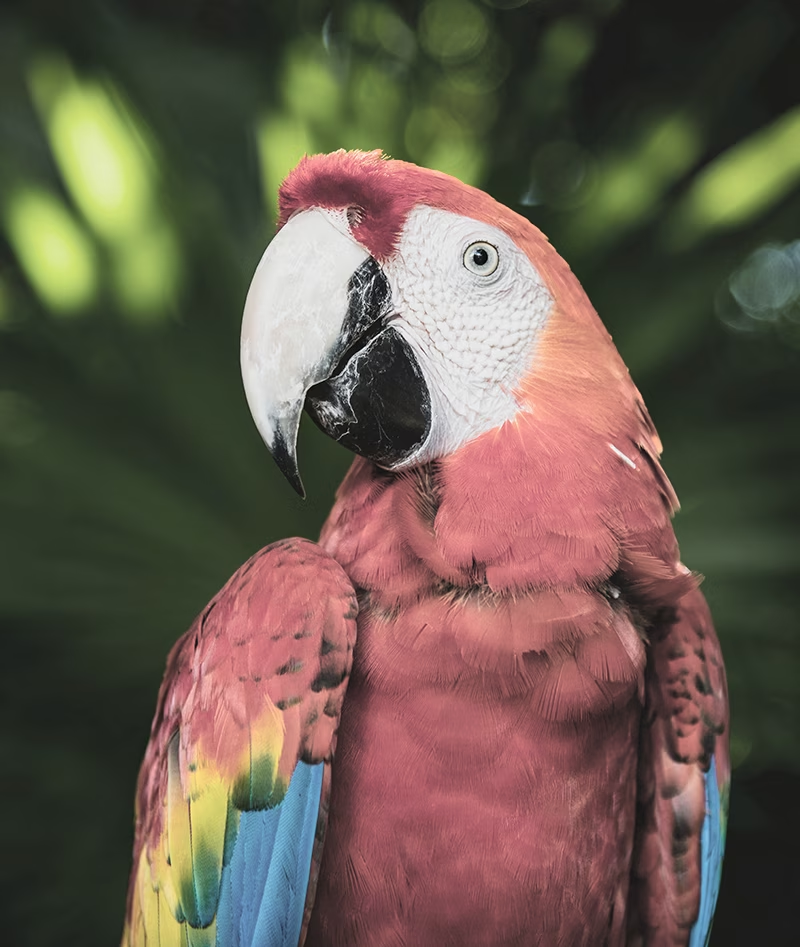
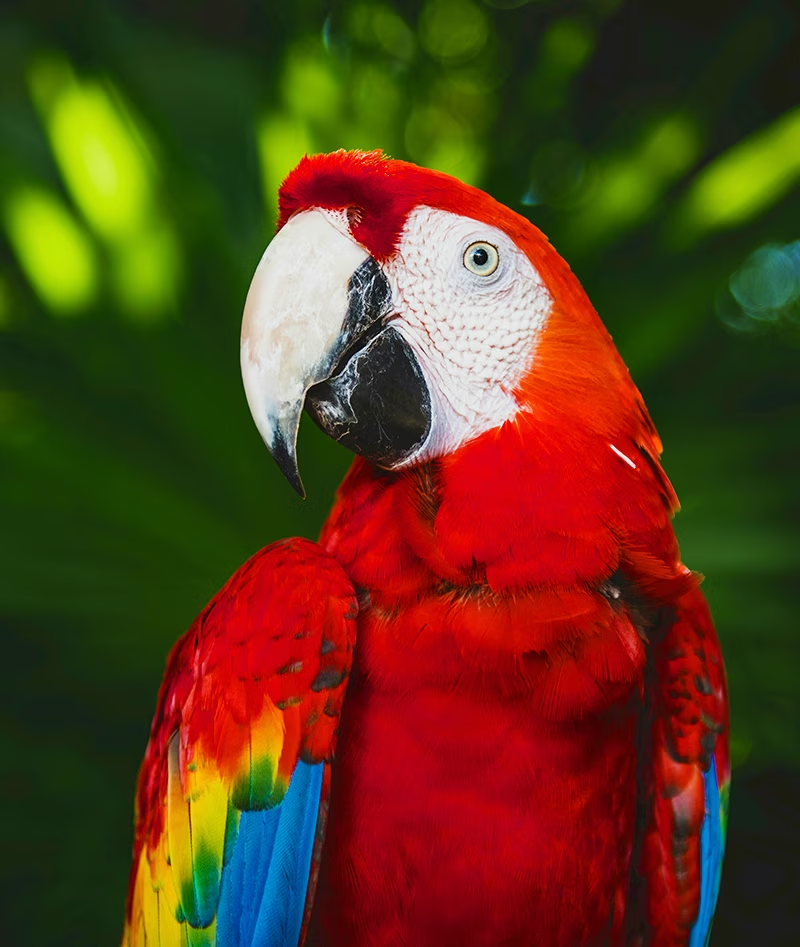
Regolazione della saturazione (hsv_s)#
- Intervallo:
0.0-1.0 - Predefinito:
0.7 - Uso: modifica l'intensità dei colori nell'immagine. L'iperparametro
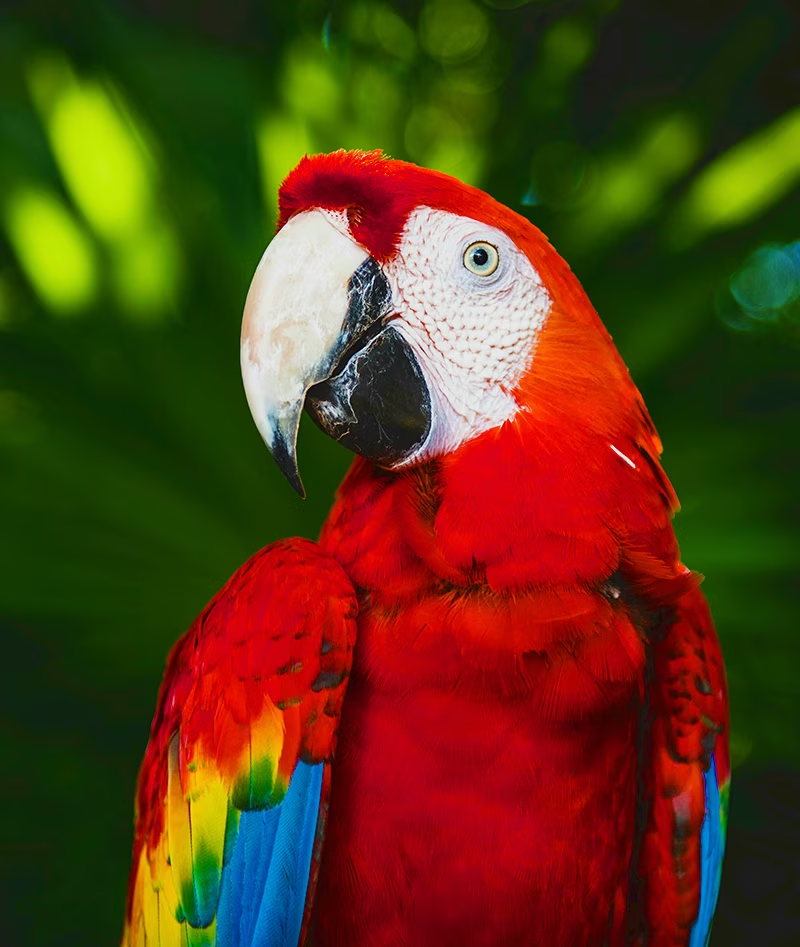
hsv_sdefinisce l'entità dello spostamento; la regolazione finale viene scelta casualmente tra-hsv_sehsv_s. Ad esempio, conhsv_s=0.7, l'intensità viene selezionata casualmente nell'intervallo da-0.7a0.7. - Scopo: aiuta i modelli a gestire condizioni meteorologiche e impostazioni della fotocamera variabili. Ad esempio, un cartello stradale rosso può apparire molto acceso in una giornata di sole, ma spento e sbiadito in condizioni di nebbia.
- Implementazione di Ultralytics: RandomHSV
-1.0 | -0.5 | 0.0 | 0.5 | 1.0 |
|---|---|---|---|---|
 |  | |  |  |
Regolazione della luminosità (hsv_v)#
- Intervallo:
0.0-1.0 - Predefinito:
0.4 - Uso: modifica la luminosità dell'immagine. L'iperparametro
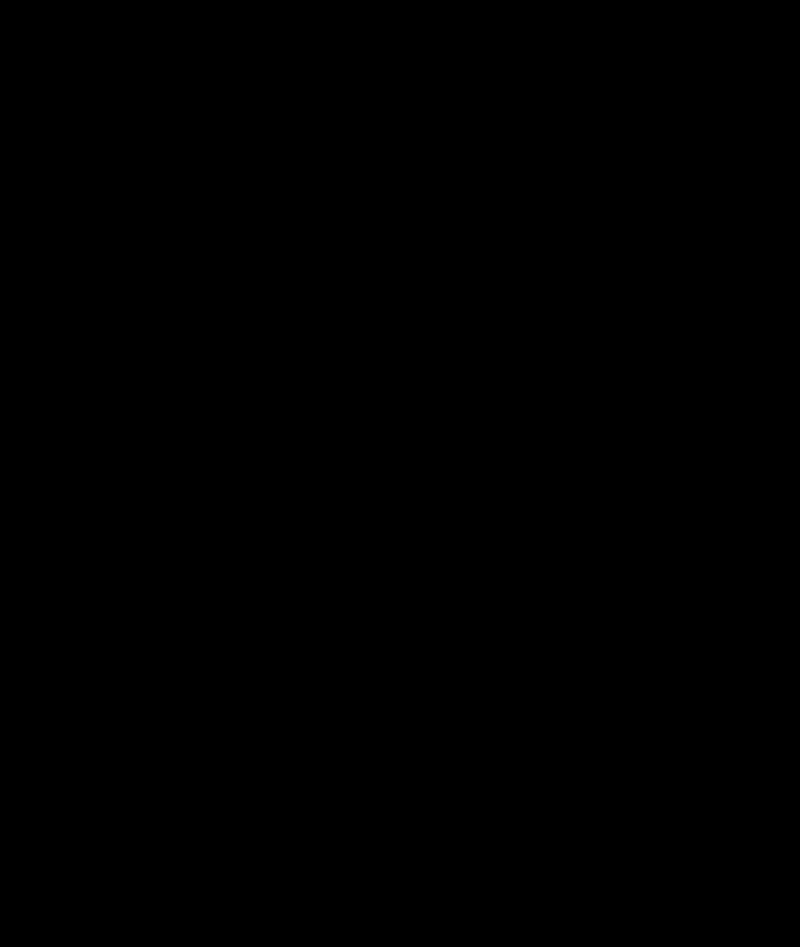
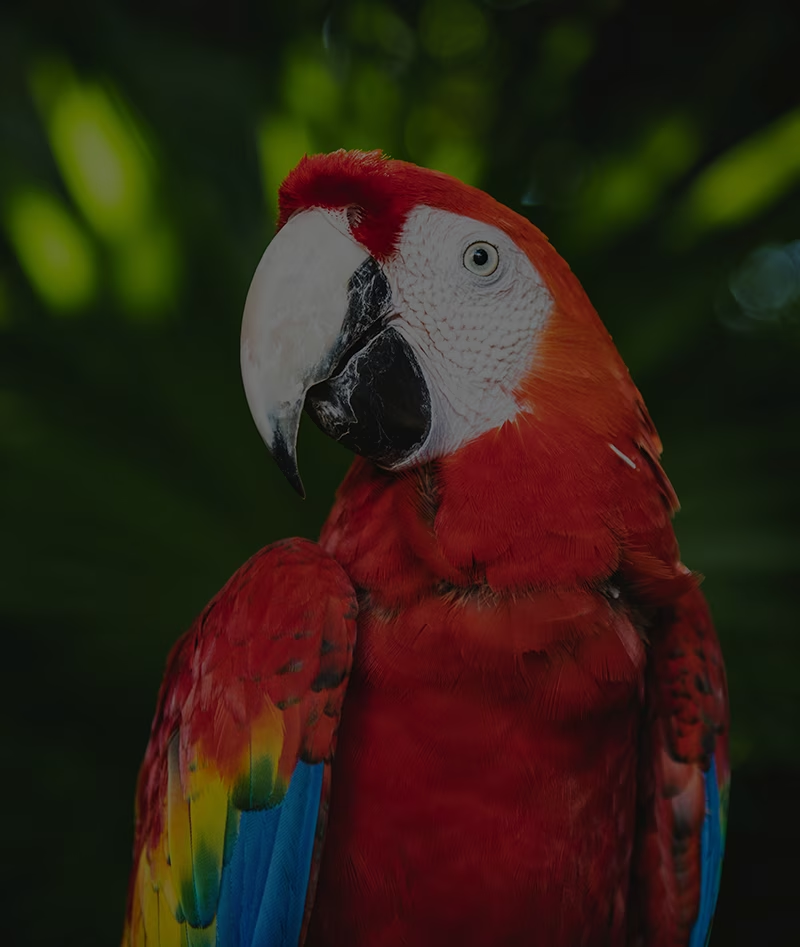
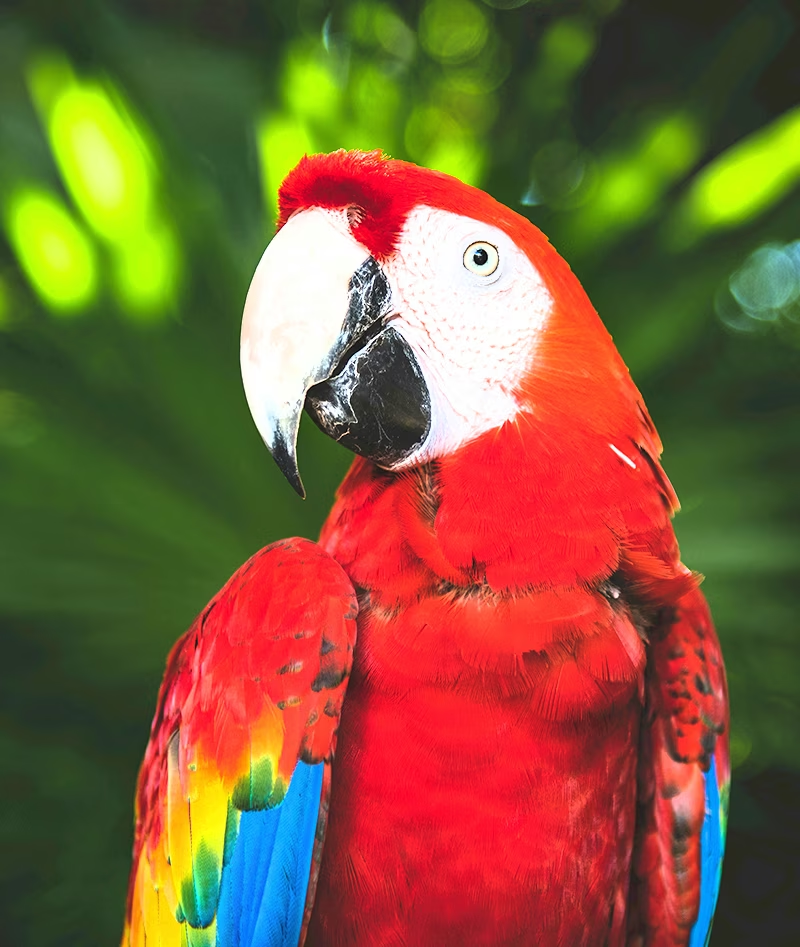
hsv_vdefinisce l'entità dello spostamento; la regolazione finale viene scelta casualmente tra-hsv_vehsv_v. Ad esempio, conhsv_v=0.4, l'intensità viene selezionata casualmente nell'intervallo da-0.4a0.4. - Scopo: essenziale per addestrare modelli che devono funzionare in condizioni di illuminazione diverse. Ad esempio, una mela rossa può apparire luminosa alla luce del sole e molto più scura all'ombra.
- Implementazione di Ultralytics: RandomHSV
-1.0 | -0.5 | 0.0 | 0.5 | 1.0 |
|---|---|---|---|---|
 |  | |  | 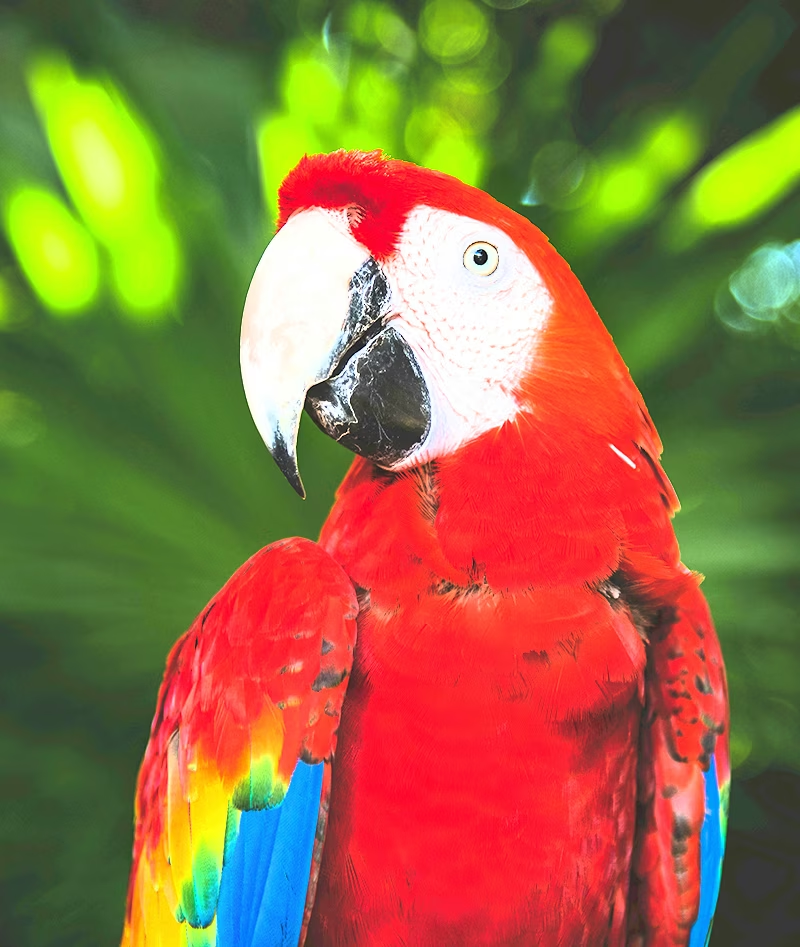 |
Trasformazioni geometriche#
Rotazione (degrees)#
- Intervallo: da
0.0a180 - Predefinito:
0 - Uso: ruota le immagini casualmente entro l'intervallo specificato. L'iperparametro
degreesdefinisce l'angolo di rotazione; la regolazione finale viene scelta casualmente tra-degreesedegrees. Ad esempio, condegrees=10.0, la rotazione viene selezionata casualmente nell'intervallo da-10.0a10.0. - Scopo: fondamentale per le applicazioni in cui gli oggetti possono comparire con orientamenti diversi. Ad esempio, nelle immagini aeree riprese dai droni, i veicoli possono essere orientati in qualsiasi direzione; i modelli devono quindi riconoscere gli oggetti indipendentemente dalla loro rotazione.
- Implementazione di Ultralytics: RandomPerspective
-180 | -90 | 0.0 | 90 | 180 |
|---|---|---|---|---|
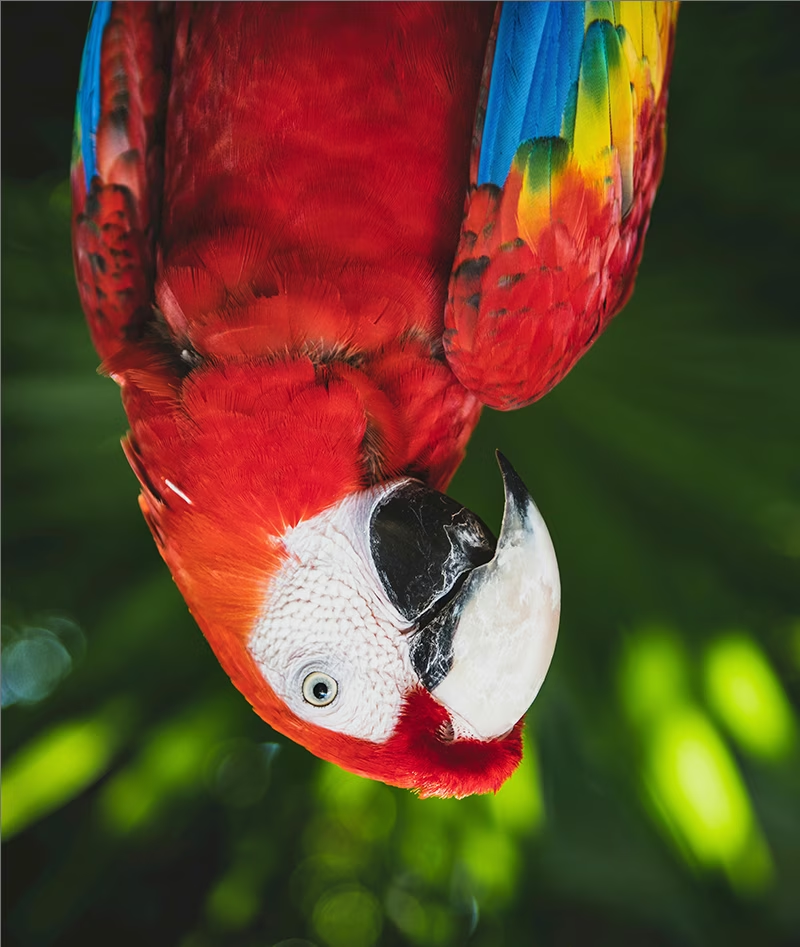 | 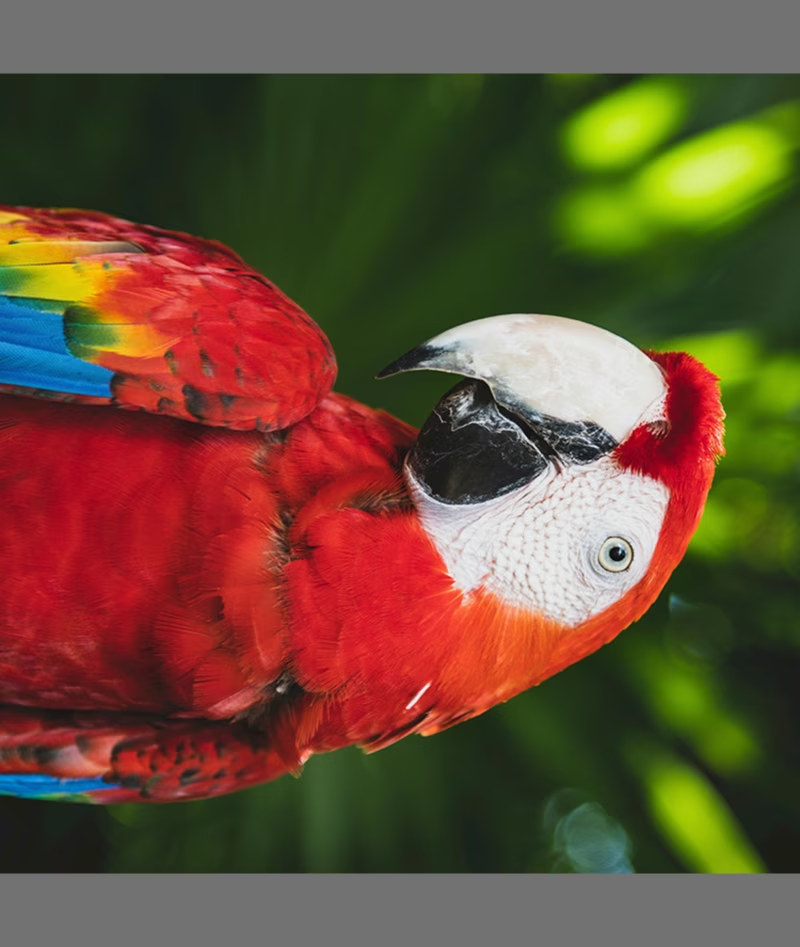 | | 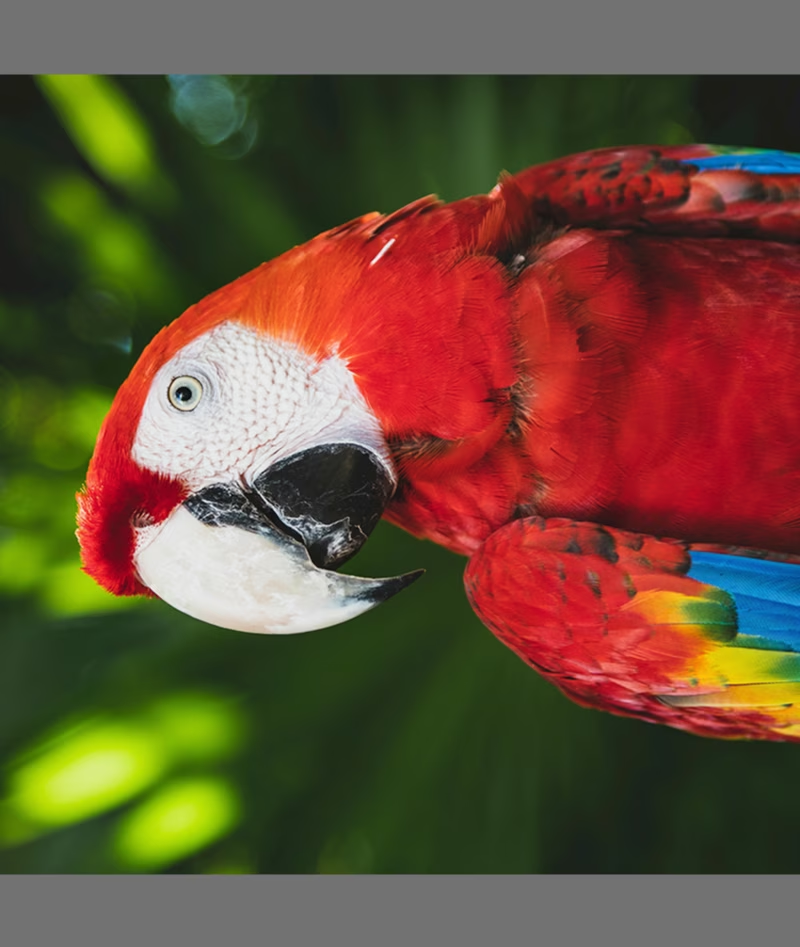 | |
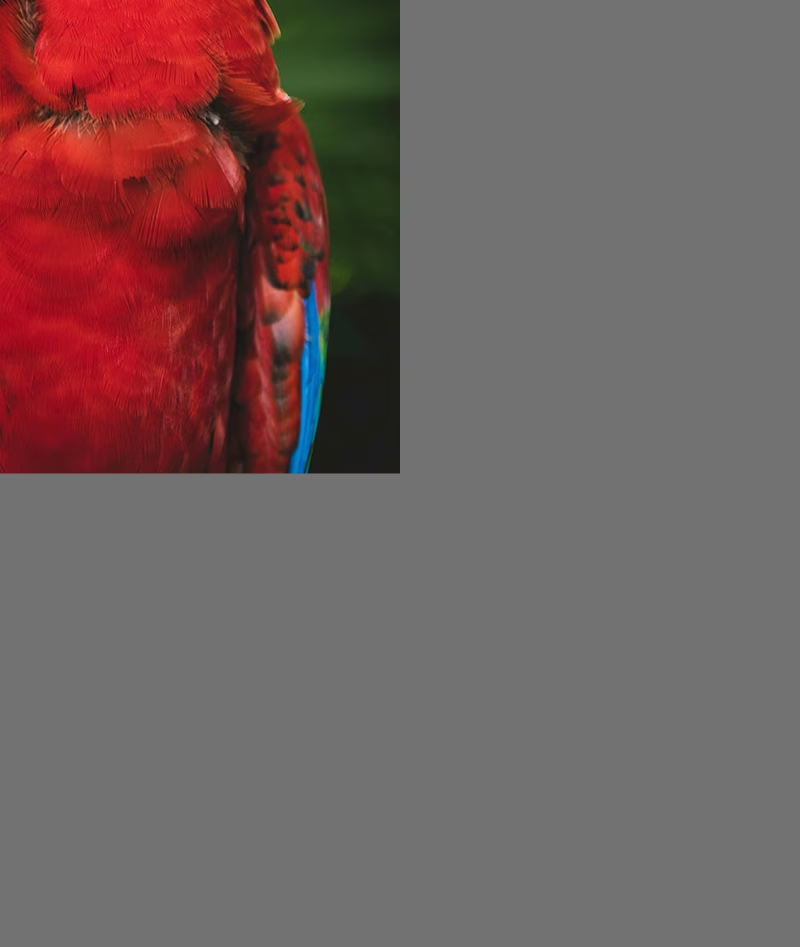
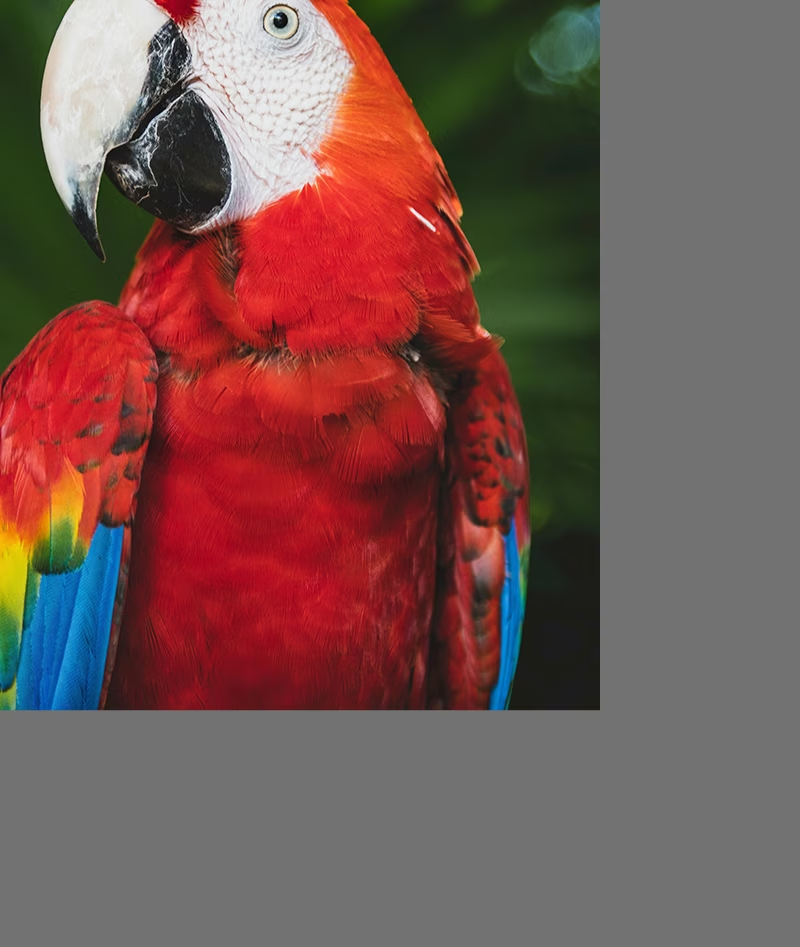
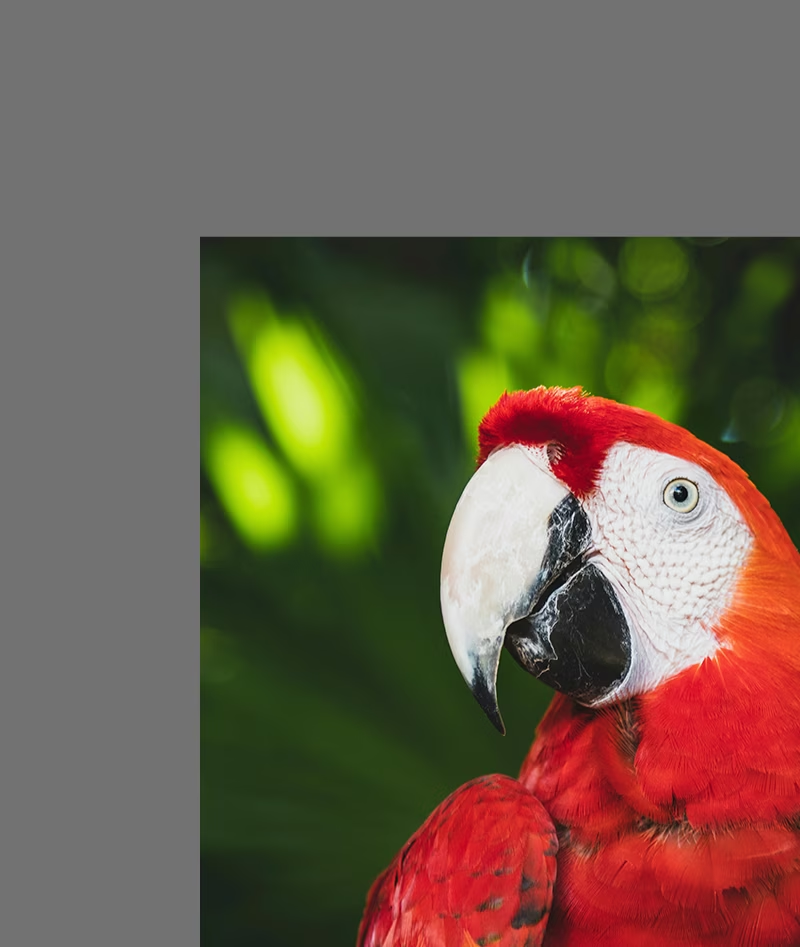
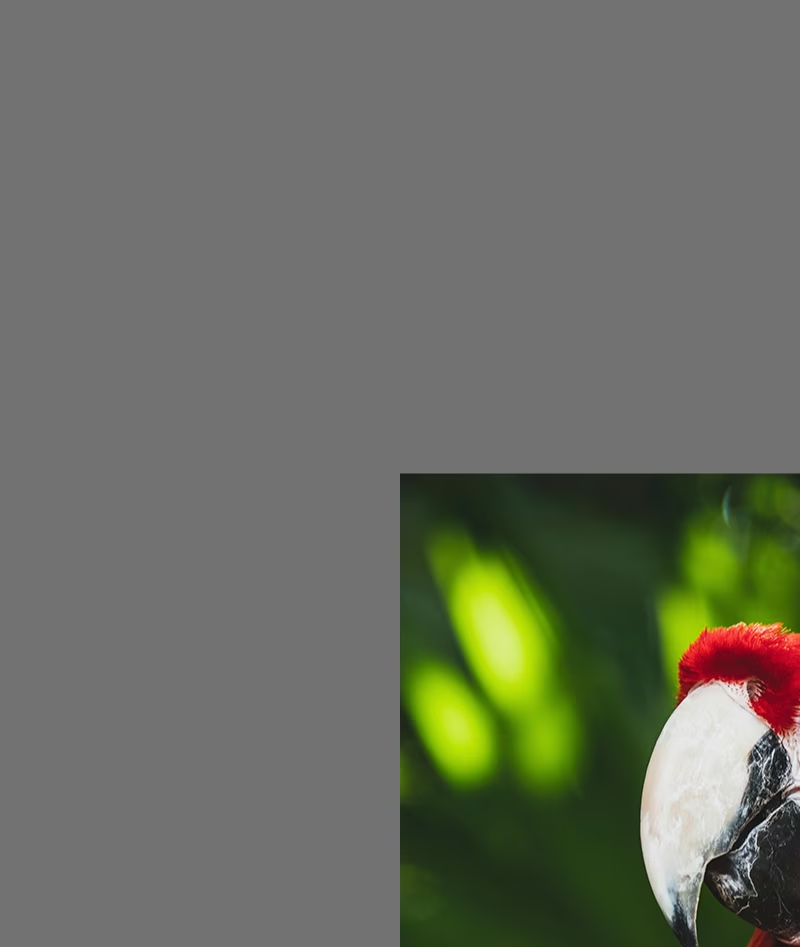
Traslazione (translate)#
- Intervallo:
0.0-1.0 - Predefinito:
0.1 - Uso: sposta le immagini orizzontalmente e verticalmente di una frazione casuale delle loro dimensioni. L'iperparametro
translatedefinisce l'entità dello spostamento; la regolazione finale viene scelta casualmente, due volte (una per ciascun asse), nell'intervallo compreso tra-translateetranslate. Ad esempio, contranslate=0.5, la traslazione sull'asse x viene selezionata casualmente nell'intervallo da-0.5a0.5, mentre per l'asse y viene selezionato un altro valore casuale indipendente nello stesso intervallo. - Scopo: aiuta i modelli a imparare a rilevare oggetti parzialmente visibili e migliora la robustezza rispetto alla posizione degli oggetti. Ad esempio, nelle applicazioni di valutazione dei danni ai veicoli, le parti di un'auto possono comparire nell'inquadratura per intero o solo in parte, a seconda della posizione e della distanza del fotografo. La trasformazione di traslazione insegna al modello a riconoscere queste caratteristiche indipendentemente da quanto siano complete o dalla loro posizione.
- Implementazione di Ultralytics: RandomPerspective
- Nota: per semplicità, le traslazioni applicate qui sotto sono uguali ogni volta per entrambi gli assi
xey. I valori-1.0e1.0non sono mostrati perché sposterebbero completamente l'immagine fuori dall'inquadratura.
-0.5 | -0.25 | 0.0 | 0.25 | 0.5 |
|---|---|---|---|---|
 |  | |  |  |
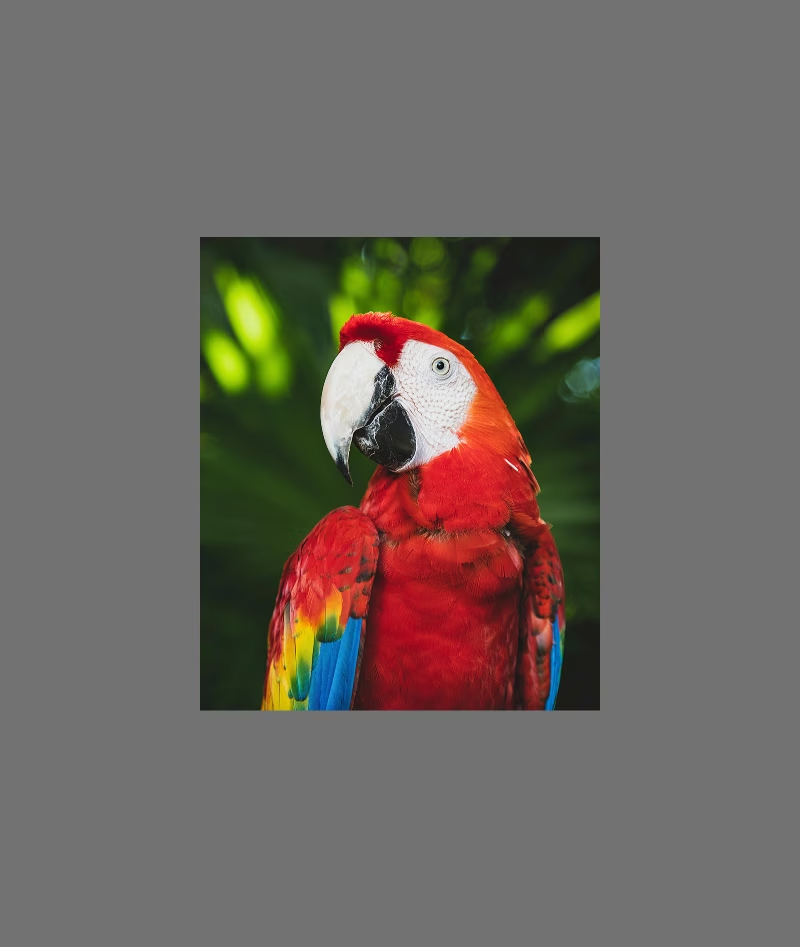
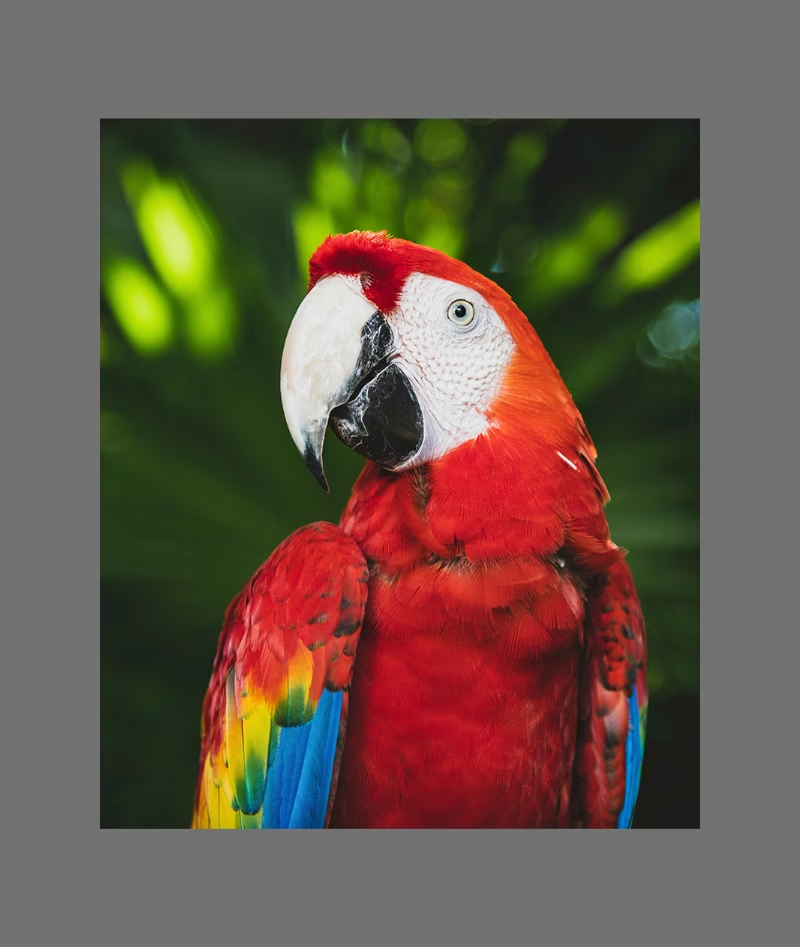
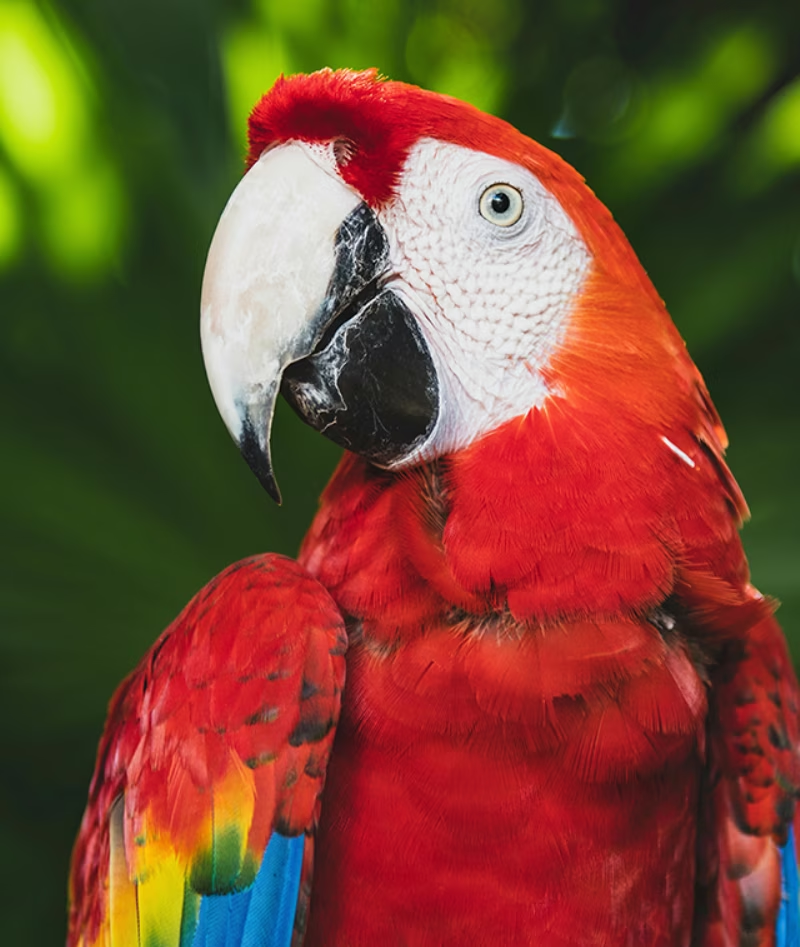
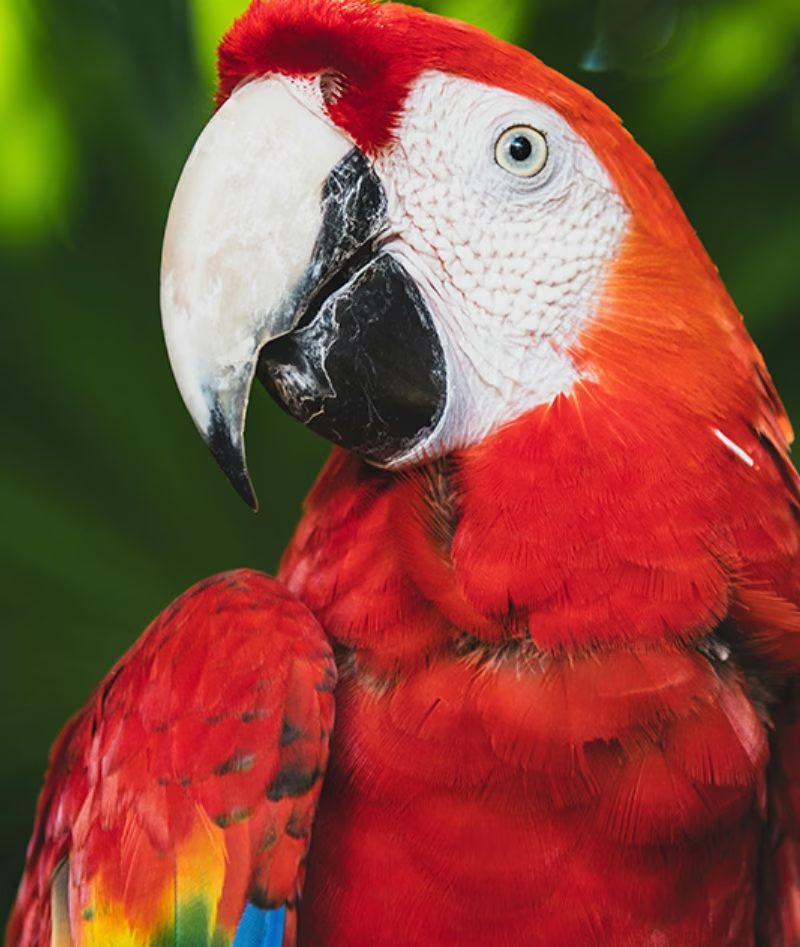
Scala (scale)#
- Intervallo: da
0.0a1.0come numero decimale oppure come tupla esplicita(min, max) - Predefinito:
0.5 - Uso: ridimensiona le immagini con un fattore casuale nell'intervallo specificato. Se è un numero decimale, l'iperparametro
scaledefinisce il fattore di scala; il fattore finale viene scelto casualmente tra1-scalee1+scale. Ad esempio, conscale=0.5, il fattore di scala viene selezionato casualmente nell'intervallo da0.5a1.5. Se è una tupla,scaleimposta direttamente l'intervallo, quindiscale=(0.5, 2.0)seleziona il fattore tra0.5e2.0. - Scopo: permette ai modelli di gestire oggetti a distanze e dimensioni diverse. Ad esempio, nelle applicazioni di guida autonoma i veicoli possono trovarsi a distanze diverse dalla fotocamera; il modello deve quindi riconoscerli indipendentemente dalle loro dimensioni.
- Implementazione di Ultralytics: RandomPerspective
- Nota:
- Il valore
-1.0non è mostrato perché farebbe scomparire l'immagine, mentre1.0produce semplicemente uno zoom 2x. - I valori mostrati nella tabella seguente sono gli scostamenti di scala effettivi, non i valori da passare all'iperparametro
scale. - La forma decimale è convalidata rispetto all'intervallo da
0.0a1.0; un valore al di fuori dell'intervallo genera unValueError. Per selezionare un fattore superiore a uno zoom 2x, usa invece la forma a tupla(min, max). - La forma a tupla si applica solo alle attività geometriche. L'addestramento di classificazione ricava il proprio intervallo di ritaglio dal numero decimale (da
1.0 - scalea1.0), quindi passare una tupla genera unTypeError.
- Il valore
-0.5 | -0.25 | 0.0 | 0.25 | 0.5 |
|---|---|---|---|---|
 |  | |  |  |
Inclinazione (shear)#
- Intervallo: da
-180a+180 - Predefinito:
0 - Uso: applica una trasformazione geometrica che inclina l'immagine lungo gli assi x e y, spostando di fatto alcune parti dell'immagine in una direzione e mantenendo parallele le rette. L'iperparametro
sheardefinisce l'angolo di inclinazione; la regolazione finale viene scelta casualmente tra-sheareshear. Ad esempio, conshear=10.0, l'inclinazione sull'asse x viene selezionata casualmente nell'intervallo da-10a10, mentre per l'asse y viene selezionato un altro valore casuale indipendente nello stesso intervallo. - Scopo: aiuta i modelli a generalizzare rispetto alle variazioni dell'angolo di visuale causate da leggere inclinazioni o prospettive oblique. Ad esempio, nel monitoraggio del traffico, oggetti come automobili e segnali stradali possono apparire inclinati perché le fotocamere non sono posizionate perpendicolarmente. L'aumento dei dati tramite inclinazione assicura che il modello impari a riconoscere gli oggetti nonostante queste distorsioni.
- Implementazione di Ultralytics: RandomPerspective
- Nota:
- I valori
shearpossono distorcere rapidamente l'immagine; è quindi consigliabile iniziare con valori piccoli e aumentarli gradualmente. - A differenza delle trasformazioni prospettiche, l'inclinazione non introduce profondità o punti di fuga, ma distorce la forma degli oggetti modificandone gli angoli e mantenendo paralleli i lati opposti.
- I valori
-10 | -5 | 0.0 | 5 | 10 |
|---|---|---|---|---|
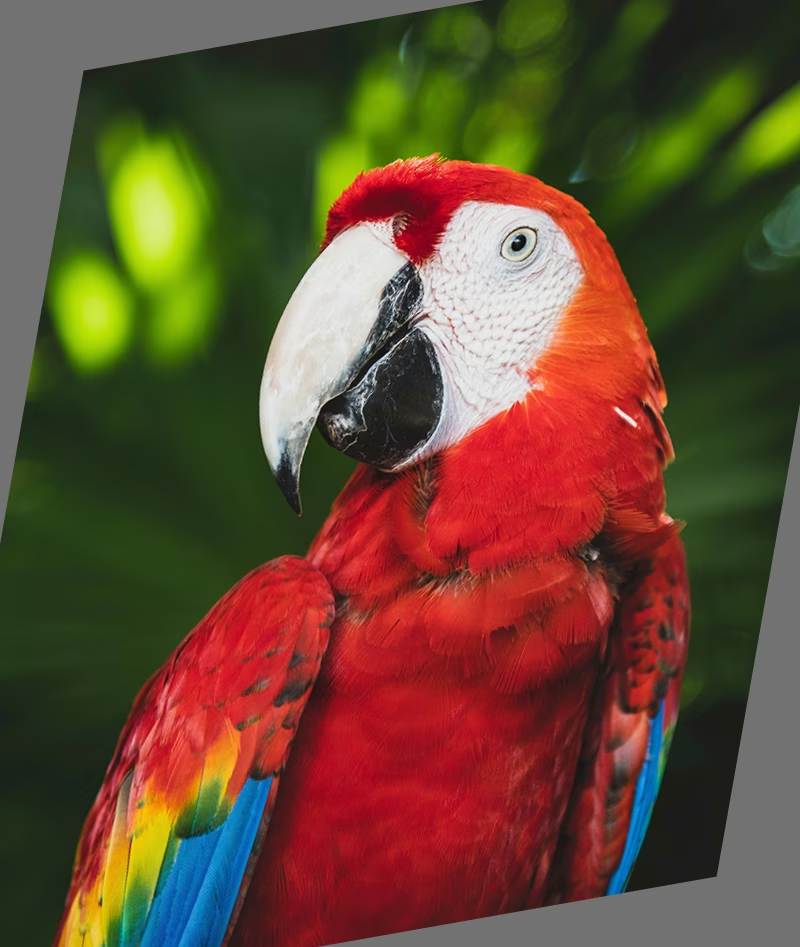 | 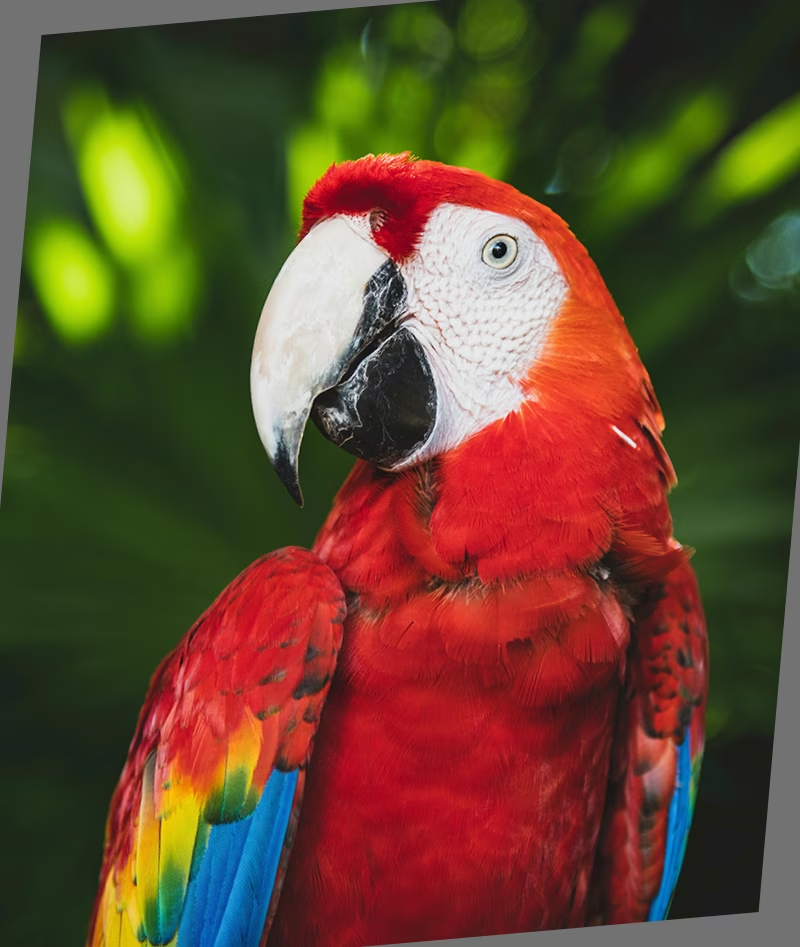 | | 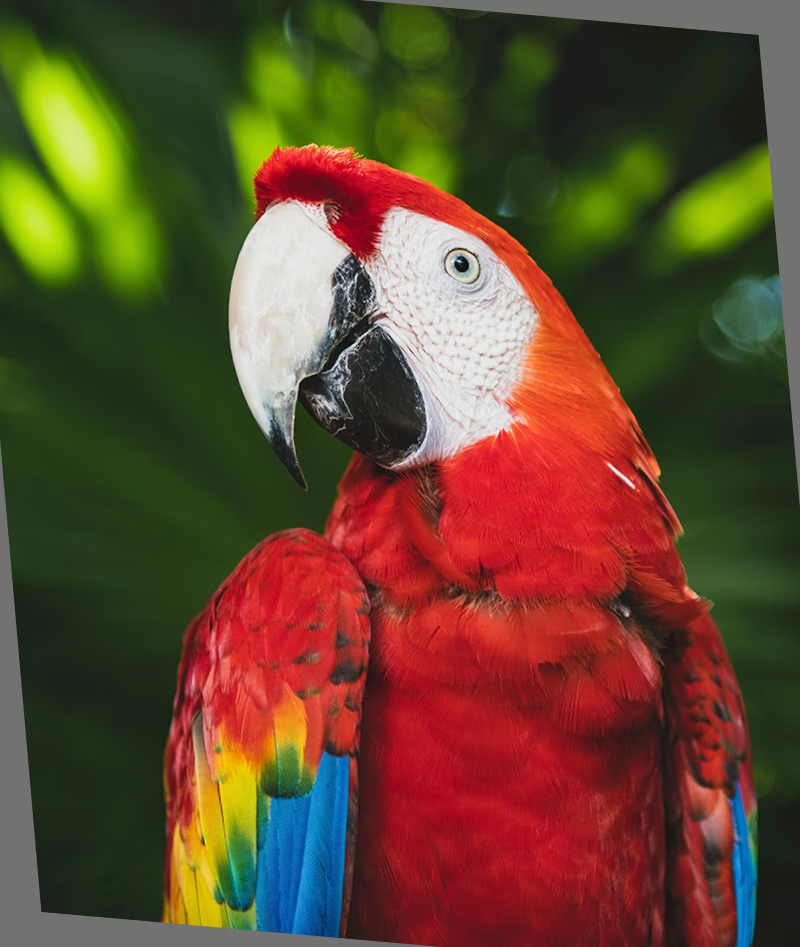 | 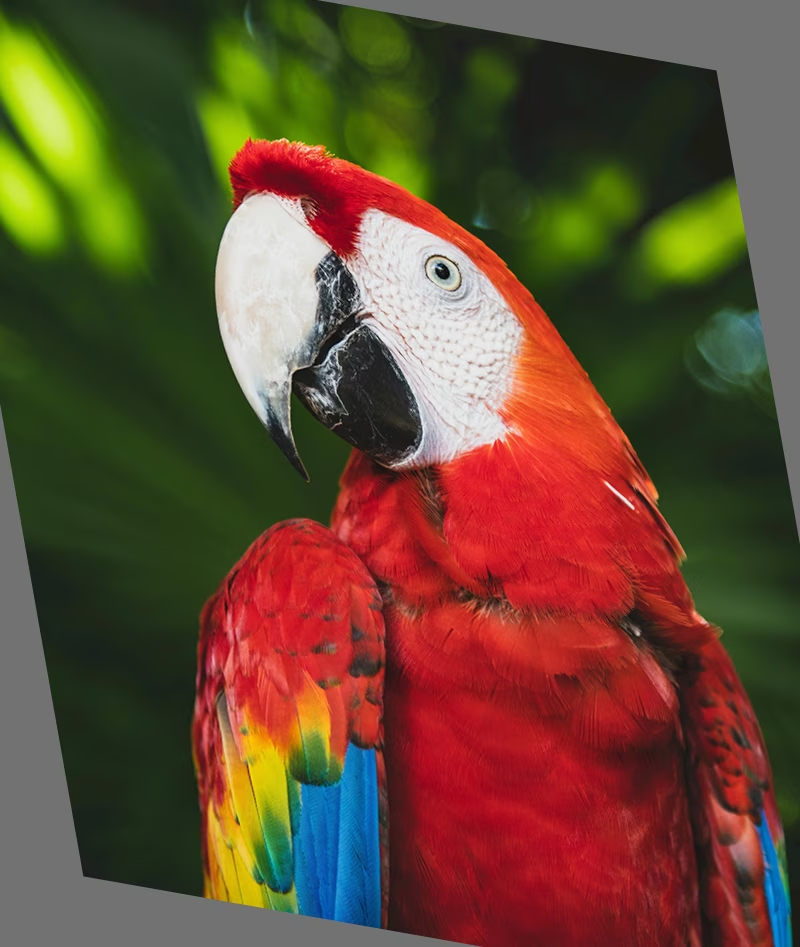 |
Prospettiva (perspective)#
- Intervallo:
0.0-0.001 - Predefinito:
0 - Uso: applica una trasformazione prospettica completa lungo gli assi x e y, simulando l'aspetto degli oggetti osservati da profondità o angolazioni diverse. L'iperparametro
perspectivedefinisce l'entità della prospettiva; la regolazione finale viene scelta casualmente tra-perspectiveeperspective. Ad esempio, conperspective=0.001, la prospettiva sull'asse x viene selezionata casualmente nell'intervallo da-0.001a0.001, mentre per l'asse y viene selezionato un altro valore casuale indipendente nello stesso intervallo. - Scopo: l'aumento dei dati tramite prospettiva è fondamentale per gestire cambiamenti estremi dell'angolo di visuale, soprattutto nei casi in cui gli oggetti appaiono scorciati o distorti a causa delle variazioni prospettiche. Ad esempio, nel rilevamento di oggetti con i droni, edifici, strade e veicoli possono apparire allungati o compressi a seconda dell'inclinazione e dell'altitudine del drone. Applicando trasformazioni prospettiche, i modelli imparano a riconoscere gli oggetti nonostante le distorsioni prospettiche e diventano più robusti nelle applicazioni reali.
- Implementazione di Ultralytics: RandomPerspective
-0.001 | -0.0005 | 0.0 | 0.0005 | 0.001 |
|---|---|---|---|---|
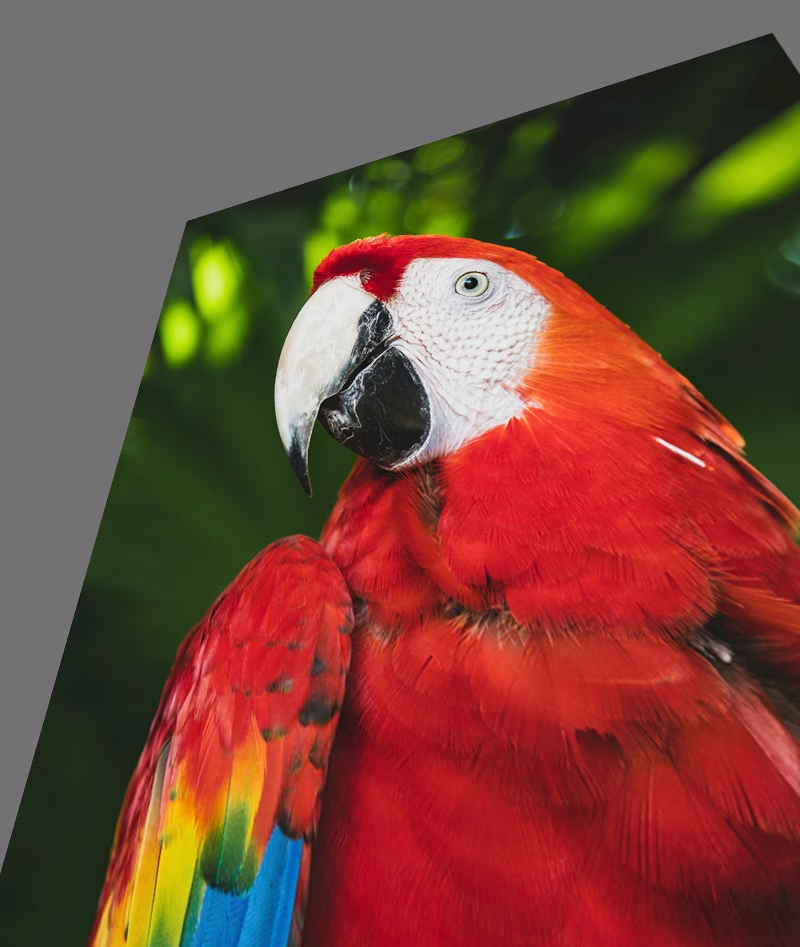 | 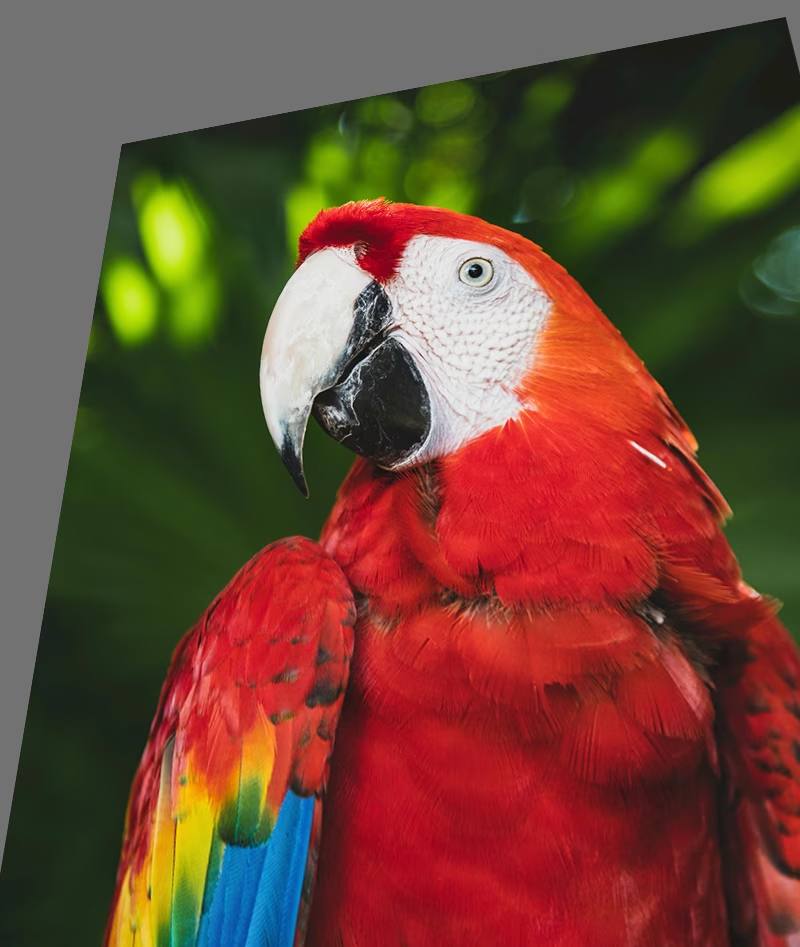 | | 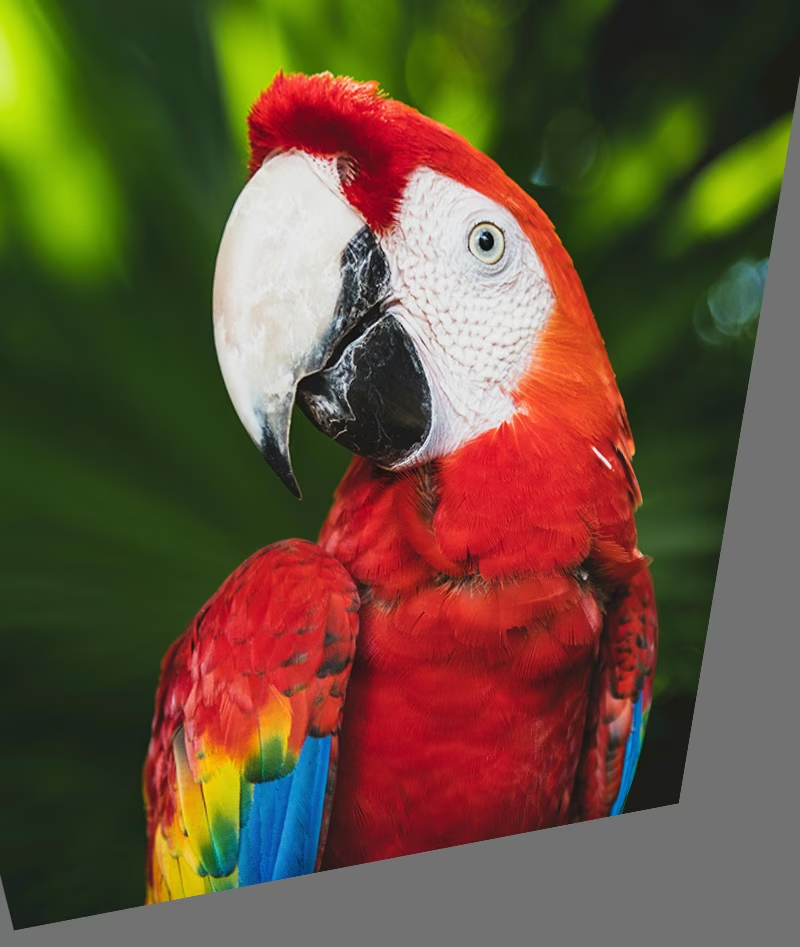 | 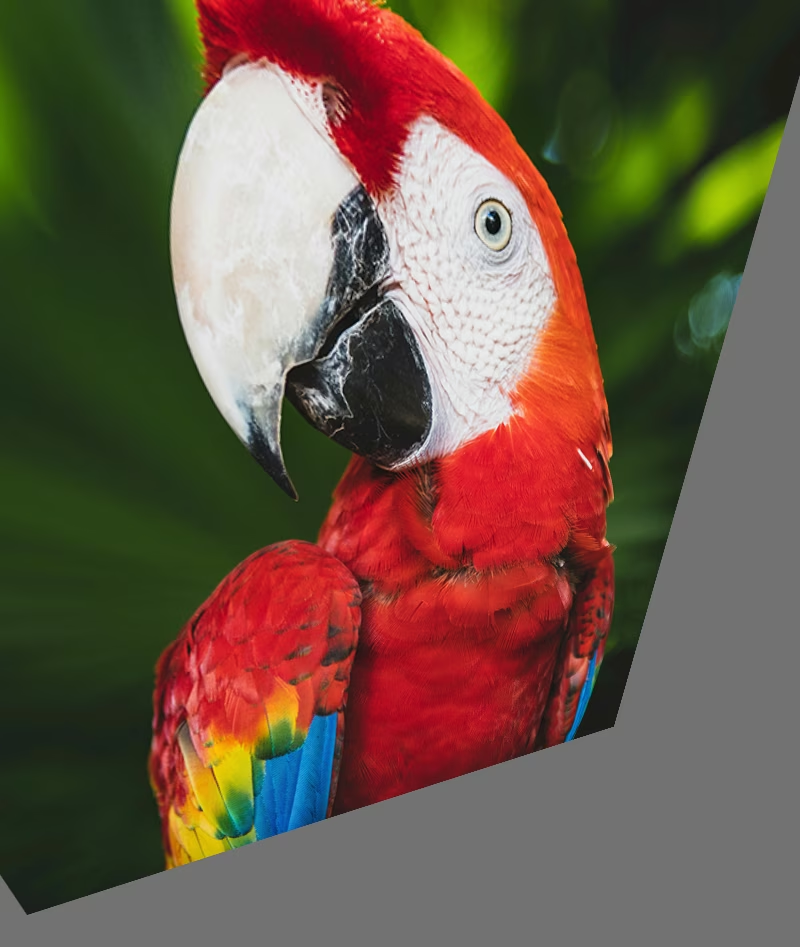 |
Capovolgimento verticale (flipud)#
- Intervallo:
0.0-1.0 - Predefinito:
0 - Uso: capovolge verticalmente l'immagine invertendola lungo l'asse y. Questa trasformazione capovolge l'intera immagine sottosopra, ma mantiene tutte le relazioni spaziali tra gli oggetti. L'iperparametro flipud definisce la probabilità di applicare la trasformazione: il valore
flipud=1.0assicura che tutte le immagini vengano capovolte, mentre il valoreflipud=0.0disattiva completamente la trasformazione. Ad esempio, conflipud=0.5, ogni immagine ha il 50% di probabilità di essere capovolta sottosopra. - Scopo: utile negli scenari in cui gli oggetti possono apparire capovolti. Ad esempio, nei sistemi di visione robotica, gli oggetti su nastri trasportatori o bracci robotici possono essere prelevati e posizionati con orientamenti diversi. Il capovolgimento verticale aiuta il modello a riconoscere gli oggetti indipendentemente dal loro orientamento dall'alto verso il basso.
- Implementazione di Ultralytics: RandomFlip
flipud disattivato | flipud attivato |
|---|---|
|  |
Capovolgimento orizzontale (fliplr)#
- Intervallo:
0.0-1.0 - Predefinito:
0.5 - Uso: capovolge orizzontalmente l'immagine specchiandola lungo l'asse x. Questa trasformazione scambia i lati sinistro e destro mantenendo la coerenza spaziale, aiutando il modello a generalizzare agli oggetti con orientamento speculare. L'iperparametro
fliplrdefinisce la probabilità di applicare la trasformazione: il valorefliplr=1.0assicura che tutte le immagini vengano capovolte, mentre il valorefliplr=0.0disattiva completamente la trasformazione. Ad esempio, confliplr=0.5, ogni immagine ha il 50% di probabilità di essere capovolta da sinistra a destra. - Scopo: il capovolgimento orizzontale è ampiamente usato nel rilevamento di oggetti, nella stima della posa e nel riconoscimento facciale per migliorare la robustezza rispetto alle variazioni tra sinistra e destra. Ad esempio, nella guida autonoma, veicoli e pedoni possono trovarsi su entrambi i lati della strada; il capovolgimento orizzontale aiuta il modello a riconoscerli con la stessa efficacia in entrambi gli orientamenti.
- Implementazione di Ultralytics: RandomFlip
fliplr disattivato | fliplr attivato |
|---|---|
|  |
Scambio dei canali BGR (bgr)#
- Intervallo:
0.0-1.0 - Predefinito:
0 - Uso: scambia i canali di colore di un'immagine passando da RGB a BGR e modificando l'ordine di rappresentazione dei colori. L'iperparametro
bgrdefinisce la probabilità di applicare la trasformazione: il valorebgr=1.0assicura che tutte le immagini subiscano lo scambio dei canali, mentre il valorebgr=0.0lo disattiva. Ad esempio, conbgr=0.5, ogni immagine ha il 50% di probabilità di essere convertita da RGB a BGR. - Scopo: aumenta la robustezza rispetto ai diversi ordinamenti dei canali di colore. Ad esempio, durante l'addestramento di modelli che devono funzionare con vari sistemi di fotocamere e librerie di elaborazione delle immagini, dove i formati RGB e BGR potrebbero essere usati in modo incoerente, oppure quando i modelli vengono distribuiti in ambienti in cui il formato colore dell'input può differire da quello dei dati di training.
- Implementazione di Ultralytics: Format
bgr disattivato | bgr attivato |
|---|---|
|  |
Mosaic (mosaic)#
- Intervallo:
0.0-1.0 - Predefinito:
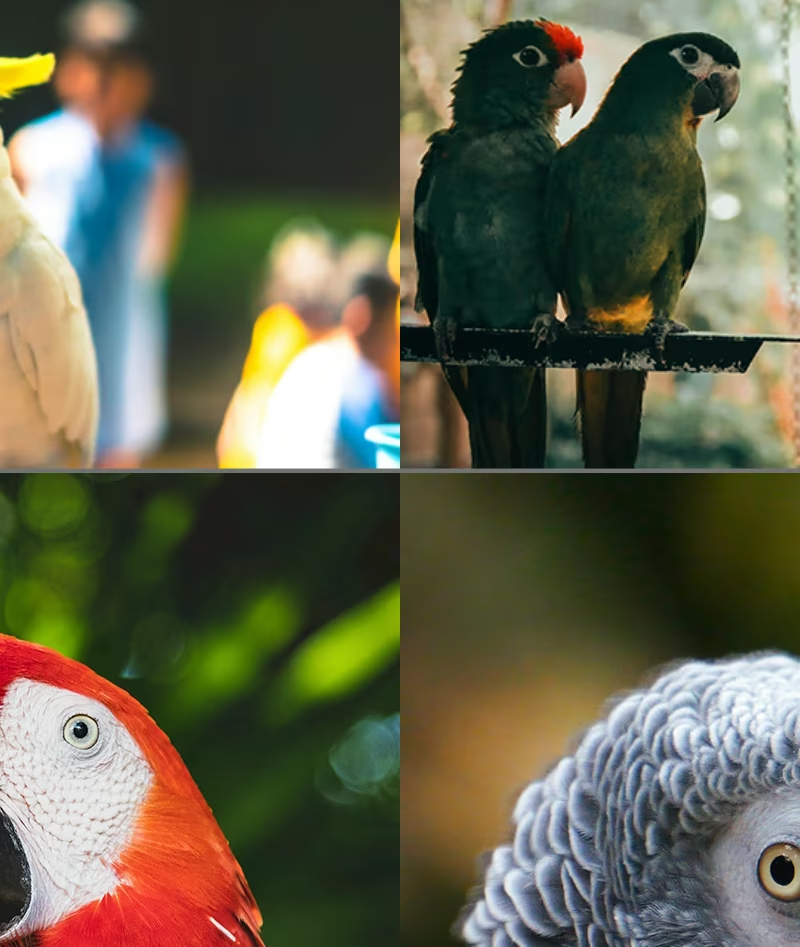
1 - Uso: combina quattro immagini di training in una. L'iperparametro
mosaicdefinisce la probabilità di applicare la trasformazione: il valoremosaic=1.0assicura che tutte le immagini vengano combinate, mentre il valoremosaic=0.0disattiva la trasformazione. Ad esempio, conmosaic=0.5, ogni immagine ha il 50% di probabilità di essere combinata con altre tre immagini. - Scopo: molto efficace per migliorare il rilevamento di oggetti piccoli e la comprensione del contesto. Ad esempio, nei progetti di conservazione della fauna selvatica, gli animali possono comparire a distanze e scale diverse. L'aumento dei dati mosaic aiuta il modello a imparare a riconoscere la stessa specie con dimensioni diverse, occlusioni parziali e contesti ambientali differenti, creando artificialmente campioni di training diversificati a partire da dati limitati.
- Implementazione di Ultralytics: Mosaic
- Nota:
- Anche se l'aumento dei dati
mosaicrende il modello più robusto, può rendere più impegnativo il processo di training. - L'aumento dei dati
mosaicpuò essere disattivato verso la fine dell'addestramento impostandoclose_mosaicsul numero di epoche mancanti al completamento dopo il quale disattivarlo. Ad esempio, seepochsè impostato su200eclose_mosaicè impostato su20, l'aumento dei datimosaicverrà disattivato dopo180epoche. Seclose_mosaicè impostato su0, l'aumento dei datimosaicsarà attivo per l'intero processo di training. - La chiusura del mosaic disattiva anche
copy_paste,mixupecutmixalla stessa epoca. Le quattro trasformazioni vengono disattivate insieme, così le epoche finali si svolgono senza di esse, mentre tutte le altre trasformazioni di aumento dei dati — trasformazioni geometriche, HSV, capovolgimenti e Albumentations — continuano a essere applicate. Nota checopy_paste, nella modalità predefinitaflip, opera su una singola immagine anziché combinarne diverse. - Il centro del mosaic generato viene determinato usando valori casuali e può trovarsi all'interno o all'esterno dell'immagine.
- L'implementazione attuale dell'aumento dei dati
mosaiccombina l'immagine corrente con altre 3, estratte da un buffer di immagini caricate di recente oppure da qualsiasi punto del dataset, secache='ram'. In entrambi i casi, le immagini vengono campionate con reinserimento, quindi la stessa immagine può comparire più di una volta in un singolo mosaic.
- Anche se l'aumento dei dati
mosaic disattivato | mosaic attivato |
|---|---|
|  |
Mixup (mixup)#
- Intervallo:
0.0-1.0 - Predefinito:
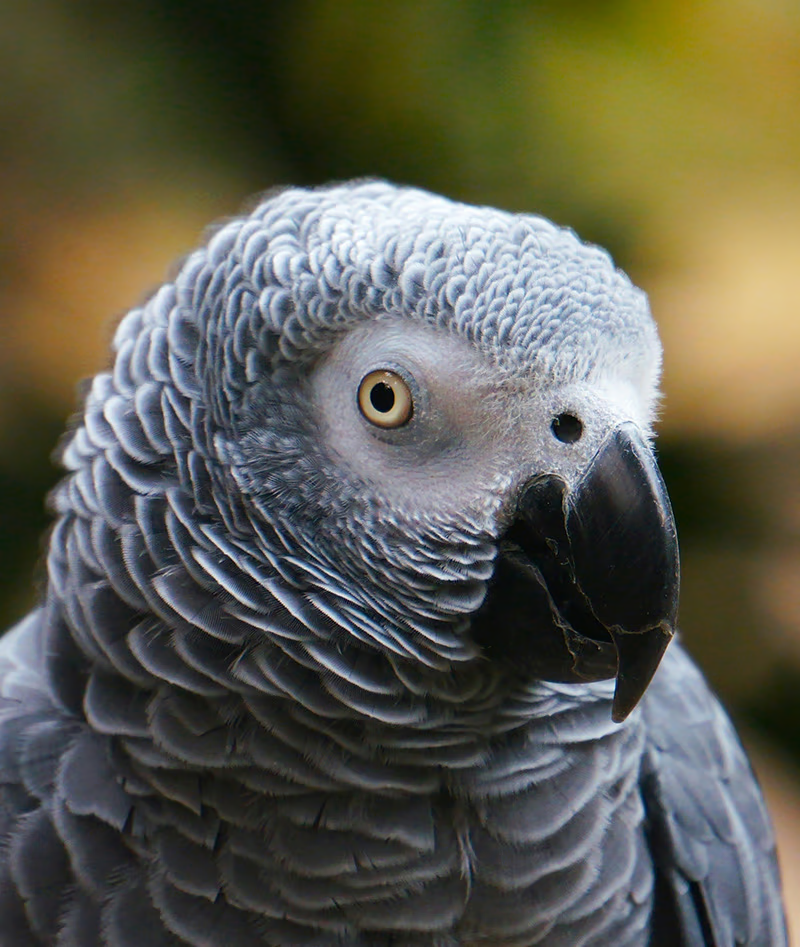
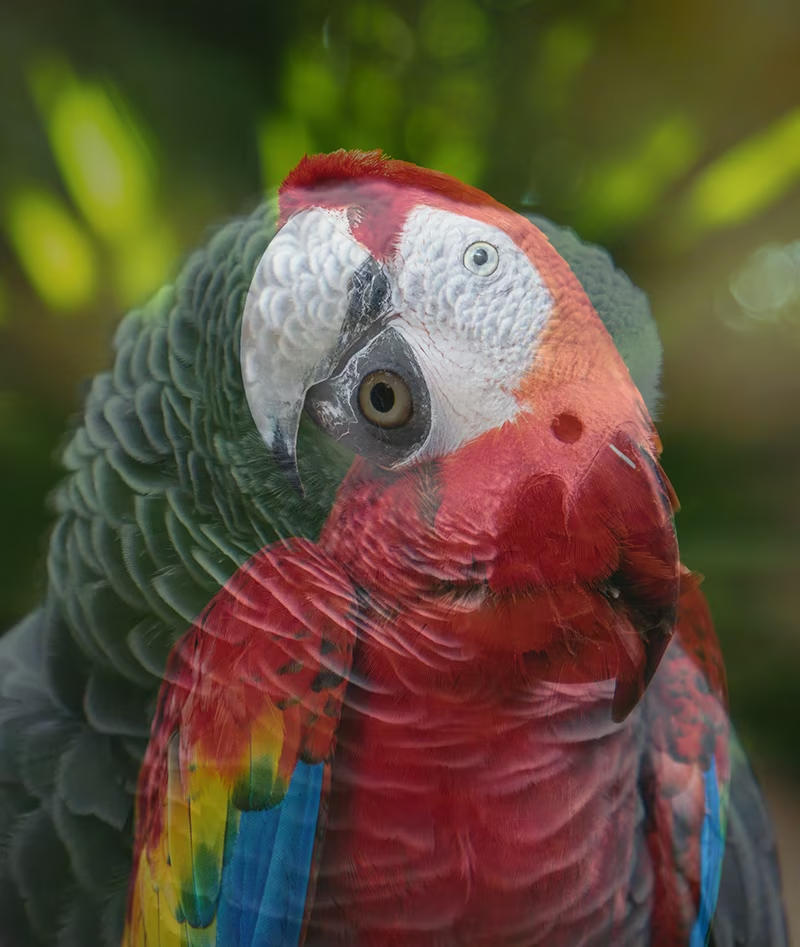
0 - Uso: fonde due immagini e le rispettive etichette con una determinata probabilità. L'iperparametro
mixupdefinisce la probabilità di applicare la trasformazione: il valoremixup=1.0assicura che tutte le immagini vengano mescolate, mentre il valoremixup=0.0disattiva la trasformazione. Ad esempio, conmixup=0.5, ogni immagine ha il 50% di probabilità di essere mescolata con un'altra. - Scopo: migliora la robustezza del modello e riduce l'overfitting. Ad esempio, nei sistemi di riconoscimento dei prodotti al dettaglio, mixup aiuta il modello a imparare caratteristiche più robuste fondendo immagini di prodotti diversi; in questo modo, il modello impara a identificare gli articoli anche quando sono parzialmente visibili o nascosti da altri prodotti sugli scaffali affollati dei negozi.
- Implementazione di Ultralytics: MixUp
- Nota:
- Il rapporto
mixupè un valore casuale estratto da una distribuzione betanp.random.beta(32.0, 32.0); ciò significa che ogni immagine contribuisce per circa il 50%, con leggere variazioni.
- Il rapporto
Prima immagine, mixup disattivato | Seconda immagine, mixup disattivato | mixup attivato |
|---|---|---|
|  |  |
CutMix (cutmix)#
- Intervallo:
0.0-1.0 - Predefinito:
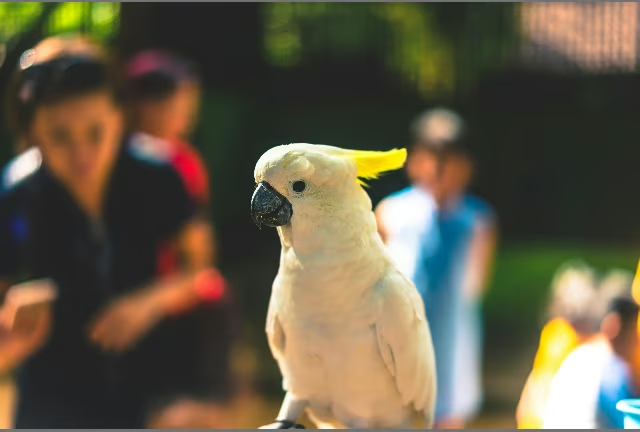
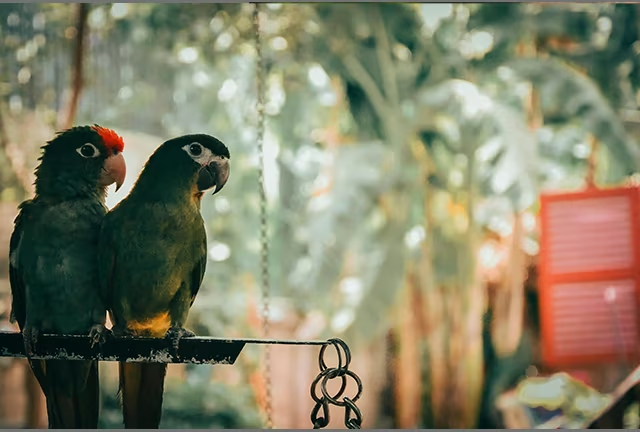
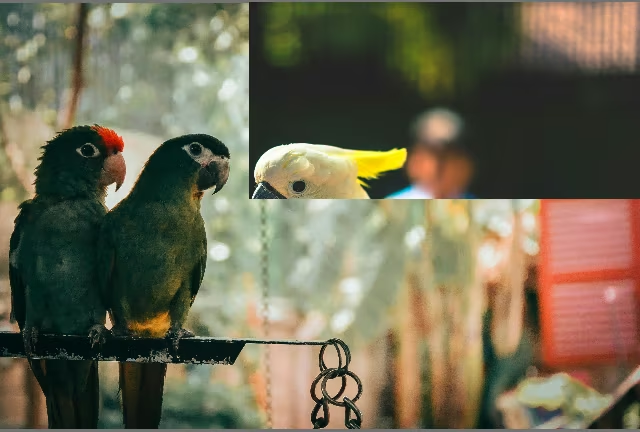
0 - Uso: ritaglia una regione rettangolare da un'immagine e la incolla su un'altra con una probabilità specificata. L'iperparametro
cutmixdefinisce la probabilità di applicare la trasformazione;cutmix=1.0fa sì che la trasformazione venga applicata a tutte le immagini, mentrecutmix=0.0la disabilita completamente. Ad esempio, concutmix=0.5, ogni immagine ha il 50% di probabilità che una regione venga sostituita con una porzione ritagliata da un'altra immagine. - Scopo: migliora le prestazioni del modello creando scenari realistici di occlusione e mantenendo l'integrità delle caratteristiche locali. Ad esempio, nei sistemi di guida autonoma, CutMix aiuta il modello a imparare a riconoscere veicoli o pedoni anche quando sono parzialmente occlusi da altri oggetti, migliorando la precisione di rilevamento in ambienti reali complessi con oggetti sovrapposti.
- Implementazione di Ultralytics: CutMix
- Nota:
- Le dimensioni e la posizione della regione ritagliata vengono determinate casualmente a ogni applicazione.
- A differenza di mixup, che combina globalmente i valori dei pixel,
cutmixmantiene le intensità originali dei pixel nelle regioni ritagliate, preservando le caratteristiche locali. - Una regione viene incollata nell'immagine di destinazione solo se non si sovrappone a nessun riquadro di delimitazione esistente. Inoltre, vengono mantenuti solo i riquadri di delimitazione che conservano una porzione sufficiente della loro area originale all'interno della regione incollata.
- Con l'implementazione attuale non è possibile modificare questa soglia minima dell'area del riquadro di delimitazione. È pari a
0.1(10%) per le etichette di rilevamento e a0.01(1%) quando le etichette includono segmenti.
Prima immagine, cutmix disattivato | Seconda immagine, cutmix disattivato | cutmix attivato |
|---|---|---|
 |  |  |
Augmentazioni Copy-Paste#
Copy-Paste (copy_paste)#
- Intervallo:
0.0-1.0 - Predefinito:
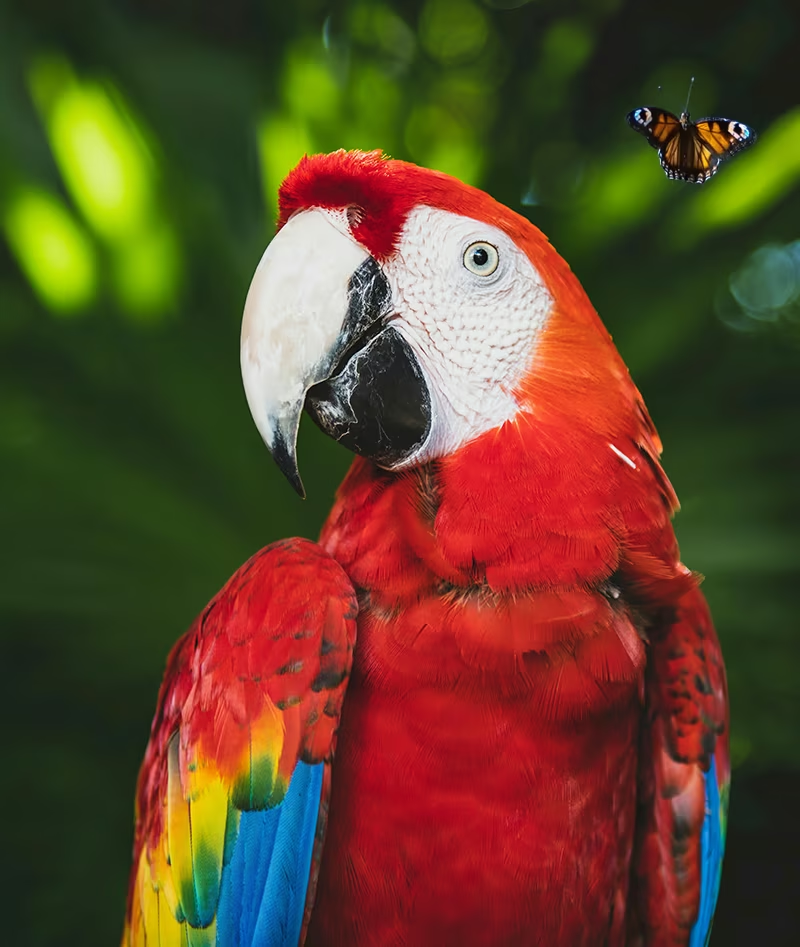
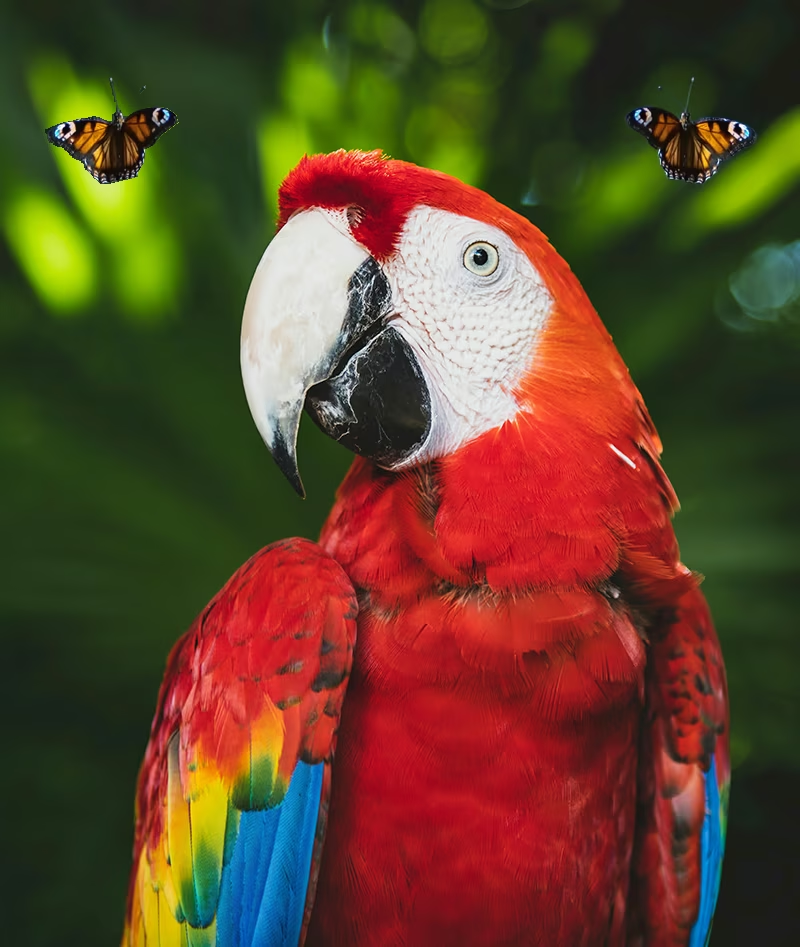
0 - Uso: richiede etichette poligonali, quindi si applica alle attività di segmentazione e OBB; questa augmentazione copia oggetti all'interno o tra immagini, in base a
copy_paste_mode. In modalitàflip,copy_pasteindica la frazione di oggetti idonei che vengono copiati: un'immagine con sei oggetti idonei ne acquisisce tre copie acopy_paste=0.5. In modalitàmixup, lo stesso valore controlla anche la probabilità che Copy-Paste venga eseguito.copy_paste=0.0disabilita la trasformazione. - Scopo: è particolarmente utile per le attività di segmentazione di istanze e per le classi di oggetti rari. Ad esempio, nel rilevamento di difetti industriali, dove alcuni tipi di difetti compaiono raramente, l'augmentazione Copy-Paste può aumentare artificialmente la frequenza di questi difetti rari copiandoli da un'immagine a un'altra. In questo modo il modello impara meglio a riconoscere i casi sottorappresentati senza richiedere altri campioni difettosi.
- Implementazione di Ultralytics: CopyPaste
- Nota:
- Come mostrato nel video qui sotto, l'augmentazione
copy_pastepuò essere usata per copiare oggetti da un'immagine a un'altra. - Dopo aver selezionato un oggetto da copiare, il suo IoA viene calcolato rispetto a tutti gli oggetti già presenti nell'immagine di destinazione, indipendentemente da
copy_paste_mode. L'oggetto viene incollato solo se tutti i valori IoA sono inferiori a0.3(30%); non viene incollato se un qualsiasi valore IoA è pari o superiore a0.3. - Con l'implementazione attuale non è possibile modificare la soglia IoA, che per impostazione predefinita è
0.3.
- Come mostrato nel video qui sotto, l'augmentazione
copy_paste disattivato | copy_paste attivo con copy_paste_mode=flip | Visualizza il processo copy_paste |
|---|---|---|
 |  |
Modalità Copy-Paste (copy_paste_mode)#
- Opzioni:
'flip','mixup' - Predefinito:
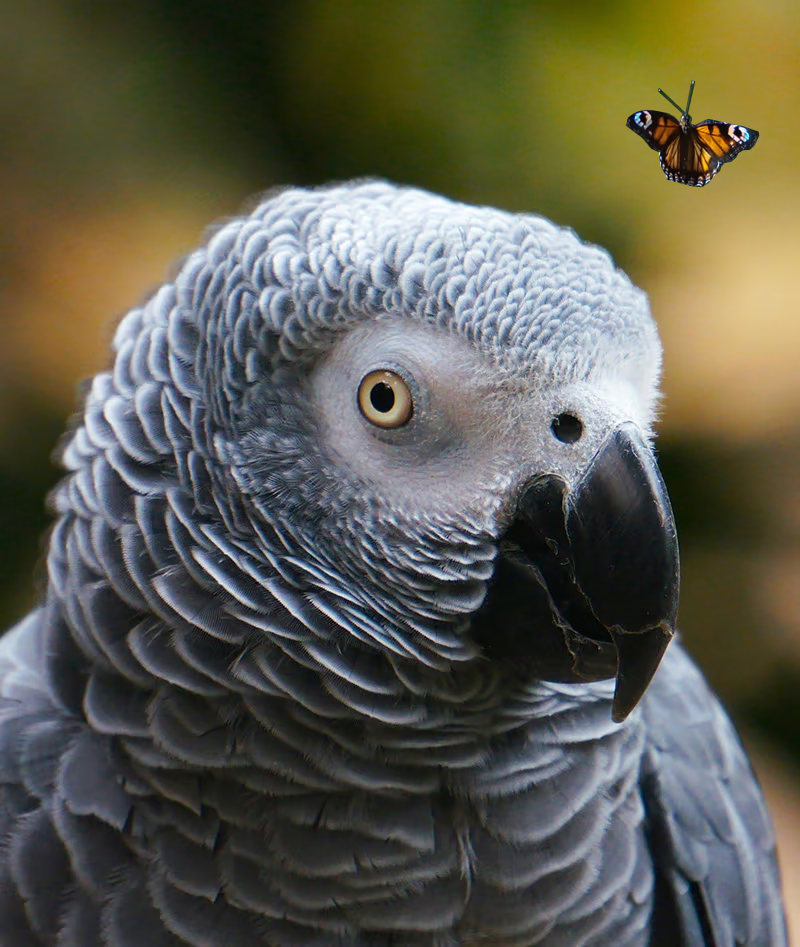
'flip' - Uso: determina il metodo usato per l'augmentazione Copy-Paste. Se impostato su
'flip', gli oggetti provengono dalla stessa immagine, mentre'mixup'consente di copiare oggetti da immagini diverse. - Scopo: offre flessibilità nel modo in cui gli oggetti copiati vengono integrati nelle immagini di destinazione.
- Implementazione di Ultralytics: CopyPaste
- Nota:
- Il principio IoA è lo stesso per entrambe le opzioni
copy_paste_mode, ma il modo in cui gli oggetti vengono copiati è diverso. - A seconda delle dimensioni dell'immagine, a volte gli oggetti possono essere copiati parzialmente o interamente fuori dall'inquadratura.
- A seconda della qualità delle annotazioni poligonali, gli oggetti copiati possono presentare lievi variazioni di forma rispetto agli originali.
- Il principio IoA è lo stesso per entrambe le opzioni
| Immagine di riferimento | Immagine scelta per copy_paste | copy_paste attivo con copy_paste_mode=mixup |
|---|---|---|
| |  |
Augmentazioni specifiche per la classificazione#
Auto Augment (auto_augment)#
- Opzioni:
'randaugment','autoaugment','augmix',None - Predefinito:
'randaugment' - Uso: applica policy di augmentazione automatizzate per la classificazione. L'opzione
'randaugment'usa RandAugment,'autoaugment'usa AutoAugment e'augmix'usa AugMix. ImpostandoNone, l'augmentazione automatizzata viene disabilitata. - Scopo: ottimizza automaticamente le strategie di augmentazione per le attività di classificazione. Ecco le differenze:
- AutoAugment: questa modalità applica policy di augmentazione predefinite, apprese da dataset come ImageNet, CIFAR10 e SVHN. Puoi selezionare queste policy esistenti, ma non puoi addestrarne di nuove con Torchvision. Per individuare le strategie di augmentazione ottimali per dataset specifici, servono librerie esterne o implementazioni personalizzate. Consulta l'articolo su AutoAugment.
- RandAugment: applica una selezione casuale di trasformazioni con intensità uniforme. Questo approccio riduce la necessità di una fase di ricerca approfondita, rendendo il processo più efficiente dal punto di vista computazionale e migliorando comunque la robustezza del modello. Consulta l'articolo su RandAugment.
- AugMix: AugMix è un metodo di augmentazione dei dati che migliora la robustezza del modello creando variazioni diverse delle immagini mediante combinazioni casuali di trasformazioni semplici. Consulta l'articolo su AugMix.
- Implementazione di Ultralytics: classify_augmentations()
- Nota:
- In sostanza, la differenza principale tra i tre metodi è il modo in cui le policy di augmentazione vengono definite e applicate.
- Puoi consultare questo articolo, che confronta nel dettaglio i tre metodi.
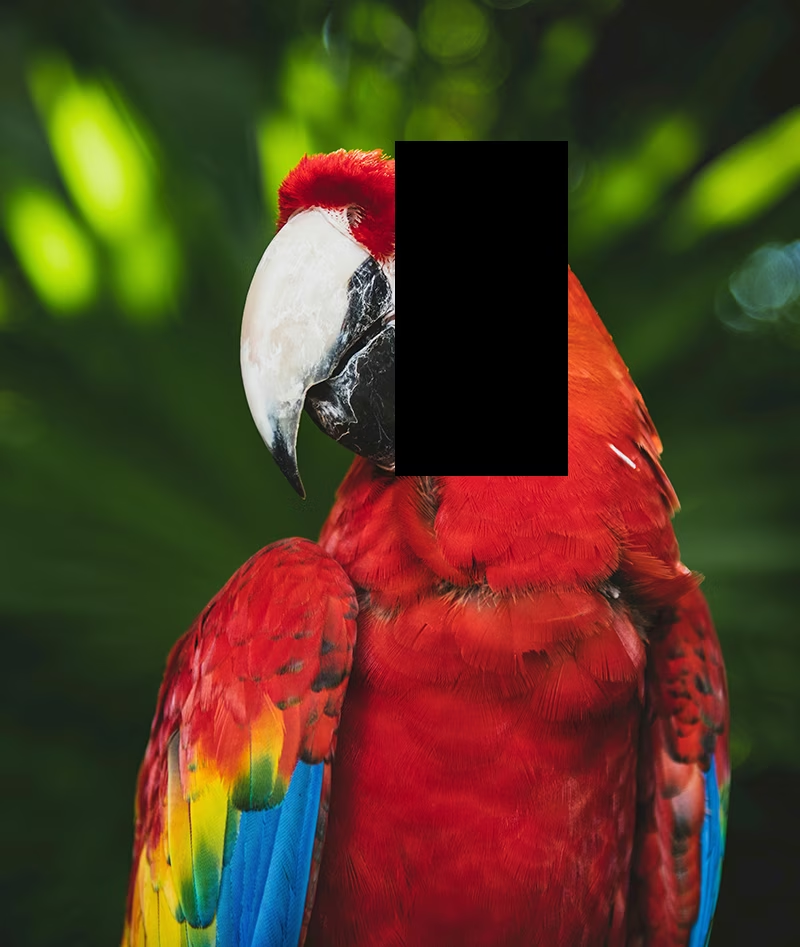
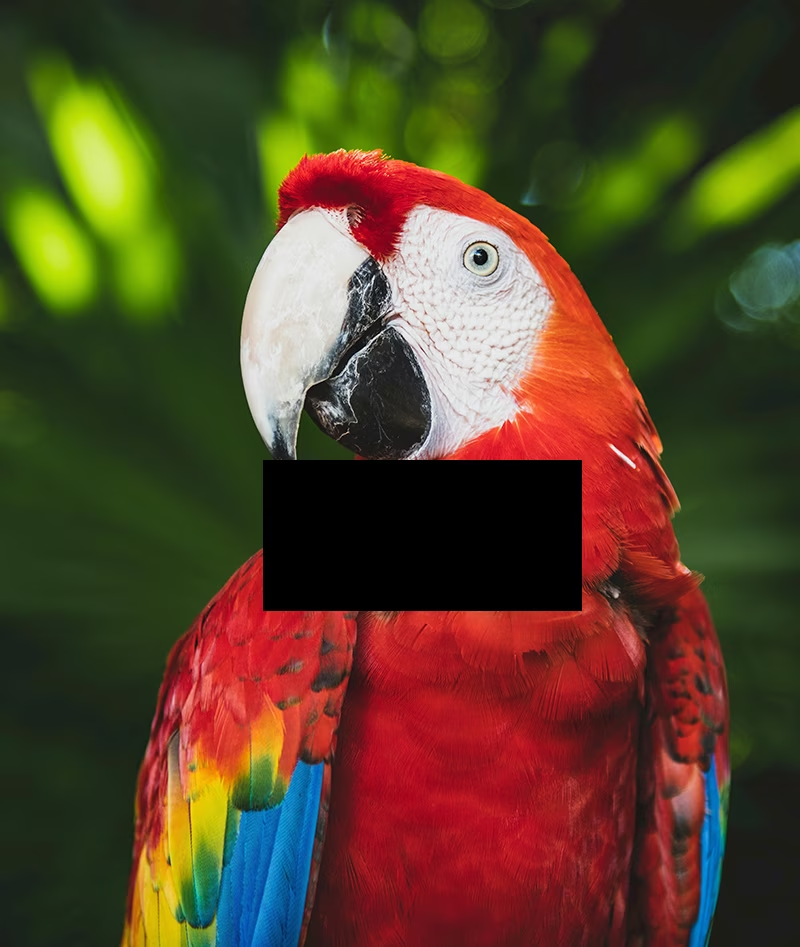
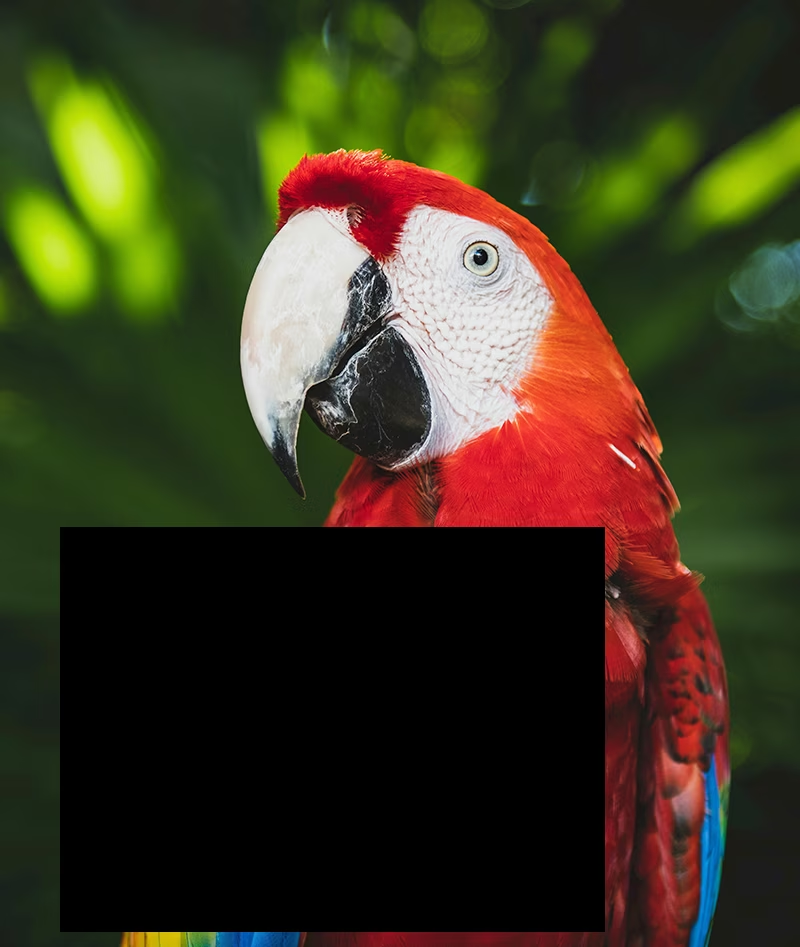
Random Erasing (erasing)#
- Intervallo:
0.0-1.0 - Predefinito:
0.4 - Uso: cancella casualmente porzioni dell'immagine durante l'addestramento per la classificazione. L'iperparametro
erasingdefinisce la probabilità di applicare la trasformazione;erasing=1.0cancella una regione in ogni immagine, mentreerasing=0.0disabilita la trasformazione. Ad esempio, conerasing=0.5, ogni immagine ha il 50% di probabilità che una porzione venga cancellata. - Scopo: aiuta i modelli ad apprendere caratteristiche robuste e impedisce che dipendano eccessivamente da regioni specifiche dell'immagine. Ad esempio, nei sistemi di riconoscimento facciale, Random Erasing aiuta i modelli a diventare più robusti alle occlusioni parziali, come occhiali da sole, mascherine o altri oggetti che possono coprire parzialmente i tratti del viso. Questo migliora le prestazioni nel mondo reale, perché costringe il modello a identificare le persone usando più caratteristiche facciali anziché basarsi soltanto su tratti distintivi che potrebbero essere nascosti.
- Implementazione di Ultralytics: classify_augmentations()
- Nota:
- L'augmentazione
erasinginclude gli iperparametriscale,ratioevalue, che non possono essere modificati con l'implementazione attuale. Come indicato nella documentazione di PyTorch, i rispettivi valori predefiniti sono(0.02, 0.33),(0.3, 3.3)e0.
- L'augmentazione
erasing disattivato | erasing attivo (esempio 1) | erasing attivo (esempio 2) | erasing attivo (esempio 3) |
|---|---|---|---|
|  |  |  |
Funzionalità avanzate di augmentazione#
Trasformazioni Albumentations personalizzate (augmentations)#
- Tipo:
listdelle trasformazioni Albumentations - Predefinito:
None - Uso: consente di fornire trasformazioni Albumentations personalizzate per l'augmentazione dei dati tramite l'API Python. Questo parametro accetta un elenco di oggetti di trasformazione Albumentations, che vengono applicati durante l'addestramento al posto delle trasformazioni Albumentations predefinite.
- Scopo: offre un controllo dettagliato sulle strategie di augmentazione dei dati sfruttando l'ampia libreria di trasformazioni Albumentations. È particolarmente utile quando servono augmentazioni specializzate che vanno oltre le opzioni YOLO integrate, come deformazioni elastiche e distorsioni a griglia per l'imaging medico, trasformazioni ottimizzate per riprese aeree dall'alto e immagini satellitari, variazioni di rumore e luminosità che simulano condizioni di scarsa illuminazione o variazioni di texture simili a difetti per l'ispezione industriale.
- Implementazione di Ultralytics: Albumentations
- Nota:
- Per creare gli oggetti di trasformazione è necessaria l'API Python. Quando salva un checkpoint, Ultralytics li serializza con
A.to_dict(); in questo modo, un elenco già serializzato può essere salvato e ricaricato tramite un file di configurazione YAML o la CLI, consentendo aresumedi ripristinarli. - Le trasformazioni personalizzate sostituiscono completamente il set predefinito di Albumentations. Tutte le altre augmentazioni configurate in questa pagina —
mosaic,hsv_h,degreese le altre — restano attive e vengono applicate indipendentemente. - Le trasformazioni spaziali che modificano la geometria dell'immagine, incluse quelle annidate in
A.OneOfoA.Compose, spostano insieme all'immagine i riquadri di delimitazione, i poligoni, i punti chiave e le maschere di profondità o semantiche;A.RandomGridShufflenon può preservare la topologia dei poligoni o dei punti chiave e genera un errore con i campioni di segmentazione, posa e OBB. - Albumentations offre oltre 70 trasformazioni; la documentazione di Albumentations le elenca tutte. Aggiungere molte trasformazioni, o trasformazioni con un costo computazionale elevato, rallenta l'addestramento. Inizia quindi con un piccolo set e tieni d'occhio la durata delle epoche.
- Si applica alle attività
detect,segment,semantic,depth,poseeobb. La classificazione è esclusa, perché usa una pipeline di augmentazione separata.
- Per creare gli oggetti di trasformazione è necessaria l'API Python. Quando salva un checkpoint, Ultralytics li serializza con
Gli esempi seguenti richiedono Albumentations 1.4.22 o versioni successive e quindi Python 3.9 o versioni successive.
import albumentations as A

from ultralytics import YOLO

# Carica un modello
model = YOLO("yolo26n.pt")

# Definisci trasformazioni Albumentations personalizzate
custom_transforms = [
    A.Blur(blur_limit=7, p=0.5),
    A.GaussNoise(std_range=(0.0124, 0.0277), p=0.3),
    A.CLAHE(clip_limit=4.0, p=0.5),
    A.RandomBrightnessContrast(brightness_limit=0.2, contrast_limit=0.2, p=0.5),
    A.HueSaturationValue(hue_shift_limit=20, sat_shift_limit=30, val_shift_limit=20, p=0.5),
]

# Addestra con trasformazioni Albumentations personalizzate
model.train(
    data="coco8.yaml",
    epochs=100,
    augmentations=custom_transforms,  # Passa trasformazioni personalizzate
    imgsz=640,
)
Domande frequenti#
La scelta delle augmentazioni giuste dipende dal tuo caso d'uso specifico e dal tuo dataset. Ecco alcune linee guida generali per aiutarti a decidere:
- Nella maggior parte dei casi, leggere variazioni di colore e luminosità sono vantaggiose. I valori predefiniti di
hsv_h,hsv_sehsv_vsono un buon punto di partenza. - Se il punto di vista della telecamera è costante e non cambierà una volta distribuito il modello, probabilmente puoi evitare le trasformazioni geometriche come
degrees(rotazione),translate,scale,shearoperspective. Se invece l'angolazione della telecamera può variare e vuoi un modello più robusto, è meglio mantenere queste augmentazioni. - Usa l'augmentazione
mosaicsolo se gli oggetti parzialmente occlusi o la presenza di più oggetti per immagine sono accettabili e non modificano il valore dell'etichetta. In alternativa, puoi mantenere attivomosaice aumentare il valore diclose_mosaicper disabilitarlo prima durante l'addestramento.
In breve: mantieni le cose semplici. Inizia con poche augmentazioni e aggiungine gradualmente altre secondo necessità. L'obiettivo è migliorare la capacità di generalizzazione e la robustezza del modello, non complicare eccessivamente il processo di addestramento. Assicurati inoltre che le augmentazioni applicate riflettano la stessa distribuzione dei dati che il modello incontrerà in produzione.
- Nella maggior parte dei casi, leggere variazioni di colore e luminosità sono vantaggiose. I valori predefiniti di
Se il pacchetto
albumentationsè installato, Ultralytics applica automaticamente un insieme di augmentazioni aggiuntive alle immagini. Queste augmentazioni vengono gestite internamente e non richiedono configurazioni aggiuntive.Puoi trovare l'elenco completo delle trasformazioni applicate nella nostra documentazione tecnica e nella nostra guida all'integrazione di Albumentations. Nota che sono attive solo le augmentazioni con una probabilità
psuperiore a0. Vengono applicate intenzionalmente con frequenza ridotta per simulare artefatti visivi del mondo reale, come sfocatura o effetti in scala di grigi.Puoi anche fornire trasformazioni Albumentations personalizzate usando l'API Python. Per maggiori dettagli, consulta la sezione Funzionalità avanzate di augmentazione.
Verifica che il pacchetto
albumentationssia installato. In caso contrario, installalo:pip install albumentationsUna volta installato, Ultralytics dovrebbe rilevare e usare automaticamente il pacchetto.
Puoi personalizzare le augmentazioni creando una classe di dataset e un trainer personalizzati. Ad esempio, puoi sostituire le augmentazioni di classificazione predefinite di Ultralytics con torchvision.transforms.Resize di PyTorch o altre trasformazioni. Per i dettagli sull'implementazione, consulta l'esempio di addestramento personalizzato nella documentazione sulla classificazione.