Caltech-256データセット#
Caltech-256データセットは、256の物体カテゴリと1つの背景クラスにまたがる30,607枚の画像で構成された、古典的な画像分類ベンチマークです。各カテゴリには、動物、乗り物、家庭用品、人など、実世界の物体の画像が少なくとも80枚含まれており、物体認識モデル向けのCaltech-101を発展させた、より大規模で難易度の高いデータセットとなっています。
Ultralytics Platform上のCaltech-256を確認して、サンプルのプレビュー、データセット統計の確認、トレーニング用のクローンを行えます。
Caltech-256には、あらかじめ定義されたトレーニング/検証分割がありません。以下のトレーニングコマンドによって、80%をトレーニング、20%を検証として自動的に分割されるため、手動で準備する必要はありません。
主な特徴#
- Caltech-256には、256の物体カテゴリと1つの
257.clutter背景クラスにまたがる30,607枚のカラー画像が含まれています(合計257個のクラスフォルダー)。 - カテゴリには、動物、乗り物、家庭用品、人など、さまざまな現実世界の物体が含まれています。
- 各カテゴリには少なくとも80枚の画像が含まれ、最大のカテゴリには約800枚まで含まれるため、クラスサイズには偏りがあります。
- 画像のサイズと解像度は一定ではありません。
- Caltech-256は、画像分類および物体認識アルゴリズムのベンチマークに広く使用されています。
データセットの構成#
Caltech-256は、256の物体カテゴリと1つの257.clutter背景クラスを含む、クラスごとに1つの計257個のフォルダーとして配布され、あらかじめ定義されたトレーニング/検証分割はありません。トレーニングを開始すると、Ultralyticsが画像を自動的に分割するため、手動で設定しなくてもモデルは257クラスすべてでトレーニングされます。
- クラス数: 257(物体カテゴリ256 + 背景1)
- 画像総数: 30,607
- トレーニング/検証分割: 80% / 20%の自動分割(トレーニング約24,385枚、検証約6,222枚)
- クラスあたりの画像数: 最低80枚(不均衡、最大約800枚)
アプリケーション#
Caltech-256データセットは、画像分類および物体認識モデルのトレーニングと評価に広く使用されており、畳み込みニューラルネットワーク (CNNs)やサポートベクターマシン (SVMs)などが含まれます。カテゴリ数の多さと高品質な画像により、機械学習およびコンピュータービジョンの研究やプロトタイピングで人気のベンチマークとなっています。
使用方法#
Caltech-256でYOLOモデルを、画像サイズ416、100エポックでトレーニングします。利用可能な引数の完全な一覧については、トレーニングページと画像分類タスクガイドを参照してください。
from ultralytics import YOLO

# Load a model
model = YOLO("yolo26n-cls.pt")  # load a pretrained model (recommended for training)

# Train the model
results = model.train(data="caltech256", epochs=100, imgsz=416)サンプル画像とアノテーション#
Caltech-256データセットにはさまざまな物体の高品質なカラー画像が含まれており、画像分類タスクに適した、構造化されたデータセットを提供します。以下に、データセットの画像例を示します(クレジット)。
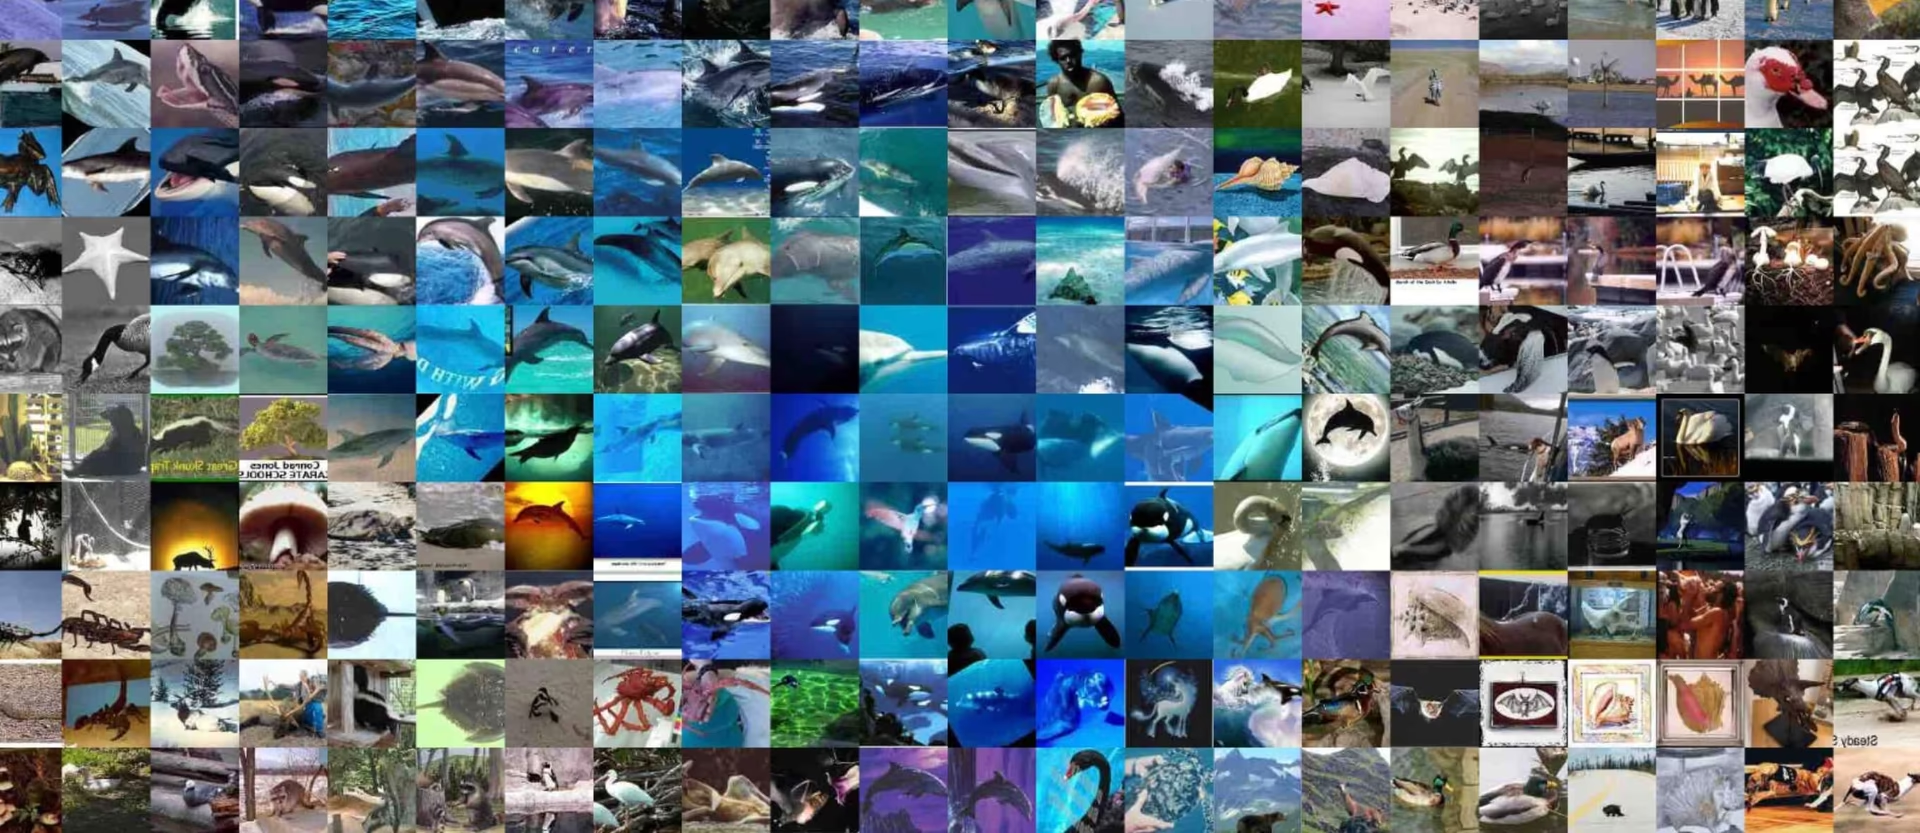
サンプルはCaltech-256データセットに含まれる物体の多様性と複雑さを示しており、堅牢な物体認識モデルのトレーニングにおける多様なデータセットの価値を浮き彫りにしています。
引用と謝辞#
研究または開発作業でCaltech-256データセットを使用する場合は、以下の論文を引用してください。
@article{griffin2007caltech,
         title={Caltech-256 object category dataset},
         author={Griffin, Gregory and Holub, Alex and Perona, Pietro},
         year={2007}
}機械学習およびコンピュータービジョン研究コミュニティにとって貴重なリソースであるCaltech-256データセットを作成・維持しているGregory Griffin、Alex Holub、Pietro Peronaに謝意を表します。Caltech-256データセットとその作成者の詳細については、Caltech-256データセットのWebサイトをご覧ください。
FAQ#
Caltech-256データセットは、画像分類および物体認識モデルのトレーニングとベンチマークに広く使用されています。256の物体カテゴリと1つの背景クラスにまたがる30,607枚の画像が含まれており、畳み込みニューラルネットワーク (CNNs)やサポートベクターマシン (SVMs)などのアルゴリズムに対して、Caltech-101よりも大規模で難易度の高いベンチマークを提供します。
Caltech-256でUltralytics YOLOモデルをトレーニングするには、以下のコードスニペットを使用してください。データセットは初回使用時に自動的にダウンロードされます。引数の完全な一覧については、モデルのトレーニングページを参照してください。
トレーニング例from ultralytics import YOLO # Load a model model = YOLO("yolo26n-cls.pt") # load a pretrained model (recommended for training) # Train the model results = model.train(data="caltech256", epochs=100, imgsz=416)Caltech-256には、256の物体カテゴリと1つの
257.clutter背景クラスが含まれており、合計257個のクラスフォルダーと30,607枚の画像があります。Ultralyticsでトレーニングすると、モデルは257クラスすべてを学習します。各カテゴリには少なくとも80枚の画像が含まれますが、クラスサイズには偏りがあり、最大のカテゴリには約800枚まで含まれます。Caltech-256にはあらかじめ定義された分割がありません。初めてトレーニングすると、Ultralyticsが80%をトレーニング、20%を検証として自動的に分割します(トレーニング画像約24,385枚、検証画像約6,222枚)。そのため、分割を手動で作成する必要はありません。分割を自分で管理する場合は、トレーニング前に画像を
train/フォルダーとval/フォルダーに整理してください。はい。Ultralytics Platformを使用すると、データセットの管理、画像分類モデルのトレーニング、広範なコーディングなしでのデプロイが可能です。クラウドでCaltech-256の実験を実行する便利な方法であり、分類データセットの概要でさらに多くのオプションを確認できます。