署名検出データセット
Ultralytics署名検出データセットは、178枚のドキュメント画像に単一のsignatureクラスのアノテーションを付与した物体検出データセットで、トレーニング用143枚、検証用35枚にあらかじめ分割されています。初回のトレーニング時にデータセットが自動でダウンロードされるため(11.3 MB)、ドキュメント検証、不正検出、デジタルドキュメント処理などのコンピュータービジョンアプリケーションを始めるためのコンパクトなデータセットとして適しています。
データセットの構成#
このデータセットには、手書きの署名が含まれるさまざまな種類のドキュメント画像が178枚あり、2つのサブセットに分かれています。
| 分割 | 画像 | 説明 |
|---|---|---|
| 学習 | 143 | モデルのトレーニング用ラベル付き画像 |
| 検証 | 35 | 評価用のホールドアウト画像 |
各画像には、1つのクラスsignatureのバウンディングボックスアノテーションが付与されています。設定には独立したテストセットはありません。
署名検出データセット(11.3 MB)は、初回のトレーニング時にUltralytics GitHubアセットから自動的にダウンロードされるため、手動でのダウンロードや準備は不要です。
Ultralytics Platform上のSignatureで、アノテーションを重ねた画像やChartsタブのクラス分布とバウンディングボックスのヒートマップを確認し、データセットをクローンして独自モデルをクラウドでトレーニングできます。
用途#
このデータセットでトレーニングしたモデルは、スキャンしたドキュメントや動画内の署名を識別して追跡でき、次の用途に役立ちます。
- ドキュメント検証: 法務・金融関連ドキュメントの署名確認を自動化します
- 不正検出: 偽造または権限のない署名の可能性を特定します
- デジタルドキュメント処理: 行政・法務分野のワークフローを効率化します
- 銀行・金融: 小切手処理や融資関連ドキュメントの検証におけるセキュリティを強化します
- アーカイブ研究: 歴史的文書の分析と目録作成を支援します
- 教育・研究: コンピュータービジョンの講座で、さまざまな種類のドキュメントにおける署名の特徴を研究します
データセットYAML#
signature.yamlファイルでは、データセットのパス、クラス名、その他のメタデータなどの設定を定義します。このファイルは、https://github.com/ultralytics/ultralytics/blob/main/ultralytics/cfg/datasets/signature.yamlにあるUltralyticsリポジトリで管理されています。
# Ultralytics 🚀 AGPL-3.0 License - https://ultralytics.com/license

# Signature dataset by Ultralytics
# Documentation: https://docs.ultralytics.com/datasets/detect/signature
# Example usage: yolo train data=signature.yaml
# parent
# ├── ultralytics
# └── datasets
#     └── signature ← downloads here (11.3 MB)

# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: signature # dataset root dir
train: images/train # train images (relative to 'path') 143 images
val: images/val # val images (relative to 'path') 35 images

# Classes
names:
  0: signature

# Download script/URL (optional)
download: https://github.com/ultralytics/assets/releases/download/v0.0.0/signature.zip使用方法#
提供されているコード例を使用すると、Signature Detection Datasetで画像サイズ640、100エポックの条件でYOLO26nモデルをトレーニングできます。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("yolo26n.pt")  # 事前トレーニング済みモデルを読み込みます(トレーニングにはこちらを推奨します)

# モデルをトレーニングする
results = model.train(data="signature.yaml", epochs=100, imgsz=640)トレーニング後は、ファインチューニング済みモデルを使用して、ドキュメントや動画に対する推論を実行できます。以下の例では、信頼度しきい値を0.75に設定し、サンプル動画に対して予測を実行します。
from ultralytics import YOLO

# モデルを読み込む
model = YOLO("path/to/best.pt")  # 署名検出用のファインチューニング済みモデルを読み込みます

# モデルを使用した推論
results = model.predict("https://ultralytics.com/assets/signature-s.mp4", conf=0.75)サンプル画像とアノテーション#
このデータセットはさまざまな形式のドキュメントを網羅しており、トレーニング済みモデルが契約書、フォーム、手紙にわたって汎化できるよう支援します。以下はデータセットのトレーニングバッチです。
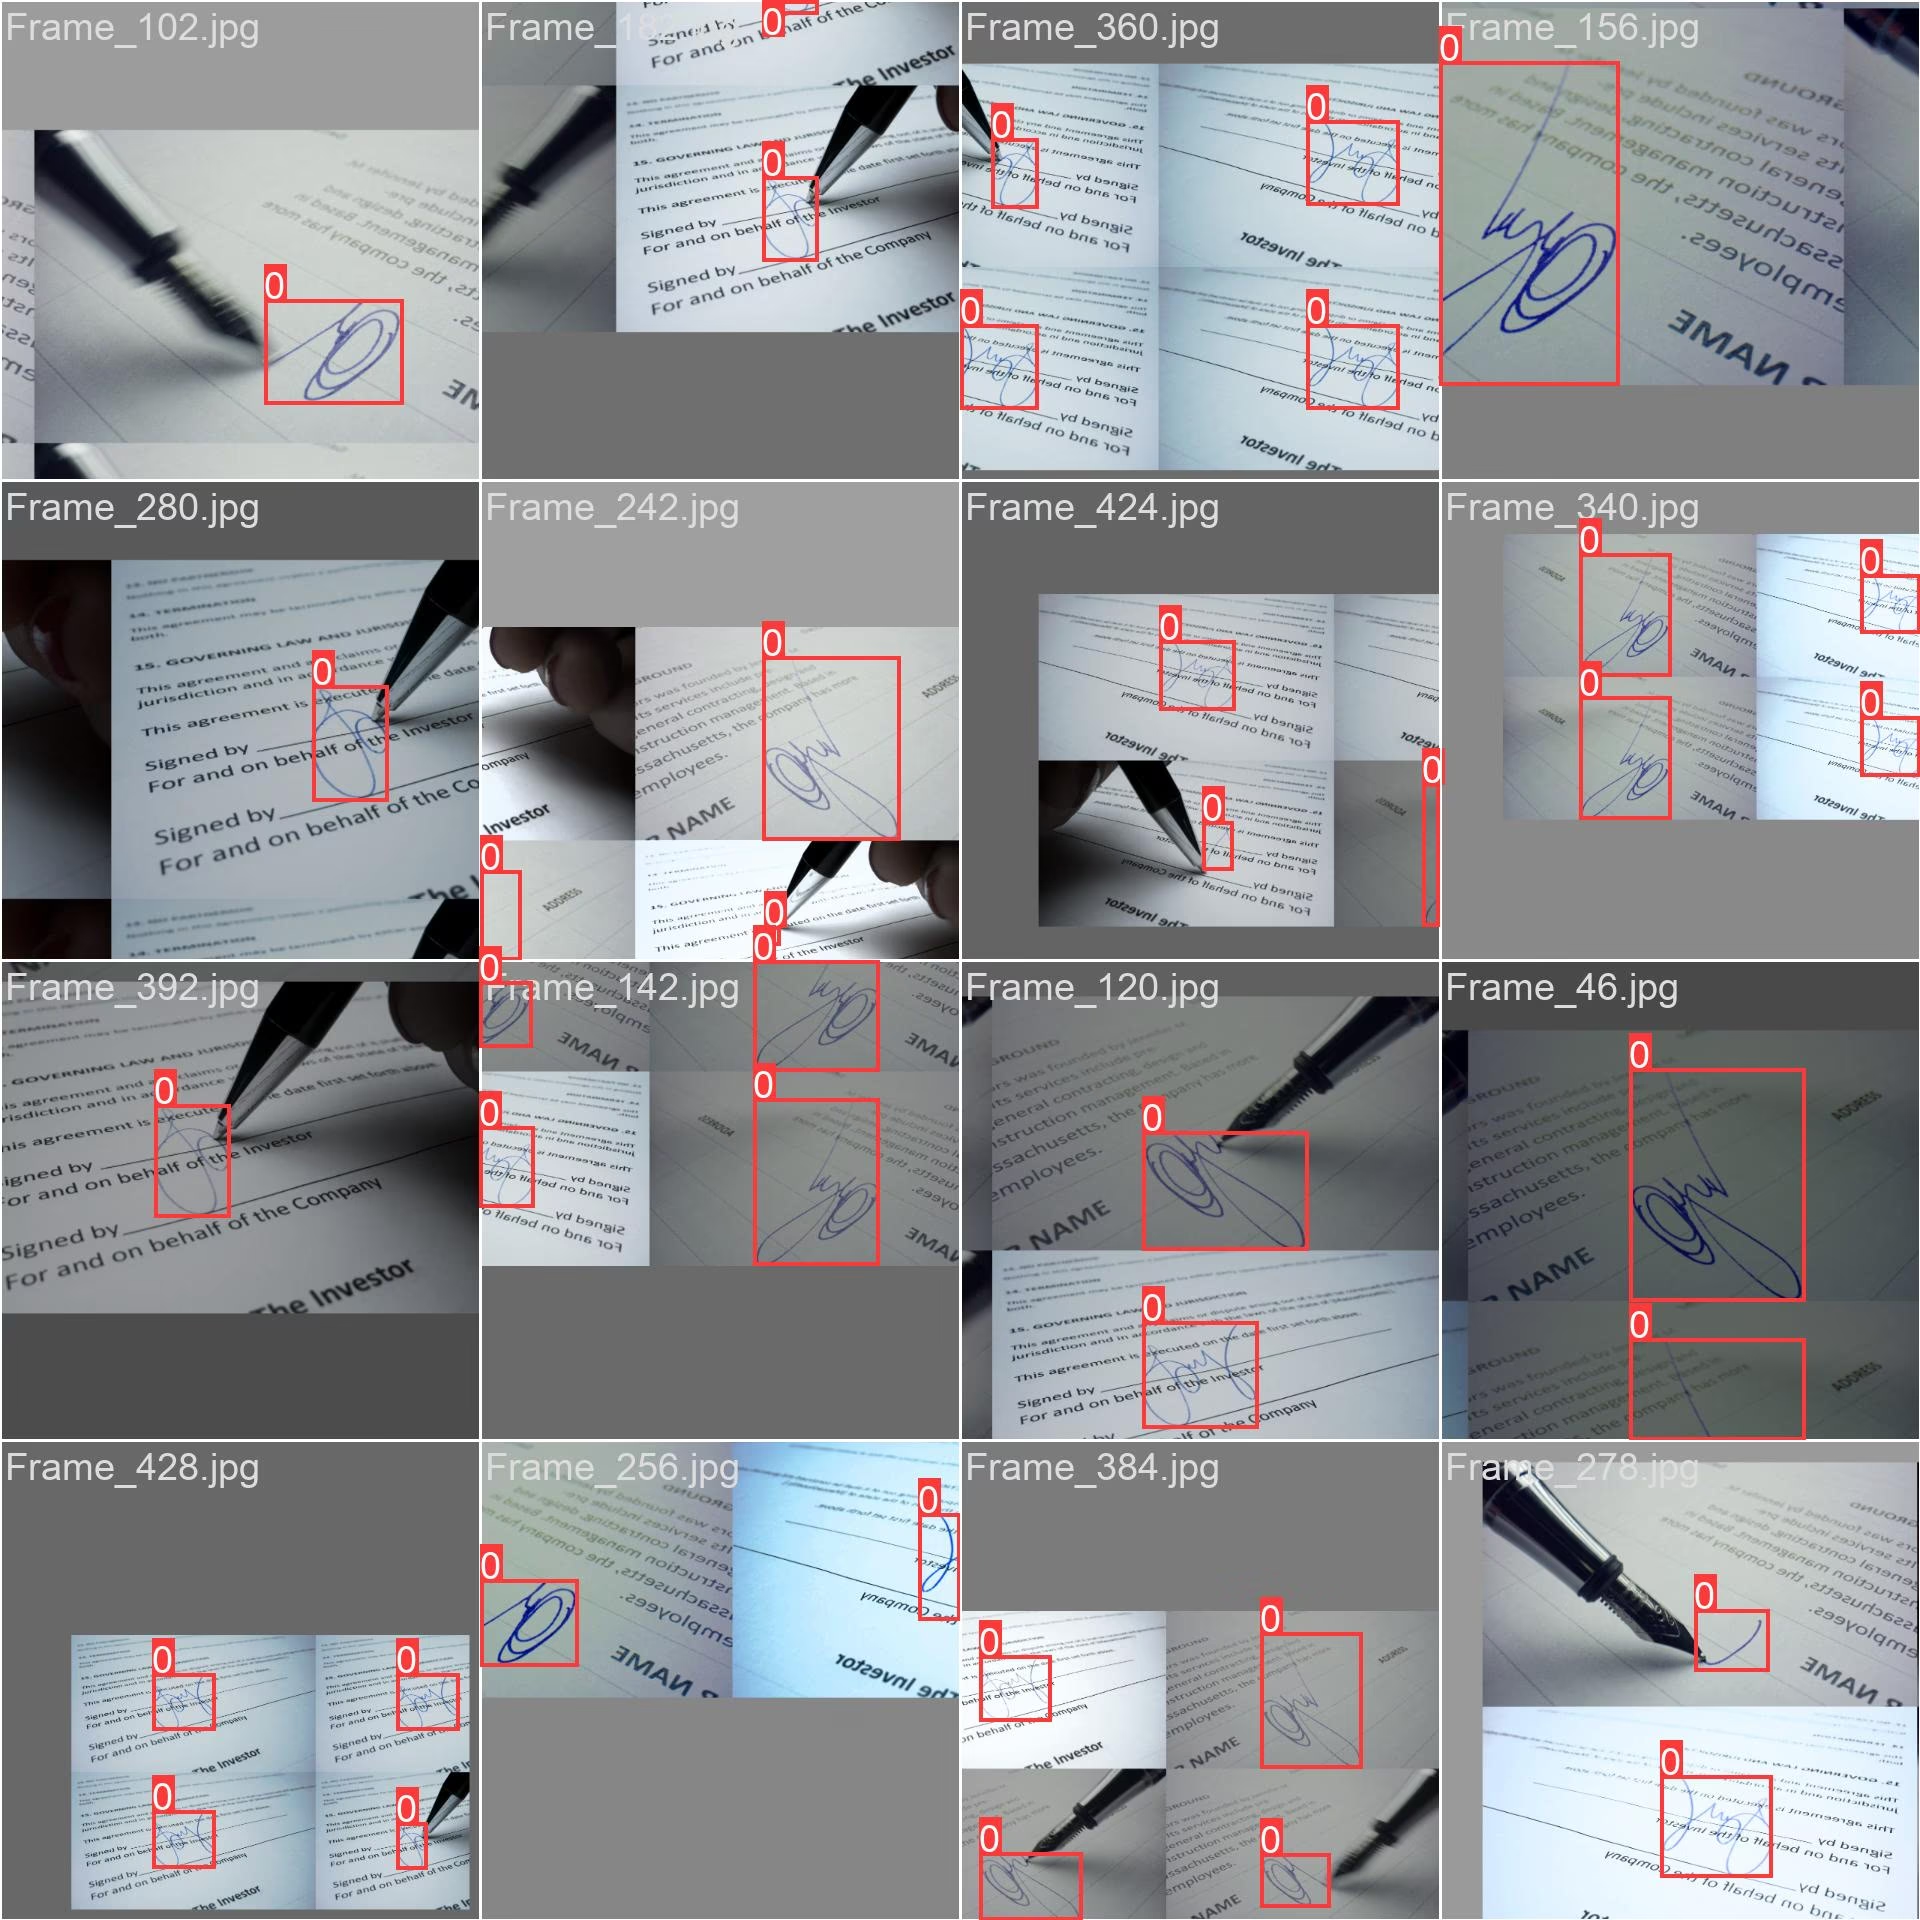
- モザイク画像: このトレーニングバッチは、モザイク化というトレーニング手法で複数のデータセット画像を組み合わせています。これによりバッチの多様性が高まり、さまざまな署名サイズ、アスペクト比、コンテキストに対するモデルの汎化能力が向上します。
引用と謝辞#
このデータセットはAGPL-3.0ライセンスの下で公開されています。
研究または開発で署名検出データセットを使用する場合は、適切な形式で引用してください。
@dataset{Ultralytics_Signature_Detection_Dataset_2024,
    author = {Ultralytics},
    title = {Signature Detection Dataset},
    year = {2024},
    publisher = {Ultralytics},
    url = {https://docs.ultralytics.com/datasets/detect/signature}
}よくある質問#
data="signature.yaml"を使用して初めてトレーニングすると、データセットはUltralytics GitHubアセットから自動的にダウンロードされます(11.3 MB)。手動でダウンロードする必要はありません。他のデータセットについては、検出データセットの概要をご覧ください。署名検出データセットには、トレーニング用画像143枚と検証用画像35枚が含まれており、合計178枚です。各画像には単一クラス
signatureのアノテーションが付いています。独立したテスト分割はありません。詳細については、データセット構成のセクションとsignature.yaml設定をご覧ください。PythonまたはCLIを使用して、画像サイズ640でYOLO26nモデルを100エポックトレーニングできます。
トレーニング例from ultralytics import YOLO # 事前トレーニング済みモデルを読み込む model = YOLO("yolo26n.pt") # モデルをトレーニングする results = model.train(data="signature.yaml", epochs=100, imgsz=640)詳しくは、トレーニングページとモデルのトレーニングに関するヒントをご覧ください。
ファインチューニング済みの重みを読み込み、予測を実行します。
推論例from ultralytics import YOLO # ファインチューニング済みモデルを読み込みます model = YOLO("path/to/best.pt") # 推論を実行 results = model.predict("https://ultralytics.com/assets/signature-s.mp4", conf=0.75)このデータセットはAGPL-3.0ライセンスの下で公開されており、ネットワーク経由で提供されるソフトウェアを含め、派生物を同じライセンスで公開する場合は商用利用が許可されます。オープンソース要件の適用を受けないライセンスオプションについては、Ultralyticsのライセンスをご覧ください。


コメント2
質問したり、結果を共有したり、ほかの人をサポートしたりできます。
 Haroon Aziz
Thank you for providing the free dataset. I am interested in contributing to this platform by creating a dataset for briquette texture classification.
 Glenn JocherUltralytics
Thanks for your interest! Please share the proposed classes, image counts, data source, and sample images in this discussion, then follow the dataset contribution guide to prepare the briquette texture classification dataset and submit a focused documentation PR.